Cómo recopilar reseñas de mapas, marketplaces y agregadores: guía paso a paso para principiantes
Contenido del artículo
- Introducción: qué obtendrás al final
- Preparación previa: herramientas y accesos
- Conceptos básicos: cómo están estructuradas las reseñas y por qué se recopilan distinto que los catálogos
- Paso 1: define el objetivo y arma la lista de fuentes
- Paso 2: diseña la tabla de reseñas
- Paso 3: usa las vías oficiales: paneles y apis
- Paso 4: recopila reseñas de mapas: yandex maps, 2gis, google maps
- Paso 5: recopila reseñas de marketplaces: wildberries, ozon, yandex market
- Paso 6: recopila reseñas de agregadores: otzovik, irecommend, flamp, zoon
- Paso 7: conecta los proxies móviles y configura la rotación
- Paso 8: guarda, limpia y deduplica
- Verificación del resultado: checklist y pruebas
- Errores típicos y soluciones
- Posibilidades adicionales para avanzados
- Faq: preguntas frecuentes sobre la recopilación de reseñas
- Conclusión
Introducción: qué obtendrás al final
Las reseñas son la fuente de información más honesta sobre un producto, una tienda o un establecimiento. En ellas las personas cuentan por sí mismas qué les gustó, qué se rompió, por qué no volverán y qué recomendarían a sus amigos. El problema es que las reseñas están dispersas en decenas de plataformas: mapas, marketplaces, agregadores, catálogos sectoriales. Leerlas manualmente durante semanas es irreal. Por eso necesitas una recopilación sistemática.
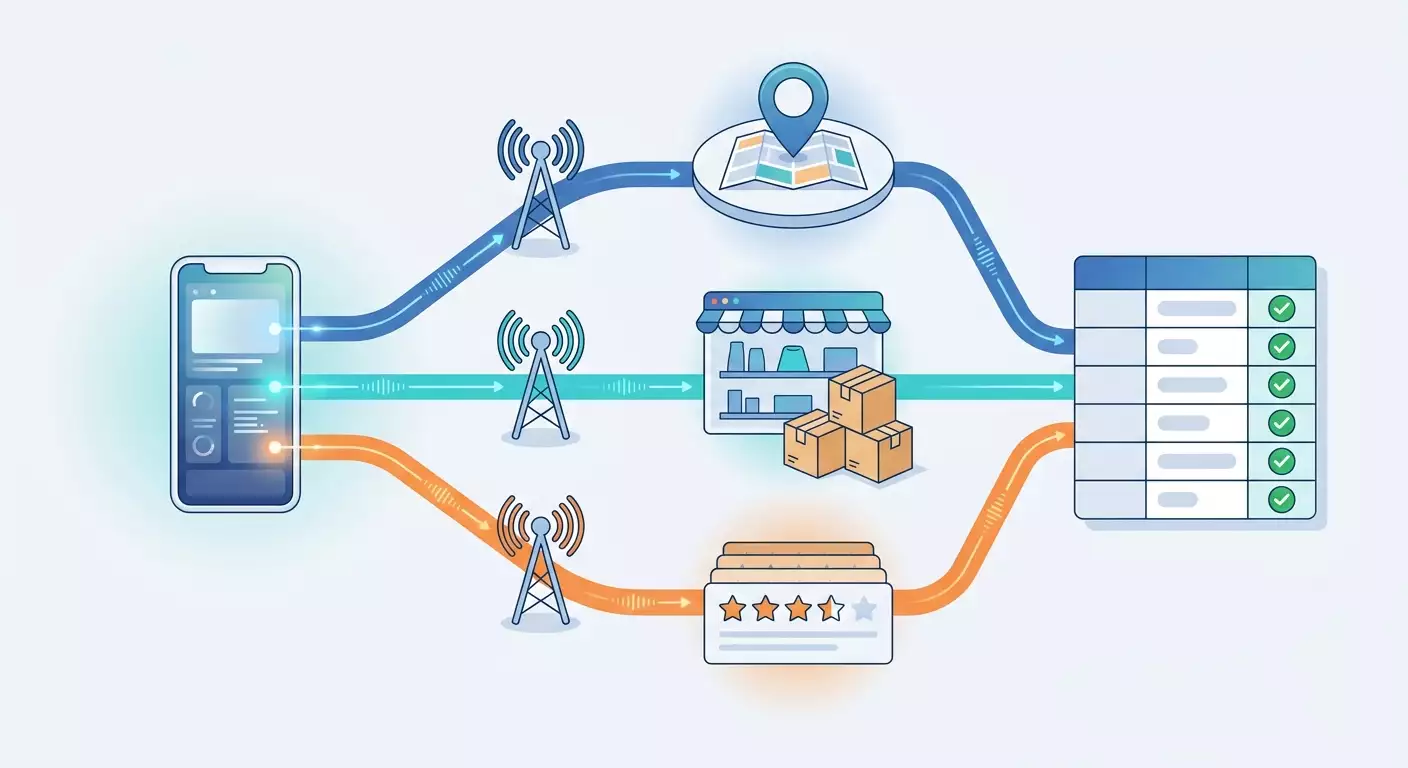
En esta guía te mostraremos cómo recopilar reseñas de tres tipos de plataformas: servicios de mapas (Yandex Maps, 2GIS, Google Maps), marketplaces (Wildberries, Ozon, Yandex Market) y agregadores (Otzovik, iRecommend, Flamp, Zoon). Recorrerás todo el camino: desde plantear el objetivo y diseñar la tabla hasta tener un script funcional, conectar proxies móviles y limpiar los datos.
Al final obtendrás:
- Comprensión de dónde y en qué forma se encuentran las reseñas en cada tipo de plataforma.
- Una estructura lista de tabla de reseñas que podrás cargar en Excel, Google Sheets o una base de datos.
- Un scraper de reseñas funcional en Python que sabe operar a través de proxies móviles y no sobrecarga las plataformas.
- Conocimiento sobre las vías oficiales de exportación: paneles de control, APIs de socios, exportaciones.
- Una lista de verificación de calidad de los datos recopilados y una lista de errores típicos.
Para quién es esta guía. Está pensada para especialistas en marketing, dueños de negocios, afiliados y desarrolladores principiantes. Si nunca has escrito código, no te asustes. Algunos escenarios se ejecutan sin programación en absoluto, y para los scripts te damos fragmentos listos que solo necesitas copiar y sustituir con tus propios valores. Para quienes ya saben programar, al final hay un bloque aparte con técnicas avanzadas.
Qué necesitas saber de antemano. Basta con saber usar el navegador, instalar programas y trabajar con tablas. Tener una idea básica de qué es un proxy ayuda, pero explicaremos los términos clave sobre la marcha.
Un límite importante de este material. Aquí hablamos solo de reseñas como un tipo de datos aparte: texto, calificación, fecha, autor, respuesta de la empresa. No abordamos el scraping de catálogos de productos, precios ni existencias: ese es un tema aparte con sus propias particularidades. Si necesitas precios, esta guía no te servirá; si necesitas retroalimentación de clientes, estás en el lugar correcto.
Cuánto tiempo tomará. Preparar el entorno tomará unos 30-40 minutos. Diseñar la estructura y la primera recopilación desde una plataforma, aproximadamente una hora. El recorrido completo por los tres tipos de plataformas con configuración de proxies y limpieza de datos llevará 3-4 horas. Después, la recopilación tomará minutos, porque el script se puede ejecutar repetidamente.
Preparación previa: herramientas y accesos
Antes de recopilar reseñas, hay que preparar el entorno de trabajo. Aquí tienes la lista de lo que necesitarás. No te saltes esta sección, aunque algo parezca obvio: la mitad de los problemas en los siguientes pasos surgen precisamente por un entorno mal preparado.
Requisitos del sistema
- Computadora con Windows 10/11, macOS o Linux. Cualquier laptop de los últimos 6-7 años sirve.
- Mínimo 4 GB de memoria RAM. Para recopilar decenas de miles de reseñas, mejor 8 GB.
- Internet estable. La recopilación en sí no requiere alta velocidad, pero las caídas de conexión provocan pérdidas de datos.
- Alrededor de 2 GB de espacio libre en disco para Python, bibliotecas y resultados.
Qué instalar
- Python 3.11 o superior. Descarga el instalador del sitio oficial de Python. Al instalar en Windows, asegúrate de marcar la casilla «Add Python to PATH» en la primera pantalla del instalador. Sin ella, el comando python no funcionará en la terminal.
- Editor de código. VS Code es gratuito y fácil de entender. Después de instalarlo, ábrelo una vez para asegurarte de que se inicia.
- Bibliotecas de Python. Abre la terminal (en Windows, PowerShell; en macOS, Terminal) y ejecuta el comando:
pip install requests pandas openpyxl. Espera el mensaje Successfully installed. Tomará 1-2 minutos. - Navegador Chrome o Yandex Browser. Lo necesitas para examinar las plataformas a través de las herramientas de desarrollador. Vienen integradas, no hay que instalar nada aparte.
- Editor de hojas de cálculo. Excel, LibreOffice Calc o Google Sheets para revisar los resultados.
Qué accesos necesitarás
- Acceso a proxies móviles. Regístrate en mobileproxy.space, elige un plan con la geolocalización adecuada (para plataformas rusas, operadores rusos) y obtén los datos de conexión: host, puerto, usuario, contraseña. También en tu panel encuentra el enlace para cambiar la IP: lo necesitarás en el paso de rotación.
- Acceso a los paneles de las plataformas si recopilas reseñas sobre tu propio negocio. Esto incluye Yandex Business, el panel de vendedor de Wildberries, Ozon Seller, Yandex Market para vendedores, Google Business Profile. Las exportaciones oficiales desde ahí son la fuente más limpia.
- Carpeta del proyecto. Crea en el disco una carpeta, por ejemplo reviews_project, y dentro de ella dos subcarpetas: raw para datos sin procesar y clean para datos procesados. Esto es tu seguro: los datos sin procesar nunca se sobrescriben.
Consejo: Crea de inmediato en la carpeta del proyecto un archivo de texto sources.txt y anota ahí cada dirección desde la que recopiles reseñas, junto con la fecha. En un mes no recordarás de dónde salió tal o cual tabla, y un diario así eliminará todas las dudas.
Copias de seguridad
Las copias de seguridad aquí no se refieren al sistema, sino a los datos. Establece como regla: cada ejecución del scraper escribe el resultado en un nuevo archivo con la fecha en el nombre, por ejemplo reviews_ozon_2026-03-14.csv. No borres los archivos antiguos al menos durante un mes. Si la nueva recopilación sale dañada por cambios en la plataforma, conservarás una versión funcional.
Verificación: Escribe en la terminal python --version: debe mostrarse la versión 3.11 o superior. Luego escribe python -c 'import requests, pandas; print(1)': debe aparecer el número 1 sin errores. Si ambos comandos funcionaron, el entorno está listo.
Conceptos básicos: cómo están estructuradas las reseñas y por qué se recopilan distinto que los catálogos
Antes de ejecutar algo, es importante entender con qué tipo de datos trabajas. Una reseña no es solo texto. Es un registro estructurado con varios campos, y tiene particularidades que no existen en una ficha de producto.
Términos clave en lenguaje sencillo
- Reseña (review): registro dejado por un usuario sobre un objeto: producto, tienda, establecimiento. Normalmente contiene calificación, texto, fecha, nombre del autor y a veces fotografías.
- Objeto de la reseña: aquello sobre lo que trata la reseña: ficha de producto en un marketplace, organización en el mapa, empresa en un agregador. Cada objeto tiene un identificador único en la plataforma.
- Respuesta de la empresa: réplica de un representante del negocio bajo una reseña. Para analizar la calidad del soporte, es un campo aparte.
- Paginación: división de las reseñas en páginas o porciones. La plataforma entrega, por ejemplo, 20 reseñas a la vez, y hay que solicitar las siguientes porciones.
- Scraper de reseñas: programa que recorre automáticamente los objetos necesarios, extrae las reseñas y las vuelca en una tabla. Puede ser un script sencillo o un servicio listo.
- Deduplicación: eliminación de repetidos. Una misma reseña puede aparecer dos veces en la selección por la paginación o por ejecuciones repetidas.
- Proxies móviles: servidores intermedios con direcciones IP de operadores móviles. Las solicitudes a través de ellos parecen tráfico de un usuario normal desde un smartphone. Las plataformas son más tolerantes con ese tráfico, porque detrás de una IP móvil hay cientos de personas reales.
- Rotación de IP: cambio de la dirección del proxy a un intervalo dado o bajo demanda. Ayuda a distribuir la carga y a no crear un flujo anómalo de solicitudes desde una sola dirección.
En qué se diferencia la recopilación de reseñas de la de un catálogo
Un catálogo de productos es relativamente estático: la ficha existe, tiene precio y características. Las reseñas, en cambio, viven de otra manera, y eso afecta todo el proceso.
- Las reseñas se añaden constantemente. Hay que saber descargar solo las nuevas, no volver a extraer todo cada vez.
- Las reseñas se cargan por separado. En la mayoría de las plataformas, el texto de las reseñas no viene en la propia página, sino en una solicitud aparte en segundo plano. Es una buena noticia: esas solicitudes entregan JSON listo, no hay que parsear HTML.
- Las reseñas contienen datos personales. Nombre del autor, avatar, a veces ciudad. Hay requisitos legales al respecto, de eso hablamos más abajo.
- Las reseñas se ordenan y se filtran. Por defecto, la plataforma puede mostrar «útiles» o «nuevas». Si no fijas el orden, recopilarás conjuntos distintos en distintas ejecuciones.
- Las reseñas se editan y se eliminan. La moderación retira parte de los registros, los autores cambian calificaciones. La fecha de recopilación se convierte en un campo importante.
Marco legal que debes entender
Atención: Las reseñas contienen nombres y otros datos sobre personas. Al recopilar y almacenar, cumple con los requisitos de la Ley Federal 152-FZ sobre datos personales: no recopiles más de lo necesario para tu tarea, anonimiza a los autores donde el nombre no sea necesario para el análisis, no transfieras la base a terceros. Lee también los términos de uso de la plataforma y el archivo robots.txt: algunos servicios describen explícitamente los modos permitidos de acceso automático. Si para tu tarea existe una API oficial o una exportación desde el panel, empieza siempre por ahí.
Otro principio es la carga respetuosa. Tu scraper de reseñas debe comportarse como un usuario atento, no como un torrente de solicitudes. Pausas entre solicitudes, un número razonable de hilos y rotación a través de proxies móviles no son un truco, sino la norma de una recopilación responsable. Las plataformas bloquean no el hecho de la automatización, sino el comportamiento anómalo que interfiere con su funcionamiento.
Paso 1: Define el objetivo y arma la lista de fuentes
Objetivo del paso: obtener una lista concreta y limitada de objetos de los que recopilaremos reseñas, y entender qué campos necesitamos. Sin este paso, el scraper se convierte en un proyecto infinito.
Formula la pregunta que responderán las reseñas
Una buena recopilación empieza con una pregunta. Ejemplos de formulaciones útiles:
- «¿Por qué el competidor X en Wildberries tiene calificación 4,8 y nosotros 4,4 en la misma categoría?»
- «¿De qué se quejan más en las reseñas sobre nuestras cinco cafeterías en Yandex Maps durante los últimos seis meses?»
- «¿Qué dolores de los clientes se mencionan en las reseñas sobre cursos online en Otzovik, para usarlos en creatividades?»
Fíjate: en cada pregunta hay plataforma, objeto, período y tipo de información. Eso es precisamente lo que determina la configuración de la recopilación.
Arma la lista de objetos
- Abre la plataforma en el navegador y encuentra manualmente cada objeto necesario: ficha de producto, organización en el mapa, página de empresa en el agregador.
- Copia la dirección completa de la página desde la barra de direcciones.
- Extrae de la dirección el identificador del objeto. En Wildberries es el número en la dirección de la ficha después de catalog/; en Ozon, el número después de product/ y el guion al final; en Yandex Maps, el número largo después de org/ y el nombre; en 2GIS, el número después de firm/. Anótalo aparte.
- Registra todo en una tabla sources.csv con las columnas: plataforma, nombre del objeto, dirección, identificador, comentario.
- Para la primera ejecución, limítate a 3-5 objetos por plataforma. Escalarás después.
Decide qué campos necesitas
El conjunto mínimo de campos para cualquier reseña: identificador de la reseña en la plataforma, identificador del objeto, plataforma, calificación, texto, fecha de publicación, fecha de recopilación. Conjunto ampliado: nombre del autor (o su hash), presencia de fotos, pros y contras por separado (existen en marketplaces y Otzovik), respuesta de la empresa y su fecha, número de me gusta o marcas de «útil», variante del producto (talla, color), estado de compra confirmada.
Consejo: No persigas todos los campos a la vez. Recopila el conjunto mínimo más 2-3 campos que realmente necesites para tu pregunta. Cada campo extra es un lugar extra donde el marcado de la plataforma puede cambiar y romper el script.
Resultado esperado: archivo sources.csv con 5-15 filas y una lista de campos anotada. Cada fila tiene su identificador rellenado.
Posibles problemas: no logras entender dónde está el identificador en la dirección. Solución: abre dos objetos similares en la misma plataforma y compara las direcciones: las partes coincidentes son la plantilla, las que difieren son el identificador.
Verificación: Puedes leer cualquier fila de sources.csv y con un solo identificador abrir manualmente el objeto correspondiente en la plataforma. Si para eso tienes que adivinar, vuelve y aclara los identificadores.
Paso 2: Diseña la tabla de reseñas
Objetivo del paso: fijar un formato único de registro al que se adaptarán las reseñas de todas las plataformas. Esto te permitirá analizarlas juntas y no en cinco tablas distintas.
Esquema unificado
Crea en el editor de código un archivo schema.txt y enumera las columnas en este orden:
- review_id: identificador de la reseña en la plataforma. Si la plataforma no lo entrega explícitamente, lo formamos nosotros a partir del objeto, el autor y la fecha.
- source: código corto de la plataforma: yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon.
- object_id: identificador del objeto de sources.csv.
- object_name: nombre legible para mayor comodidad.
- rating: número de 1 a 5. Si la plataforma usa otra escala, la llevamos a cinco puntos y lo anotamos en un comentario.
- text: texto completo de la reseña en una sola línea. Los saltos de línea los sustituimos por espacios.
- pros y cons: pros y contras, si la plataforma los separa. Si no, vacío.
- author: nombre del autor o su hash anonimizado.
- published_at: fecha de publicación en formato AAAA-MM-DD.
- company_reply: texto de la respuesta de la empresa, si existe.
- likes: número de marcas de utilidad.
- has_photo: 1 o 0.
- collected_at: fecha y hora de la recopilación.
- url: dirección de la página del objeto.
Por qué se necesita exactamente un formato unificado
Cada plataforma entrega los datos a su manera: en un lugar la fecha es la cadena «hace 3 días», en otro es un número de milisegundos, en otro es el texto «14 de marzo». Si no llevas todo a una forma común en la entrada, al analizar te ahogarás en excepciones. Hay que adaptar al esquema justo al escribir, no después.
Reglas de anonimización
Si para la tarea no necesitas los nombres de los autores (y en el 90% de las tareas analíticas no se necesitan), guarda un hash en lugar del nombre. En Python esto se hace en una línea con el módulo hashlib: se toma el nombre del autor, se le añade el código de la plataforma y el resultado se convierte en una cadena corta. Así podrás distinguir las reseñas de un mismo autor entre sí, pero no almacenarás el nombre en sí.
Consejo: Añade al esquema una columna raw_json donde se guarde la respuesta original de la plataforma para cada reseña. Ocupa espacio, pero permite luego extraer un campo en el que hoy no pensaste, sin volver a recopilar.
Resultado esperado: archivo schema.txt con las columnas y una plantilla vacía de tabla reviews_template.csv con esos encabezados.
Verificación: Abre reviews_template.csv en Excel. Debes ver una sola fila de encabezados con exactamente las columnas de schema.txt y ninguna de más.
Paso 3: Usa las vías oficiales: paneles y APIs
Objetivo del paso: exportar las reseñas sobre tu propio negocio de la forma más limpia posible, sin scraping en absoluto. Si analizas solo lo tuyo, este paso puede ser suficiente.
Yandex Business (reseñas en Yandex Maps)
- Entra en Yandex Business con la cuenta del propietario de la organización.
- En el menú izquierdo selecciona la sección «Reseñas».
- Arriba elige la sucursal deseada si tienes varias organizaciones.
- Configura el filtro por período y calificación.
- La lista de reseñas se muestra con texto, fecha, calificación y tus respuestas. No hay un botón directo de exportación a tabla, así que para grandes volúmenes usa la copia por páginas o pasa al paso 4.
Wildberries: API de reseñas para vendedores
Wildberries tiene una sección oficial de API para trabajar con reseñas y preguntas. Está disponible para vendedores y entrega las reseñas de tus productos con calificación, texto, pros y contras, fecha, y también permite responderlas.
- Entra en el panel de vendedor WB Partners.
- Abre la configuración del perfil, sección «Acceso a API».
- Crea un nuevo token marcando la categoría de acceso a reseñas y preguntas. Ponle un nombre claro, por ejemplo reviews_export.
- Copia el token de inmediato: no se vuelve a mostrar. Guárdalo en el archivo config.txt en la carpeta del proyecto.
- Llama a los métodos de lista de reseñas con ese token en el encabezado Authorization. La documentación describe los parámetros de paginación y filtrado por fechas.
Ozon Seller API y Yandex Market
Ozon ofrece acceso a las reseñas a través de Seller API para vendedores con una suscripción que incluya el trabajo con reseñas. La clave se crea en la sección «Configuración», subsección «Claves API». Yandex Market entrega las reseñas de los productos del vendedor a través de la API de socios por el identificador de negocio; la clave se emite en el panel del vendedor en la sección de configuración de accesos.
Google Business Profile y 2GIS para negocios
Las reseñas sobre tu propia organización en Google Maps están disponibles en el panel de Google Business Profile y a través de su API tras confirmar los permisos. 2GIS ofrece a los propietarios un panel con notificaciones de reseñas y posibilidad de responder.
Atención: Los tokens y claves de API son acceso a tu cuenta de negocio. Nunca los insertes directamente en el código; guárdalos en un archivo aparte que no caiga en carpetas compartidas ni repositorios. Si un token se filtra por accidente, revócalo de inmediato en el panel y crea uno nuevo.
Cuando las vías oficiales no bastan
Todos los métodos enumerados dan reseñas solo sobre tus objetos. Para analizar competidores, mercado o productos ajenos no sirven. En ese caso pasamos a la recopilación desde páginas públicas: a eso están dedicados los siguientes pasos.
Resultado esperado: si trabajas con tu propio negocio, la primera tabla de reseñas de una fuente oficial, adaptada al esquema del paso 2.
Verificación: El número de reseñas en la exportación coincide con el que muestra el panel para el mismo período, con un margen de 1-2 registros por reseñas que en el momento de la exportación estaban en moderación.
Paso 4: Recopila reseñas de mapas: Yandex Maps, 2GIS, Google Maps
Objetivo del paso: aprender a encontrar la solicitud en segundo plano con la que el mapa carga las reseñas y reproducirla con un script. Esta habilidad es universal y te servirá en todas las demás plataformas.
Cómo encontrar la solicitud con reseñas a través de las herramientas de desarrollador
- Abre en Chrome la página de la organización en Yandex Maps o 2GIS.
- Pulsa la tecla F12. A la derecha o abajo se abrirá el panel de desarrollador.
- Ve a la pestaña Network (Red). Si está vacía, actualiza la página con F5.
- En la barra de filtro sobre la lista de solicitudes, pulsa el botón Fetch/XHR. Solo quedarán las solicitudes en segundo plano por datos.
- En la página de la organización, ve a la sección de reseñas y desplaza la lista hacia abajo para que se cargue la siguiente porción.
- En la lista de solicitudes aparecerá una nueva. En su nombre suele aparecer la palabra review o feedback. Haz clic sobre ella.
- Abre la pestaña Preview o Response. Verás la estructura JSON donde, como lista anidada, van las reseñas: texto, calificación, fecha, autor.
- Abre la pestaña Headers. Copia la dirección completa de la solicitud (Request URL) y presta atención a los parámetros: normalmente ahí están el identificador del objeto, el número de página o el desplazamiento, el tamaño de la porción y el orden.
- En esa misma sección encuentra los encabezados de la solicitud: User-Agent, Accept, Referer. Habrá que pasarlos desde el script.
Consejo: Haz clic derecho sobre la solicitud encontrada y elige Copy, luego Copy as cURL. Obtendrás un comando con todos los encabezados. Es cómodo pegarlo en un archivo de texto como referencia: si el script deja de funcionar, compararás su solicitud con la de referencia.
Particularidades de cada mapa
- Yandex Maps. Las reseñas se cargan por porciones indicando el orden (por novedad, por calificación, por relevancia). Fija obligatoriamente un solo orden, de lo contrario en distintas ejecuciones los conjuntos divergirán. La fecha llega en formato legible por máquina, la calificación es un número. Las respuestas de la organización están en un campo anidado aparte.
- 2GIS. El servicio tiene un servicio público de reseñas al que recurre el propio sitio. La solicitud contiene el identificador de la sucursal y los parámetros de límite y desplazamiento. En la respuesta hay texto, calificación, fecha, nombre de usuario, respuesta oficial y contador de utilidad. También llega el número total de reseñas: úsalo para verificar la completitud.
- Google Maps. La más compleja de las tres: las reseñas llegan en un formato empaquetado dentro de respuestas largas. Para unas pocas decenas de objetos es más fácil usar Places API con una clave oficial: entrega un conjunto limitado de reseñas recientes por cada lugar, lo que suele bastar para evaluar la tonalidad. Para la recopilación completa de objetos ajenos hará falta automatización del navegador: ese es tema del bloque avanzado.
Escribimos el primer script
Crea el archivo collect_maps.py y pega el esqueleto. Sustituye la dirección de la solicitud y los nombres de los campos por lo que viste en el panel de desarrollador: difieren entre plataformas y pueden cambiar con el tiempo.
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
Analicemos qué ocurre aquí. La variable PROXY guarda los datos de tu proxy móvil. El encabezado User-Agent presenta la solicitud como un navegador móvil: eso encaja lógicamente con la IP móvil. La función collect recorre las páginas hasta que la plataforma devuelve una lista vacía, y después de cada página hace una pausa de 2,5 segundos. La pausa no es un formalismo: hace que la carga se parezca a la lectura de una persona real.
Ejecución y escritura del resultado
- Al final del archivo añade la llamada a la función para un objeto de sources.csv y la escritura de las filas en CSV a través del módulo csv con codificación utf-8-sig, para que Excel abra correctamente el texto en ruso.
- Abre la terminal en la carpeta del proyecto y ejecuta
python collect_maps.py. - Observa la salida. Es útil imprimir el número de página y la cantidad de filas recopiladas después de cada solicitud.
- Abre el archivo obtenido en Excel y revisa las primeras 20 filas.
Resultado esperado: archivo CSV con las reseñas de una organización, donde el número de filas es aproximadamente igual al contador de reseñas en la página de la organización.
Posibles problemas: la respuesta llega con código 403 o vacía. Solución: contrasta los encabezados con el comando cURL copiado, sobre todo Referer y Accept. Verifica que el proxy esté conectado y haya respondido a una solicitud de prueba a cualquier sitio. Aumenta la pausa a 4-5 segundos.
Verificación: Toma tres reseñas al azar del archivo y encuéntralas en la página de la organización por el texto. Las tres deben aparecer, con las mismas calificaciones y fechas.
Paso 5: Recopila reseñas de marketplaces: Wildberries, Ozon, Yandex Market
Objetivo del paso: adaptar el enfoque del paso 4 a los marketplaces, donde las reseñas están vinculadas a productos y tienen campos adicionales: pros, contras, variante del producto, foto.
Wildberries
En Wildberries las reseñas están vinculadas no al artículo, sino a un identificador unificador de la ficha, bajo el cual están agrupados colores y tallas. Esto es importante: si recopilas reseñas por artículo, las obtendrás para todas las variantes a la vez, y habrá que filtrar por el campo de variante.
- Abre la ficha del producto, pulsa F12, ve a la pestaña Network con filtro Fetch/XHR.
- Desplázate hasta el bloque de reseñas y pulsa «Ver todas las reseñas».
- Encuentra la solicitud cuyo nombre contenga feedbacks. En la respuesta habrá una lista con texto, calificación, fecha, campos de pros y contras, nombre del autor, color y talla, indicador de presencia de foto y respuesta del vendedor.
- Presta atención al número total de reseñas en la respuesta: ayudará a verificar la completitud.
- Copia la dirección y los encabezados, sustitúyelos en el script según el modelo del paso 4. Aquí puede no haber paginación: parte de las respuestas llega completa, a veces en un archivo muy grande. Aumenta el timeout a 60 segundos.
Ozon
Ozon protege activamente los datos y verifica el comportamiento del cliente. Para las reseñas, el sitio usa una solicitud interna por la composición de la página, en la que las reseñas son uno de los bloques. Orden práctico de acciones:
- Abre la página del producto y luego ve a la sección de reseñas por el enlace de la ficha.
- En el panel de desarrollador encuentra la solicitud cuya respuesta contenga un array con campos content, score o rating y author. Puede llamarse de distintas formas; búscalo por el contenido con la barra de búsqueda del panel (combinación Ctrl+F dentro de la pestaña Network).
- Copia la solicitud como cURL. Presta atención a los encabezados y cookies: Ozon es sensible a su ausencia.
- Al reproducir desde el script, usa una sesión requests.Session para que las cookies se conserven entre solicitudes, y haz primero una solicitud a la página normal del producto, y solo después a las reseñas. Esto imita el camino natural del usuario.
- Mantén pausas de 4-6 segundos y cambia la IP a través del proxy móvil cada 30-50 solicitudes.
Atención: Si la plataforma empezó a entregar una página de verificación del navegador o un captcha, es señal de detenerse, no de presionar más. Reduce la frecuencia, cambia la IP a través del enlace de rotación y espera 10-15 minutos. La presión sistemática sobre los mecanismos de defensa lleva al bloqueo de todo el pool de direcciones y contradice las reglas de las plataformas.
Yandex Market
En Yandex Market las reseñas son de dos tipos: sobre el producto (comunes para todos los vendedores) y sobre la tienda. Para analizar el producto se necesitan las primeras; para analizar el servicio, las segundas. Ambos tipos tienen división en pros, contras y comentario, además de calificación y fecha. La solicitud de reseñas se encuentra de la misma manera a través del panel de desarrollador en la pestaña «Reseñas» de la ficha del producto.
Adaptación al esquema
En los marketplaces, el campo de texto a menudo consta de tres partes. Regístralas así: pros en la columna pros, cons en la columna cons, y el comentario general en text. Si para el análisis necesitas un solo texto continuo, en la etapa de limpieza une las tres columnas con un separador, pero en los datos sin procesar guárdalas por separado.
Consejo: En los marketplaces, las reseñas con foto y compra confirmada son notablemente más informativas. Añade un filtro al script: primero recopila todo, y al analizar mira por separado el corte con has_photo igual a 1. A menudo ahí están las descripciones más detalladas de defectos y escenarios de uso reales.
Resultado esperado: un CSV por cada marketplace con reseñas de 3-5 productos, adaptadas al esquema unificado.
Posibles problemas: el número de reseñas recopiladas es menor que el contador en la página. Causa: la plataforma limita la profundidad de la entrega o entrega solo reseñas con texto, ocultando calificaciones sin comentario. Solución: compara los contadores de «total de calificaciones» y «con texto» en la página: normalmente la discrepancia se explica por eso.
Verificación: Abre el archivo en Excel, construye una tabla dinámica por la columna rating. La distribución de calificaciones debe corresponder aproximadamente a lo que muestra la ficha del producto: si en la plataforma el 70% son cincos, en tu muestra debe haber un valor cercano.
Paso 6: Recopila reseñas de agregadores: Otzovik, iRecommend, Flamp, Zoon
Objetivo del paso: aprender a trabajar con plataformas donde las reseñas son artículos independientes con marcado HTML, y no JSON en segundo plano.
En qué se diferencian los agregadores
Otzovik e iRecommend construyen las páginas de forma clásica: cada reseña es una página aparte con título, texto largo, calificación, fecha, pros y contras, y en la página del objeto hay una lista de enlaces a esas reseñas con breves avances. Flamp y Zoon están más cerca de los mapas: organización, lista de reseñas, carga por porciones. En consecuencia, para los dos primeros hace falta parseo de HTML; para los segundos sirve el método del paso 4.
Instalación de la biblioteca para parsear HTML
Ejecuta en la terminal pip install beautifulsoup4 lxml. La biblioteca BeautifulSoup permite encontrar elementos de la página por etiquetas y clases, como los encuentras a ojo en el panel de desarrollador.
Recopilación paso a paso desde Otzovik
- Abre la página del objeto (producto, empresa, curso) en Otzovik.
- Pulsa F12 y ve a la pestaña Elements (Elementos).
- Pulsa el icono de flecha en la esquina superior izquierda del panel y haz clic en el título de la primera reseña de la lista. En el panel se resaltará el elemento HTML. Anota su etiqueta y clase: ese es el selector del enlace a la reseña.
- De la misma manera encuentra los elementos de calificación (normalmente un bloque con estrellas y un atributo numérico), fecha y texto breve.
- Desplaza la página hacia abajo y encuentra el bloque de paginación. Haz clic en el número 2 y observa cómo cambió la dirección: normalmente se añade el número de página. Esa es la plantilla para el recorrido.
- En el script: carga la página de la lista a través de requests con proxy, parsea con BeautifulSoup, extrae los enlaces a las reseñas y los avances, luego pasa a la siguiente página de la lista. Pausa entre páginas: 5-8 segundos; los agregadores son más sensibles que los mapas.
- Si necesitas el texto completo de la reseña y no el avance, haz una segunda pasada: por cada enlace carga la página de la reseña y extrae el texto principal, los bloques de pros y contras, la calificación por subcriterios.
iRecommend
La lógica es análoga a la de Otzovik: página del objeto con lista de reseñas y páginas separadas de reseñas. La diferencia está en el marcado y en que la calificación se expresa por la cantidad de estrellas rellenas: cuenta los elementos de estrella con clase activa, no busques un número.
Flamp y Zoon
Para estas plataformas usa el método del paso 4: abre la organización, cambia a Fetch/XHR, desplaza las reseñas y encuentra la solicitud en segundo plano. Flamp entrega reseñas con calificación, texto, fecha, respuesta oficial y utilidad. Zoon, con calificación, texto, fecha y respuesta de la organización. Ambas plataformas muestran el número total de reseñas para controlar la completitud.
Mini ejemplo de parseo de HTML
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
Los nombres de las clases aquí son condicionales: sustituye los reales que viste en el panel Elements. Las comprobaciones de elemento vacío son obligatorias: si el marcado de una reseña es distinto, el script no debe caerse por completo.
Consejo: En los agregadores las fechas a menudo se escriben con palabras: «ayer», «hace 3 días», «14 de marzo». Crea una función aparte de normalización de fechas que convierta esas cadenas al formato AAAA-MM-DD en relación con la fecha de recopilación. Sin ella, la ordenación por tiempo no funcionará.
Resultado esperado: CSV con reseñas de uno o dos agregadores, donde cada reseña tenga calificación, fecha y texto, y para Otzovik e iRecommend también el enlace a la página completa.
Posibles problemas: los selectores dejaron de encontrar elementos después de varias páginas. Causa: la plataforma entregó una página de verificación en lugar de la lista. Solución: revisa el título de la página después de cada carga; si aparecen indicios de verificación, pausa, cambia la IP, reintenta en unos minutos.
Verificación: El número de reseñas recopiladas de una página de lista es igual al número de reseñas que ves en esa página en el navegador. Si se recopilaron menos, uno de los selectores es demasiado estrecho.
Paso 7: Conecta los proxies móviles y configura la rotación
Objetivo del paso: hacer que el scraper de reseñas funcione de forma estable en decenas y cientos de objetos, distribuyendo la carga y sin crear un flujo anómalo desde una sola dirección.
Por qué precisamente proxies móviles
Todas las plataformas de esta guía están orientadas a la audiencia móvil: la mayoría de las reseñas se escriben y se leen desde smartphones. Las direcciones IP móviles de los operadores de telefonía son direcciones detrás de las cuales hay simultáneamente cientos y miles de abonados reales. Las plataformas no pueden bloquear esas direcciones sin perjudicar a los usuarios reales, por eso las tratan con tolerancia. Para la recopilación de reseñas, esto significa menos verificaciones, menos falsos positivos de la protección y una velocidad predecible.
Configuración de la conexión
- Entra en el panel de mobileproxy.space y abre la lista de tus proxies.
- Copia host, puerto, usuario y contraseña. Presta atención al protocolo: para requests es más cómodo el proxy HTTP, pero SOCKS5 también se soporta instalando el complemento
pip install requests[socks]. - Inserta los datos en la variable PROXY del script. Formato: protocolo, dos puntos, dos barras, usuario, dos puntos, contraseña, arroba, host, dos puntos, puerto.
- Copia del panel el enlace para cambiar la IP y guárdalo en la variable ROTATE_URL.
- Ejecuta una solicitud de prueba a través del proxy a cualquier servicio que muestre tu IP. En la respuesta debe aparecer la dirección de un operador móvil, no la de tu proveedor doméstico.
Estrategia de rotación
Hay dos enfoques, y ambos son funcionales.
- Rotación por tiempo. En el panel se define el intervalo de cambio automático de IP, por ejemplo cada 5 minutos. El script no hace nada: la dirección cambia sola. Sirve para recopilaciones largas y tranquilas.
- Rotación por evento. El script mismo activa ROTATE_URL en el momento necesario: después de cada N solicitudes, al pasar a un nuevo objeto o al recibir un código 429/403. Sirve cuando se necesita control.
Regla práctica para reseñas: cambia la IP al pasar a cada nuevo objeto y adicionalmente después de 40-60 solicitudes dentro de un mismo objeto. Después del cambio de IP, haz una pausa de 5-10 segundos: el operador necesita tiempo para que la nueva dirección esté activa.
Manejo de errores y reintentos
Añade a la función fetch_page un envoltorio: ante códigos 429, 403, 5xx o timeout, llamar a la rotación, esperar, repetir la solicitud hasta tres veces con pausa creciente (10, 30, 90 segundos). Si tres intentos no ayudaron, registrar el objeto en el archivo failed.txt y pasar al siguiente. Así un objeto problemático no detendrá toda la recopilación, y luego volverás a recolectar los faltantes por separado.
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
Cuántos hilos usar
Para principiantes, un solo hilo. Un proxy, una conexión, recorrido secuencial. Es lento, pero confiable: 500-1000 reseñas por hora sin un solo problema. Cuando compruebes que todo es estable, puedes añadir un segundo proxy y lanzar un segundo ejemplar del script sobre la otra mitad de la lista de objetos. Más de 3-4 hilos por plataforma para reseñas casi nunca es necesario.
Consejo: Coordina el User-Agent con el tipo de IP. Si vas por un proxy móvil, preséntate como un navegador móvil, como en el ejemplo del paso 4. La discordancia «IP móvil, pero Chrome de escritorio en Windows» no es crítica por sí sola, pero la coherencia reduce el número de verificaciones adicionales.
Resultado esperado: script que recorre todo sources.csv de una plataforma sin intervención manual, cambia la IP al pasar entre objetos y registra los objetos problemáticos en failed.txt.
Posibles problemas: después del cambio de IP las primeras solicitudes fallan con timeout. Solución: aumenta la pausa tras la rotación a 15 segundos. El proxy no conecta en absoluto: verifica si no está activada la lista blanca de IP en el panel y añade ahí la dirección de tu computadora.
Verificación: Lanza la recopilación de 10 objetos seguidos. En el log debe haber registros de cambio de IP entre objetos, el archivo failed.txt debe estar vacío o contener no más de un objeto, y el número total de filas en el resultado debe ser comparable con la suma de los contadores de reseñas en la plataforma.
Paso 8: Guarda, limpia y deduplica
Objetivo del paso: convertir el conjunto de CSV sin procesar de distintas plataformas en una tabla única y limpia, apta para el análisis.
Unión de archivos
- Asegúrate de que todos los archivos sin procesar estén en la carpeta raw y tengan los mismos encabezados según schema.txt.
- Crea el archivo merge.py. Con pandas, lee todos los CSV de la carpeta raw en un solo DataFrame: la función pandas.concat une una lista de tablas.
- Verifica los tipos: rating debe ser número, published_at debe ser fecha. Conviértelos con pandas.to_numeric y pandas.to_datetime con el parámetro errors='coerce', para que los valores incorrectos queden vacíos en lugar de romper el procesamiento.
Deduplicación
Los repetidos surgen por tres causas: solapamiento de páginas en la paginación, ejecuciones repetidas y una misma reseña publicada por el autor en varias plataformas. Procésalos en orden:
- Elimina los duplicados exactos por el par source y review_id: son los repetidos de la paginación y los reinicios. Método drop_duplicates con el parámetro subset.
- Encuentra los duplicados difusos dentro de una misma plataforma: mismo object_id, misma fecha y los primeros 100 caracteres del texto. Esto ocurre cuando la plataforma cambia el identificador al editar una reseña.
- Los duplicados entre plataformas no los elimines, márcalos con una columna aparte. El hecho de que una persona escribiera lo mismo en Otzovik y en Yandex Maps es informativo por sí mismo.
Limpieza del texto
- Elimina los espacios dobles y los saltos de línea dentro del texto.
- Elimina las frases de servicio de las plataformas que caen en el texto: «Leer completo», «Mostrar más».
- Sustituye las cadenas vacías en pros y cons por un valor vacío explícito, no por la cadena «no» o «-».
- Revisa la codificación: si ves caracteres corruptos, el archivo se guardó sin utf-8. Vuelve a guardarlo desde la fuente sin procesar.
Exportación del resultado
Guarda la tabla final en la carpeta clean bajo el nombre reviews_all_AAAA-MM-DD.xlsx con el método to_excel y en paralelo en CSV. Excel es cómodo para revisar, CSV para cargar en otros sistemas. Adicionalmente guarda un archivo aparte con el resumen: número de reseñas por plataforma, calificación promedio por objeto, proporción de reseñas con respuesta de la empresa.
Consejo: Añade a la tabla limpia una columna text_len con la longitud del texto. Las reseñas de menos de 30 caracteres casi siempre son inútiles para analizar causas, pero las reseñas largas con calificación 2-3 son oro: en ellas las personas explican detalladamente qué es exactamente lo que está mal.
Resultado esperado: un archivo limpio con reseñas de todas las plataformas, sin duplicados exactos, con tipos de datos correctos y un resumen.
Posibles problemas: tras la deduplicación desaparecieron demasiadas filas. Causa: review_id en alguna plataforma resultó vacío para todos los registros, y todos se contaron como duplicados. Solución: verifica el llenado de review_id por plataforma y para la plataforma problemática forma el identificador a partir de object_id, la fecha y el hash del texto.
Verificación: El número de filas en el archivo limpio no es más de un 5-10% menor que la suma de las filas de los archivos sin procesar. En la columna rating no hay valores fuera del rango 1-5, en la columna published_at no hay fechas del futuro.
Verificación del resultado: checklist y pruebas
Antes de sacar conclusiones basadas en las reseñas recopiladas, asegúrate de que la recopilación se hizo correctamente. Recorre el checklist completo.
Checklist de preparación
- Para cada objeto de sources.csv hay al menos una reseña en la tabla limpia, o el objeto está registrado en failed.txt con la causa.
- El número de reseñas por objeto difiere del contador en la plataforma en no más del 10%.
- La distribución de calificaciones por objeto coincide aproximadamente con la que muestra la plataforma.
- La reseña más reciente de la tabla está fechada no más tarde del día anterior respecto a la fecha de recopilación, si el objeto está activo.
- Todas las fechas están en formato AAAA-MM-DD, todas las calificaciones son números.
- No hay duplicados exactos por source y review_id.
- Los nombres de los autores o bien faltan, o bien están sustituidos por hashes, si la tarea no requiere nombres.
- Los archivos de datos sin procesar están guardados con fecha y no sobrescritos.
- Los tokens y los datos del proxy no están dentro del script, sino en un archivo de configuración aparte.
Cómo probar selectivamente
- Elige 10 reseñas al azar de la tabla con la función sample de pandas.
- Para cada una, abre la página del objeto en la plataforma y encuentra la reseña por un fragmento del texto.
- Contrasta la calificación, la fecha y la presencia de respuesta de la empresa.
- Si coincidieron 10 de 10, excelente. Si 8-9, revisa si las discrepancias están relacionadas con la edición de la reseña después de la recopilación. Si menos de 8, hay un error sistemático en el parseo; vuelve al paso correspondiente.
Indicadores de ejecución exitosa
El éxito se ve así: puedes abrir una sola tabla, filtrarla por cualquier plataforma y objeto, ordenarla por fecha y calificación y en cinco minutos responder la pregunta inicial del paso 1. Por ejemplo, ver que el 40% de las reseñas con calificación 1-2 sobre una cafetería en Yandex Maps durante los últimos tres meses mencionan el tiempo de espera, y que en 2GIS esas mismas personas elogian el café pero critican al personal. Si la pregunta recibe respuesta, la recopilación cumplió su tarea.
Errores típicos y soluciones
Aquí están reunidos los problemas con los que se topa casi todo el que configura un scraper de reseñas por primera vez. Formato: problema, causa, solución.
1. El script recopiló solo las primeras 20 reseñas
Causa: no se implementó la paginación o el parámetro de desplazamiento está mal definido.
Solución: vuelve al panel de desarrollador, desplaza la lista de reseñas dos veces y compara las direcciones de dos solicitudes consecutivas. El parámetro que cambió es el desplazamiento o el número de página. Asegúrate de que el script lo incrementa en el paso correcto.
2. Todas las reseñas llegan con la misma fecha: la fecha de recopilación
Causa: en el campo published_at se escribe collected_at, o la plataforma entrega la fecha en un campo con otro nombre.
Solución: abre el raw_json de una reseña y encuentra el campo con la fecha de publicación. Puede llamarse date, created, published, time, updatedAt. Corrige el nombre del campo en el script.
3. El texto en ruso se muestra mal en Excel
Causa: el CSV se guardó en utf-8 sin marca de orden de bytes, y Excel lo abre en otra codificación.
Solución: guarda con codificación utf-8-sig o exporta directamente a xlsx con to_excel.
4. La plataforma responde con código 403 a cada solicitud
Causa: no se pasaron los encabezados obligatorios, no se establecieron las cookies de sesión o la solicitud va demasiado frecuente.
Solución: compara con el comando cURL de referencia. Usa requests.Session y carga primero una página normal del objeto. Aumenta las pausas a 5 segundos. Cambia la IP a través del proxy y espera 10 minutos antes del reintento.
5. Las calificaciones recopiladas no coinciden con las reales
Causa: la plataforma guarda la calificación en otra escala (por ejemplo, de 0 a 100 o de 1 a 10) o en un campo aparte guarda la calificación por subcriterio, no la general.
Solución: contrasta tres reseñas manualmente. Determina la escala y llévala a cinco puntos dividiendo con redondeo. Documenta esto en schema.txt.
6. El número de reseñas es distinto en cada ejecución
Causa: no se fijó el orden, y la plataforma entrega conjuntos distintos en modo «por relevancia».
Solución: encuentra el parámetro de orden en la dirección de la solicitud y fija el orden por fecha. Recopila hasta encontrar una reseña más antigua que el período necesario.
7. El script se cae en un objeto y no sigue adelante
Causa: falta manejo de excepciones; cualquier error detiene el programa.
Solución: envuelve el procesamiento de cada objeto en try-except, escribe el error y el identificador del objeto en failed.txt y pasa al siguiente. Los faltantes los recopilarás en una ejecución aparte.
8. Después de una semana de funcionamiento, el script dejó de encontrar algo
Causa: la plataforma cambió la dirección de la solicitud, la estructura del JSON o los nombres de las clases en el HTML.
Solución: esto es parte normal de la vida de cualquier scraper. Repite el procedimiento de búsqueda de la solicitud del paso 4 y actualiza la dirección y los nombres de los campos. Mantén la lista de selectores y campos en un archivo de configuración aparte, para corregir un solo lugar y no todo el código.
9. El proxy funciona, pero la velocidad es muy baja
Causa: respuestas demasiado grandes (los marketplaces a veces entregan miles de reseñas en un solo archivo) o carga en la estación base del operador en hora pico.
Solución: aumenta el timeout, activa la compresión con el encabezado Accept-Encoding, programa las recopilaciones voluminosas para la noche.
Posibilidades adicionales para avanzados
Si ya dominas el escenario básico, aquí tienes hacia dónde crecer. Este bloque supone que escribes Python con seguridad.
Recopilación incremental
En lugar de una reextracción completa, guarda para cada objeto la fecha de la reseña más reciente recopilada. En la siguiente ejecución, recopila con orden por fecha y detente en cuanto encuentres una reseña no más nueva que la fecha guardada. Así la actualización diaria de 500 objetos toma minutos en lugar de horas, y la carga sobre las plataformas cae decenas de veces. Ten en cuenta que las reseñas pueden aparecer con fecha retroactiva tras la moderación: haz un solapamiento de 2-3 días.
Automatización del navegador para plataformas complejas
Google Maps y parte de las secciones de Ozon son más fáciles de recopilar a través de un navegador controlado: Playwright con un proxy móvil conectado abre la página, desplaza la lista de reseñas e intercepta las respuestas en segundo plano a través del manejador de eventos response. Obtienes el mismo JSON que en el panel de desarrollador, pero sin necesidad de reproducir encabezados y cookies manualmente. Playwright soporta emulación de dispositivos móviles, lo que combina perfectamente con la IP móvil. El precio es la velocidad y el consumo de memoria: un navegador consume 300-500 MB, así que lanza no más de 2-3 instancias.
Almacenamiento en base de datos
Cuando las reseñas superan las 100 mil, el CSV se vuelve incómodo. Pasa a SQLite (integrado en Python, archivo en disco, cero configuración) o PostgreSQL. La tabla reviews con un índice único por el par source y review_id protege automáticamente de duplicados: la inserción con INSERT y manejo del conflicto ON CONFLICT DO NOTHING descarta los repetidos a nivel de base de datos.
Enriquecimiento y análisis
- Tonalidad y temas. Pasa los textos por un modelo de lenguaje con un prompt del tipo «extrae 3 temas principales y la tonalidad general». Guarda el resultado en columnas aparte. Para decenas de miles de reseñas usa procesamiento por lotes y caché, para no pagar dos veces por un mismo texto.
- Dinámica de calificaciones. Construye la calificación promedio por semanas para cada objeto. Una caída brusca es señal de un problema que las reseñas explicarán con palabras.
- Velocidad de reacción de la empresa. La diferencia entre published_at y la fecha de la respuesta de la empresa es un indicador directo de la calidad del soporte, propio y de la competencia.
- Diccionario de dolores para publicidad. El análisis de frecuencia de sustantivos y adjetivos en reseñas con calificación 1-2 da una lista lista de formulaciones para creatividades y landing pages.
Monitoreo de la salud del scraper
Configura una ejecución diaria a través del planificador de tareas de Windows o cron y añade una comprobación sencilla: si en 24 horas se recopiló menos del 30% del promedio semanal o la proporción de errores superó el 10%, envía una notificación a Telegram a través de un bot. Así te enterarás del cambio de marcado en la plataforma el mismo día, y no un mes después, cuando necesites los datos.
Gestión del pool de proxies
Al trabajar con varias plataformas simultáneamente, asigna a cada una un proxy móvil aparte. Así el comportamiento en una plataforma no afecta la reputación de la dirección en otra. Haz la rotación para los mapas con menos frecuencia (los objetos suelen ser pequeños, 50-200 reseñas), para los marketplaces con más frecuencia (miles de reseñas por ficha). Lleva un diario: hora, plataforma, IP, código de respuesta. En una semana, por ese diario se verá qué intervalos de rotación son óptimos para tu perfil de carga.
FAQ: preguntas frecuentes sobre la recopilación de reseñas
¿Es legal recopilar reseñas de páginas públicas?
La recopilación de información públicamente accesible para análisis propio no está prohibida en sí misma, pero hay limitaciones: los términos de uso de las plataformas, los requisitos de la 152-FZ sobre el tratamiento de datos personales, la prohibición de crear obstáculos al funcionamiento del servicio. Respeta las pausas, anonimiza a los autores, no publiques las bases recopiladas y usa las APIs oficiales donde existan. Para el uso comercial de los datos, consulta con un abogado.
¿Se puede prescindir de la programación?
Parcialmente. Para tus propios objetos basta con los paneles de control. Para tareas pequeñas y puntuales sirven las extensiones de navegador tipo scraper que exportan a una tabla los elementos visibles en la página: tú desplazas las reseñas manualmente, la extensión recopila. Para la recopilación regular de decenas de objetos, el script sigue siendo más cómodo y confiable, y los fragmentos listos de esta guía se pueden usar casi sin cambios.
¿Para qué proxies móviles si solo tengo 10 objetos?
Para 10 objetos y una recopilación puntual puedes intentarlo sin ellos. Pero en cuanto empieces a actualizar los datos con regularidad o amplíes la lista, las solicitudes desde una sola IP doméstica empezarán a recibir verificaciones adicionales. El proxy móvil resuelve esto de antemano, y el costo no es comparable con el tiempo que se va en resolver bloqueos.
¿Cuántas reseñas por hora se pueden recopilar realmente?
En un solo hilo con pausas de 2-5 segundos, de 500 a 1500 reseñas por hora según el tamaño de la porción en la plataforma. Los marketplaces que entregan cientos de reseñas en una sola respuesta dan más; los agregadores con HTML paginado, menos. Para la mayoría de las tareas analíticas es más que suficiente.
¿Cómo recopilar solo las reseñas nuevas y no todo de nuevo?
Guarda la fecha de la última reseña recopilada por cada objeto, ordena por fecha al solicitar y detente en la primera reseña ya conocida. Más detalles en el bloque sobre recopilación incremental.
Reseñas sin texto, solo con calificación: ¿recopilar o no?
Depende de la tarea. Para calcular la calificación promedio y su dinámica, sí, influyen en las cifras. Para analizar causas, no, se pueden filtrar en el procesamiento. Recopila todo y filtra en la etapa de análisis: volver a recopilar es más caro.
¿Qué hacer si la plataforma muestra un captcha?
Detener la recopilación 10-15 minutos, cambiar la IP a través del proxy, reducir la frecuencia de solicitudes y revisar los encabezados. El captcha es señal de que tu comportamiento parece atípico. La tarea es hacerlo típico, no atravesar la verificación.
¿Cómo almacenar los nombres de los autores sin infringir la ley?
Lo mejor es no almacenarlos en absoluto. Si necesitas distinguir las reseñas de un mismo autor, usa un hash unidireccional del nombre. Si los nombres son necesarios (por ejemplo, para responder al cliente a través del panel), guárdalos solo en el marco del trabajo con tu propia organización y no los transfieras a terceros.
¿Con qué frecuencia se rompen los scrapers de reseñas?
Las grandes plataformas cambian las solicitudes internas y el marcado varias veces al año. Con un buen monitoreo, la reparación toma 20-40 minutos: repetir la búsqueda de la solicitud y actualizar los campos. Mantén los selectores y las direcciones en un archivo de configuración, y las correcciones serán puntuales.
¿Se puede recopilar de todas las plataformas con un solo script?
Sí, si haces un esqueleto común (proxy, reintentos, escritura al esquema) y para cada plataforma una función adaptadora aparte que conozca la dirección de la solicitud y los nombres de los campos. Así están hechos los proyectos maduros: un módulo común y una decena de adaptadores pequeños.
Conclusión
Resumamos. Has recorrido el camino desde plantear la pregunta hasta una tabla limpia de reseñas de tres tipos distintos de plataformas. Aprendiste a encontrar las solicitudes en segundo plano a través del panel de desarrollador, a reproducirlas con un script, a parsear HTML donde el JSON no está disponible, a conectar proxies móviles con rotación, a manejar errores y reintentar solicitudes, a unir y limpiar datos. Por separado, te familiarizaste con las vías oficiales de exportación y el marco legal, lo que protege tanto los datos como a ti.
Lo principal que conviene llevarse: las reseñas son un tipo de datos especial con su propia dinámica. Aparecen constantemente, se editan, pasan por moderación y contienen información personal. Por eso el scraper de reseñas no es un script puntual, sino un pequeño sistema: recopilación, almacenamiento de datos sin procesar, adaptación al esquema, deduplicación, monitoreo. Cada elemento de este sistema ya lo construiste en su forma básica.
Qué hacer después:
- Amplía sources.csv hasta una lista real de objetos y realiza la recopilación completa.
- Configura una ejecución incremental diaria con el planificador.
- Añade al menos una capa analítica: dinámica de la calificación o tematización de las reseñas negativas.
- Lleva un diario de cambios de las plataformas y actualiza los adaptadores a medida que se rompan.
Hacia dónde desarrollarse. El siguiente nivel es la automatización de la reacción: notificaciones al equipo sobre una reseña negativa dentro de la hora siguiente a su publicación, informes comparativos de competidores una vez por semana, integración de los temas de las reseñas en el plan de producto y en las hipótesis publicitarias. Los datos ya los tienes. Falta convertirlos en decisiones, y ahí empieza la parte más interesante del trabajo.
