Cómo armar un corpus para un sistema RAG con proxies móviles y no llenarlo de basura: guía paso a paso
Contenido del artículo
- Introducción: qué obtendrás y para quién es
- Preparación previa: herramientas, accesos, entorno
- Conceptos básicos en lenguaje sencillo
- Paso 1: definimos los límites del corpus y armamos el mapa de fuentes
- Paso 2: conectamos el proxy móvil y verificamos que las peticiones pasen por él
- Paso 3: escribimos un recolector cuidadoso con límites, rotación y registro
- Paso 4: extraemos texto limpio del html y los documentos
- Paso 5: filtramos la basura: deduplicación, plantillas, calidad, idioma
- Paso 6: etiquetamos los metadatos y armamos el corpus final
- Verificación del resultado: lista de control y prueba del corpus
- Errores típicos y soluciones al recolectar un corpus para rag
- Posibilidades adicionales para avanzados
- Faq: preguntas frecuentes sobre la recolección de un corpus
- Conclusión: qué se hizo y hacia dónde seguir
Introducción: qué obtendrás y para quién es
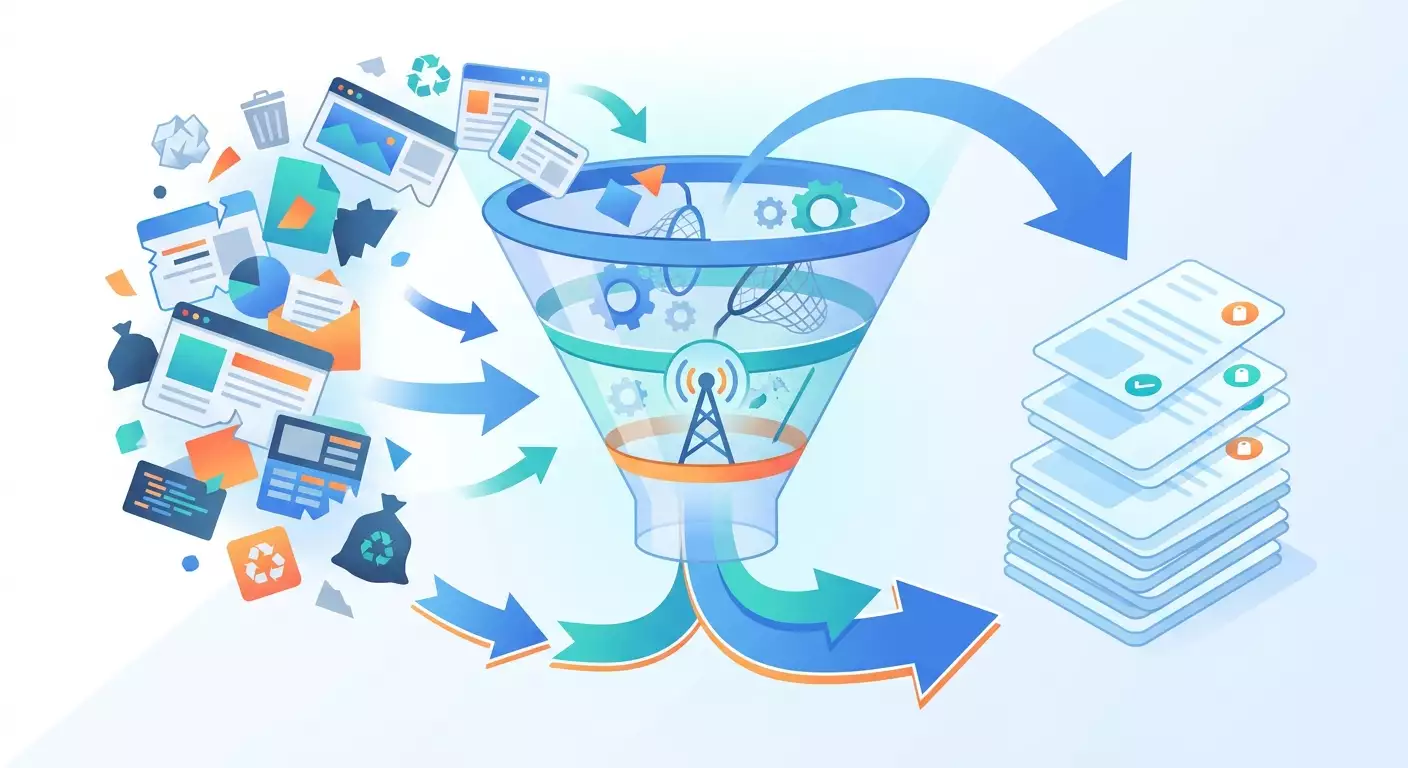
Un sistema RAG es tan bueno como el corpus sobre el que responde. Puedes tomar el modelo de lenguaje más potente, conectar una base vectorial costosa y obtener como resultado una sarta de barbaridades si en el corpus se colaron menús del sitio, pies de página con copyright, duplicados de un mismo artículo en cinco versiones y páginas de "producto temporalmente no disponible". El modelo no distingue basura de conocimiento. Solo busca fragmentos similares y arma la respuesta con ellos.
Esta guía paso a paso está dedicada a una sola etapa: la recolección del corpus. No vamos a analizar la arquitectura de la base vectorial, la elección de embeddings ni la configuración de chunks; sobre eso hay materiales aparte en el blog. Aquí nos detendremos justo en el límite: en tu disco tienes un conjunto limpio, etiquetado y deduplicado de documentos en formato JSONL, listo para entregar a cualquier pipeline de indexación.
Qué obtendrás al final:
- una lista de fuentes con límites claros: qué recolectamos y qué no;
- un recolector funcional en Python que navega a través de un proxy móvil, respeta los límites y no tumba sitios ajenos;
- una carpeta con páginas y documentos en bruto, cada uno con metadatos;
- un script para extraer el texto principal sin navegación, publicidad ni bloques plantilla;
- filtros de calidad y deduplicación que descartan la basura antes de que llegue al índice;
- el archivo final del corpus y un informe con cifras que demuestran que todo se hizo bien.
Para quién es esta guía. Para marketers y dueños de negocios que quieren armar una base de conocimiento de su nicho y construir un asistente sobre ella. Para afiliados que necesitan un corpus sobre ofertas, landings y reglas de plataformas publicitarias. Para desarrolladores que ya conectaron proxies a sus scripts y ahora quieren hacerlo con cuidado y de forma sistemática. El texto principal está escrito para principiantes y al final hay un bloque aparte para avanzados.
Qué necesitas saber de antemano. Saber ejecutar comandos en la terminal y abrir archivos en un editor de texto. Noción básica de Python al nivel de "entiendo qué hace un bucle for". Tener acceso a un proxy móvil: dirección, puerto, usuario, contraseña y enlace para cambiar IP.
Cuánto tiempo tomará. Preparar el entorno, unos 30 minutos. Recorrer todos los pasos, de 3 a 5 horas según el volumen del corpus. La recolección en sí de varios miles de páginas puede correr en segundo plano varias horas, pero tu participación durante ese tiempo no es necesaria.
Preparación previa: herramientas, accesos, entorno
Antes de escribir la primera línea de código, pongamos en orden el espacio de trabajo. Esto ahorrará horas de depuración más adelante.
Requisitos del sistema
- Una computadora o servidor con Windows 10/11, macOS o Linux. Para recolectar decenas de miles de páginas es más cómodo un VPS alquilado, pero para un primer corpus basta una laptop.
- Al menos 8 GB de memoria RAM. La deduplicación de corpus grandes consume memoria.
- Espacio libre en disco: mínimo 5 GB. El HTML en bruto ocupa entre 5 y 10 veces más que el texto limpio, y guardaremos ambos.
- Internet estable. El proxy agrega latencia, así que un canal doméstico lento alargará notablemente la recolección.
Qué instalar
- Python 3.11 o superior. Descarga el instalador del sitio oficial; al instalar en Windows marca la casilla "Add Python to PATH". Verifica en la terminal:
python --version. Debe aparecer una línea comoPython 3.12.x. - Entorno virtual. Crea una carpeta de proyecto, por ejemplo
rag-corpus, entra en ella y ejecutapython -m venv venv. Actívalo: en Windowsvenv\Scripts\activate, en macOS y Linuxsource venv/bin/activate. Al inicio de la línea de la terminal aparecerá(venv). - Bibliotecas. Instálalas con un solo comando:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm. La instalación tomará de 1 a 3 minutos. - Editor de texto con resaltado de código: VS Code, PyCharm Community o cualquier otro.
Accesos al proxy
Abre el panel de tu servicio de proxies. En la tarjeta del proxy móvil que compraste encuentra cuatro valores: host (dirección IP o nombre de dominio), puerto para HTTP y puerto para SOCKS5, usuario y contraseña. Copia aparte el enlace para cambiar IP: es una URL a la que basta con hacer una petición GET para que el proxy obtenga una nueva dirección del operador. Anota todo esto en un archivo .env en la carpeta del proyecto, no directamente en el código.
Estructura de carpetas
Crea dentro del proyecto las siguientes carpetas: raw para páginas en bruto, clean para el texto extraído, corpus para el archivo final, logs para los registros. Las carpetas vacías al inicio son normales.
Copias de seguridad
El corpus se recolecta durante mucho tiempo y perderlo duele. Acuerda contigo mismo una regla: la carpeta raw nunca se sobrescribe, solo se amplía. Después de cada etapa grande archiva el resultado: tar -czf raw_backup_2026-03-01.tar.gz raw/ en Linux y macOS o con el compresor integrado de Windows. Si te equivocas en los filtros y borras de más, siempre podrás volver a los datos en bruto sin recolectarlos de nuevo.
Consejo: Crea desde el inicio un archivo sources.md y anota cada decisión: qué sitios tomas, qué secciones excluyes, por qué. Dentro de un mes, cuando el asistente empiece a responder raro, este archivo te salvará la tarde.
Conceptos básicos en lenguaje sencillo
Si es la primera vez que recolectas datos para un sistema RAG, varios términos aparecerán en cada paso. Los repasamos brevemente.
Qué es RAG y por qué el corpus importa más que el modelo
RAG (Retrieval-Augmented Generation) es un enfoque en el que el modelo de lenguaje, antes de responder, recibe una selección de fragmentos de tu base de conocimiento. El modelo no "conoce" tus documentos, lee los fragmentos encontrados y responde con base en ellos. De ahí una regla simple: si en la base hay basura, la búsqueda tarde o temprano la sacará, y la respuesta se basará en la línea "Suscríbete al boletín" en lugar de en la instrucción. Por eso la etapa de recolección del corpus no se puede saltar.
Corpus, documento, metadatos
Corpus es todo el conjunto de textos que irán al sistema RAG. Documento es una unidad de sentido: un artículo, una página de ayuda, un PDF de instrucciones, una ficha de producto. Metadatos es el pasaporte del documento: de dónde se tomó, cuándo se recolectó, en qué idioma, quién es el autor, a qué sección pertenece. Sin metadatos no podrás actualizar el corpus, ni explicar al usuario de dónde salió la respuesta, ni filtrar lo obsoleto.
Proxy móvil y para qué sirve al recolectar
Un proxy móvil es un servidor intermediario que emite tus peticiones a internet a través de una dirección IP de un operador celular. Para recolectar un corpus resuelve tres problemas prácticos. Primero: distribución de la carga. En lugar de golpear el sitio desde una sola dirección, navegas desde varias, y cada fuente ve un tráfico tranquilo y poco frecuente. Segundo: geografía. Muchos sitios muestran contenido, precios y disponibilidad distintos según la región, y un proxy móvil de la ciudad correcta te da exactamente la versión de la página que ven tus clientes. Tercero: estabilidad de sesiones largas. La rotación de IP mediante enlace permite continuar la recolección durante horas sin depender de una sola dirección.
Rotación es el cambio de dirección IP. Puede ser por horario (cada N minutos) o bajo demanda (accionas el enlace cuando lo necesitas). En la recolección del corpus es más cómoda la segunda: cambias de fuente, cambias de dirección.
Qué consideramos basura
En el contexto del corpus, basura es todo lo que no aporta conocimiento sobre tu tema pero ocupa lugar en el índice y arruina la búsqueda:
- navegación, menús, pies de página, "migas de pan", formularios de suscripción;
- duplicados exactos y casi exactos de un mismo texto en distintas direcciones;
- páginas de relleno: "Página no encontrada", "Producto agotado", "En mantenimiento";
- textos en otro idioma, si el corpus es monolingüe;
- páginas truncadas, donde el proxy o el sitio devolvieron la mitad del HTML;
- contenido ajeno que no tienes derecho a usar.
Marco legal
Recolecta solo datos abiertos, accesibles sin autenticación, y tus propios documentos. Respeta el archivo robots.txt: es la lista de reglas del sitio sobre qué secciones se pueden recorrer automáticamente. No recolectes datos personales de terceros: nombres con teléfonos, direcciones, cuentas. Si construyes un corpus con tus documentos internos, asegúrate de tener derecho a usarlos. El proxy en esta guía se usa como herramienta de recolección distribuida honesta, no como forma de hacer lo que la fuente prohibió.
Paso 1: Definimos los límites del corpus y armamos el mapa de fuentes
Objetivo de la etapa: obtener un archivo con la lista de fuentes, donde para cada una se especifique qué URLs tomamos, cuáles excluimos, con qué profundidad recorremos y cuántas peticiones por minuto permitimos.
La causa más frecuente de un corpus basura no son errores técnicos, sino la ausencia de límites. La persona lanza el recolector "a todo el sitio", obtiene 40 mil páginas, de las cuales 800 son del tema, y luego pasa una semana limpiando. Hagamos lo contrario: primero el mapa, después la recolección.
Instrucciones
- Formula las preguntas que debe responder tu sistema RAG. Escribe 20-30 preguntas reales de usuarios. Por ejemplo, para una base de conocimiento de un servicio de proxies: "Cómo cambiar la IP por enlace", "Por qué el proxy responde lento", "Qué puertos se soportan". Estas preguntas serán tu conjunto de prueba en la etapa de verificación.
- Para cada pregunta anota dónde está la respuesta. Sección de ayuda, documentación, artículos del blog, reglamentos en PDF, páginas de productos. Todo lo que no esté en esta lista no entra al corpus.
- Abre cada fuente en el navegador y estudia la estructura de direcciones. Normalmente el contenido útil está bajo prefijos claros:
/help/,/docs/,/blog/,/faq/. Y la basura bajo otros:/tag/,/search?,/cart/,/author/, páginas de paginación tipo?page=. - Revisa el robots.txt de la fuente. Abre
https://dominio/robots.txt. Encuentra las líneasDisallow: esas rutas las excluimos sin discusión. Si allí también apareceCrawl-delay, anótalo como pausa mínima entre peticiones. - Busca el mapa del sitio. A menudo se indica en robots.txt con la línea
Sitemap:, o está en la dirección/sitemap.xml. El mapa del sitio es una lista lista de direcciones que te ahorrará el recorrido recursivo de enlaces y la basura asociada. - Define la carga. Para sitios pequeños, no más de 10-15 peticiones por minuto. Para portales grandes con CDN se permite hasta 30. Si dudas, elige menos: el corpus no corre prisa.
- Define la geografía. Si el contenido depende de la región (precios, envío, disponibilidad), decide desde qué ciudad debe "mirar" tu recolector y elige el proxy móvil correspondiente.
- Plásmalo todo en el archivo
sources.json.
Ejemplo de registro para una fuente:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]El campo rotate_every define cada cuántas peticiones el recolector accionará el enlace de cambio de IP. Reemplaza las comillas simples por dobles al guardar en un archivo JSON real; aquí se muestran para mayor claridad.
Atención: No agregues a las fuentes sitios donde el contenido útil solo se ve tras iniciar sesión. Primero, eso viola el acuerdo de usuario de la mayoría de las plataformas. Segundo, ese corpus no se puede actualizar ni distribuir legalmente dentro de la empresa.
Consejo: Crea una fuente aparte para tus propios documentos: una carpeta con PDF, DOCX y exportaciones de tu CRM o base de conocimiento. No hay que descargarlos por proxy, pero los procesaremos y limpiaremos con el mismo pipeline que las páginas web.
Verificación: Tienes el archivo sources.json donde cada fuente tiene prefijos de inclusión, patrones de exclusión, límite de peticiones e idioma. Abre 5 direcciones aleatorias del mapa del sitio que caigan dentro de tus filtros y confirma que cada una tiene texto sustancial, no un catálogo de enlaces.
Posibles problemas
- El sitio no tiene mapa del sitio. Arma la lista de direcciones manualmente desde varias páginas de índice, o con un recorrido simple de enlaces solo dentro de los prefijos permitidos a profundidad 2.
- El mapa del sitio contiene 100 mil direcciones. Filtra por prefijos, luego toma una muestra de 200 direcciones, recolecta y evalúa la calidad antes de lanzar todo.
- El contenido útil está repartido en distintos dominios. Crea un registro aparte en
sources.jsonpara cada dominio, con su propio límite y su propia geografía.
Paso 2: Conectamos el proxy móvil y verificamos que las peticiones pasen por él
Objetivo de la etapa: confirmar que el script realmente navega a través del proxy móvil, que la rotación funciona y que las latencias son aceptables para la recolección.
Instrucciones
- Crea el archivo
.enven la raíz del proyecto e ingresa los valores del panel:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=tu_usuario PROXY_PASS=tu_contraseña ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxCada valor en su propia línea. Agrega .env a .gitignore si usas control de versiones.
- Crea el archivo
proxy_check.pycon el siguiente contenido:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP sin proxy:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP vía proxy:', ip1, 'en', round(time.time() - t0, 2), 'seg') print('Cambiando IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP tras rotación:', ip2) print('Rotación funcionó:', ip1 != ip2)Instala previamente pip install python-dotenv. Las líneas de código en el archivo real van cada una en su propia línea.
- Ejecuta:
python proxy_check.py. - Lee la salida. La primera IP debe ser la de tu casa o servidor. La segunda debe ser distinta y pertenecer a un operador celular. La tercera debe diferir de la segunda, y la última línea debe mostrar
True. - Mide la latencia. Si una petición a través del proxy tarda más de 5-6 segundos, la recolección será lenta. Verifica que el proxy elegido esté geográficamente cerca de los sitios objetivo o contacta al soporte del servicio.
- Prueba SOCKS5 como alternativa. Si el puerto HTTP da resultados inestables, reemplaza
http://enproxy_urlporsocks5h://y el puerto por el de SOCKS5 del panel. Necesitaráspip install requests[socks]. El sufijohes importante: obliga al proxy a resolver los nombres de dominio por sí mismo.
Atención: No ejecutes la rotación de IP más seguido de lo que permite tu plan. La mayoría de los proxies móviles tienen un intervalo mínimo entre cambios, normalmente de 30 segundos a 2 minutos. Las peticiones demasiado frecuentes al enlace de rotación se ignoran o bloquean temporalmente la función.
Consejo: Haz cinco mediciones de latencia seguidas y anota la mediana. Ese número te servirá en el siguiente paso para fijar bien los timeouts: el timeout debe ser aproximadamente 4-5 veces mayor que la latencia típica.
Verificación: El script muestra tres direcciones IP distintas, la línea Rotación funcionó: True, y la latencia típica a través del proxy no supera los 3-4 segundos. Si todo está así, el proxy está listo para trabajar.
Posibles problemas
- Error 407 Proxy Authentication Required. Verifica usuario y contraseña, asegúrate de que no tengan espacios extra. Si la contraseña tiene caracteres
@o:, codifícalos conurllib.parse.quote. - Error Connection refused o timeout. Puede que el proxy esté vinculado a tu IP blanca. Entra al panel y agrega la dirección actual del servidor a la lista de permitidas, o cambia a autenticación por usuario y contraseña.
- La IP tras la rotación no cambió. Aumenta la pausa después de la petición al enlace de rotación a 15-20 segundos. Algunos operadores no asignan la nueva dirección al instante.
- Errores SSL. Actualiza la biblioteca
certificonpip install -U certifi. No desactives la verificación de certificados converify=False: eso no es seguro.
Paso 3: Escribimos un recolector cuidadoso con límites, rotación y registro
Objetivo de la etapa: obtener un script que recorra las direcciones del mapa del sitio, respete robots.txt y los límites, navegue por el proxy, cambie IP según lo previsto, guarde el HTML en bruto y mantenga un registro donde se vea cada petición.
Aquí es importante entender la filosofía. Un buen recolector para un sistema RAG es lento, cortés y paranoicamente detallado en los logs. Un crawler rápido y agresivo te juntará una montaña de páginas truncadas y errores 429, y después no sabrás qué de eso es basura.
Instrucciones
- Crea el archivo
fetch.py. Estructura del script: carga de configuración, análisis del mapa del sitio, filtrado de direcciones, bucle de peticiones con pausas, guardado del resultado. - Carga el mapa del sitio y filtra las direcciones. El mapa del sitio es un XML donde cada dirección está en la etiqueta
loc. Parsea conxml.etree.ElementTree. Deja solo las direcciones que empiecen coninclude_prefixesy no contengan ninguno de losexclude_patterns. Guarda el resultado enurls_help_center.txty revísalo con los ojos. - Conecta la verificación de robots.txt. Usa
urllib.robotparser.RobotFileParser: carga el archivo una vez por dominio y antes de cada petición preguntacan_fetch(user_agent, url). Las direcciones prohibidas sáltalas y escribe en el registro con la marcarobots_disallow. - Define un User-Agent honesto. Por ejemplo:
CorpusCollector/1.0 (+contact: data@tuempresa.com). El dueño del sitio debe entender quién vino y cómo contactarle. No es solo ética, también práctica: un agente claro cae menos en restricciones automáticas. - Implementa las pausas. De
rate_per_minutecalcula la pausa base:60 / rate_per_minutesegundos. Agrega un componente aleatorio del 20-40 por ciento para que las peticiones no vayan a metrónomo. Si en robots.txt hayCrawl-delay, toma el máximo de los dos valores. - Implementa la rotación. Cuenta las peticiones y, cuando el contador llegue a
rotate_every, llama al enlace de cambio de IP, espera 10 segundos, reinicia el contador. También conviene rotar al pasar a la siguiente fuente. - Procesa las respuestas. El código 200 se guarda. Los códigos 301 y 302 los maneja
requestssolo, pero anota la dirección final: te hará falta para la deduplicación. El código 404 lo escribimos en el registro y lo saltamos. El código 429 o 503 significa "demasiado frecuente": haz una pausa de 5 minutos, aumenta la pausa base una vez y media y reintenta una vez. Si el reintento no funcionó, sáltalo y sigue. - Guarda el HTML en bruto junto con su pasaporte. Para cada página escribe una línea en el archivo
raw/help_center.jsonl.
Fragmento clave del código de guardado y del bucle:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))Fíjate en la condición len(html) > 2000. Una página con texto sustancial casi nunca tiene menos de dos kilobytes de HTML. Es el primer filtro, el más grueso, y descarta respuestas vacías y páginas de relleno desde la entrada.
- Ejecuta sobre una muestra. La primera corrida hazla sobre 50 direcciones. Mira el registro, abre un par de HTML guardados en el navegador. Confirma que son las páginas correctas.
- Lanza la recolección completa. En el servidor usa
nohup python fetch.py &oscreenpara que el proceso sobreviva al cierre de la terminal. Recolectar 3000 páginas a 12 peticiones por minuto tomará unas 4-5 horas.
Atención: No lances varias copias del recolector sobre el mismo sitio en paralelo a través del mismo proxy. La rotación de IP no anula los límites de carga del servidor de origen. Si quieres acelerar, paraleliza por sitios distintos, no por uno solo.
Consejo: Anota en el registro la IP del proxy desde la que se hizo cada petición. Cuando en la etapa de limpieza aparezca un lote de páginas truncadas, por la IP y la hora verás de inmediato si fue un fallo de una sesión concreta, y podrás recolectar solo esa de nuevo.
Consejo: Agrega al recolector la reanudación: antes de arrancar, lee las direcciones ya recolectadas de raw/*.jsonl y sáltalas. Así una caída de conexión o un reinicio del servidor no te obligarán a empezar de cero.
Verificación: En la carpeta raw hay un archivo JSONL, el número de líneas se acerca al número de direcciones con estado 200 en el registro, y una línea elegida al azar contiene los campos url, fetched_at, proxy_ip y el HTML completo. La proporción de errores y omisiones en el registro no supera el 5 por ciento.
Posibles problemas
- Muchas respuestas 429. Vas demasiado rápido para ese sitio. Reduce
rate_per_minutea la mitad, aumentarotate_everypara que la rotación no parezca un pico desde direcciones nuevas. - Las páginas llegan vacías aunque el estado sea 200. El contenido se dibuja con JavaScript. Esas fuentes requieren renderizado de navegador, del que hablamos en el bloque avanzado. Por ahora márcalas en
sources.jsoncon la banderaneeds_js: true. - La recolección avanza, pero muy lento. Verifica la latencia del proxy del Paso 2, asegúrate de que el timeout no esté en 120 segundos cuando la latencia típica es 2, porque cada página colgada se comerá dos minutos.
- El script se cae por codificación. Usa
r.textcon verificación der.encoding; si el sitio entrega mal la codificación, ponr.encoding = r.apparent_encodingantes de leer.
Paso 4: Extraemos texto limpio del HTML y los documentos
Objetivo de la etapa: convertir el HTML en bruto y los archivos en texto limpio, donde solo quede el contenido principal de la página: título, párrafos, listas, tablas, sin menús, pies de página, anuncios ni widgets.
Es el momento en que nace o muere la calidad del corpus. El enfoque ingenuo de "quitar todas las etiquetas" deja en el texto los ítems del menú, los botones "Comprar", el texto del banner de cookies y las listas de artículos similares. Todo eso luego aflora en las respuestas del sistema RAG.
Instrucciones para páginas web
- Crea el archivo
extract.py. Leeraw/*.jsonllínea a línea y escribe el resultado enclean/*.jsonl. - Usa la biblioteca
trafilaturapara extraer el texto principal. Está entrenada para encontrar el área de contenido de la página y descartar los bloques plantilla.
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- El parámetro
favor_precision=Truehace que la biblioteca sea más estricta: preferirá perder un trozo de texto antes que arrastrar el menú. Para un corpus RAG es la elección correcta. Si notas que se pierden bloques necesarios, por ejemplo tablas de características, cambia afavor_recall=Truepara esa fuente concreta. - Agrega un método de respaldo. Si
trafilaturadevuelveNoneo un texto de menos de 200 caracteres, intenta extraer el contenido por selector CSS que encuentres a mano: abre la página en el navegador, pulsa F12, encuentra el bloque con el texto principal, copia su clase, por ejemploarticle-body. UsaBeautifulSouppara recortar solo ese bloque. Anota el selector ensources.jsoncomocontent_selector. - Normaliza el texto. Reemplaza los espacios duros por espacios normales, colapsa tres o más saltos de línea en dos, elimina espacios al inicio y al final de las líneas. No cambies mayúsculas ni elimines signos de puntuación: eso empeorará la búsqueda.
- Guarda junto con los metadatos originales. Copia del registro en bruto
url,final_url,fetched_at, agregasourcedesources.json, los campos de la extracción y la longitud del texto en caracteres.
Instrucciones para PDF y DOCX
- PDF. Usa
pypdf: abre el archivo, recorre las páginas, llama apage.extract_text()y une. Guarda el número de página de cada fragmento: son metadatos valiosos, con ellos el usuario podrá encontrar el lugar en el original. Si el texto vuelve vacío, el PDF contiene escaneos, no texto: esos archivos déjalos en una carpeta aparte, el OCR queda fuera del alcance de esta guía. - DOCX. Usa
python-docx: recorredocument.paragraphsydocument.tables. Los encabezados en Word tienen estiloHeading 1,Heading 2: guárdalos como líneas aparte con una marca, te servirán para cortar el documento más adelante. - Quita los encabezados y pies. En los PDF de instrucciones se repite en cada página el nombre de la empresa, el número de versión y "Página 3 de 40". Reúne todas las líneas del documento, encuentra las que se repiten en más de la mitad de las páginas y elimínalas.
Atención: No elimines las tablas por estética. En instrucciones, tarifas y características son precisamente las tablas las que contienen las respuestas a preguntas concretas: "cuál es el límite", "cuánto cuesta", "cuál es el puerto". Guárdalas línea a línea, separando las celdas con tabulación o barra vertical.
Consejo: Después de la extracción, toma 20 documentos al azar y léelos completos. No los recorras, léelos. Una sola revisión así encuentra más problemas sistemáticos que cualquier filtro automático: por ejemplo, verás que en todas las páginas del blog se pegó al final del texto un bloque "Lee también" con tres titulares.
Verificación: En la carpeta clean hay archivos JSONL. El número de registros no es menor al 80 por ciento del número de páginas en bruto. En 10 registros al azar el texto empieza con el título o el primer párrafo del artículo, no con ítems del menú, y termina en el último párrafo sustancial, no con la firma "Todos los derechos reservados".
Posibles problemas
- Se extrae muy poco texto. Sitio con maquetación no estándar. Agrega
content_selectory una ruta de respaldo conBeautifulSoup. - En el texto quedan botones e ítems del menú. Activa
favor_precisiony para casos persistentes agrega una lista de líneas de parada: líneas cortas como "Compartir", "Leer más", "Arriba" elimínalas si están en línea aparte. - El PDF devuelve texto al revés o con palabras partidas. Prueba
pdfplumberen lugar depypdf, funciona mejor con columnas.
Paso 5: Filtramos la basura: deduplicación, plantillas, calidad, idioma
Objetivo de la etapa: descartar duplicados, páginas de relleno, bloques plantilla, textos en otro idioma y documentos demasiado cortos o rotos, dejando solo lo que aporta conocimiento.
Aun después de una extracción cuidadosa queda en el corpus entre un 15 y un 40 por ciento de basura. Eso es normal. Lo anormal es dejarla pasar al índice.
Instrucciones
- Crea el archivo
filter.py, que leeclean/*.jsonl, aplica los filtros en orden, escribe los documentos que pasan encorpus/filtered.jsonly los descartados encorpus/rejected.jsonlindicando la causa. - Filtro 1: longitud mínima. Los documentos de menos de 300 caracteres casi siempre son páginas de relleno, avances o errores de extracción. Descarta con causa
too_short. Para fichas de producto el umbral puede bajar a 150. - Filtro 2: frases de páginas de relleno. Arma una lista de frases que delatan una página vacía: "página no encontrada", "producto no disponible", "acceso restringido", "active javascript", "en mantenimiento". Si esa frase aparece en los primeros 300 caracteres y todo el texto es menor a 1500, descarta con causa
placeholder. - Filtro 3: idioma. Usa
langdetect.detectsobre los primeros 1000 caracteres. Si el idioma no coincide con el indicado en la fuente, descarta con causawrong_lang. Ten en cuenta que en textos cortos el detector se equivoca, así que aplícalo después del filtro de longitud. - Filtro 4: duplicados exactos. Normaliza el texto: minúsculas, colapsar espacios, quitar signos de puntuación. Calcula
sha1. Si el hash ya apareció, descarta con causaexact_dupy guarda la referencia al original. Fuentes típicas de duplicados exactos: la misma página enhttpyhttps, conwwwy sin, con el parámetro?utm_sourcey sin, y las páginas para imprimir. - Filtro 5: casi duplicados. Aquí necesitas MinHash de la biblioteca
datasketch. Divide el texto normalizado en shingles de 5 palabras, construyeMinHashcon 128 permutaciones, colócalo enMinHashLSHcon umbral 0.85. Un documento que ya tiene un vecino parecido en el índice se descarta con causanear_dup. Así se van las versiones de un artículo con distintas fechas, las páginas de producto que difieren solo en el color y las noticias reeditadas.
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- Filtro 6: líneas plantilla. Reúne todas las líneas de todos los documentos de una misma fuente y cuenta en qué porcentaje de documentos aparece cada una. Las líneas que aparecen en más del 30 por ciento de los documentos y tienen menos de 200 caracteres son plantilla: descargos, firmas, llamados a suscribirse. Elimínalas de todos los documentos. No es descartar el documento, es limpiarlo por dentro.
- Filtro 7: calidad del texto. Calcula métricas simples: la proporción de letras entre todos los caracteres debe superar 0.6; la longitud media de palabra entre 3 y 12; la proporción de líneas que terminan en punto, mayor a 0.3 para artículos. Los documentos fuera de esos límites son, por regla general, tablas de códigos, volcados o extracciones rotas. Descarta con causa
low_quality, pero revisa con los ojos lo descartado: para documentación técnica los umbrales deben suavizarse. - Filtro 8: páginas truncadas. Compara
html_lendel registro en bruto con la mediana de la fuente. Si el HTML es menor al 30 por ciento de la mediana y el texto se corta a mitad de frase sin punto, es una respuesta truncada. Causatruncated. Anota esas direcciones enrecollect.txty vuelve a recolectarlas con proxy en el Paso 3. - Ejecuta el filtro y estudia el informe. El script debe mostrar una tabla: cuántos documentos de entrada, cuántos descartados por cada causa, cuántos quedaron.
Atención: Nunca borres archivos de clean ni de raw durante el filtrado. El filtro solo escribe archivos nuevos. Si el umbral de MinHash resultó demasiado agresivo y perdiste 40 por ciento de documentos útiles, solo cambias el número y vuelves a correr el script en dos minutos.
Consejo: El umbral 0.85 para casi duplicados es bueno para artículos y ayuda. Para fichas de producto de una misma marca que difieren solo en talla o volumen, las colapsará en una. Decide de antemano si tu sistema RAG necesita todas las variantes y, o bien sube el umbral a 0.95, o bien combina las variantes en un solo documento con una tabla de diferencias ya en la etapa de extracción.
Consejo: Los documentos descartados no son residuos, son material de depuración. Una vez a la semana abre rejected.jsonl, filtra por causa y mira 10 registros al azar. Si entre los low_quality aparecen con regularidad tablas útiles de tarifas, hay que ajustar los umbrales.
Verificación: El informe del filtro muestra un panorama razonable: descarte total entre 10 y 40 por ciento, del cual los duplicados son una parte notable, y la causa truncated no supera el 2-3 por ciento. En el archivo filtered.jsonl no hay dos documentos con el mismo texto normalizado, y 10 registros al azar se ven como artículos completos o secciones de documentación.
Posibles problemas
- El descarte supera el 60 por ciento. Probablemente los umbrales de calidad son demasiado estrictos o hay un error de normalización que hizo que todos los textos se parecieran. Muestra 20 descartados al azar y encuentra la causa sistemática.
- MinHash tarda muchísimo. En un corpus de más de 100 mil documentos reduce
num_perma 64 o calcula por fuentes separadas. - El detector de idioma marca textos en español como catalán o portugués. Pasa en fragmentos cortos con muchos nombres propios. Verifica el idioma en los primeros 2000 caracteres y acepta como coincidencia cualquier idioma del grupo cercano.
Paso 6: Etiquetamos los metadatos y armamos el corpus final
Objetivo de la etapa: obtener un archivo único corpus/corpus_v1.jsonl, donde cada documento tiene un identificador estable, un conjunto completo de metadatos y está listo para entregar al pipeline de indexación.
Los metadatos son lo que distingue un corpus de un montón de texto. Permiten actualizar fuentes individuales, explicar al usuario el origen de la respuesta, filtrar por fecha y sección y, sobre todo, no hacer todo el trabajo de nuevo dentro de un mes.
Instrucciones
- Define el esquema del documento. Fíjalo en el archivo
schema.mdy no lo cambies sin versión del corpus. Mínimo recomendado:
doc_id: identificador estable, por ejemplosha1definal_url, para que al recolectar de nuevo el documento reciba el mismo id;source: nombre de la fuente desources.json;urlyfinal_url;title;section: sección del sitio, calculada del primer segmento de la ruta tras el prefijo, por ejemplohelp/proxies;lang;published_at: fecha de publicación, si se extrajo;fetched_at: fecha de recolección;geo: región del proxy desde la que se recolectó;text;text_len,text_sha1;corpus_version: por ejemplov1.
- Calcula la sección. Parsea
final_urlconurllib.parse.urlparse, toma la ruta, quita el prefijo de la fuente, deja uno o dos segmentos. La sección será luego un filtro en el sistema RAG: el usuario pregunta por pagos, la búsqueda va primero a la secciónbilling. - Normaliza las fechas. Lleva todas las fechas a ISO 8601 en UTC. Si la fecha de publicación no se encuentra, deja el campo vacío, no pongas la fecha de recolección: son cosas distintas y confundirlas es peligroso al filtrar materiales obsoletos.
- Agrega el título al texto. Si
textno empieza contitle, inserta el título como primera línea. El título lleva palabras clave importantes para la búsqueda. - Ordena y escribe. Ordena los documentos por
sourceyfinal_url, escribe encorpus/corpus_v1.jsonl. Junto a él colocacorpus/manifest_v1.jsoncon el número de documentos por fuente, la fecha de armado, la versión del esquema y los parámetros de los filtros. - Haz un archivo comprimido. Comprime
corpus,sources.json,schema.mdy la carpetalogs. Ese archivo es una versión reproducible de tu corpus.
Consejo: Mantén los datos personales fuera del corpus por completo. Si en los textos de ayuda aparecen ejemplos como "Juan Pérez, +57 300...", reemplázalos por marcadores ya en la etapa de recolección del corpus. El sistema RAG no debe poder entregar el teléfono de nadie, aunque estuviera en acceso abierto.
Verificación: El archivo corpus_v1.jsonl abre, cada línea es un JSON válido con los campos del esquema, todos los documentos tienen doc_id único, todos tienen source, lang, fetched_at, text completos. El archivo manifest_v1.json contiene un resumen que coincide con el número de líneas.
Posibles problemas
- Direcciones distintas llevan a un mismo documento y dan doc_id distinto. Calcula el id desde
final_urltras las redirecciones, quitando parámetros de consulta y la barra final. - Las fechas se extraen en formatos distintos. Usa
dateutil.parser.parsecon el parámetrodayfirst=Truepara fuentes en español.
Verificación del resultado: lista de control y prueba del corpus
El corpus está armado. Antes de llevarlo a indexación, revisémoslo como producto, no como archivo.
Lista de control
- Existe
sources.jsoncon los límites de cada fuente e indicación de los topes. - Todas las peticiones pasaron por el proxy móvil; en el registro cada petición tiene
proxy_ip. - La proporción de errores de recolección en el registro no supera el 5 por ciento, y las respuestas 429 son menos del 1 por ciento.
- De las páginas en bruto se extrajo al menos el 80 por ciento de los documentos.
- El descarte en el filtrado está entre 10 y 40 por ciento, y todas las causas de descarte están nombradas.
- En el corpus no hay duplicados exactos por texto normalizado.
- Todos los documentos tienen los metadatos obligatorios completos.
- Hay un archivo comprimido con los datos en bruto, el corpus, los registros y la configuración.
Cómo probar
- Prueba con las preguntas del Paso 1. Toma tus 20-30 preguntas. Para cada una, con una búsqueda simple por subcadena o con
grep, encuentra en el corpus el documento que contiene la respuesta. Meta: al menos el 90 por ciento de las preguntas tienen cobertura. Si una pregunta no está cubierta, busca en el navegador la página con la respuesta y averigua por qué no entró: no estaba en el mapa del sitio, la descartaron los filtros, el texto se truncó. - Prueba de basura. Busca en el corpus cadenas como "suscríbete", "carrito", "cookie", "todos los derechos reservados", "lee también". Cada aparición es una sospecha. Unidades son aceptables si forman parte del texto sustancial; decenas de apariciones significan que hay que mejorar el filtro de plantillas.
- Prueba de cortes. Cuenta los documentos cuyo texto termina sin punto, sin signo de exclamación o interrogación y sin paréntesis de cierre. Deben ser menos del 5 por ciento. El resto, revísalos con los ojos.
- Prueba de distribución. Arma un histograma de longitudes de documentos. Un corpus sano de ayuda o blog tiene un pico entre 2 y 8 mil caracteres y una cola larga. Un pico marcado cerca del umbral mínimo indica páginas de relleno que se colaron.
- Prueba de geografía. Si el contenido depende de la región, abre 5 páginas con precios o disponibilidad y compáralas con lo que ve una persona de la ciudad correcta. Las discrepancias significan que el proxy es de otra región o que el sitio determina la región por cookies, no por IP.
Indicadores de éxito
El corpus está listo si la cobertura de las preguntas de prueba supera el 90 por ciento, la proporción de documentos con señales de basura es menor al 3 por ciento, y el manifest permite reproducir por completo el armado. Solo después de eso el corpus se entrega al pipeline de indexación del sistema RAG.
Errores típicos y soluciones al recolectar un corpus para RAG
Problema: en las respuestas del asistente aparecen ítems del menú y llamados a suscribirse. Causa: la extracción de texto operó en modo de exhaustividad y no de precisión, y el filtro de plantillas no se ejecutó. Solución: activa favor_precision, implementa la eliminación de líneas que se repiten en más del 30 por ciento de los documentos de la fuente, vuelve a armar clean desde raw sin descargar de nuevo.
Problema: el asistente responde con la versión obsoleta de una instrucción. Causa: en el corpus conviven la versión vieja y la nueva del artículo; los casi duplicados no se descartaron o el umbral es demasiado alto. Solución: baja el umbral de MinHash a 0.8 para fuentes con versiones, y ante conflicto conserva el documento con published_at más reciente.
Problema: parte de las páginas se recolectó vacía, estado 200. Causa: el contenido se construye con JavaScript en el navegador. Solución: marca la fuente como needs_js y usa renderizado con Playwright del bloque avanzado, o busca en el sitio una API o RSS donde el contenido se entregue listo.
Problema: la recolección se detiene en errores 429 y 503. Causa: frecuencia de peticiones demasiado alta; la rotación de IP se usó en lugar de bajar la carga. Solución: reduce la frecuencia a 6-8 peticiones por minuto, aumenta la dispersión aleatoria de las pausas, pon una pausa de 5-10 minutos ante el primer 429. Recuerda que el límite de carga es cuestión de respeto a la fuente, no de cantidad de direcciones.
Problema: tras la rotación el sitio muestra contenido de otra región. Causa: el proxy móvil entregó una IP de otra ciudad, o el sitio determinó la región por las cookies de la sesión anterior. Solución: fija la región correcta en el panel del proxy, reinicia la sesión de requests tras cada rotación para que las cookies no se arrastren.
Problema: el corpus está listo, pero la cobertura de preguntas es del 60 por ciento. Causa: los límites de las fuentes están demasiado estrechos, páginas útiles se descartaron por prefijos. Solución: toma las preguntas sin cobertura, busca las respuestas en el navegador, mira sus direcciones y amplía include_prefixes.
Problema: la deduplicación se comió fichas de producto que difieren en características. Causa: el umbral de casi duplicados es demasiado bajo para textos de tipo uniforme. Solución: para fuentes de catálogo sube el umbral a 0.95 o combina las variantes de un producto en un solo documento en la etapa de extracción.
Problema: los textos de PDF van en una sola línea continua sin párrafos. Causa: pypdf pierde la maquetación. Solución: pasa a pdfplumber o pymupdf, reconstruye los párrafos por saltos dobles y sangrías.
Problema: entraron datos personales al corpus. Causa: no hubo etapa de anonimización. Solución: agrega antes de escribir en el corpus una búsqueda de teléfonos, correos y nombres con patrones simples y su reemplazo por marcadores; los documentos dudosos mándalos a revisión manual.
Posibilidades adicionales para avanzados
Si el pipeline básico funciona, aquí tienes hacia dónde desarrollarlo.
Renderizado de páginas con JavaScript a través del proxy
Instala pip install playwright y playwright install chromium. Lanza el navegador con el parámetro proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS}. Espera el selector del contenido principal con page.wait_for_selector, no segundos fijos. Toma page.content() y guárdalo en el mismo formato raw para que los pasos siguientes no cambien. El renderizado es de 5 a 10 veces más lento que las peticiones normales, así que aplícalo solo a fuentes con la bandera needs_js y baja la frecuencia a 3-5 páginas por minuto.
Actualización incremental del corpus
Guarda en el manifiesto el text_sha1 de cada documento. En la siguiente recolección descarga las páginas, pero extrae y filtra solo las que cambiaron el hash del HTML o llevan más de 30 días desde la recolección. Usa los encabezados If-Modified-Since y ETag: muchos sitios devolverán 304 sin cuerpo y ahorrarás tráfico de proxy. Cada actualización recibe una nueva versión del corpus: v2, v3, y los archivos anteriores no se borran.
Corpus multirregional
Si el negocio tiene sucursales y el contenido de las fuentes depende de la ciudad, crea varios proxies móviles con distinta geografía. Recolecta la misma página desde cada región, guarda geo en los metadatos y deduplica solo dentro de la región. El sistema RAG después podrá responder "en Guadalajara la entrega es en 2 días, en Monterrey en 4", apoyándose en las versiones regionales reales de las páginas.
Etiquetado de calidad en lugar de umbrales rígidos
En lugar de descartar por umbrales, calcula para cada documento una nota de calidad de 0 a 1 a partir de las mismas métricas: longitud, proporción de letras, proporción de oraciones completas, repetibilidad de líneas. Guarda la nota en los metadatos. Así el pipeline de indexación podrá decidir qué tomar y la búsqueda podrá rankear más alto los documentos confiables.
Deduplicación semántica
MinHash atrapa los duplicados léxicos. Los parafraseos de una misma instrucción con otras palabras se le escapan. Para atraparlos calcula embeddings de los documentos y busca pares con similitud coseno superior a 0.95. Eso ya es frontera con la etapa de indexación, así que aquí solo lo mencionamos: decide dónde trazar la frontera y no hagas el mismo trabajo dos veces.
Monitoreo de la recolección
Extrae métricas del registro: peticiones por minuto, proporción de códigos 200, latencia media, número de rotaciones. Un tablero simple en matplotlib o una tabla en la terminal cada 10 minutos te mostrará la degradación antes de que descubras 500 páginas vacías por la mañana.
FAQ: preguntas frecuentes sobre la recolección de un corpus
¿Es obligatorio usar un proxy móvil para recolectar un corpus? Para documentos propios y fuentes pequeñas, no es obligatorio. El proxy se vuelve necesario cuando las fuentes son muchas, la recolección dura horas, importa la versión regional del contenido o no quieres crear una carga visible en el sitio desde una sola dirección.
¿Cada cuánto cambiar la IP al recolectar? Referencia: cada 30-60 peticiones o al pasar a otra fuente. Más seguido no hace falta: el sentido de la rotación es distribuir la carga y estabilizar la sesión, no la frecuencia en sí. La rotación frecuente sin bajar el ritmo general no reduce la carga.
¿Cuántos documentos se necesitan para un sistema RAG funcional? Para un asistente de un solo producto suelen bastar 200-500 documentos de calidad. Para un nicho amplio, varios miles. La calidad importa más que el volumen: 500 artículos limpios darán mejores respuestas que 20 mil con basura.
¿Se pueden recolectar redes sociales y marketplaces? Solo páginas abiertas, dentro de las reglas de la plataforma y del robots.txt, sin datos personales. Muchas plataformas tienen API oficiales para obtener contenido; empieza por ellas.
¿Qué hacer con imágenes y videos? Dentro del marco de un corpus de texto, guarda solo los pies de foto, los textos alt y los transcritos si están en la página. Los archivos en sí no entran al corpus.
¿Por qué no puedo simplemente descargar el sitio completo con un programa de descargas? Puedes, pero obtendrás decenas de miles de archivos sin metadatos, con duplicados, páginas de servicio y sin registro. Después tendrás que hacer los pasos de esta guía en orden inverso, solo que más difícil.
¿Cómo saber que los filtros no eliminaron lo necesario? Revisa rejected.jsonl por cada causa, una muestra de 10-20 registros. Y verifica la cobertura de las preguntas de prueba: si faltan respuestas, búscalas entre los descartados.
¿Hay que cortar los documentos en chunks en esta etapa? No. La división en fragmentos es parte de la indexación y depende del modelo de embeddings y del tamaño del contexto. La tarea del corpus es entregar documentos completos con metadatos y etiquetado de encabezados, para que el chunker pueda cortar con sentido.
¿Cómo actualizar el corpus sin recolectar todo de nuevo? Guarda hashes, usa peticiones condicionales If-Modified-Since, versiona el corpus. Más detalles en el bloque avanzado.
¿Qué hacer si el sitio prohíbe la recolección automática en robots.txt? Respetar la prohibición. Escribe al propietario; a menudo te dará una exportación, una API o permiso. Un corpus recolectado contra las reglas de la fuente genera riesgos para todo el proyecto.
Conclusión: qué se hizo y hacia dónde seguir
Recorriste todo el camino desde la idea hasta el corpus listo. Definiste los límites y armaste el mapa de fuentes con topes y geografía. Conectaste el proxy móvil y confirmaste que la rotación funciona. Escribiste un recolector cortés que respeta robots.txt, distribuye la carga y mantiene un registro detallado. Extraíste texto limpio de HTML, PDF y DOCX. Descartaste duplicados, páginas de relleno, plantillas y páginas rotas con causas nombradas. Etiquetaste los metadatos y armaste un corpus versionado con manifiesto. Lo probaste con preguntas reales.
El resultado principal no es el archivo en el disco, sino un proceso reproducible. Dentro de un mes lo ejecutarás de nuevo y obtendrás el corpus actualizado en un par de horas, no en una semana. Y cuando el sistema RAG empiece a responder raro, sabrás exactamente dónde buscar la causa: en el registro de recolección, en el informe del filtro o en el manifiesto.
Qué hacer ahora. Entrega corpus_v1.jsonl al pipeline de indexación: división en fragmentos, embeddings, base vectorial. Sobre eso hay artículos relacionados en el blog. Configura la ejecución periódica del recolector con actualización incremental. Amplía el mapa de fuentes a medida que crezca el número de preguntas sin cobertura. Si el negocio es regional, agrega proxies de las ciudades necesarias y recolecta las versiones regionales del contenido.
Hacia dónde desarrollarte. Domina el renderizado de navegador para sitios complejos, la evaluación de calidad de documentos en lugar de umbrales rígidos, la deduplicación semántica y el monitoreo de la recolección. Cada uno de estos pasos mejora la calidad de las respuestas más que cambiar de modelo. Los datos limpios son la mejora más barata de tu sistema RAG. Que tengas una buena recolección.