Coleta de avaliações de mapas, marketplaces e agregadores: guia passo a passo para iniciantes
Sumário do artigo
- Introdução: o que você vai obter no final
- Preparação inicial: ferramentas e acessos
- Conceitos básicos: como as avaliações são estruturadas e por que coletá-las de forma diferente de catálogos
- Etapa 1: definindo o objetivo e montando a lista de fontes
- Etapa 2: desenhando a tabela de avaliações
- Etapa 3: usando os caminhos oficiais — painéis e apis
- Etapa 4: coletando avaliações de mapas — yandex maps, 2gis, google maps
- Etapa 5: coletando avaliações de marketplaces — wildberries, ozon, yandex market
- Etapa 6: coletando avaliações de agregadores — otzovik, irecommend, flamp, zoon
- Etapa 7: conectando proxies móveis e configurando a rotação
- Etapa 8: salvando, limpando e deduplicando
- Verificação do resultado: checklist e testes
- Erros típicos e soluções
- Recursos adicionais para avançados
- Faq: perguntas frequentes sobre coleta de avaliações
- Conclusão
Introdução: o que você vai obter no final
Avaliações são a fonte mais honesta de informação sobre um produto, loja ou estabelecimento. Nelas, as próprias pessoas contam o que gostaram, o que quebrou, por que não voltam mais e o que recomendariam aos amigos. O problema é que as avaliações estão espalhadas por dezenas de plataformas: mapas, marketplaces, agregadores, catálogos do setor. Ler tudo manualmente durante semanas é inviável. Por isso é preciso uma coleta sistemática.
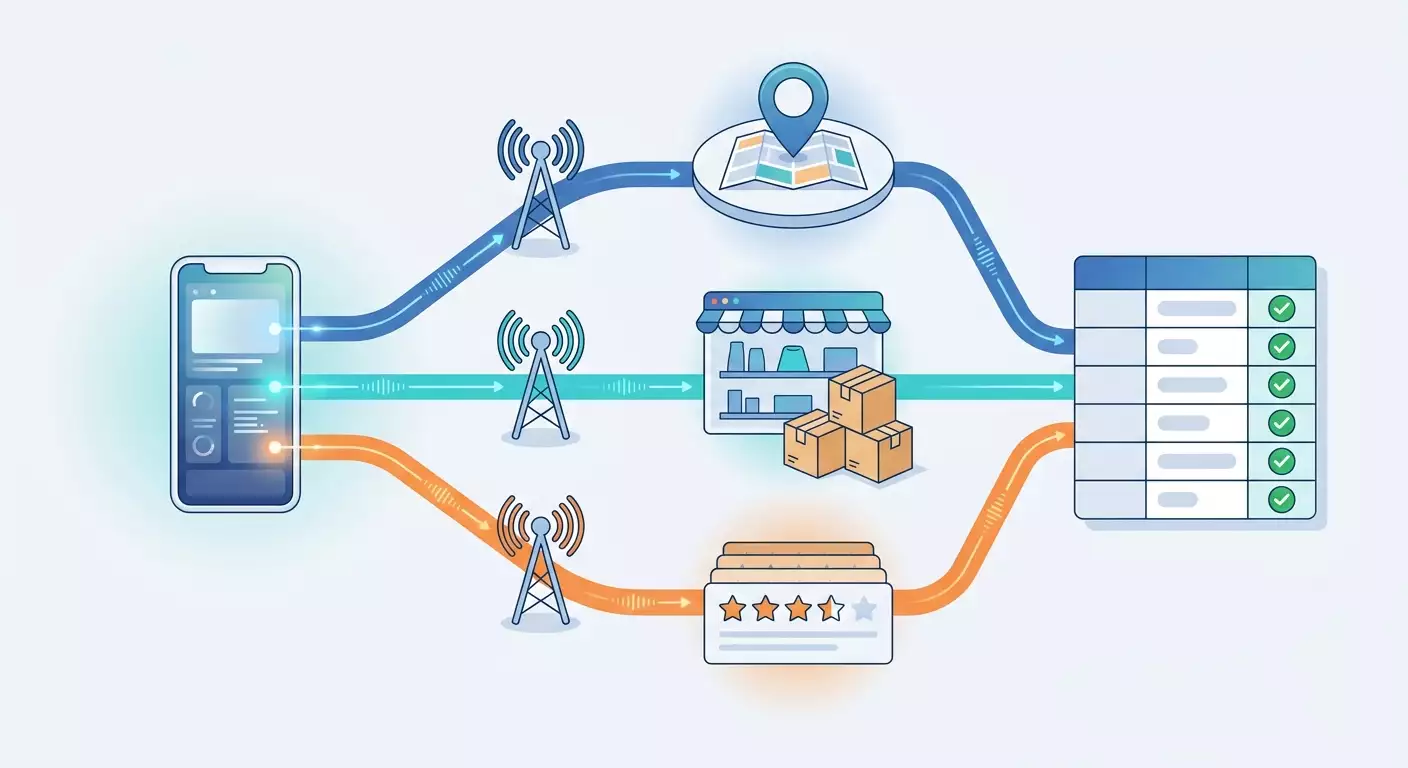
Neste guia vamos mostrar como coletar avaliações de três tipos de plataformas: serviços de mapas (Yandex Maps, 2GIS, Google Maps), marketplaces (Wildberries, Ozon, Yandex Market) e agregadores (Otzovik, iRecommend, Flamp, Zoon). Você vai percorrer todo o caminho: desde a definição do objetivo e o desenho da tabela até o script funcional, a conexão de proxies móveis e a limpeza dos dados.
O que você vai obter como resultado:
- Entender onde e em que formato ficam as avaliações em cada tipo de plataforma.
- Uma estrutura pronta de tabela de avaliações que pode ser carregada no Excel, Google Planilhas ou em um banco de dados.
- Um parser de avaliações funcional em Python, capaz de operar através de proxies móveis sem sobrecarregar as plataformas.
- Conhecimento sobre os caminhos oficiais de exportação: painéis administrativos, APIs de parceiros, exportações.
- Um checklist de verificação da qualidade dos dados coletados e uma lista dos erros mais comuns.
Para quem é este guia. Ele foi feito para profissionais de marketing, donos de negócio, gestores de tráfego e desenvolvedores iniciantes. Se você nunca escreveu código, não se assuste. Parte dos cenários é executada sem programação alguma, e para os scripts fornecemos trechos prontos que você só precisa copiar e substituir pelos seus valores. Para quem já programa, há um bloco separado com técnicas avançadas no final.
O que você precisa saber de antemão. Basta saber usar o navegador, instalar programas e trabalhar com tabelas. Uma noção básica do que é um proxy ajuda, mas vamos explicar os termos-chave ao longo do texto.
Fronteira importante deste material. Aqui falamos apenas de avaliações como um tipo específico de dado: texto, nota, data, autor, resposta da empresa. Não abordamos o parsing de catálogos de produtos, preços e estoques — esse é um tema separado, com suas próprias particularidades. Se você precisa de preços, este guia não serve; mas se precisa do feedback dos clientes, você está no lugar certo.
Quanto tempo vai levar. A preparação do ambiente leva cerca de 30-40 minutos. O desenho da estrutura e a primeira coleta de uma plataforma, aproximadamente uma hora. A passagem completa pelos três tipos de plataformas, com configuração de proxy e limpeza de dados, leva de 3 a 4 horas. Depois disso, a coleta vai levar minutos, porque o script pode ser executado repetidamente.
Preparação inicial: ferramentas e acessos
Antes de coletar avaliações, é preciso preparar o ambiente de trabalho. Abaixo está a lista do que será necessário. Não pule esta seção, mesmo que algo pareça óbvio: metade dos problemas nas próximas etapas surge justamente por causa de um ambiente mal preparado.
Requisitos de sistema
- Computador com Windows 10/11, macOS ou Linux. Qualquer notebook dos últimos 6-7 anos serve.
- No mínimo 4 GB de memória RAM. Para coletar dezenas de milhares de avaliações, prefira 8 GB.
- Internet estável. A coleta em si não exige alta velocidade, mas quedas de conexão causam lacunas nos dados.
- Cerca de 2 GB de espaço livre em disco para o Python, as bibliotecas e os resultados.
O que precisa ser instalado
- Python 3.11 ou mais recente. Baixe o instalador no site oficial do Python. Na instalação no Windows, marque obrigatoriamente a opção "Add Python to PATH" na primeira tela do instalador. Sem ela, o comando python não vai funcionar no terminal.
- Editor de código. O VS Code serve bem — é gratuito e fácil de usar. Depois de instalar, abra-o uma vez para confirmar que ele inicia.
- Bibliotecas Python. Abra o terminal (no Windows, o PowerShell; no macOS, o Terminal) e execute o comando:
pip install requests pandas openpyxl. Aguarde a mensagem Successfully installed. Isso leva de 1 a 2 minutos. - Navegador Chrome ou similar. Necessário para inspecionar as plataformas através das ferramentas de desenvolvedor. Elas já vêm embutidas, não é preciso instalar nada à parte.
- Editor de planilhas. Excel, LibreOffice Calc ou Google Planilhas — para visualizar os resultados.
Quais acessos serão necessários
- Acesso a proxies móveis. Cadastre-se no mobileproxy.space, escolha um plano com a geolocalização necessária (para plataformas brasileiras, operadoras locais) e obtenha os dados de conexão: host, porta, login, senha. Também no painel, encontre o link para troca de IP — ele será usado na etapa de rotação.
- Acesso aos painéis das plataformas, caso você colete avaliações sobre o seu próprio negócio. Isso inclui Google Business Profile, o painel do vendedor na Wildberries, o Seller Center da Ozon, o painel de vendedor do Yandex Market. As exportações oficiais de lá são a fonte mais limpa.
- Pasta do projeto. Crie no disco uma pasta, por exemplo reviews_project, e dentro dela duas subpastas: raw para dados brutos e clean para dados processados. Isso é a sua proteção: os dados brutos nunca são sobrescritos.
Dica: Crie de imediato um arquivo de texto sources.txt na pasta do projeto e anote nele cada endereço de onde você coleta avaliações, junto com a data. Em um mês você não vai lembrar de onde veio esta ou aquela tabela, e esse registro resolve tudo.
Backups
O backup aqui não é do sistema, mas dos dados. Adote a regra: cada execução do parser grava o resultado em um novo arquivo com a data no nome, por exemplo reviews_ozon_2026-03-14.csv. Não apague os arquivos antigos por pelo menos um mês. Se a nova coleta sair corrompida por causa de mudanças na plataforma, você ainda terá uma versão funcional.
Verificação: Digite no terminal python --version — deve aparecer a versão 3.11 ou superior. Depois digite python -c 'import requests, pandas; print(1)' — deve aparecer o número 1 sem erros. Se os dois comandos funcionaram, o ambiente está pronto.
Conceitos básicos: como as avaliações são estruturadas e por que coletá-las de forma diferente de catálogos
Antes de rodar qualquer coisa, é importante entender com que tipo de dado você está lidando. Uma avaliação não é apenas texto. É um registro estruturado com vários campos, e tem particularidades que não existem em uma ficha de produto.
Termos-chave em linguagem simples
- Avaliação (review) — registro deixado por um usuário sobre um objeto: produto, loja, estabelecimento. Normalmente contém nota, texto, data, nome do autor e às vezes fotos.
- Objeto da avaliação — aquilo sobre o que é a avaliação: ficha de produto em um marketplace, organização em um mapa, empresa em um agregador. Cada objeto tem um identificador único na plataforma.
- Resposta da empresa — réplica de um representante do negócio embaixo da avaliação. Para análise de qualidade do atendimento, é um campo separado.
- Paginação — divisão das avaliações em páginas ou lotes. A plataforma entrega, por exemplo, 20 avaliações por vez, e é preciso solicitar os próximos lotes.
- Parser de avaliações — programa que percorre automaticamente os objetos desejados, extrai as avaliações e as guarda em uma tabela. Pode ser um script simples ou um serviço pronto.
- Deduplicação — remoção de repetições. A mesma avaliação pode entrar na amostra duas vezes por causa da paginação ou de execuções repetidas.
- Proxies móveis — servidores intermediários com endereços IP de operadoras móveis. As requisições através deles parecem tráfego de um usuário comum em um smartphone. As plataformas são mais tolerantes com esse tipo de tráfego, porque atrás de um IP móvel há centenas de pessoas reais.
- Rotação de IP — troca do endereço do proxy em um intervalo definido ou sob demanda. Ajuda a distribuir a carga e evitar criar um fluxo anômalo de requisições a partir de um único endereço.
Em que a coleta de avaliações difere da coleta de catálogo
Um catálogo de produtos é relativamente estático: a ficha existe, tem preço e características. Já as avaliações vivem de outra forma, e isso influencia todo o processo.
- Avaliações são adicionadas o tempo todo. É preciso saber baixar apenas as novas, em vez de recapturar tudo a cada vez.
- Avaliações são carregadas separadamente. Na maioria das plataformas, o texto das avaliações chega não na própria página, mas em uma requisição separada em segundo plano. Isso é uma boa notícia: essas requisições devolvem JSON pronto, sem precisar analisar HTML.
- Avaliações contêm dados pessoais. Nome do autor, avatar, às vezes cidade. Isso está sujeito a exigências legais — veja abaixo.
- Avaliações são ordenadas e filtradas. Por padrão, a plataforma pode mostrar as "úteis" ou as "novas". Se você não fixar a ordenação, vai coletar conjuntos diferentes em execuções diferentes.
- Avaliações são editadas e excluídas. A moderação remove parte dos registros, e os autores mudam notas. A data da coleta se torna um campo importante.
Marcos legais que você precisa entender
Atenção: As avaliações contêm nomes e outras informações sobre pessoas. Na coleta e no armazenamento, siga as exigências da LGPD (Lei Geral de Proteção de Dados): não colete mais do que o necessário para a tarefa, anonimize os autores onde o nome não for necessário para a análise, não compartilhe a base com terceiros. Leia também os termos de uso da plataforma e o arquivo robots.txt: alguns serviços descrevem explicitamente os modos permitidos de acesso automatizado. Se houver uma API oficial ou exportação pelo painel para a sua tarefa, comece sempre por ela.
Outro princípio é a carga respeitosa. O seu parser de avaliações deve se comportar como um usuário atento, não como um fluxo de requisições. Pausas entre as requisições, número razoável de threads e rotação através de proxies móveis não são truques, mas sim a norma de uma coleta responsável. As plataformas bloqueiam não o fato da automação em si, mas o comportamento anômalo que atrapalha o funcionamento delas.
Etapa 1: Definindo o objetivo e montando a lista de fontes
Objetivo da etapa: obter uma lista concreta e limitada de objetos dos quais vamos coletar avaliações, e entender quais campos precisamos. Sem essa etapa, o parser se transforma em um projeto infinito.
Formule a pergunta que as avaliações vão responder
Uma boa coleta começa com uma pergunta. Exemplos de formulações práticas:
- "Por que o concorrente X na Wildberries tem nota 4,8 e nós temos 4,4 na mesma categoria?"
- "Do que reclamam com mais frequência nas avaliações sobre os nossos cinco cafés no Yandex Maps nos últimos seis meses?"
- "Quais dores dos clientes aparecem nas avaliações sobre cursos online no Otzovik, para usar nos criativos?"
Observe: cada pergunta tem uma plataforma, um objeto, um período e um tipo de informação. É exatamente isso que define as configurações da coleta.
Monte a lista de objetos
- Abra a plataforma no navegador e encontre cada objeto necessário manualmente: a ficha do produto, a organização no mapa, a página da empresa no agregador.
- Copie o endereço completo da página da barra de endereços.
- Extraia do endereço o identificador do objeto. Na Wildberries é o número no endereço da ficha depois de catalog/, na Ozon é o número depois de product/ e o hífen no final, no Yandex Maps é o número longo depois de org/ e do nome, no 2GIS é o número depois de firm/. Anote-o separadamente.
- Registre tudo em uma tabela sources.csv com as colunas: plataforma, nome do objeto, endereço, identificador, comentário.
- Para a primeira execução, limite-se a 3-5 objetos por plataforma. Você vai escalar depois.
Decida quais campos são necessários
O conjunto mínimo de campos para qualquer avaliação: identificador da avaliação na plataforma, identificador do objeto, plataforma, nota, texto, data de publicação, data de coleta. Conjunto ampliado: nome do autor (ou seu hash), presença de fotos, prós e contras separados (existe em marketplaces e no Otzovik), resposta da empresa e sua data, número de curtidas ou marcações de "útil", variante do produto (tamanho, cor), status de compra confirmada.
Dica: Não corra atrás de todos os campos de uma vez. Colete o conjunto mínimo mais 2-3 campos realmente necessários para a sua pergunta. Cada campo extra é mais um lugar onde a marcação da plataforma pode mudar e quebrar o script.
Resultado esperado: arquivo sources.csv com 5-15 linhas e a lista de campos registrada. Cada linha tem o identificador preenchido.
Possíveis problemas: não dá para entender onde está o identificador no endereço. Solução: abra dois objetos parecidos na mesma plataforma e compare os endereços — as partes que coincidem são o modelo, as que diferem são o identificador.
Verificação: Você consegue ler qualquer linha de sources.csv e, a partir de um identificador, abrir manualmente o objeto certo na plataforma. Se para isso você precisa adivinhar, volte e ajuste os identificadores.
Etapa 2: Desenhando a tabela de avaliações
Objetivo da etapa: fixar um formato único de registro no qual as avaliações de todas as plataformas serão convertidas. Isso permitirá analisá-las juntas, e não em cinco tabelas diferentes.
Esquema unificado
Crie no editor de código um arquivo schema.txt e liste as colunas nesta ordem:
- review_id — identificador da avaliação na plataforma. Se a plataforma não o fornecer explicitamente, formamos nós mesmos a partir do objeto, do autor e da data.
- source — código curto da plataforma: yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon.
- object_id — identificador do objeto de sources.csv.
- object_name — nome legível, para conveniência.
- rating — número de 1 a 5. Se a plataforma usar outra escala, convertemos para a escala de cinco pontos e registramos isso em um comentário.
- text — texto completo da avaliação em uma única linha. Quebras de linha substituídas por espaço.
- pros e cons — prós e contras, se a plataforma os separar. Caso contrário, vazio.
- author — nome do autor ou seu hash anonimizado.
- published_at — data de publicação no formato AAAA-MM-DD.
- company_reply — texto da resposta da empresa, se houver.
- likes — número de marcações de utilidade.
- has_photo — 1 ou 0.
- collected_at — data e hora da coleta.
- url — endereço da página do objeto.
Por que é preciso exatamente o formato unificado
Cada plataforma entrega os dados à sua maneira: em uma, a data é a string "3 dias atrás"; em outra, é um número em milissegundos; em outra, o texto "14 de março". Se você não converter tudo para um formato comum na entrada, vai se afogar em exceções na análise. A conversão para o esquema deve ser feita logo na gravação, e não depois.
Regras de anonimização
Se a tarefa não exige nomes de autores (e em 90% das tarefas analíticas eles não são necessários), armazene um hash em vez do nome. Em Python, isso é feito em uma linha com o módulo hashlib: pega-se o nome do autor, adiciona-se o código da plataforma, e o resultado é transformado em uma string curta. Assim você consegue distinguir as avaliações de um mesmo autor, mas sem guardar o nome em si.
Dica: Adicione ao esquema a coluna raw_json, onde será gravada a resposta original da plataforma para a avaliação específica. Ela ocupa espaço, mas permite, depois, extrair um campo no qual você não pensou hoje, sem precisar recoletar.
Resultado esperado: arquivo schema.txt com as colunas e um modelo vazio de tabela reviews_template.csv com esses cabeçalhos.
Verificação: Abra reviews_template.csv no Excel. Você deve ver uma linha de cabeçalhos, na qual estão exatamente as colunas de schema.txt, sem nenhuma a mais.
Etapa 3: Usando os caminhos oficiais — painéis e APIs
Objetivo da etapa: exportar as avaliações sobre o seu próprio negócio da forma mais limpa possível, sem parsing algum. Se você analisa apenas a si mesmo, essa etapa pode ser suficiente.
Google Business Profile (avaliações no Google Maps)
- Entre no Google Business Profile com a conta do proprietário da organização.
- No menu à esquerda, selecione a seção "Avaliações".
- No topo, escolha a unidade desejada, se houver várias organizações.
- Configure o filtro por período e nota.
- A lista de avaliações é exibida com texto, data, nota e as suas respostas. Não há botão direto de exportação para tabela, então, para grandes volumes, use a cópia página por página ou vá para a etapa 4.
Wildberries: API de avaliações para vendedores
A Wildberries tem uma seção oficial de API para trabalhar com avaliações e perguntas. Ela está disponível para vendedores e entrega as avaliações dos seus produtos com nota, texto, prós e contras, data, e também permite responder a elas.
- Entre no painel do vendedor do WB (WB Partners).
- Abra as configurações de perfil, seção "Acesso à API".
- Crie um novo token, marcando a categoria de acesso a avaliações e perguntas. Dê um nome claro, como reviews_export.
- Copie o token imediatamente — ele não é mostrado novamente. Salve no arquivo config.txt na pasta do projeto.
- Acesse os métodos de listagem de avaliações com esse token no cabeçalho Authorization. A documentação descreve os parâmetros de paginação e filtragem por datas.
Ozon Seller API e Yandex Market
A Ozon oferece acesso às avaliações através do Seller API para vendedores com assinatura que inclui o trabalho com avaliações. A chave é criada na seção "Configurações", subseção "Chaves de API". O Yandex Market entrega as avaliações dos produtos do vendedor via API de parceiro, pelo identificador do negócio, e a chave é emitida no painel do vendedor, na seção de configurações de acesso.
Google Business Profile e 2GIS para empresas
As avaliações sobre a própria organização no Google Maps estão disponíveis no painel do Google Business Profile e através da sua API, após a confirmação dos direitos. O 2GIS oferece aos proprietários um painel com notificações de avaliações e possibilidade de resposta.
Atenção: Tokens e chaves de API são o acesso à sua conta de negócio. Nunca insira-os diretamente no código: armazene em um arquivo separado que não vá para pastas compartilhadas ou repositórios. Se o token vazar por acidente, revogue-o imediatamente no painel e crie um novo.
Quando os caminhos oficiais não bastam
Todos os métodos acima entregam avaliações apenas sobre os seus próprios objetos. Para analisar concorrentes, mercado ou produtos de terceiros, eles não servem. Nesse caso, passamos à coleta a partir de páginas públicas — é a isso que se dedicam as etapas seguintes.
Resultado esperado: se você trabalha com o seu próprio negócio — a primeira tabela de avaliações de uma fonte oficial, convertida para o esquema da etapa 2.
Verificação: O número de avaliações na exportação coincide com o número que o painel mostra para o mesmo período, com uma margem de 1-2 registros para avaliações que estavam em moderação no momento da exportação.
Etapa 4: Coletando avaliações de mapas — Yandex Maps, 2GIS, Google Maps
Objetivo da etapa: aprender a encontrar a requisição de fundo com que o mapa carrega as avaliações e reproduzi-la com um script. Essa habilidade é universal e vai servir em todas as demais plataformas.
Como encontrar a requisição das avaliações pelas ferramentas de desenvolvedor
- Abra no Chrome a página da organização no Yandex Maps ou no 2GIS.
- Pressione a tecla F12. À direita ou embaixo, o painel de desenvolvedor será aberto.
- Vá para a aba Network (Rede). Se ela estiver vazia — atualize a página com F5.
- Na barra de filtro acima da lista de requisições, clique no botão Fetch/XHR. Sobrarão apenas as requisições de fundo por dados.
- Na página da organização, vá para a seção de avaliações e role a lista para baixo, para carregar o próximo lote.
- Na lista de requisições aparecerá uma nova. No nome dela geralmente aparece a palavra review ou feedback. Clique nela.
- Abra a aba Preview ou Response. Você verá a estrutura JSON, onde há uma lista aninhada de avaliações: texto, nota, data, autor.
- Abra a aba Headers. Copie o endereço completo da requisição (Request URL) e observe os parâmetros: normalmente há o identificador do objeto, o número da página ou offset, o tamanho do lote e a ordenação.
- Encontre nessa mesma seção os cabeçalhos da requisição: User-Agent, Accept, Referer. Eles precisarão ser passados pelo script.
Dica: Clique com o botão direito na requisição encontrada e escolha Copy, depois Copy as cURL. Você terá um comando com todos os cabeçalhos. É prático colar isso em um arquivo de texto como referência: se o script parar de funcionar de repente, você compara a requisição dele com a de referência.
Particularidades de cada mapa
- Yandex Maps. As avaliações são carregadas em lotes com indicação de ordenação (por novidade, por nota, por relevância). Fixe obrigatoriamente uma ordenação, senão os conjuntos vão divergir entre execuções. A data vem em formato legível por máquina, a nota é um número. As respostas da organização ficam em um campo aninhado separado.
- 2GIS. O serviço tem um serviço público de avaliações que o próprio site consulta. A requisição contém o identificador da filial e os parâmetros de limite e offset. A resposta traz texto, nota, data, nome do usuário, resposta oficial e contador de utilidade. Também vem o número total de avaliações — use-o para verificar a completude.
- Google Maps. A mais complicada das três: as avaliações vêm em um formato empacotado dentro de respostas longas. Para algumas dezenas de objetos, é mais simples usar a Places API com chave oficial — ela entrega um conjunto limitado das últimas avaliações de cada lugar, o que muitas vezes basta para avaliar o sentimento. Para coleta completa de objetos de terceiros, será preciso automatização de navegador — esse é o tema do bloco avançado.
Escrevendo o primeiro script
Crie o arquivo collect_maps.py e cole o esqueleto. Substitua o endereço da requisição e os nomes dos campos pelo que você viu no painel de desenvolvedor — eles mudam entre plataformas e podem mudar com o tempo.
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
Vamos entender o que acontece aqui. A variável PROXY armazena os dados do seu proxy móvel. O cabeçalho User-Agent apresenta a requisição como um navegador móvel — isso faz sentido combinado com o IP móvel. A função collect percorre as páginas até que a plataforma devolva uma lista vazia, e depois de cada página faz uma pausa de 2,5 segundos. A pausa não é formalidade: ela faz a carga parecer uma leitura de uma pessoa real.
Execução e gravação do resultado
- No final do arquivo, adicione a chamada da função para um objeto de sources.csv e a gravação das linhas em CSV através do módulo csv com codificação utf-8-sig, para que o Excel abra o texto em português corretamente.
- Abra o terminal na pasta do projeto e execute
python collect_maps.py. - Acompanhe a saída. É útil imprimir o número da página e a quantidade de linhas coletadas após cada requisição.
- Abra o arquivo gerado no Excel e examine as primeiras 20 linhas.
Resultado esperado: um arquivo CSV com avaliações de uma organização, onde o número de linhas é aproximadamente igual ao contador de avaliações na página da organização.
Possíveis problemas: a resposta chega com código 403 ou vazia. Solução: confira os cabeçalhos com o comando cURL copiado, especialmente Referer e Accept. Verifique se o proxy está conectado e respondeu a uma requisição de teste a qualquer site. Aumente a pausa para 4-5 segundos.
Verificação: Pegue três avaliações aleatórias do arquivo e encontre-as na página da organização pelo texto. Todas as três devem ser localizadas, com as mesmas notas e datas.
Etapa 5: Coletando avaliações de marketplaces — Wildberries, Ozon, Yandex Market
Objetivo da etapa: adaptar a abordagem da etapa 4 aos marketplaces, nos quais as avaliações são vinculadas aos produtos e têm campos adicionais: prós, contras, variante do produto, fotos.
Wildberries
Na Wildberries, as avaliações são vinculadas não ao SKU, mas ao identificador unificador da ficha, sob o qual as cores e tamanhos estão agrupados. Isso é importante: se você coletar avaliações por SKU, receberá as de todas as variantes de uma vez, e será preciso filtrar pelo campo de variante.
- Abra a ficha do produto, pressione F12, vá para a aba Network com filtro Fetch/XHR.
- Role até o bloco de avaliações e clique em "Ver todas as avaliações".
- Encontre a requisição cujo nome contenha feedbacks. Na resposta haverá uma lista com texto, nota, data, campos de prós e contras, nome do autor, cor e tamanho, indicador de presença de foto e resposta do vendedor.
- Preste atenção ao número total de avaliações na resposta — ele ajudará a verificar a completude.
- Copie o endereço e os cabeçalhos, insira no script conforme o modelo da etapa 4. A paginação aqui pode não existir — parte das respostas vem inteira, às vezes em um arquivo muito grande. Aumente o timeout para 60 segundos.
Ozon
A Ozon protege ativamente os dados e verifica o comportamento do cliente. Para as avaliações, o site usa uma requisição interna para a composição da página, na qual as avaliações são um dos blocos. Ordem prática das ações:
- Abra a página do produto, depois vá para a seção de avaliações pelo link da ficha.
- No painel de desenvolvedor, encontre a requisição cuja resposta contenha um array com os campos content, score ou rating e author. Ela pode ter nomes diferentes; procure pelo conteúdo usando a barra de busca do painel (combinação Ctrl+F dentro da aba Network).
- Copie a requisição como cURL. Preste atenção aos cabeçalhos e cookies: a Ozon é sensível à ausência deles.
- Ao reproduzir pelo script, use uma sessão requests.Session, para que os cookies sejam mantidos entre as requisições, e faça a primeira requisição à página comum do produto, e só depois às avaliações. Isso imita o caminho natural do usuário.
- Mantenha pausas de 4-6 segundos e troque o IP através do proxy móvel a cada 30-50 requisições.
Atenção: Se a plataforma começar a entregar uma página de verificação de navegador ou captcha — isso é um sinal para parar, e não para insistir. Diminua a frequência, troque o IP pelo link de rotação e espere 10-15 minutos. A pressão sistemática sobre os mecanismos de defesa leva ao bloqueio de todo o pool de endereços e contraria as regras das plataformas.
Yandex Market
As avaliações no Yandex Market são de dois tipos: sobre o produto (comuns a todos os vendedores) e sobre a loja. Para analisar o produto, são necessárias as primeiras; para analisar o serviço, as segundas. Ambos os tipos têm divisão em prós, contras e comentário, além de nota e data. A requisição das avaliações é encontrada do mesmo modo, através do painel de desenvolvedor, na aba "Avaliações" da ficha do produto.
Conversão para o esquema
Nos marketplaces, o campo de texto frequentemente consiste em três partes. Registre-as assim: pros — na coluna pros, cons — na coluna cons, e o comentário geral — em text. Se para a análise for necessário um texto corrido único, na etapa de limpeza una as três colunas por um separador, mas nos dados brutos armazene separadamente.
Dica: Nos marketplaces, as avaliações com foto e compra confirmada são sensivelmente mais informativas. Adicione um filtro no script: primeiro colete tudo, e na análise observe separadamente o recorte com has_photo igual a 1. Muitas vezes é justamente ali que estão as descrições mais detalhadas de defeitos e cenários reais de uso.
Resultado esperado: um CSV por marketplace com avaliações de 3-5 produtos, convertidas para o esquema unificado.
Possíveis problemas: o número de avaliações coletadas é menor que o contador na página. Causa: a plataforma limita a profundidade da entrega ou entrega apenas avaliações com texto, ocultando notas sem comentário. Solução: compare os contadores de "total de notas" e "com texto" na página — geralmente a diferença se explica justamente por isso.
Verificação: Abra o arquivo no Excel, monte uma tabela dinâmica pela coluna rating. A distribuição das notas deve corresponder aproximadamente ao que a ficha do produto mostra: se na plataforma 70% são cincos, na sua amostra deve haver um valor próximo.
Etapa 6: Coletando avaliações de agregadores — Otzovik, iRecommend, Flamp, Zoon
Objetivo da etapa: aprender a trabalhar com plataformas nas quais as avaliações são artigos autônomos com marcação HTML, e não JSON em segundo plano.
Em que os agregadores diferem
Otzovik e iRecommend constroem as páginas de forma clássica: cada avaliação é uma página separada com título, texto longo, nota, data, prós e contras, e na página do objeto há uma lista de links para essas avaliações com prévias resumidas. Flamp e Zoon estão mais próximos dos mapas: organização, lista de avaliações, carregamento em lotes. Assim, para os dois primeiros é preciso analisar HTML; para os segundos, serve o método da etapa 4.
Instalação da biblioteca para análise de HTML
Execute no terminal pip install beautifulsoup4 lxml. A biblioteca BeautifulSoup permite encontrar elementos da página por tags e classes, como você os encontra com os olhos no painel de desenvolvedor.
Coleta passo a passo no Otzovik
- Abra a página do objeto (produto, empresa, curso) no Otzovik.
- Pressione F12 e vá para a aba Elements (Elementos).
- Clique no ícone de seta no canto superior esquerdo do painel e clique no título da primeira avaliação da lista. No painel, o elemento HTML será destacado. Anote a tag e a classe — esse é o seletor do link para a avaliação.
- Do mesmo modo, encontre os elementos de nota (geralmente um bloco com estrelas e um atributo numérico), de data e de texto resumido.
- Role a página para baixo e encontre o bloco de paginação. Clique no número 2 e veja como o endereço mudou — geralmente um número de página é adicionado. Esse é o modelo para o percurso.
- No script: carregue a página da lista via requests com proxy, analise com BeautifulSoup, extraia os links para as avaliações e as prévias, e depois passe para a próxima página da lista. Pausa entre páginas — 5-8 segundos; os agregadores são mais sensíveis que os mapas.
- Se for necessário o texto completo da avaliação, e não a prévia, faça uma segunda passagem: por cada link, carregue a página da avaliação e extraia o texto principal, os blocos de prós e contras, a nota por subcritério.
iRecommend
A lógica é análoga à do Otzovik: página do objeto com lista de avaliações e páginas separadas de avaliações. A diferença está na marcação e no fato de a nota ser expressa pela quantidade de estrelas preenchidas — conte os elementos de estrela com classe ativa, em vez de procurar o número.
Flamp e Zoon
Para essas plataformas, use o método da etapa 4: abra a organização, alterne para Fetch/XHR, role as avaliações e encontre a requisição de fundo. O Flamp entrega avaliações com nota, texto, data, resposta oficial e utilidade. O Zoon — com nota, texto, data e resposta da organização. Ambas as plataformas mostram o número total de avaliações para controle de completude.
Mini-exemplo de análise de HTML
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
Os nomes das classes aqui são hipotéticos — substitua pelos reais que você viu no painel Elements. As verificações de elemento vazio são obrigatórias: se a marcação de uma avaliação for diferente, o script não deve quebrar por inteiro.
Dica: Nos agregadores, as datas frequentemente são escritas por extenso: "ontem", "3 dias atrás", "14 de março". Crie uma função separada de normalização de datas, que converte essas strings para o formato AAAA-MM-DD em relação à data da coleta. Sem ela, a ordenação por tempo não vai funcionar.
Resultado esperado: um CSV com avaliações de um ou dois agregadores, no qual cada avaliação tem nota, data e texto, e para Otzovik e iRecommend também o link para a página completa.
Possíveis problemas: os seletores deixaram de encontrar elementos depois de algumas páginas. Causa: a plataforma entregou uma página de verificação em vez da lista. Solução: verifique o título da página após cada carregamento; ao aparecerem sinais de verificação — pausa, troca de IP, repetição após alguns minutos.
Verificação: O número de avaliações coletadas de uma página da lista é igual ao número de avaliações que você vê nessa página no navegador. Se coletou menos — um dos seletores está estreito demais.
Etapa 7: Conectando proxies móveis e configurando a rotação
Objetivo da etapa: fazer com que o parser de avaliações funcione de forma estável em dezenas e centenas de objetos, distribuindo a carga e sem criar um fluxo anômalo a partir de um único endereço.
Por que justamente proxies móveis
Todas as plataformas deste guia são voltadas ao público móvel: a maioria das avaliações é escrita e lida em smartphones. Os endereços IP móveis das operadoras de telefonia são endereços atrás dos quais estão simultaneamente centenas e milhares de assinantes reais. As plataformas não podem bloquear esses endereços sem prejudicar usuários de verdade, por isso são tolerantes com eles. Para a coleta de avaliações, isso significa menos verificações, menos falsos positivos das defesas e velocidade previsível.
Configuração da conexão
- Entre no painel do mobileproxy.space e abra a lista dos seus proxies.
- Copie host, porta, login e senha. Preste atenção ao protocolo: para requests, é mais prático o proxy HTTP, mas SOCKS5 também é suportado se você instalar o complemento
pip install requests[socks]. - Insira os dados na variável PROXY do script. Formato: protocolo, dois-pontos, duas barras, login, dois-pontos, senha, arroba, host, dois-pontos, porta.
- Copie do painel o link para troca de IP e salve na variável ROTATE_URL.
- Execute uma requisição de teste através do proxy para qualquer serviço que mostre o seu IP. A resposta deve trazer um endereço de operadora móvel, e não o do seu provedor residencial.
Estratégia de rotação
Existem duas abordagens, e ambas funcionam.
- Rotação por tempo. No painel, configura-se um intervalo de troca automática de IP, por exemplo a cada 5 minutos. O script não faz nada — o endereço troca sozinho. Serve para coletas longas e calmas.
- Rotação por evento. O script aciona o ROTATE_URL no momento certo: a cada N requisições, ao passar a um novo objeto ou ao receber um código 429/403. Serve quando é preciso controle.
Regra prática para avaliações: troque o IP ao passar a cada novo objeto e adicionalmente após 40-60 requisições dentro de um mesmo objeto. Depois da troca de IP, faça uma pausa de 5-10 segundos — a operadora precisa de tempo para o novo endereço ficar ativo.
Tratamento de erros e repetições
Adicione à função fetch_page uma camada de proteção: em códigos 429, 403, 5xx ou timeout — acionar a rotação, esperar, repetir a requisição até três vezes com pausa crescente (10, 30, 90 segundos). Se três tentativas não resolveram — gravar o objeto no arquivo failed.txt e passar ao próximo. Assim, um objeto problemático não vai parar toda a coleta, e você depois recoleta as lacunas separadamente.
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
Quantas threads usar
Para iniciantes — uma thread. Um proxy, uma conexão, percurso sequencial. É lento, mas confiável: 500-1000 avaliações por hora sem um único problema. Depois que você confirmar que tudo está estável, pode adicionar um segundo proxy e executar uma segunda instância do script na outra metade da lista de objetos. Mais de 3-4 threads por plataforma, para avaliações, quase nunca é necessário.
Dica: Alinhe o User-Agent ao tipo de IP. Se você passa por um proxy móvel, apresente-se como navegador móvel, como no exemplo da etapa 4. A divergência "IP móvel, mas Chrome desktop no Windows" por si só não é crítica, mas a coerência reduz o número de verificações adicionais.
Resultado esperado: um script que percorre todo o sources.csv de uma plataforma sem intervenção manual, troca o IP ao passar entre objetos e grava os objetos problemáticos em failed.txt.
Possíveis problemas: depois da troca de IP, as primeiras requisições falham por timeout. Solução: aumente a pausa após a rotação para 15 segundos. O proxy não conecta de jeito nenhum — verifique se não há uma lista branca de IPs habilitada no painel e adicione o endereço do seu computador nela.
Verificação: Execute a coleta por 10 objetos seguidos. No log deve haver registros de troca de IP entre objetos, o arquivo failed.txt deve estar vazio ou conter no máximo um objeto, e o total de linhas no resultado deve ser comparável à soma dos contadores de avaliações da plataforma.
Etapa 8: Salvando, limpando e deduplicando
Objetivo da etapa: transformar o conjunto de CSVs brutos de diferentes plataformas em uma única tabela limpa, adequada para análise.
União dos arquivos
- Certifique-se de que todos os arquivos brutos estão na pasta raw e têm os mesmos cabeçalhos conforme o schema.txt.
- Crie o arquivo merge.py. Via pandas, leia todos os CSVs da pasta raw em um único DataFrame: a função pandas.concat une uma lista de tabelas.
- Verifique os tipos: rating deve ser número, published_at — data. Converta com pandas.to_numeric e pandas.to_datetime com o parâmetro errors='coerce', para que valores incorretos virem vazios em vez de quebrar o processamento.
Deduplicação
As repetições surgem por três motivos: sobreposição de páginas na paginação, execuções repetidas e uma mesma avaliação publicada pelo autor em várias plataformas. Trate na ordem:
- Apague duplicatas exatas pelo par source e review_id — são repetições de paginação e reexecuções. Use o método drop_duplicates com o parâmetro subset.
- Encontre duplicatas aproximadas dentro de uma mesma plataforma: mesmo object_id, mesma data e os primeiros 100 caracteres do texto iguais. Isso acontece quando a plataforma muda o identificador após a edição da avaliação.
- Não apague duplicatas entre plataformas, mas marque-as com uma coluna separada. O fato de a pessoa ter escrito o mesmo no Otzovik e no Google Maps já é informativo por si só.
Limpeza do texto
- Remova espaços duplos e quebras de linha dentro do texto.
- Remova frases de serviço das plataformas que caem no texto: "Ler na íntegra", "Mostrar mais".
- Substitua strings vazias em pros e cons por um valor explicitamente vazio, e não pela string "nenhum" ou "-".
- Verifique a codificação: se você vê caracteres estranhos, o arquivo foi salvo em codificação diferente de utf-8. Salve novamente a partir da fonte bruta.
Exportação do resultado
Salve a tabela final na pasta clean com o nome reviews_all_AAAA-MM-DD.xlsx através do método to_excel e, em paralelo, em CSV. O Excel é prático para visualização; o CSV, para carregar em outros sistemas. Salve adicionalmente um arquivo separado com um resumo: número de avaliações por plataforma, nota média por objeto, proporção de avaliações com resposta da empresa.
Dica: Adicione à tabela limpa uma coluna text_len com o comprimento do texto. Avaliações com menos de 30 caracteres são quase sempre inúteis para analisar causas, mas avaliações longas com nota 2-3 são ouro: nelas as pessoas explicam em detalhes o que exatamente está errado.
Resultado esperado: um único arquivo limpo com avaliações de todas as plataformas, sem duplicatas exatas, com tipos de dados corretos e um resumo.
Possíveis problemas: após a deduplicação, sumiram linhas demais. Causa: em alguma plataforma o review_id ficou vazio para todos os registros, e todos foram considerados duplicatas. Solução: verifique o preenchimento do review_id por plataforma e, para a plataforma problemática, forme o identificador a partir de object_id, data e hash do texto.
Verificação: O número de linhas no arquivo limpo é no máximo 5-10% menor que a soma das linhas dos arquivos brutos. Na coluna rating não há valores fora do intervalo 1-5, na coluna published_at não há datas futuras.
Verificação do resultado: checklist e testes
Antes de tirar conclusões a partir das avaliações coletadas, certifique-se de que a coleta foi bem-sucedida. Percorra o checklist completo.
Checklist de prontidão
- Para cada objeto de sources.csv há pelo menos uma avaliação na tabela limpa, ou o objeto está registrado em failed.txt com a causa.
- O número de avaliações por objeto difere do contador da plataforma em no máximo 10%.
- A distribuição das notas por objeto corresponde aproximadamente à distribuição que a plataforma mostra.
- A avaliação mais recente da tabela é datada de não mais que ontem em relação à data da coleta, se o objeto estiver ativo.
- Todas as datas estão no formato AAAA-MM-DD, todas as notas são números.
- Não há duplicatas exatas por source e review_id.
- Os nomes dos autores estão ausentes ou substituídos por hashes, se a tarefa não exigir nomes.
- Os arquivos de dados brutos foram salvos com data e não foram sobrescritos.
- Tokens e dados de proxy não estão dentro do script, mas em um arquivo de configuração separado.
Como testar por amostragem
- Escolha 10 avaliações aleatórias da tabela com a função sample do pandas.
- Para cada uma, abra a página do objeto na plataforma e encontre a avaliação por um trecho do texto.
- Confira a nota, a data e a presença de resposta da empresa.
- Se bateu 10 de 10 — ótimo. Se 8-9 — verifique se as divergências estão relacionadas à edição da avaliação após a coleta. Se for menos de 8 — há um erro sistemático na análise; volte à etapa correspondente.
Indicadores de sucesso
O sucesso é assim: você consegue abrir uma única tabela, filtrá-la por qualquer plataforma e objeto, ordenar por data e nota e, em cinco minutos, responder à pergunta inicial da etapa 1. Por exemplo, ver que 40% das avaliações com nota 1-2 sobre um café no Yandex Maps nos últimos três meses mencionam o tempo de espera, enquanto no 2GIS as mesmas pessoas elogiam o café, mas reclamam do atendimento. Se a pergunta recebe resposta — a coleta cumpriu a sua função.
Erros típicos e soluções
Abaixo estão reunidos os problemas que quase todo mundo encontra ao configurar um parser de avaliações pela primeira vez. Formato: problema, causa, solução.
1. O script coletou apenas as primeiras 20 avaliações
Causa: a paginação não foi implementada ou o parâmetro de offset foi definido incorretamente.
Solução: volte ao painel de desenvolvedor, role a lista de avaliações duas vezes e compare os endereços de duas requisições consecutivas. O parâmetro que mudou é o offset ou o número da página. Certifique-se de que o script o incrementa no passo correto.
2. Todas as avaliações vêm com a mesma data — a data da coleta
Causa: no campo published_at está sendo gravado collected_at, ou a plataforma entrega a data em um campo com outro nome.
Solução: abra o raw_json de uma avaliação e encontre o campo com a data de publicação. Ele pode se chamar date, created, published, time, updatedAt. Corrija o nome do campo no script.
3. O texto em português aparece errado no Excel
Causa: o CSV foi salvo em utf-8 sem marca de ordem de bytes, e o Excel o abre em outra codificação.
Solução: salve com a codificação utf-8-sig ou exporte direto para xlsx via to_excel.
4. A plataforma responde com código 403 a cada requisição
Causa: cabeçalhos obrigatórios não foram passados, cookies de sessão não foram definidos ou a requisição está indo com frequência excessiva.
Solução: compare com o comando cURL de referência. Use requests.Session e carregue primeiro a página comum do objeto. Aumente as pausas para 5 segundos. Troque o IP pelo proxy e espere 10 minutos antes de repetir.
5. As notas coletadas não batem com as reais
Causa: a plataforma armazena a nota em outra escala (por exemplo, de 0 a 100 ou de 1 a 10) ou em um campo separado está a nota de um subcritério, e não a geral.
Solução: confira três avaliações manualmente. Determine a escala e converta para cinco pontos por divisão com arredondamento. Documente isso no schema.txt.
6. O número de avaliações é diferente a cada execução
Causa: a ordenação não foi fixada, e a plataforma entrega conjuntos diferentes no modo "por relevância".
Solução: encontre o parâmetro de ordenação no endereço da requisição e fixe rigidamente a ordenação por data. Colete até encontrar uma avaliação mais antiga que o período desejado.
7. O script falha em um objeto e não continua
Causa: não há tratamento de exceções; qualquer erro para o programa.
Solução: envolva o processamento de cada objeto em try-except, grave o erro e o identificador do objeto em failed.txt e passe ao próximo. As lacunas você recoleta em uma execução separada.
8. Depois de uma semana, o script de repente parou de encontrar qualquer coisa
Causa: a plataforma mudou o endereço da requisição, a estrutura do JSON ou os nomes das classes no HTML.
Solução: isso é uma parte normal da vida de qualquer parser. Repita o procedimento de busca da requisição da etapa 4 e atualize o endereço e os nomes dos campos. Mantenha a lista de seletores e campos em um arquivo de configuração separado, para corrigir um só lugar, e não o código todo.
9. O proxy funciona, mas a velocidade é muito baixa
Causa: respostas grandes demais (os marketplaces às vezes entregam milhares de avaliações em um único arquivo) ou carga na estação base da operadora em horário de pico.
Solução: aumente o timeout, habilite a compressão pelo cabeçalho Accept-Encoding, agende coletas volumosas para o período noturno.
Recursos adicionais para avançados
Se o cenário básico já foi dominado, aqui está o caminho para evoluir. Este bloco pressupõe que você programa em Python com segurança.
Coleta incremental
Em vez de recoletar tudo, guarde para cada objeto a data da avaliação mais recente já coletada. Na próxima execução, colete com ordenação por data e pare assim que encontrar uma avaliação não mais nova que a data salva. Assim, a atualização diária de 500 objetos leva minutos em vez de horas, e a carga sobre as plataformas cai dezenas de vezes. Leve em conta que avaliações podem aparecer com data retroativa após a moderação — faça uma sobreposição de 2-3 dias.
Automação de navegador para plataformas complexas
O Google Maps e parte das seções da Ozon são mais fáceis de coletar via navegador controlado: o Playwright com um proxy móvel conectado abre a página, rola a lista de avaliações e intercepta as respostas de fundo por um handler de eventos response. Você obtém o mesmo JSON do painel de desenvolvedor, mas sem precisar reproduzir cabeçalhos e cookies manualmente. O Playwright suporta emulação de dispositivos móveis, o que combina perfeitamente com IP móvel. O preço é velocidade e consumo de memória: um navegador consome 300-500 MB, então rode no máximo 2-3 instâncias.
Armazenamento em banco de dados
Quando as avaliações passam de 100 mil, o CSV se torna desconfortável. Migre para SQLite (embutido no Python, arquivo em disco, zero configuração) ou PostgreSQL. A tabela reviews com índice único pelo par source e review_id protege automaticamente das duplicatas: a inserção via INSERT com tratamento de conflito ON CONFLICT DO NOTHING descarta as repetições no nível do banco.
Enriquecimento e análise
- Sentimento e temas. Passe os textos por um modelo de linguagem com o prompt do tipo "extraia 3 temas principais e o sentimento geral". Coloque o resultado em colunas separadas. Para dezenas de milhares de avaliações, use processamento em lote e cache, para não pagar duas vezes pelo mesmo texto.
- Dinâmica das notas. Monte a nota média por semana para cada objeto. Uma queda acentuada é sinal de um problema que as avaliações vão explicar com palavras.
- Velocidade de reação da empresa. A diferença entre published_at e a data da resposta da empresa é um indicador direto da qualidade do atendimento, seu e dos concorrentes.
- Dicionário de dores para anúncios. A análise de frequência de substantivos e adjetivos nas avaliações com nota 1-2 dá uma lista pronta de formulações para criativos e páginas de destino.
Monitoramento da saúde do parser
Configure a execução diária pelo Agendador de Tarefas do Windows ou pelo cron e adicione uma verificação simples: se em 24 horas foi coletado menos de 30% da média semanal ou a proporção de erros passou de 10% — envie uma notificação no Telegram via bot. Assim você ficará sabendo de uma mudança na marcação da plataforma no mesmo dia, e não um mês depois, quando os dados forem necessários.
Gestão do pool de proxies
Ao trabalhar com várias plataformas ao mesmo tempo, fixe um proxy móvel separado para cada uma. Assim, o comportamento em uma plataforma não afeta a reputação do endereço em outra. Faça a rotação para mapas com menos frequência (os objetos geralmente são pequenos, 50-200 avaliações), para marketplaces com mais (milhares de avaliações por ficha). Mantenha um registro: hora, plataforma, IP, código de resposta. Em uma semana, esse registro mostrará quais intervalos de rotação são ideais para o seu perfil de carga.
FAQ: perguntas frequentes sobre coleta de avaliações
É legal coletar avaliações de páginas públicas?
A coleta de informação publicamente acessível para análise própria não é proibida em si, mas há limites: os termos de uso das plataformas, as exigências da LGPD quanto ao tratamento de dados pessoais, a proibição de criar obstáculos ao funcionamento do serviço. Respeite as pausas, anonimize os autores, não publique as bases coletadas e use APIs oficiais onde elas existirem. Para uso comercial dos dados, consulte um advogado.
É possível fazer sem programação?
Em parte. Para os seus próprios objetos, os painéis administrativos bastam. Para tarefas pontuais pequenas, servem extensões de navegador que exportam para tabela os elementos visíveis na página: você rola as avaliações manualmente e a extensão coleta. Para coleta regular de dezenas de objetos, o script ainda é mais prático e confiável, e os trechos prontos deste guia podem ser usados quase sem alterações.
Para que proxies móveis, se eu tenho só 10 objetos?
Para 10 objetos e uma coleta única, dá para tentar sem eles. Mas assim que você começar a atualizar os dados regularmente ou ampliar a lista, as requisições de um único IP residencial começarão a receber verificações adicionais. O proxy móvel resolve isso de antemão, e o custo é incomparável ao tempo gasto para lidar com bloqueios.
Quantas avaliações por hora dá para coletar de verdade?
Em uma thread com pausas de 2-5 segundos — de 500 a 1500 avaliações por hora, dependendo do tamanho do lote na plataforma. Marketplaces que entregam centenas de avaliações em uma única resposta rendem mais; agregadores com HTML paginado, menos. Para a maioria das tarefas analíticas, isso é mais do que suficiente.
Como coletar só as avaliações novas, em vez de tudo de novo?
Guarde a data da última avaliação coletada por objeto, ordene por data na requisição e pare na primeira avaliação já conhecida. Mais detalhes no bloco sobre coleta incremental.
Avaliações sem texto, só com nota — coletar ou não?
Depende da tarefa. Para calcular a nota média e a dinâmica — sim, elas influenciam os números. Para analisar causas — não, podem ser filtradas no processamento. Colete tudo e filtre na etapa de análise: recoletar sai mais caro.
O que fazer se a plataforma mostrar captcha?
Parar a coleta por 10-15 minutos, trocar o IP pelo proxy, reduzir a frequência das requisições e verificar os cabeçalhos. O captcha é um sinal de que o seu comportamento parece atípico. A tarefa é torná-lo típico, e não forçar a passagem pela verificação.
Como armazenar nomes de autores sem infringir a lei?
O melhor é não armazenar de forma alguma. Se for preciso distinguir avaliações de um mesmo autor, use um hash unidirecional do nome. Se os nomes forem realmente necessários (por exemplo, para responder ao cliente pelo painel), armazene-os apenas no âmbito do trabalho com a sua própria organização e não os compartilhe com terceiros.
Com que frequência os parsers de avaliações quebram?
As grandes plataformas mudam as requisições internas e a marcação algumas vezes por ano. Com um bom monitoramento, o conserto leva 20-40 minutos: repetir a busca da requisição e atualizar os campos. Mantenha seletores e endereços em um arquivo de configuração, e as correções serão pontuais.
Dá para coletar de todas as plataformas com um único script?
Sim, se você fizer um esqueleto comum (proxy, repetições, gravação no esquema) e, para cada plataforma, uma função-adaptador separada que conhece o endereço da requisição e os nomes dos campos. É exatamente assim que funcionam os projetos maduros: um módulo comum e uma dezena de pequenos adaptadores.
Conclusão
Vamos resumir. Você percorreu o caminho desde a formulação da pergunta até uma tabela limpa de avaliações de três tipos diferentes de plataforma. Você aprendeu a encontrar requisições de fundo pelo painel de desenvolvedor, a reproduzi-las com um script, a analisar HTML onde o JSON não está disponível, a conectar proxies móveis com rotação, a tratar erros e repetir requisições, a unir e limpar dados. Separadamente, você entendeu os caminhos oficiais de exportação e os marcos legais, o que protege tanto os dados quanto você.
O principal a levar daqui: avaliações são um tipo especial de dado com dinâmica própria. Elas aparecem o tempo todo, são editadas, passam por moderação e carregam informação pessoal. Por isso, o parser de avaliações não é um script pontual, mas um pequeno sistema: coleta, armazenamento dos dados brutos, conversão para o esquema, deduplicação, monitoramento. Cada elemento desse sistema você já construiu na forma básica.
O que fazer a seguir:
- Amplie o sources.csv até a lista real de objetos e faça uma coleta completa.
- Configure a execução incremental diária pelo agendador.
- Adicione pelo menos uma camada analítica: dinâmica da nota ou tematização das avaliações negativas.
- Mantenha um registro das mudanças das plataformas e atualize os adaptadores conforme as quebras.
Para onde evoluir. O próximo nível é a automação da reação: notificações à equipe sobre uma avaliação negativa em até uma hora após a publicação, relatórios comparativos de concorrentes uma vez por semana, integração dos temas das avaliações no plano de produto e nas hipóteses de anúncios. Os dados você já tem. Falta transformá-los em decisões, e é aí que começa a parte mais interessante do trabalho.
