Como montar um corpus para sistema RAG usando proxies móveis e não coletar lixo: guia passo a passo
Sumário do artigo
- Introdução: o que você vai conseguir e para quem é este guia
- Preparação inicial: ferramentas, acessos, ambiente
- Conceitos básicos em linguagem simples
- Etapa 1: definindo os limites do corpus e montando o mapa de fontes
- Etapa 2: conectando o proxy móvel e verificando se as requisições passam por ele
- Etapa 3: escrevendo um coletor cuidadoso com limites, rotação e registro
- Etapa 4: extraindo texto limpo de html e documentos
- Etapa 5: filtrando o lixo: deduplicação, padrões, qualidade, idioma
- Etapa 6: rotulando metadados e montando o corpus final
- Verificação do resultado: checklist e teste do corpus
- Erros típicos e soluções na coleta de corpus para rag
- Recursos extras para avançados
- Faq: perguntas frequentes sobre coleta de corpus
- Conclusão: o que foi feito e para onde ir agora
Introdução: o que você vai conseguir e para quem é este guia
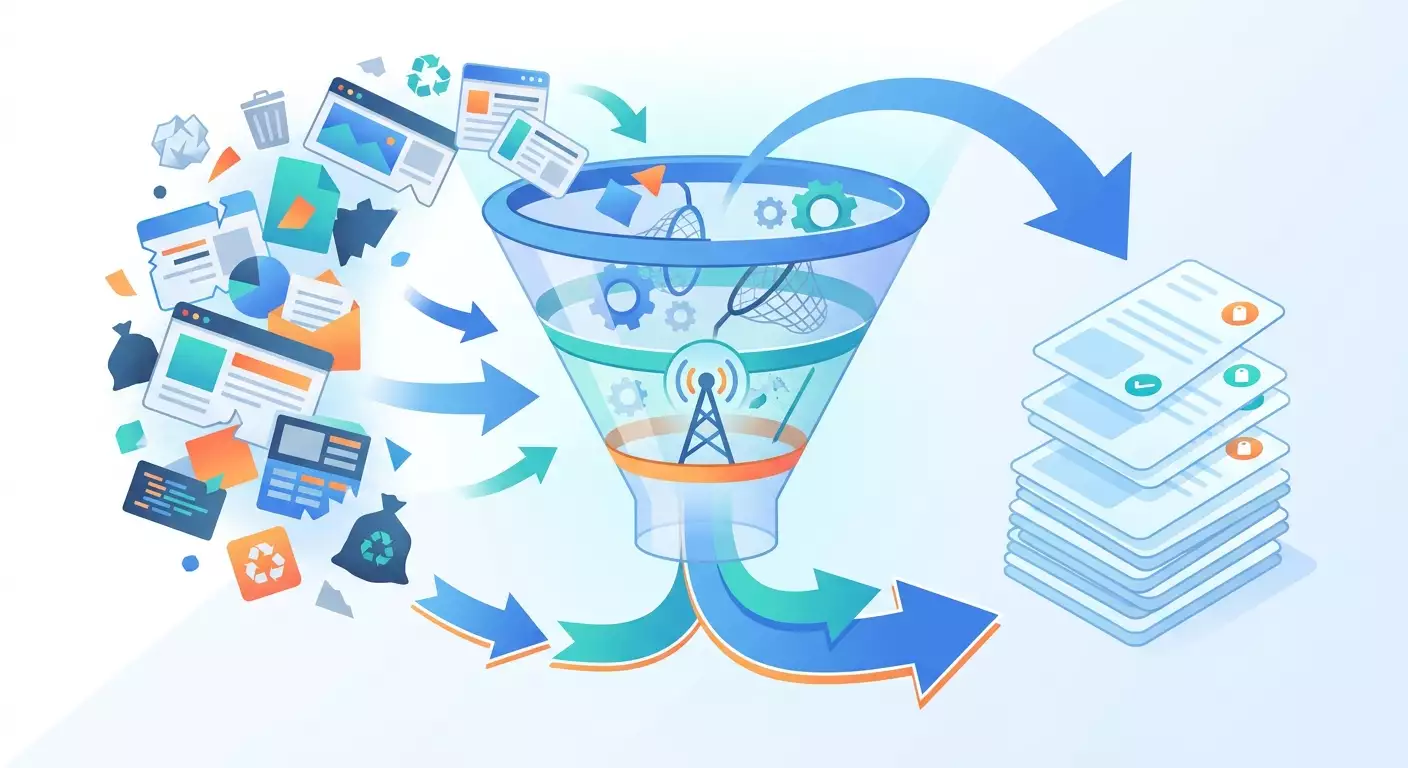
Um sistema RAG é tão bom quanto o corpus com que ele responde. Você pode pegar o modelo de linguagem mais forte, conectar um banco vetorial caro e, na saída, receber uma bobagem confiante se no corpus entrar menu do site, rodapé com copyright, duplicatas do mesmo artigo em cinco versões e páginas de "produto temporariamente indisponível". O modelo não distingue lixo de conhecimento. Ele simplesmente busca fragmentos parecidos e monta a resposta com eles.
Este guia passo a passo aborda uma única etapa: a coleta do corpus. Não vamos entrar no funcionamento do banco vetorial, na escolha de embeddings e na configuração de chunks, sobre isso há materiais separados no blog. Aqui vamos parar exatamente na fronteira: no seu disco há um conjunto limpo, rotulado e deduplicado de documentos em formato JSONL, pronto para ser entregue a qualquer pipeline de indexação.
O que você vai conseguir no final:
- uma lista de fontes com limites claros: o que coletamos, o que não coletamos;
- um coletor funcional em Python que acessa via proxy móvel, respeita limites e não derruba sites alheios;
- uma pasta com páginas e documentos brutos, cada um com metadados;
- um script de extração de texto principal sem navegação, anúncios e blocos padronizados;
- filtros de qualidade e deduplicação que descartam o lixo antes de ele entrar no índice;
- o arquivo final do corpus e um relatório com números que mostram que tudo foi feito corretamente.
Para quem é este guia. Para profissionais de marketing e donos de negócio que querem montar uma base de conhecimento da sua área e construir um assistente em cima dela. Para afiliados que precisam de um corpus sobre ofertas, landing pages e regras de plataformas de anúncios. Para desenvolvedores que já conectaram proxies a scripts e agora querem fazer isso com cuidado e de forma sistemática. O texto principal é escrito para iniciantes, e no final há um bloco separado para avançados.
O que você precisa saber antes. Saber rodar comandos no terminal e abrir arquivos num editor de texto. Noções básicas de Python no nível "entendo o que faz um loop for". Ter acesso a um proxy móvel: endereço, porta, login, senha e link para troca de IP.
Quanto tempo vai levar. Preparar o ambiente leva cerca de 30 minutos. Passar por todas as etapas leva de 3 a 5 horas, dependendo do volume do corpus. A coleta em si de alguns milhares de páginas pode rodar em segundo plano por várias horas, mas você não precisa participar durante esse tempo.
Preparação inicial: ferramentas, acessos, ambiente
Antes de escrever a primeira linha de código, organize seu espaço de trabalho. Isso economiza horas de depuração depois.
Requisitos de sistema
- Computador ou servidor com Windows 10/11, macOS ou Linux. Para coletar dezenas de milhares de páginas é mais prático um VPS alugado, mas para o primeiro corpus um notebook resolve.
- Pelo menos 8 GB de memória RAM. A deduplicação de corpus grandes adora memória.
- Espaço livre em disco: no mínimo 5 GB. O HTML bruto ocupa de 5 a 10 vezes mais que o texto limpo, e vamos armazenar os dois.
- Internet estável. O proxy adiciona latência, então um canal doméstico lento vai esticar bastante a coleta.
O que instalar
- Python 3.11 ou mais recente. Baixe o instalador do site oficial e, ao instalar no Windows, marque a caixa "Add Python to PATH". Verifique no terminal:
python --version. Deve aparecer uma linha comoPython 3.12.x. - Ambiente virtual. Crie uma pasta de projeto, por exemplo
rag-corpus, entre nela e executepython -m venv venv. Ative: no Windowsvenv\Scripts\activate, no macOS e Linuxsource venv/bin/activate. No início da linha do terminal vai aparecer(venv). - Bibliotecas. Instale com um único comando:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm. A instalação leva de 1 a 3 minutos. - Editor de texto com destaque de código: VS Code, PyCharm Community ou qualquer outro.
Acessos ao proxy
Abra o painel do seu serviço de proxy. No cartão do proxy móvel comprado, encontre quatro valores: host (endereço IP ou nome de domínio), porta para HTTP e porta para SOCKS5, login e senha. Copie separadamente o link de troca de IP: é uma URL para a qual basta fazer uma requisição GET para que o proxy receba um novo endereço da operadora. Anote tudo num arquivo .env na pasta do projeto, e não direto no código.
Estrutura de pastas
Crie dentro do projeto as seguintes pastas: raw para páginas brutas, clean para o texto extraído, corpus para o arquivo final, logs para os registros. Pastas vazias no começo são normais.
Backups
O corpus leva tempo para ser montado, e perdê-lo dói. Faça um acordo consigo mesmo: a pasta raw nunca é sobrescrita, só complementada. Depois de cada etapa importante, arquive o resultado: tar -czf raw_backup_2026-03-01.tar.gz raw/ no Linux e macOS, ou pelo compactador nativo do Windows. Se você errar nos filtros e apagar algo útil, sempre dá para voltar aos dados brutos sem precisar coletar de novo.
Dica: Crie desde já um arquivo sources.md e registre nele cada decisão: quais sites você pega, quais seções exclui, por quê. Daqui a um mês, quando o assistente começar a responder estranho, esse arquivo vai salvar sua noite.
Conceitos básicos em linguagem simples
Se é a sua primeira vez coletando dados para um sistema RAG, alguns termos vão aparecer em cada etapa. Vamos destrinchá-los rapidamente.
O que é RAG e por que o corpus importa mais que o modelo
RAG (Retrieval-Augmented Generation) é a abordagem em que o modelo de linguagem, antes de responder, recebe um conjunto de fragmentos da sua base de conhecimento. O modelo não "sabe" os seus documentos, ele lê os trechos encontrados e responde com base neles. Daí a regra simples: se há lixo na base, a busca cedo ou tarde vai puxar justamente ele, e a resposta vai se apoiar na linha "Assine nossa newsletter" em vez da instrução. Por isso a etapa de coleta do corpus não pode ser pulada.
Corpus, documento, metadados
Corpus é o conjunto inteiro de textos que vão para o sistema RAG. Documento é uma unidade de sentido: um artigo, uma página de ajuda, um PDF de instruções, uma ficha de produto. Metadados são a identidade do documento: de onde veio, quando foi coletado, em que idioma, quem é o autor, a que seção pertence. Sem metadados você não consegue nem atualizar o corpus, nem explicar ao usuário de onde veio a resposta, nem filtrar o que está desatualizado.
Proxy móvel e por que usar na coleta
Proxy móvel é um servidor intermediário que faz suas requisições saírem para a internet através de um IP de operadora de celular. Para a coleta de corpus ele resolve três questões práticas. Primeira: distribuição de carga. Em vez de bater no site sempre do mesmo endereço, você acessa de endereços diferentes, e cada fonte vê um tráfego calmo e raro. Segunda: geografia. Muitos sites mostram conteúdo, preços e disponibilidade diferentes conforme a região, e o proxy móvel da cidade certa entrega exatamente a versão da página que seus clientes veem. Terceira: estabilidade de sessões longas. A rotação de IP pelo link permite continuar a coleta por horas, sem depender de um único endereço.
Rotação é a troca de endereço IP. Ela pode ser por agendamento (a cada N minutos) ou sob demanda (você aciona o link quando precisa). Na coleta de corpus a segunda é mais prática: trocou de fonte, trocou de endereço.
O que considerar lixo
No contexto do corpus, lixo é tudo aquilo que não traz conhecimento sobre o seu tema, mas ocupa espaço no índice e estraga a busca:
- navegação, menus, rodapés, "breadcrumbs", formulários de inscrição;
- duplicatas exatas e quase exatas de um mesmo texto em endereços diferentes;
- páginas vazias: "Página não encontrada", "Produto esgotado", "Em manutenção";
- textos em outro idioma, se o corpus for monolíngue;
- páginas truncadas, em que o proxy ou o site devolveram metade do HTML;
- conteúdo de terceiros que você não tem direito de usar.
Marco legal
Colete apenas dados abertos, disponíveis sem autenticação, e seus próprios documentos. Respeite o arquivo robots.txt: é a lista de regras do site sobre quais seções podem ser percorridas automaticamente. Não colete dados pessoais de terceiros: nomes com telefone, endereços, contas. Se você está montando um corpus com documentos internos, certifique-se de que tem o direito de usá-los. Neste guia, o proxy é usado como ferramenta de coleta distribuída honesta, e não como forma de fazer o que a fonte proibiu.
Etapa 1: Definindo os limites do corpus e montando o mapa de fontes
Objetivo da etapa: obter um arquivo com a lista de fontes, onde para cada uma está registrado quais URLs pegamos, quais excluímos, com que profundidade percorremos e quantas requisições por minuto permitimos.
A causa mais comum de corpus lixo não são erros técnicos, e sim a ausência de limites. A pessoa dispara o coletor "no site inteiro", recebe 40 mil páginas, das quais só 800 são do tema, e depois passa uma semana limpando. Vamos fazer o contrário: primeiro o mapa, depois a coleta.
Instruções
- Formule as perguntas que seu sistema RAG deve responder. Escreva de 20 a 30 perguntas reais dos usuários. Por exemplo, para a base de conhecimento de um serviço de proxy: "Como trocar o IP pelo link", "Por que o proxy responde devagar", "Quais portas são suportadas". Essas perguntas serão o seu conjunto de testes na etapa de verificação.
- Para cada pergunta, anote onde está a resposta. Seção de ajuda, documentação, artigos do blog, PDFs de normas, páginas de produto. Tudo o que não estiver nessa lista não entra no corpus.
- Abra cada fonte no navegador e estude a estrutura dos endereços. Normalmente o conteúdo útil fica em prefixos previsíveis:
/help/,/docs/,/blog/,/faq/. E o lixo fica em outros:/tag/,/search?,/cart/,/author/, páginas de paginação como?page=. - Verifique o robots.txt da fonte. Abra
https://dominio/robots.txt. Encontre as linhasDisallow: esses caminhos ficam excluídos sem discussão. Se houver tambémCrawl-delay, anote como a pausa mínima entre requisições. - Encontre o sitemap. Muitas vezes ele está indicado no robots.txt na linha
Sitemap:, ou fica em/sitemap.xml. O sitemap é uma lista pronta de endereços que evita a varredura recursiva de links e o lixo associado a ela. - Defina a carga. Para sites pequenos, use no máximo 10 a 15 requisições por minuto. Para portais grandes com CDN, até 30. Em caso de dúvida, escolha menos: o corpus não tem pressa.
- Defina a geografia. Se o conteúdo depende da região (preços, entrega, disponibilidade), decida de qual cidade seu coletor deve "olhar" e escolha o proxy móvel correspondente.
- Formalize tudo num arquivo
sources.json.
Exemplo de registro para uma fonte:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]O campo rotate_every define após quantas requisições o coletor vai acionar o link de troca de IP. Troque as aspas simples por aspas duplas ao salvar num arquivo JSON de verdade; aqui elas estão apenas para ilustrar.
Atenção: Não adicione às fontes sites cujo conteúdo útil só aparece após login na conta. Primeiro, isso viola o contrato de usuário da maioria das plataformas. Segundo, um corpus assim não pode ser legalmente atualizado nem distribuído dentro da empresa.
Dica: Crie uma fonte separada para seus próprios documentos: uma pasta com PDFs, DOCXs e exportações da sua CRM ou base de conhecimento. Eles não precisam ser baixados via proxy, mas serão processados e limpos pelo mesmo pipeline das páginas web.
Verificação: Você tem o arquivo sources.json em que cada fonte tem prefixos de inclusão, padrões de exclusão, limite de requisições e idioma. Abra 5 endereços aleatórios do sitemap que passem pelos filtros e confirme que cada um tem texto relevante, e não um catálogo de links.
Possíveis problemas
- O site não tem sitemap. Monte a lista de endereços manualmente a partir de algumas páginas-índice ou com uma varredura simples de links apenas dentro dos prefixos permitidos, com profundidade 2.
- O sitemap tem 100 mil endereços. Filtre pelos prefixos e depois pegue uma amostra de 200 endereços, colete e avalie a qualidade antes de rodar tudo.
- O conteúdo útil está espalhado por domínios diferentes. Crie um registro separado em
sources.jsonpara cada domínio, com seu próprio limite e sua própria geografia.
Etapa 2: Conectando o proxy móvel e verificando se as requisições passam por ele
Objetivo da etapa: confirmar que o script realmente acessa pelo proxy móvel, que a rotação funciona e que as latências são aceitáveis para a coleta.
Instruções
- Crie o arquivo
.envna raiz do projeto e insira os valores do painel:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxCada valor em sua própria linha. Adicione .env ao .gitignore se você usa controle de versão.
- Crie o arquivo
proxy_check.pycom o seguinte conteúdo:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP sem proxy:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP via proxy:', ip1, 'em', round(time.time() - t0, 2), 'seg') print('Trocando de IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP após rotação:', ip2) print('Rotação funcionou:', ip1 != ip2)Antes, instale pip install python-dotenv. No arquivo real, cada linha de código fica na sua própria linha.
- Execute:
python proxy_check.py. - Leia a saída. O primeiro IP deve ser o da sua casa ou servidor. O segundo deve ser diferente e pertencer a uma operadora de celular. O terceiro deve ser diferente do segundo, e a última linha deve mostrar
True. - Meça a latência. Se a requisição via proxy demora mais de 5-6 segundos, a coleta será lenta. Verifique se o proxy escolhido está geograficamente próximo dos sites-alvo ou entre em contato com o suporte do serviço.
- Teste SOCKS5 como alternativa. Se a porta HTTP der resultado instável, troque
http://porsocks5h://emproxy_urle use a porta SOCKS5 do painel. Vai precisar depip install requests[socks]. O sufixohé importante: ele faz o proxy resolver os nomes de domínio por conta própria.
Atenção: Não faça rotação de IP com mais frequência do que o seu plano permite. A maioria dos proxies móveis tem um intervalo mínimo entre trocas, normalmente de 30 segundos a 2 minutos. Requisições muito frequentes ao link de rotação são ignoradas ou bloqueiam a função temporariamente.
Dica: Faça cinco medições de latência seguidas e anote a mediana. Esse número será usado na próxima etapa para definir os timeouts corretamente: o timeout deve ser cerca de 4 a 5 vezes a latência típica.
Verificação: O script mostra três endereços IP diferentes, a linha Rotação funcionou: True, e a latência típica via proxy não passa de 3-4 segundos. Se está tudo assim, o proxy está pronto para uso.
Possíveis problemas
- Erro 407 Proxy Authentication Required. Confira login e senha, garanta que não há espaços extras. Se a senha tiver caracteres
@ou:, codifique-os comurllib.parse.quote. - Erro Connection refused ou timeout. O proxy pode estar vinculado ao seu IP autorizado. Acesse o painel e adicione o endereço atual do servidor à lista de permitidos ou mude para autenticação por login e senha.
- O IP após a rotação não mudou. Aumente a pausa depois da requisição ao link de rotação para 15-20 segundos. Algumas operadoras não emitem o novo endereço imediatamente.
- Erros de SSL. Atualize a biblioteca com
pip install -U certifi. Não desative a verificação de certificados com o parâmetroverify=False: isso não é seguro.
Etapa 3: Escrevendo um coletor cuidadoso com limites, rotação e registro
Objetivo da etapa: obter um script que percorre os endereços do sitemap, respeita o robots.txt e os limites, acessa via proxy, troca de IP conforme o agendamento, salva o HTML bruto e mantém um registro em que cada requisição é visível.
Aqui é importante entender a filosofia. Um bom coletor para sistema RAG é lento, educado e paranoicamente detalhado nos logs. Um crawler rápido e agressivo vai coletar uma pilha de páginas truncadas e erros 429, e depois você não vai saber o que disso é lixo.
Instruções
- Crie o arquivo
fetch.py. Estrutura do script: carregar configurações, interpretar o sitemap, filtrar endereços, loop de requisições com pausas, salvar resultado. - Carregue o sitemap e filtre os endereços. O sitemap é um XML em que cada endereço fica na tag
loc. Faça o parse com oxml.etree.ElementTreepadrão. Mantenha apenas endereços que comecem cominclude_prefixese não contenham nenhum dosexclude_patterns. Salve o resultado emurls_help_center.txte olhe para ele com os próprios olhos. - Conecte a verificação de robots.txt. Use
urllib.robotparser.RobotFileParser: carregue o arquivo uma vez por domínio e, antes de cada requisição, perguntecan_fetch(user_agent, url). Endereços proibidos devem ser pulados e registrados no log com a marcarobots_disallow. - Defina um User-Agent honesto. Por exemplo:
CorpusCollector/1.0 (+contact: data@yourcompany.ru). O dono do site deve entender quem o acessou e como entrar em contato. Isso não é só ética, é prática: um agente claro raramente cai em bloqueios automáticos. - Implemente as pausas. A partir de
rate_per_minute, calcule a pausa base:60 / rate_per_minutesegundos. Adicione uma variação aleatória de 20% a 40% para que as requisições não saiam como metrônomo. Se o robots.txt tiverCrawl-delay, use o maior dos dois valores. - Implemente a rotação. Conte as requisições e, quando o contador atingir
rotate_every, chame o link de troca de IP, espere 10 segundos e zere o contador. A rotação também deve acontecer ao mudar de fonte. - Trate as respostas. Código 200, salvamos. Códigos 301 e 302 o
requestsresolve sozinho, mas registre o endereço final: ele será necessário para a deduplicação. Código 404 vai para o log e é ignorado. Código 429 ou 503 significa "rápido demais": faça uma pausa de 5 minutos, aumente a pausa base em uma vez e meia e repita uma vez. Se o repeat não ajudar, pule e siga em frente. - Salve o HTML bruto junto com a identidade. Para cada página, grave uma linha no arquivo
raw/help_center.jsonl.
Trecho-chave do código de gravação e do loop:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))Repare na condição len(html) > 2000. Uma página com texto relevante quase nunca tem menos de dois kilobytes de HTML. É o primeiro filtro de lixo, o mais grosseiro, e já elimina respostas vazias e páginas falsas na entrada.
- Rode numa amostra. A primeira execução deve ser em 50 endereços. Confira o log, abra alguns HTML salvos no navegador. Confirme que são exatamente as páginas esperadas.
- Rode a coleta completa. No servidor, use
nohup python fetch.py &ouscreenpara que o processo sobreviva ao fechamento do terminal. Coletar 3000 páginas a 12 requisições por minuto leva cerca de 4-5 horas.
Atenção: Não rode várias cópias do coletor no mesmo site em paralelo pelo mesmo proxy. A rotação de IP não anula os limites de carga no servidor da fonte. Se quiser acelerar, paralelize por sites diferentes, não por um só.
Dica: Registre no log o IP do proxy usado em cada requisição. Quando, na etapa de limpeza, aparecer um lote de páginas truncadas, você vai identificar pelo IP e pelo horário se foi falha de uma sessão específica e vai recoletar só ela.
Dica: Adicione retomada ao coletor: antes de rodar, leia os endereços já coletados de raw/*.jsonl e pule-os. Assim, uma queda de conexão ou um reinício do servidor não obriga a começar do zero.
Verificação: Na pasta raw há um arquivo JSONL, o número de linhas nele é próximo ao número de endereços com status 200 no log, e uma linha aleatória tem os campos url, fetched_at, proxy_ip e um HTML completo. A proporção de erros e pulos no log não passa de 5%.
Possíveis problemas
- Muitas respostas 429. Você está rápido demais para esse site. Reduza
rate_per_minutepela metade, aumenterotate_everypara que a rotação não pareça um pico vindo de novos endereços. - As páginas chegam vazias, mesmo com status 200. O conteúdo é renderizado em JavaScript. Essas fontes exigem renderização de navegador, tratada no bloco avançado. Por enquanto, marque-as em
sources.jsoncom a flagneeds_js: true. - A coleta roda, mas muito devagar. Verifique a latência do proxy da Etapa 2 e confira se o timeout não está em 120 segundos quando a latência típica é 2, senão cada página travada come dois minutos.
- O script quebra na codificação. Use
r.textcom verificação der.encoding; se o site entregar a codificação errada, definar.encoding = r.apparent_encodingantes de ler.
Etapa 4: Extraindo texto limpo de HTML e documentos
Objetivo da etapa: transformar o HTML bruto e os arquivos em texto limpo, em que só resta o conteúdo principal da página: título, parágrafos, listas, tabelas, sem menus, rodapés, inserções de anúncios e widgets.
É o momento em que a qualidade do corpus nasce ou morre. A abordagem ingênua de "remover todas as tags" deixa no texto itens de menu, botões "Comprar", texto do banner de cookies e listas de artigos parecidos. Tudo isso depois aparece nas respostas do sistema RAG.
Instruções para páginas web
- Crie o arquivo
extract.py. Ele lêraw/*.jsonllinha a linha e escreve o resultado emclean/*.jsonl. - Use a biblioteca
trafilaturapara extrair o texto principal. Ela é treinada para encontrar a área de conteúdo da página e descartar blocos padronizados.
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- O parâmetro
favor_precision=Truefaz a biblioteca ser mais rígida: ela prefere perder um pedaço de texto a capturar o menu. Para o corpus de um sistema RAG, essa é a escolha correta. Se perceber que blocos necessários estão sendo perdidos, por exemplo tabelas de características, troque parafavor_recall=Truesó para a fonte específica. - Adicione um método de reserva. Se a
trafilaturaretornarNoneou texto com menos de 200 caracteres, tente extrair o conteúdo por um seletor CSS que você encontra na mão: abra a página no navegador, aperte F12, encontre o bloco com o texto principal, copie a classe dele, por exemploarticle-body. Use oBeautifulSouppara recortar apenas esse bloco. Registre o seletor emsources.jsoncomocontent_selector. - Normalize o texto. Troque espaços não separáveis por espaços comuns, condense três ou mais quebras de linha em duas, remova espaços no início e no fim das linhas. Não altere maiúsculas e minúsculas nem remova pontuação: isso piora a busca.
- Salve junto com os metadados originais. Copie da gravação bruta
url,final_url,fetched_at, adicionesourcedesources.json, os campos da extração e o comprimento do texto em caracteres.
Instruções para PDF e DOCX
- PDF. Use o
pypdf: abra o arquivo, percorra as páginas, chamepage.extract_text()e combine. Guarde o número da página para cada fragmento: são metadados valiosos, com eles o usuário pode localizar o ponto no original. Se o texto voltar vazio, o PDF contém digitalizações e não texto: separe esses arquivos numa pasta específica, o reconhecimento está fora do escopo deste guia. - DOCX. Use o
python-docx: percorradocument.paragraphsedocument.tables. Títulos no Word têm estiloHeading 1,Heading 2: guarde-os como linhas separadas com marcação, eles facilitam o fatiamento do documento depois. - Remova cabeçalhos e rodapés. Em PDFs de instruções, em cada página se repetem o nome da empresa, o número da versão e "Página 3 de 40". Reúna todas as linhas do documento, encontre as que se repetem em mais da metade das páginas e remova-as.
Atenção: Não remova as tabelas por questão de estética. Em instruções, tarifas e características, são justamente as tabelas que contêm respostas a perguntas específicas: "qual o limite", "quanto custa", "qual a porta". Guarde-as linha a linha, separando as células por tabulação ou barra vertical.
Dica: Depois da extração, pegue 20 documentos aleatórios e leia-os inteiros. Não passe os olhos, leia de fato. Uma revisão assim encontra mais problemas sistêmicos do que qualquer filtro automático: por exemplo, você vai perceber que em todas as páginas do blog o texto termina com um bloco "Leia também" com três títulos colados.
Verificação: Na pasta clean há arquivos JSONL. O número de registros é de pelo menos 80% do número de páginas brutas. Em 10 registros aleatórios, o texto começa com o título ou o primeiro parágrafo do artigo, e não com itens de menu, e termina com o último parágrafo relevante, e não com a assinatura "Todos os direitos reservados".
Possíveis problemas
- Extrai-se muito pouco texto. O site tem layout fora do padrão. Adicione
content_selectore um caminho de reserva comBeautifulSoup. - Restam botões e itens de menu no texto. Ative
favor_precisione, para casos resistentes, adicione uma lista de stop-strings: linhas curtas como "Compartilhar", "Ler mais", "Voltar ao topo" devem ser removidas se estiverem numa linha própria. - O PDF entrega texto de trás para frente ou com palavras quebradas. Tente o
pdfplumberem vez dopypdf, ele lida melhor com colunas.
Etapa 5: Filtrando o lixo: deduplicação, padrões, qualidade, idioma
Objetivo da etapa: descartar duplicatas, páginas falsas, blocos padronizados, textos em idioma estrangeiro e documentos curtos demais ou corrompidos, mantendo apenas o que traz conhecimento.
Mesmo depois de uma extração cuidadosa, sobram de 15% a 40% de lixo no corpus. É normal. Anormal é deixar isso passar para o índice.
Instruções
- Crie o arquivo
filter.py, que lêclean/*.jsonl, aplica os filtros em ordem, grava os documentos aprovados emcorpus/filtered.jsonle os descartados emcorpus/rejected.jsonlcom a indicação do motivo. - Filtro 1: comprimento mínimo. Documentos com menos de 300 caracteres quase sempre são páginas falsas, resumos ou erros de extração. Descarte com o motivo
too_short. Para fichas de produto, o limite pode cair para 150. - Filtro 2: frases-chave de página falsa. Monte uma lista de frases que indicam página vazia: "página não encontrada", "produto indisponível", "acesso restrito", "ative o javascript", "manutenção em andamento". Se a frase aparecer nos primeiros 300 caracteres e todo o texto tiver menos de 1500, descarte com o motivo
placeholder. - Filtro 3: idioma. Use
langdetect.detectnos primeiros 1000 caracteres. Se o idioma não corresponder ao indicado na fonte, descarte com o motivowrong_lang. Lembre que em textos curtos o detector erra, então aplique-o depois do filtro de comprimento. - Filtro 4: duplicatas exatas. Normalize o texto: caixa baixa, condense espaços, remova pontuação. Calcule o
sha1. Se o hash já apareceu, descarte com o motivoexact_dupe guarde a referência ao original. Fontes típicas de duplicatas exatas: a mesma página emhttpehttps, com e semwww, com e sem o parâmetro?utm_source, além de versões para impressão. - Filtro 5: quase duplicatas. Aqui você precisa do MinHash da biblioteca
datasketch. Quebre o texto normalizado em shingles de 5 palavras, construa umMinHashcom 128 permutações, insira numMinHashLSHcom limiar 0.85. Documentos que já têm um vizinho parecido no índice devem ser descartados com o motivonear_dup. Assim saem versões do mesmo artigo com datas diferentes, páginas de produto que diferem só pela cor e notícias republicadas.
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- Filtro 6: linhas padronizadas. Reúna todas as linhas de todos os documentos de uma fonte e conte em que porcentagem de documentos cada uma aparece. Linhas que aparecem em mais de 30% dos documentos e têm menos de 200 caracteres são padrão: avisos legais, assinaturas, chamadas para assinar. Remova-as de todos os documentos. Não é descarte do documento, é limpeza dentro dele.
- Filtro 7: qualidade do texto. Calcule métricas simples: a proporção de letras entre todos os caracteres deve ser maior que 0,6; o comprimento médio das palavras deve ficar entre 3 e 12; a proporção de linhas terminando em ponto deve ser maior que 0,3 para artigos. Documentos fora desses limites geralmente são tabelas de código, dumps ou extrações quebradas. Descarte com o motivo
low_quality, mas certifique-se de olhar o que foi descartado: para documentação técnica, os limites precisam ser mais flexíveis. - Filtro 8: páginas truncadas. Compare o
html_lenda gravação bruta com a mediana da fonte. Se o HTML for menor que 30% da mediana e o texto for interrompido no meio de uma frase sem ponto final, é uma resposta truncada. Motivotruncated. Registre esses endereços emrecollect.txte recoleta-os via proxy na Etapa 3. - Rode o filtro e analise o relatório. O script deve exibir uma tabela: quantos documentos entraram, quantos foram descartados por cada motivo, quantos restaram.
Atenção: Nunca apague arquivos de clean e raw durante a filtragem. O filtro apenas grava novos arquivos. Se o limiar do MinHash ficar agressivo demais e você perder 40% de documentos úteis, é só mudar o número e rodar o script de novo em dois minutos.
Dica: O limiar de 0,85 para quase duplicatas é bom para artigos e materiais de ajuda. Para fichas de produto de uma mesma marca, que diferem só pelo tamanho ou volume, ele vai juntar tudo num só. Decida com antecedência se o seu sistema RAG precisa de todas as variantes e, então, ou suba o limiar para 0,95, ou una as variantes num único documento com uma tabela de diferenças ainda na etapa de extração.
Dica: Documentos descartados não são lixo, são material de depuração. Uma vez por semana, abra rejected.jsonl, filtre por motivo e olhe 10 registros aleatórios. Se entre os low_quality aparecem com regularidade tabelas úteis de tarifas, os limites precisam ser ajustados.
Verificação: O relatório do filtro mostra um cenário razoável: descarte total de 10% a 40%, com as duplicatas representando uma parte notável, e o motivo truncated representando no máximo 2-3%. No arquivo filtered.jsonl não há dois documentos com o mesmo texto normalizado, e 10 registros aleatórios parecem artigos completos ou seções de documentação.
Possíveis problemas
- Descarte acima de 60%. Provavelmente os limites de qualidade estão rígidos demais ou há erro de normalização fazendo todos os textos ficarem parecidos. Exiba 20 descartados aleatórios e encontre a causa sistêmica.
- O MinHash está muito lento. Num corpus com mais de 100 mil documentos, reduza
num_permpara 64 ou conte por fonte separadamente. - O detector de idioma marca textos em russo como búlgaro ou macedônio. Acontece em fragmentos curtos com muitos nomes próprios. Verifique o idioma nos primeiros 2000 caracteres e aceite qualquer idioma de um grupo próximo como correspondência.
Etapa 6: Rotulando metadados e montando o corpus final
Objetivo da etapa: obter um único arquivo corpus/corpus_v1.jsonl em que cada documento tem um identificador estável, um conjunto completo de metadados e está pronto para ser entregue ao pipeline de indexação.
Os metadados são o que diferencia um corpus de uma pilha de texto. Eles permitem atualizar fontes específicas, explicar ao usuário a origem da resposta, filtrar por data e seção e, principalmente, não refazer todo o trabalho daqui a um mês.
Instruções
- Defina o esquema do documento. Fixe-o no arquivo
schema.mde não mude sem versionar o corpus. Mínimo recomendado:
doc_id: identificador estável, por exemplosha1definal_url, para que na recoleta o documento receba o mesmo id;source: nome da fonte desources.json;urlefinal_url;title;section: seção do site, calculada a partir do primeiro segmento do caminho depois do prefixo, por exemplohelp/proxies;lang;published_at: data de publicação, se extraída;fetched_at: data de coleta;geo: região do proxy que fez a coleta;text;text_len,text_sha1;corpus_version: por exemplov1.
- Calcule a seção. Faça o parse de
final_urlcomurllib.parse.urlparse, pegue o caminho, remova o prefixo da fonte e mantenha um ou dois segmentos. A seção vai virar um filtro no sistema RAG depois: o usuário pergunta sobre pagamento, a busca vai primeiro para a seçãobilling. - Normalize as datas. Traga todas as datas para ISO 8601 em UTC. Se a data de publicação não for encontrada, deixe o campo vazio, e não preencha com a data de coleta: são coisas diferentes, e confundi-las é perigoso na filtragem de material desatualizado.
- Adicione o título ao texto. Se o
textnão começa com otitle, insira o título na primeira linha. O título carrega palavras-chave importantes para a busca. - Ordene e grave. Ordene os documentos por
sourceefinal_url, grave emcorpus/corpus_v1.jsonl. Ao lado, coloquecorpus/manifest_v1.jsoncom o número de documentos por fonte, data da montagem, versão do esquema e parâmetros dos filtros. - Faça um arquivo. Compacte
corpus,sources.json,schema.mde a pastalogs. Esse arquivo é a versão reproduzível do seu corpus.
Dica: Guarde dados pessoais fora do corpus, de vez. Se nos textos de ajuda houver exemplos como "João Silva, +55 11 900...", substitua por placeholders ainda na etapa de montagem do corpus. O sistema RAG não deve ser capaz de entregar o telefone de ninguém, mesmo que estivesse em acesso aberto.
Verificação: O arquivo corpus_v1.jsonl abre, cada linha é um JSON válido com os campos do esquema, todos os documentos têm doc_id único, e todos têm source, lang, fetched_at, text preenchidos. O arquivo manifest_v1.json contém um resumo que bate com o número de linhas.
Possíveis problemas
- Endereços diferentes levam ao mesmo documento e geram doc_ids distintos. Calcule o id a partir de
final_urldepois dos redirecionamentos, removendo parâmetros de consulta e a barra final. - As datas são extraídas em formatos diferentes. Use
dateutil.parser.parsecom o parâmetrodayfirst=Truepara fontes em português.
Verificação do resultado: checklist e teste do corpus
O corpus está montado. Antes de levá-lo para indexação, vamos testá-lo como produto, e não como arquivo.
Checklist
- Existe
sources.jsoncom os limites de cada fonte e a indicação de cotas. - Todas as requisições passaram por proxy móvel, e no log cada requisição tem
proxy_ip. - A taxa de erros de coleta no log não passa de 5%, e respostas 429 são menos de 1%.
- Foram extraídos pelo menos 80% dos documentos das páginas brutas.
- O descarte na filtragem ficou entre 10% e 40%, e todos os motivos de descarte estão nomeados.
- Não há duplicatas exatas por texto normalizado no corpus.
- Todos os documentos têm os metadados obrigatórios preenchidos.
- Existe um arquivo com dados brutos, corpus, logs e configurações.
Como testar
- Teste com as perguntas da Etapa 1. Pegue suas 20 a 30 perguntas. Para cada uma, com uma busca simples por substring ou via
grep, encontre no corpus o documento que contém a resposta. Meta: pelo menos 90% das perguntas cobertas. Se uma pergunta não estiver coberta, encontre a página com a resposta no navegador e descubra por que ela não entrou: não estava no sitemap, foi descartada pelos filtros, o texto foi truncado. - Teste de lixo. Procure no corpus as strings "assinar", "carrinho", "cookie", "todos os direitos reservados", "leia também". Cada ocorrência é uma suspeita. Algumas unidades são aceitáveis se fizerem parte de um texto relevante; dezenas de ocorrências significam que o filtro de padrões precisa melhorar.
- Teste de truncamento. Conte os documentos cujo texto termina sem ponto, sem exclamação, sem interrogação e sem parêntese de fechamento. Devem ser menos de 5%. Olhe os demais a olho nu.
- Teste de distribuição. Monte um histograma dos comprimentos dos documentos. Um corpus saudável de ajuda ou blog tem um pico entre 2 e 8 mil caracteres e uma cauda longa. Um pico acentuado junto do limite mínimo indica páginas falsas que passaram.
- Teste de geografia. Se o conteúdo depende da região, abra 5 páginas com preços ou disponibilidade e compare com o que uma pessoa da cidade certa vê. Divergências indicam que o proxy escolhido é de outra região, ou que o site determina a região por cookie e não por IP.
Indicadores de sucesso
O corpus está pronto se a cobertura das perguntas de teste estiver acima de 90%, a proporção de documentos com sinais de lixo estiver abaixo de 3%, e o manifest permitir reproduzir completamente a montagem. Só depois disso o corpus é entregue ao pipeline de indexação do sistema RAG.
Erros típicos e soluções na coleta de corpus para RAG
Problema: nas respostas do assistente aparecem itens de menu e chamadas para assinar. Causa: a extração de texto rodou no modo de completude, e não de precisão, e o filtro de padrões não rodou. Solução: ative favor_precision, implemente a remoção de linhas repetidas em mais de 30% dos documentos da fonte e remonte o clean a partir do raw sem baixar de novo.
Problema: o assistente responde com base numa versão desatualizada da instrução. Causa: no corpus convivem a versão antiga e a nova do artigo, e as quase duplicatas não foram descartadas ou o limiar está alto demais. Solução: baixe o limiar do MinHash para 0,8 nas fontes com versionamento e, em caso de conflito, mantenha o documento com published_at mais recente.
Problema: parte das páginas foi coletada vazia, com status 200. Causa: o conteúdo é montado por JavaScript no lado do navegador. Solução: marque a fonte com needs_js e use renderização via Playwright do bloco avançado, ou encontre na API ou RSS do site o conteúdo pronto.
Problema: a coleta para em erros 429 e 503. Causa: frequência de requisições alta demais, e a rotação de IP foi usada em vez de reduzir a carga. Solução: diminua a frequência para 6-8 requisições por minuto, aumente a variação aleatória das pausas e faça uma pausa de 5-10 minutos no primeiro 429. Lembre que o limite de carga é questão de respeito à fonte, não de quantidade de endereços.
Problema: depois da rotação o site mostra conteúdo de outra região. Causa: o proxy móvel entregou um IP de outra cidade, ou o site determinou a região pelo cookie da sessão anterior. Solução: fixe a região desejada no painel do proxy, reinicie a sessão do requests depois de cada rotação para que os cookies não sejam levados adiante.
Problema: o corpus está montado, mas a cobertura das perguntas é de 60%. Causa: os limites das fontes estão estreitos demais, páginas úteis foram descartadas pelos prefixos. Solução: pegue as perguntas não cobertas, encontre as respostas no navegador, veja os endereços delas e amplie include_prefixes.
Problema: a deduplicação engoliu fichas de produto que diferem por características. Causa: o limiar de quase duplicatas é baixo demais para textos muito parecidos. Solução: para fontes de catálogo, suba o limiar para 0,95 ou una as variantes de um produto num só documento ainda na etapa de extração.
Problema: os textos dos PDFs saem em uma linha corrida sem parágrafos. Causa: o pypdf perde a formatação. Solução: mude para pdfplumber ou pymupdf e reconstrua os parágrafos por quebras duplas e recuos.
Problema: dados pessoais entraram no corpus. Causa: não houve etapa de anonimização. Solução: adicione antes da gravação no corpus uma busca de telefones, e-mails e nomes por padrões simples e substitua por placeholders; documentos duvidosos vão para revisão manual.
Recursos extras para avançados
Se o pipeline básico já funciona, veja por onde evoluí-lo.
Renderização de páginas com JavaScript via proxy
Instale pip install playwright e playwright install chromium. Rode o navegador com o parâmetro proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS}. Espere o seletor do conteúdo principal com page.wait_for_selector, e não com segundos fixos. Pegue page.content() e grave no mesmo formato raw, para que as etapas seguintes não mudem. A renderização é 5 a 10 vezes mais lenta que requisições comuns, então aplique só a fontes com a flag needs_js e reduza a frequência para 3-5 páginas por minuto.
Atualização incremental do corpus
Guarde no manifesto o text_sha1 de cada documento. Na próxima coleta, baixe as páginas, mas extraia e filtre apenas as que tiveram o hash do HTML alterado ou passaram mais de 30 dias desde a coleta. Use os cabeçalhos If-Modified-Since e ETag: muitos sites devolvem 304 sem corpo, e você economiza tráfego de proxy. Cada atualização recebe uma nova versão do corpus: v2, v3, e os arquivos antigos não são apagados.
Corpus multirregional
Se o negócio tem filiais e o conteúdo das fontes depende da cidade, crie vários proxies móveis com geografias diferentes. Colete a mesma página de cada região, guarde geo nos metadados e deduplique só dentro de cada região. O sistema RAG depois poderá responder "em São Paulo a entrega leva 2 dias, em Manaus 4", com base nas versões regionais reais das páginas.
Escore de qualidade em vez de limites rígidos
Em vez de descartar por limites, calcule para cada documento uma nota de qualidade de 0 a 1 com as mesmas métricas: comprimento, proporção de letras, proporção de frases completas, repetibilidade de linhas. Guarde a nota nos metadados. Assim o pipeline de indexação decide o que pegar, e a busca prioriza documentos confiáveis.
Deduplicação semântica
O MinHash pega duplicatas lexicais. Paráfrases da mesma instrução, com palavras diferentes, ele deixa passar. Para pegá-las, calcule embeddings dos documentos e busque pares com similaridade de cosseno acima de 0,95. Isso já é fronteira com a etapa de indexação, por isso aqui é só uma menção: decida onde fica a fronteira e não faça o mesmo trabalho duas vezes.
Monitoramento da coleta
Extraia do log métricas: requisições por minuto, taxa de códigos 200, latência média, número de rotações. Um dashboard simples com matplotlib ou uma tabela no terminal a cada 10 minutos mostra a degradação antes de você descobrir 500 páginas vazias de manhã.
FAQ: perguntas frequentes sobre coleta de corpus
É obrigatório usar proxy móvel para coletar corpus? Para documentos próprios e fontes pequenas, não. O proxy passa a ser necessário quando as fontes são muitas, a coleta dura horas, a versão regional do conteúdo importa, ou você não quer gerar uma carga perceptível no site a partir de um único endereço.
Com que frequência trocar o IP durante a coleta? Como referência: a cada 30-60 requisições ou ao mudar de fonte. Mais que isso não é preciso: o sentido da rotação é distribuir a carga e manter a sessão estável, não a frequência em si. Trocar muito sem reduzir o ritmo geral não diminui a carga.
Quantos documentos são necessários para um sistema RAG funcional? Para um assistente de um produto, muitas vezes bastam 200 a 500 documentos de qualidade. Para um nicho amplo, alguns milhares. Qualidade importa mais que volume: 500 artigos limpos dão respostas melhores que 20 mil com lixo.
É possível coletar de redes sociais e marketplaces? Apenas páginas abertas, dentro das regras da plataforma e do robots.txt, sem dados pessoais. Muitas plataformas têm APIs oficiais para obter conteúdo, comece por elas.
O que fazer com imagens e vídeos? No escopo de um corpus textual, guarde apenas legendas, textos alternativos e transcrições, se houver na página. Os arquivos em si não entram no corpus.
Por que não posso simplesmente baixar o site inteiro com um programa de download? Pode, mas você vai obter dezenas de milhares de arquivos sem metadados, com duplicatas, páginas de serviço e sem log. Depois vai ter que fazer todas as etapas deste guia de trás para frente, só que mais difícil.
Como saber se os filtros não removeram o que era necessário? Olhe rejected.jsonl por cada motivo, numa amostra de 10-20 registros. E verifique a cobertura das perguntas de teste: se as respostas desapareceram, procure-as no que foi descartado.
É preciso cortar os documentos em chunks nesta etapa? Não. O fatiamento em fragmentos é parte da indexação e depende do modelo de embeddings e do tamanho do contexto. A tarefa do corpus é entregar documentos inteiros com metadados e marcação de títulos, pelos quais o chunker poderá cortar com sentido.
Como atualizar o corpus sem remontar tudo? Guarde hashes, use requisições condicionais If-Modified-Since e versione o corpus. Mais detalhes no bloco avançado.
O que fazer se o site proíbe coleta automática no robots.txt? Respeitar a proibição. Escreva para o dono; muitas vezes ele fornece uma exportação, uma API ou uma autorização. Um corpus montado contra as regras da fonte gera riscos para todo o projeto.
Conclusão: o que foi feito e para onde ir agora
Você percorreu todo o caminho da ideia até o corpus pronto. Definiu os limites e montou o mapa de fontes com cotas e geografia. Conectou o proxy móvel e confirmou que a rotação funciona. Escreveu um coletor educado, que respeita o robots.txt, distribui a carga e mantém um registro detalhado. Extraiu texto limpo de HTML, PDF e DOCX. Descartou duplicatas, páginas falsas, padrões e páginas quebradas com motivos nomeados. Rotulou os metadados e montou um corpus versionado com manifesto. Testou-o com perguntas reais.
O resultado principal não é o arquivo no disco, e sim o processo reproduzível. Daqui a um mês você vai rodá-lo de novo e ter um corpus atualizado em algumas horas, e não em uma semana. E quando o sistema RAG começar a responder estranho, você vai saber exatamente onde procurar a causa: no log da coleta, no relatório do filtro ou no manifesto.
O que fazer em seguida. Entregue o corpus_v1.jsonl ao pipeline de indexação: fatiamento em fragmentos, embeddings, banco vetorial. Isso está em artigos relacionados do blog. Configure a execução periódica do coletor com atualização incremental. Amplie o mapa de fontes conforme crescer o número de perguntas não cobertas. Se o negócio for regional, adicione proxies das cidades necessárias e colete as versões regionais do conteúdo.
Para onde evoluir. Domine a renderização de navegador para sites complexos, a avaliação de qualidade dos documentos em vez de limites rígidos, a deduplicação semântica e o monitoramento da coleta. Cada um desses passos melhora a qualidade das respostas mais do que trocar de modelo. Dados limpos são a melhoria mais barata que você tem no sistema RAG. Boa coleta.