Collecter les avis sur les cartes, marketplaces et agrégateurs : guide pas à pas pour débutants
Sommaire de l'article
- Introduction : ce que vous obtiendrez au final
- Préparation préalable : outils et accès
- Notions de base : comment sont structurés les avis et pourquoi on les collecte différemment des catalogues
- Étape 1 : définir l'objectif et dresser la liste des sources
- Étape 2 : concevoir le tableau d'avis
- Étape 3 : utiliser les voies officielles — espaces personnels et api
- Étape 4 : collecter les avis sur les cartes — yandex maps, 2gis, google maps
- Étape 5 : collecter les avis sur les marketplaces — wildberries, ozon, yandex market
- Étape 6 : collecter les avis sur les agrégateurs — otzovik, irecommend, flamp, zoon
- Étape 7 : connecter les proxys mobiles et configurer la rotation
- Étape 8 : enregistrer, nettoyer et dédupliquer
- Vérification du résultat : checklist et test
- Erreurs typiques et solutions
- Fonctionnalités supplémentaires pour les avancés
- Faq : questions fréquentes sur la collecte d'avis
- Conclusion
Introduction : ce que vous obtiendrez au final
Les avis sont la source d'information la plus honnête sur un produit, une boutique ou un établissement. Les gens y racontent eux-mêmes ce qui leur a plu, ce qui a cassé, pourquoi ils ne reviendront plus et ce qu'ils conseilleraient à leurs amis. Le problème, c'est que les avis sont dispersés sur des dizaines de plateformes : cartes, marketplaces, agrégateurs, annuaires spécialisés. Les lire manuellement pendant des semaines, c'est impossible. Il faut donc une collecte systématique.
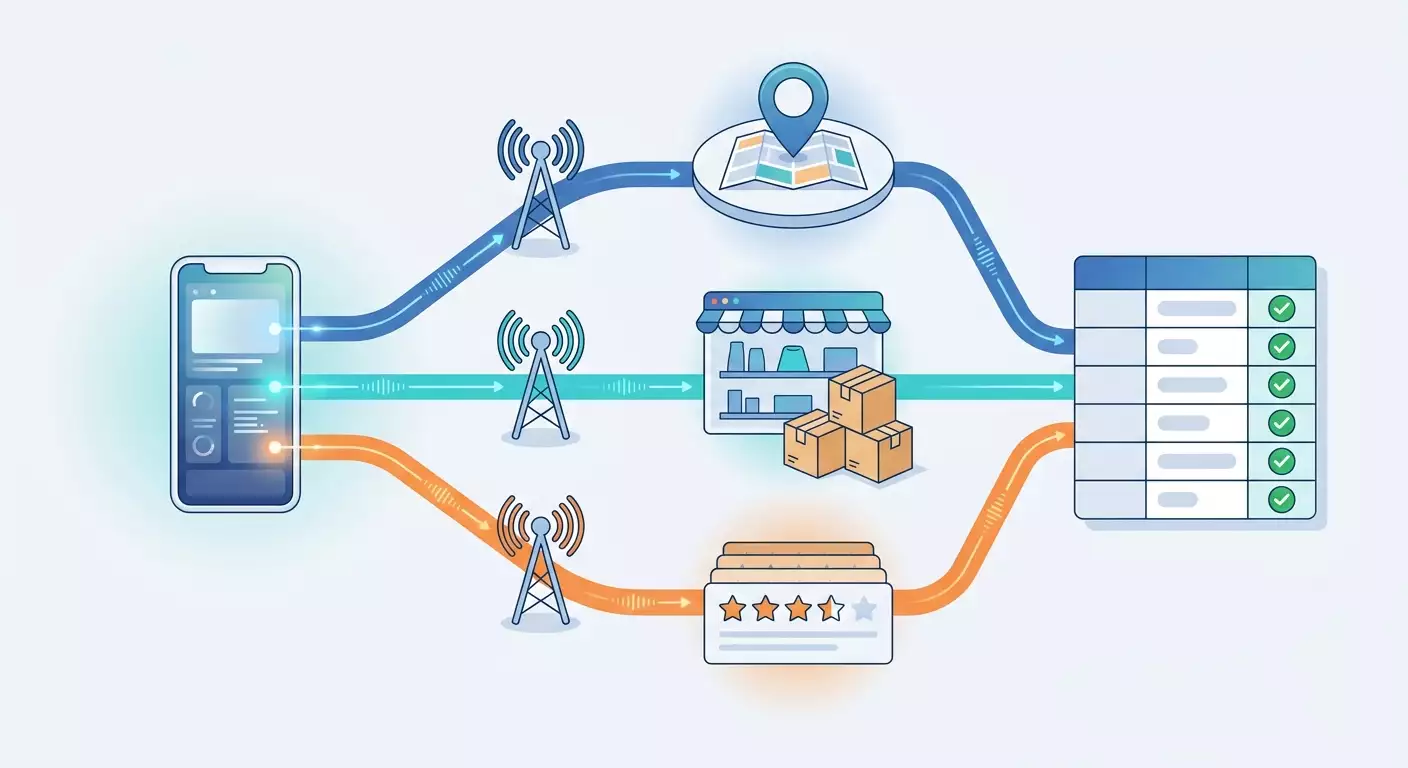
Dans ce guide, nous allons voir comment collecter des avis sur trois types de plateformes : les services cartographiques (Yandex Maps, 2GIS, Google Maps), les marketplaces (Wildberries, Ozon, Yandex Market) et les agrégateurs (Otzovik, iRecommend, Flamp, Zoon). Vous allez parcourir tout le chemin : de la définition de l'objectif et de la conception du tableau jusqu'au script fonctionnel, à la connexion des proxys mobiles et au nettoyage des données.
Ce que vous obtiendrez au final :
- Une compréhension de l'endroit et de la forme sous laquelle les avis se trouvent sur chaque type de plateforme.
- Une structure de tableau d'avis prête à l'emploi, que vous pourrez charger dans Excel, Google Sheets ou une base de données.
- Un scraper d'avis fonctionnel en Python, capable de passer par des proxys mobiles sans surcharger les plateformes.
- La connaissance des voies officielles d'export : espaces personnels, API partenaires, exports.
- Une checklist de vérification de la qualité des données collectées et une liste des erreurs typiques.
À qui s'adresse ce guide. Il est destiné aux marketeurs, propriétaires d'entreprises, arbitragistes et développeurs débutants. Si vous n'avez jamais écrit de code, ne paniquez pas. Une partie des scénarios se réalise sans programmation, et pour les scripts, nous fournissons des extraits prêts à l'emploi qu'il suffit de copier et de personnaliser. Pour ceux qui savent déjà programmer, il y a un bloc séparé avec des techniques avancées à la fin.
Ce qu'il faut savoir au préalable. Il suffit de savoir utiliser un navigateur, installer des programmes et travailler avec des tableaux. Une notion de base de ce qu'est un proxy aidera, mais nous expliquerons les termes clés au fil du texte.
Une frontière importante de ce contenu. Ici, nous ne parlons que des avis en tant que type de données à part entière : texte, note, date, auteur, réponse de l'entreprise. Nous n'abordons pas le scraping des catalogues de produits, des prix et des stocks — c'est un sujet distinct avec ses propres particularités. Si vous cherchez des prix, ce guide ne conviendra pas ; si vous cherchez le retour client, vous êtes au bon endroit.
Combien de temps cela prendra. La préparation de l'environnement prendra environ 30-40 minutes. La conception de la structure et la première collecte sur une plateforme prendront environ une heure. Le passage complet sur les trois types de plateformes, avec configuration des proxys et nettoyage des données, prendra 3-4 heures. Ensuite, la collecte prendra quelques minutes, car le script pourra être relancé.
Préparation préalable : outils et accès
Avant de collecter des avis, il faut préparer son poste de travail. Voici la liste de ce dont vous aurez besoin. Ne sautez pas cette section, même si certains éléments paraissent évidents : la moitié des problèmes aux étapes suivantes surviennent précisément à cause d'un environnement mal préparé.
Configuration système requise
- Un ordinateur sous Windows 10/11, macOS ou Linux. N'importe quel ordinateur portable des 6-7 dernières années fera l'affaire.
- Au moins 4 Go de RAM. Pour collecter des dizaines de milliers d'avis, mieux vaut 8 Go.
- Une connexion internet stable. La collecte elle-même n'exige pas une vitesse élevée, mais les coupures de connexion entraînent des pertes de données.
- Environ 2 Go d'espace libre sur le disque pour Python, les bibliothèques et les résultats.
Ce qu'il faut installer
- Python 3.11 ou plus récent. Téléchargez l'installateur depuis le site officiel de Python. Lors de l'installation sous Windows, cochez impérativement la case « Add Python to PATH » sur le premier écran de l'installateur. Sans cela, la commande python ne fonctionnera pas dans le terminal.
- Un éditeur de code. VS Code fera l'affaire — gratuit et clair. Après l'installation, ouvrez-le une fois pour vérifier qu'il se lance.
- Les bibliothèques Python. Ouvrez le terminal (PowerShell sous Windows, Terminal sous macOS) et exécutez la commande :
pip install requests pandas openpyxl. Attendez le message Successfully installed. Cela prendra 1-2 minutes. - Le navigateur Chrome ou Yandex Browser. Nécessaire pour étudier les plateformes via les outils de développement. Ils sont intégrés, rien à installer séparément.
- Un tableur. Excel, LibreOffice Calc ou Google Sheets — pour consulter les résultats.
Quels accès seront nécessaires
- Accès à des proxys mobiles. Inscrivez-vous sur mobileproxy.space, choisissez un forfait avec la géolocalisation souhaitée (pour les plateformes russes — des opérateurs russes) et récupérez les données de connexion : hôte, port, login, mot de passe. Dans votre espace personnel, trouvez aussi le lien de changement d'IP — il sera utile à l'étape de rotation.
- Accès aux espaces personnels des plateformes si vous collectez des avis sur votre propre entreprise. Il s'agit de Yandex Business, l'espace vendeur Wildberries, Ozon Seller, Yandex Market pour les vendeurs, Google Business Profile. Les exports officiels depuis ces espaces sont la source la plus propre.
- Un dossier de projet. Créez sur le disque un dossier, par exemple reviews_project, et à l'intérieur deux sous-dossiers : raw pour les données brutes et clean pour les données traitées. C'est votre assurance : les données brutes ne sont jamais écrasées.
Conseil : Créez immédiatement dans le dossier du projet un fichier texte sources.txt et notez-y chaque adresse depuis laquelle vous collectez des avis, avec la date. Dans un mois, vous ne vous souviendrez plus d'où vient tel ou tel tableau, et ce journal lèvera tous les doutes.
Sauvegardes
Les sauvegardes ici concernent les données, pas le système. Adoptez cette règle : chaque exécution du scraper écrit le résultat dans un nouveau fichier avec la date dans le nom, par exemple reviews_ozon_2026-03-14.csv. Ne supprimez pas les anciens fichiers pendant au moins un mois. Si la nouvelle collecte s'avère corrompue à cause de modifications sur la plateforme, vous aurez conservé une version fonctionnelle.
Vérification : Tapez dans le terminal python --version — la version 3.11 ou supérieure doit s'afficher. Puis tapez python -c 'import requests, pandas; print(1)' — le chiffre 1 doit apparaître sans erreur. Si les deux commandes ont fonctionné, l'environnement est prêt.
Notions de base : comment sont structurés les avis et pourquoi on les collecte différemment des catalogues
Avant de lancer quoi que ce soit, il est important de comprendre le type de données avec lequel vous travaillez. Un avis n'est pas qu'un texte. C'est un enregistrement structuré avec plusieurs champs, et il possède des particularités absentes d'une fiche produit.
Termes clés en langage simple
- Avis (review) — un enregistrement laissé par un utilisateur sur un objet : produit, boutique, établissement. Contient généralement une note, un texte, une date, un nom d'auteur et parfois des photos.
- Objet de l'avis — ce sur quoi porte l'avis : une fiche produit sur une marketplace, une organisation sur une carte, une entreprise sur un agrégateur. Chaque objet possède un identifiant unique sur la plateforme.
- Réponse de l'entreprise — la réplique d'un représentant de l'entreprise sous un avis. Pour analyser la qualité du support, c'est un champ à part.
- Pagination — le découpage des avis en pages ou en lots. La plateforme en renvoie par exemple 20 à la fois, et il faut demander les lots suivants.
- Scraper d'avis — un programme qui parcourt automatiquement les objets voulus, extrait les avis et les range dans un tableau. Cela peut être un simple script ou un service prêt à l'emploi.
- Déduplication — la suppression des doublons. Un même avis peut apparaître deux fois dans la sélection à cause de la pagination ou de relances.
- Proxys mobiles — des serveurs intermédiaires avec des adresses IP d'opérateurs mobiles. Les requêtes via eux ressemblent au trafic d'un utilisateur ordinaire depuis un smartphone. Les plateformes sont plus indulgentes avec ce trafic, car derrière une IP mobile se trouvent des centaines de personnes réelles.
- Rotation d'IP — le changement d'adresse du proxy à intervalle défini ou à la demande. Cela aide à répartir la charge et à ne pas créer de flux anormal depuis une seule adresse.
En quoi la collecte d'avis diffère de celle d'un catalogue
Un catalogue de produits est relativement statique : la fiche existe, elle a un prix et des caractéristiques. Les avis, eux, vivent autrement, et cela influe sur tout le processus.
- Les avis s'ajoutent en permanence. Il faut savoir ne récupérer que les nouveaux, plutôt que de tout reprendre à chaque fois.
- Les avis se chargent séparément. Sur la plupart des plateformes, le texte des avis n'arrive pas dans la page elle-même, mais via une requête distincte en arrière-plan. C'est une bonne nouvelle : ces requêtes renvoient du JSON prêt à l'emploi, nul besoin de parser le HTML.
- Les avis contiennent des données personnelles. Nom de l'auteur, avatar, parfois ville. Cela est soumis à des exigences légales — voir ci-dessous.
- Les avis sont triés et filtrés. Par défaut, la plateforme peut afficher les « utiles » ou les « récents ». Si vous ne fixez pas le tri, vous obtiendrez des ensembles différents d'une exécution à l'autre.
- Les avis sont modifiés et supprimés. La modération retire certains enregistrements, les auteurs changent leur note. La date de collecte devient un champ important.
Le cadre juridique à comprendre
Attention : Les avis contiennent des noms et d'autres informations sur les personnes. Lors de la collecte et du stockage, respectez les exigences de la loi n° 152-FZ sur les données personnelles : ne collectez pas plus que nécessaire pour la tâche, anonymisez les auteurs là où le nom n'est pas requis pour l'analyse, ne transmettez pas la base à des tiers. Lisez aussi les conditions d'utilisation de la plateforme et le fichier robots.txt : certains services décrivent explicitement les modes d'accès automatique autorisés. Si une API officielle ou un export depuis l'espace personnel existe pour votre tâche, commencez toujours par là.
Un autre principe : une charge respectueuse. Votre scraper d'avis doit se comporter comme un utilisateur attentif, pas comme un flot de requêtes. Des pauses entre les requêtes, un nombre raisonnable de threads et une rotation via des proxys mobiles ne sont pas une astuce, mais la norme d'une collecte responsable. Les plateformes bloquent non pas le fait même de l'automatisation, mais un comportement anormal qui gêne leur fonctionnement.
Étape 1 : Définir l'objectif et dresser la liste des sources
Objectif de l'étape : obtenir une liste précise et limitée d'objets sur lesquels nous collecterons des avis, et comprendre quels champs nous sont nécessaires. Sans cette étape, le scraper devient un projet sans fin.
Formulez la question à laquelle les avis répondront
Une bonne collecte commence par une question. Exemples de formulations efficaces :
- « Pourquoi le concurrent X a-t-il une note de 4,8 sur Wildberries alors que nous avons 4,4 dans la même catégorie ? »
- « Que critique-t-on le plus souvent dans les avis sur nos cinq cafés sur Yandex Maps ces six derniers mois ? »
- « Quels points de douleur des clients sont mentionnés dans les avis sur les cours en ligne sur Otzovik, pour les utiliser dans nos créas ? »
Remarquez : chaque question contient une plateforme, un objet, une période et un type d'information. C'est précisément ce qui détermine les paramètres de collecte.
Dressez la liste des objets
- Ouvrez la plateforme dans le navigateur et trouvez manuellement chaque objet souhaité : fiche produit, organisation sur la carte, page entreprise sur l'agrégateur.
- Copiez l'adresse complète de la page depuis la barre d'adresse.
- Extrayez l'identifiant de l'objet depuis l'adresse. Sur Wildberries, c'est le nombre dans l'adresse de la fiche après catalog/, sur Ozon — le nombre après product/ et le tiret à la fin, sur Yandex Maps — le long nombre après org/ et le nom, sur 2GIS — le nombre après firm/. Notez-le séparément.
- Consignez le tout dans un tableau sources.csv avec les colonnes : plateforme, nom de l'objet, adresse, identifiant, commentaire.
- Pour le premier lancement, limitez-vous à 3-5 objets par plateforme. Vous passerez à l'échelle plus tard.
Décidez des champs nécessaires
L'ensemble minimal de champs pour tout avis : identifiant de l'avis sur la plateforme, identifiant de l'objet, plateforme, note, texte, date de publication, date de collecte. L'ensemble étendu : nom de l'auteur (ou son hash), présence de photos, avantages et inconvénients séparés (présents sur les marketplaces et Otzovik), réponse de l'entreprise et sa date, nombre de likes ou de mentions « utile », variante du produit (taille, couleur), statut d'achat confirmé.
Conseil : Ne visez pas tous les champs d'un coup. Collectez l'ensemble minimal plus 2-3 champs réellement nécessaires à votre question. Chaque champ superflu est un endroit supplémentaire où le balisage de la plateforme peut changer et casser le script.
Résultat attendu : le fichier sources.csv avec 5-15 lignes et la liste des champs notée. Chaque ligne a un identifiant renseigné.
Problèmes possibles : impossible de repérer l'identifiant dans l'adresse. Solution : ouvrez deux objets similaires sur une même plateforme et comparez les adresses — les parties qui coïncident forment le modèle, celles qui diffèrent constituent l'identifiant.
Vérification : Vous pouvez lire n'importe quelle ligne de sources.csv et, à partir du seul identifiant, ouvrir manuellement l'objet voulu sur la plateforme. Si vous devez deviner, revenez en arrière et précisez les identifiants.
Étape 2 : Concevoir le tableau d'avis
Objectif de l'étape : fixer un format d'enregistrement unique vers lequel seront ramenés les avis de toutes les plateformes. Cela permettra de les analyser ensemble, et non dans cinq tableaux différents.
Le schéma unifié
Créez dans l'éditeur de code un fichier schema.txt et énumérez les colonnes dans cet ordre :
- review_id — identifiant de l'avis sur la plateforme. Si la plateforme ne le fournit pas explicitement, on le forme nous-mêmes à partir de l'objet, de l'auteur et de la date.
- source — code court de la plateforme : yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon.
- object_id — identifiant de l'objet depuis sources.csv.
- object_name — nom lisible pour le confort.
- rating — nombre de 1 à 5. Si la plateforme utilise une autre échelle, on la ramène à cinq points et on le consigne en commentaire.
- text — texte complet de l'avis sur une seule ligne. Les sauts de ligne sont remplacés par des espaces.
- pros et cons — avantages et inconvénients, si la plateforme les distingue. Sinon vide.
- author — nom de l'auteur ou son hash anonymisé.
- published_at — date de publication au format AAAA-MM-JJ.
- company_reply — texte de la réponse de l'entreprise, s'il y en a une.
- likes — nombre de mentions d'utilité.
- has_photo — 1 ou 0.
- collected_at — date et heure de la collecte.
- url — adresse de la page de l'objet.
Pourquoi il faut précisément un format unifié
Chaque plateforme renvoie ses données à sa manière : ici la date est une chaîne « il y a 3 jours », là un nombre de millisecondes, ailleurs un texte « 14 mars ». Si l'on ne ramène pas tout à une forme commune à l'entrée, on se noie dans les exceptions lors de l'analyse. Il faut ramener au schéma dès l'écriture, et non après coup.
Règles d'anonymisation
Si les noms des auteurs ne sont pas nécessaires à la tâche (et dans 90 % des tâches analytiques ils ne le sont pas), stockez un hash à la place du nom. En Python, cela se fait en une ligne via le module hashlib : on prend le nom de l'auteur, on y ajoute le code de la plateforme, et le résultat devient une courte chaîne. Ainsi, vous pourrez distinguer les avis d'un même auteur, sans stocker le nom lui-même.
Conseil : Ajoutez au schéma une colonne raw_json où sera enregistrée la réponse brute de la plateforme pour cet avis. Elle prend de la place, mais elle permet ensuite d'extraire un champ auquel vous n'avez pas pensé aujourd'hui, sans recollecte.
Résultat attendu : un fichier schema.txt avec les colonnes et un modèle vide de tableau reviews_template.csv avec ces en-têtes.
Vérification : Ouvrez reviews_template.csv dans Excel. Vous devez voir une seule ligne d'en-têtes, contenant exactement les colonnes de schema.txt, sans aucune en trop.
Étape 3 : Utiliser les voies officielles — espaces personnels et API
Objectif de l'étape : exporter les avis sur votre propre entreprise de la façon la plus propre, sans aucun scraping. Si vous analysez uniquement votre propre activité, cette étape peut suffire.
Yandex Business (avis sur Yandex Maps)
- Connectez-vous à Yandex Business avec le compte propriétaire de l'organisation.
- Dans le menu de gauche, choisissez la rubrique « Avis ».
- En haut, sélectionnez l'établissement voulu, si les organisations sont plusieurs.
- Configurez le filtre par période et par note.
- La liste des avis s'affiche avec le texte, la date, la note et vos réponses. Il n'y a pas de bouton d'export direct vers un tableau, donc pour de gros volumes, utilisez la copie par pages ou passez à l'étape 4.
Wildberries : l'API avis pour les vendeurs
Wildberries dispose d'une section API officielle pour travailler avec les avis et les questions. Elle est accessible aux vendeurs et renvoie les avis sur vos produits avec la note, le texte, les avantages et inconvénients, la date, et permet aussi d'y répondre.
- Connectez-vous à l'espace vendeur WB Partenaires.
- Ouvrez les paramètres du profil, rubrique « Accès à l'API ».
- Créez un nouveau token en cochant la catégorie d'accès aux avis et questions. Nommez-le clairement, par exemple reviews_export.
- Copiez le token immédiatement — il ne sera plus affiché. Enregistrez-le dans le fichier config.txt du dossier du projet.
- Appelez les méthodes de liste d'avis avec ce token dans l'en-tête Authorization. La documentation décrit les paramètres de pagination et de filtrage par dates.
Ozon Seller API et Yandex Market
Ozon donne accès aux avis via le Seller API pour les vendeurs disposant d'un abonnement incluant la gestion des avis. La clé se crée dans la rubrique « Paramètres », sous-rubrique « Clés API ». Yandex Market fournit les avis sur les produits du vendeur via l'API partenaire par identifiant d'entreprise, la clé est délivrée dans l'espace vendeur à la rubrique des paramètres d'accès.
Google Business Profile et 2GIS pour les entreprises
Les avis sur votre propre organisation dans Google Maps sont accessibles dans l'espace Google Business Profile et via son API après confirmation des droits. 2GIS propose aux propriétaires un espace avec notifications d'avis et possibilité de réponse.
Attention : Les tokens et clés API sont un accès à votre compte professionnel. Ne les insérez jamais directement dans le code, stockez-les dans un fichier séparé qui ne se retrouve pas dans des dossiers partagés ni des dépôts. Si un token fuite accidentellement — révoquez-le immédiatement dans l'espace et créez-en un nouveau.
Quand les voies officielles ne suffisent pas
Toutes les méthodes citées ne donnent des avis que sur vos propres objets. Pour analyser les concurrents, le marché ou les produits d'autrui, elles ne conviennent pas. Dans ce cas, passons à la collecte depuis les pages publiques — c'est l'objet des étapes suivantes.
Résultat attendu : si vous travaillez sur votre propre entreprise — le premier tableau d'avis issu d'une source officielle, ramené au schéma de l'étape 2.
Vérification : Le nombre d'avis dans l'export correspond au nombre affiché par l'espace pour la même période, avec une marge de 1-2 enregistrements pour les avis en cours de modération au moment de l'export.
Étape 4 : Collecter les avis sur les cartes — Yandex Maps, 2GIS, Google Maps
Objectif de l'étape : apprendre à trouver la requête d'arrière-plan par laquelle la carte charge les avis, et à la reproduire avec un script. Cette compétence est universelle et servira sur toutes les autres plateformes.
Comment trouver la requête contenant les avis via les outils de développement
- Ouvrez dans Chrome la page de l'organisation sur Yandex Maps ou 2GIS.
- Appuyez sur F12. Le panneau de développement s'ouvre à droite ou en bas.
- Passez à l'onglet Network (Réseau). S'il est vide — actualisez la page avec F5.
- Dans la ligne de filtre au-dessus de la liste des requêtes, cliquez sur Fetch/XHR. Seules les requêtes d'arrière-plan resteront.
- Sur la page de l'organisation, allez dans la rubrique des avis et faites défiler la liste vers le bas pour charger le lot suivant.
- Une nouvelle requête apparaîtra dans la liste. Son nom contient généralement le mot review ou feedback. Cliquez dessus.
- Ouvrez l'onglet Preview ou Response. Vous verrez une structure JSON où les avis forment une liste imbriquée : texte, note, date, auteur.
- Ouvrez l'onglet Headers. Copiez l'adresse complète de la requête (Request URL) et prêtez attention aux paramètres : il y a généralement l'identifiant de l'objet, le numéro de page ou l'offset, la taille du lot et le tri.
- Dans la même section, trouvez les en-têtes de requête : User-Agent, Accept, Referer. Ils devront être transmis depuis le script.
Conseil : Cliquez droit sur la requête trouvée et choisissez Copy, puis Copy as cURL. Vous obtiendrez une commande avec tous les en-têtes. Pratique à coller dans un fichier texte comme référence : si le script cesse de fonctionner, vous comparerez sa requête à celle de référence.
Particularités de chaque carte
- Yandex Maps. Les avis se chargent par lots avec indication du tri (par nouveauté, par note, par pertinence). Fixez impérativement un seul tri, sinon les ensembles divergeront d'une exécution à l'autre. La date arrive sous forme lisible par machine, la note — en nombre. Les réponses de l'organisation se trouvent dans un champ imbriqué séparé.
- 2GIS. Le service dispose d'un service public d'avis, auquel le site lui-même s'adresse. La requête contient l'identifiant de l'établissement et les paramètres de limite et d'offset. La réponse contient le texte, la note, la date, le nom d'utilisateur, la réponse officielle et le compteur d'utilité. Le nombre total d'avis arrive aussi — utilisez-le pour vérifier l'exhaustivité.
- Google Maps. La plus complexe des trois plateformes : les avis arrivent dans un format encodé au sein de longues réponses. Pour quelques dizaines d'objets, il est plus simple d'utiliser Places API avec une clé officielle — elle renvoie un ensemble limité des derniers avis par lieu, ce qui suffit souvent pour évaluer la tonalité. Pour une collecte complète sur des objets d'autrui, il faudra une automatisation par navigateur — c'est le sujet du bloc avancé.
Écrivons le premier script
Créez le fichier collect_maps.py et collez le squelette. Remplacez l'adresse de requête et les noms de champs par ce que vous avez vu dans le panneau de développement — ils diffèrent d'une plateforme à l'autre et peuvent évoluer avec le temps.
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
Analysons ce qui se passe ici. La variable PROXY stocke les données de votre proxy mobile. L'en-tête User-Agent présente la requête comme un navigateur mobile — ce qui s'accorde logiquement avec une IP mobile. La fonction collect parcourt les pages jusqu'à ce que la plateforme renvoie une liste vide, et fait une pause de 2,5 secondes après chaque page. La pause n'est pas une formalité : elle rend la charge semblable à une lecture par un humain.
Lancement et écriture du résultat
- À la fin du fichier, ajoutez l'appel de la fonction pour un objet de sources.csv et l'écriture des lignes dans un CSV via le module csv en encodage utf-8-sig, pour qu'Excel ouvre correctement le texte russe.
- Ouvrez le terminal dans le dossier du projet et exécutez
python collect_maps.py. - Observez la sortie. Il est utile d'afficher le numéro de page et le nombre de lignes collectées après chaque requête.
- Ouvrez le fichier obtenu dans Excel et parcourez les 20 premières lignes.
Résultat attendu : un fichier CSV avec les avis d'une organisation, dont le nombre de lignes correspond approximativement au compteur d'avis sur la page de l'organisation.
Problèmes possibles : la réponse arrive avec un code 403 ou vide. Solution : vérifiez les en-têtes par rapport à la commande cURL copiée, en particulier Referer et Accept. Vérifiez que le proxy est connecté et a répondu à une requête de test vers un site quelconque. Augmentez la pause à 4-5 secondes.
Vérification : Prenez trois avis au hasard dans le fichier et retrouvez-les sur la page de l'organisation par le texte. Les trois doivent être retrouvés, avec les mêmes notes et dates.
Étape 5 : Collecter les avis sur les marketplaces — Wildberries, Ozon, Yandex Market
Objectif de l'étape : adapter l'approche de l'étape 4 aux marketplaces, où les avis sont liés aux produits et comportent des champs supplémentaires : avantages, inconvénients, variante du produit, photos.
Wildberries
Sur Wildberries, les avis ne sont pas liés à l'article, mais à l'identifiant unifié de la fiche, sous lequel sont regroupés les couleurs et les tailles. C'est important : si vous collectez les avis par article, vous les obtiendrez pour toutes les variantes d'un coup, et il faudra filtrer par le champ de variante.
- Ouvrez la fiche produit, appuyez sur F12, passez à l'onglet Network avec le filtre Fetch/XHR.
- Faites défiler jusqu'au bloc des avis et cliquez sur « Voir tous les avis ».
- Trouvez la requête dont le nom contient feedbacks. La réponse contiendra une liste avec le texte, la note, la date, les champs avantages et inconvénients, le nom de l'auteur, la couleur et la taille, le signe de présence de photo et la réponse du vendeur.
- Prêtez attention au nombre total d'avis dans la réponse — il aidera à vérifier l'exhaustivité.
- Copiez l'adresse et les en-têtes, insérez-les dans le script selon le modèle de l'étape 4. La pagination peut être absente ici — une partie des réponses arrive en entier, parfois sous forme de fichier très volumineux. Augmentez le timeout à 60 secondes.
Ozon
Ozon protège activement ses données et vérifie le comportement du client. Pour les avis, le site utilise une requête interne pour la composition de la page, dans laquelle les avis constituent l'un des blocs. Ordre pratique des actions :
- Ouvrez la page du produit, puis allez dans la rubrique des avis via le lien de la fiche.
- Dans le panneau de développement, trouvez la requête dont la réponse contient un tableau avec les champs content, score ou rating et author. Elle peut porter différents noms, cherchez par contenu via la barre de recherche du panneau (Ctrl+F dans l'onglet Network).
- Copiez la requête au format cURL. Faites attention aux en-têtes et aux cookies : Ozon est sensible à leur absence.
- Lors de la reproduction depuis le script, utilisez une session requests.Session pour que les cookies soient conservés entre les requêtes, et faites d'abord une requête vers la page produit ordinaire, puis seulement ensuite vers les avis. Cela imite le parcours naturel de l'utilisateur.
- Tenez des pauses de 4-6 secondes et changez d'IP via le proxy mobile toutes les 30-50 requêtes.
Attention : Si la plateforme commence à renvoyer une page de vérification du navigateur ou un captcha — c'est le signal de s'arrêter, pas de forcer. Réduisez la fréquence, changez d'IP via le lien de rotation et attendez 10-15 minutes. Une pression systématique sur les mécanismes de défense entraîne le blocage de tout le pool d'adresses et contredit les règles des plateformes.
Yandex Market
Les avis sur Yandex Market sont de deux types : sur le produit (communs à tous les vendeurs) et sur la boutique. Pour analyser le produit, ce sont les premiers qui sont nécessaires ; pour analyser le service, les seconds. Les deux types comportent une séparation entre avantages, inconvénients et commentaire, ainsi qu'une note et une date. La requête pour les avis se trouve de la même façon via le panneau de développement, dans l'onglet « Avis » de la fiche produit.
Ramener au schéma
Sur les marketplaces, le champ texte se compose souvent de trois parties. Enregistrez-les ainsi : pros — dans la colonne pros, cons — dans la colonne cons, et le commentaire général — dans text. Si l'analyse nécessite un seul texte continu, à l'étape de nettoyage, fusionnez les trois colonnes via un séparateur, mais dans les données brutes, conservez-les séparément.
Conseil : Sur les marketplaces, les avis avec photo et achat confirmé sont nettement plus informatifs. Ajoutez un filtre dans le script : collectez tout d'abord, et à l'analyse, regardez à part le segment où has_photo vaut 1. C'est souvent là que se trouvent les descriptions les plus détaillées des défauts et des scénarios d'usage réels.
Résultat attendu : un CSV par marketplace avec les avis de 3-5 produits, ramenés au schéma unifié.
Problèmes possibles : le nombre d'avis collectés est inférieur au compteur de la page. Cause : la plateforme limite la profondeur de la sortie ou ne renvoie que les avis avec texte, en masquant les notes sans commentaire. Solution : comparez les compteurs « total des notes » et « avec texte » sur la page — l'écart s'explique généralement ainsi.
Vérification : Ouvrez le fichier dans Excel, construisez un tableau croisé par la colonne rating. La distribution des notes doit correspondre approximativement à ce qu'affiche la fiche produit : si la plateforme affiche 70 % de cinq étoiles, votre échantillon doit être proche.
Étape 6 : Collecter les avis sur les agrégateurs — Otzovik, iRecommend, Flamp, Zoon
Objectif de l'étape : apprendre à travailler avec des plateformes où les avis sont de véritables articles avec du balisage HTML, et non du JSON en arrière-plan.
En quoi les agrégateurs diffèrent
Otzovik et iRecommend construisent leurs pages de façon classique : chaque avis est une page distincte avec un titre, un long texte, une note, une date, des avantages et inconvénients, tandis que la page de l'objet contient une liste de liens vers ces avis avec de courts aperçus. Flamp et Zoon sont plus proches des cartes : organisation, liste d'avis, chargement par lots. Respectivement, pour les deux premiers, il faut parser le HTML ; pour les seconds, la méthode de l'étape 4 convient.
Installer la bibliothèque de parsing HTML
Exécutez dans le terminal pip install beautifulsoup4 lxml. La bibliothèque BeautifulSoup permet de trouver les éléments de la page par balises et classes, comme vous les repérez à l'œil dans le panneau de développement.
Collecte pas à pas sur Otzovik
- Ouvrez la page de l'objet (produit, entreprise, cours) sur Otzovik.
- Appuyez sur F12 et passez à l'onglet Elements (Éléments).
- Cliquez sur l'icône en forme de flèche en haut à gauche du panneau et cliquez sur le titre du premier avis dans la liste. L'élément HTML se mettra en surbrillance dans le panneau. Notez sa balise et sa classe — c'est le sélecteur du lien vers l'avis.
- De la même façon, trouvez les éléments de la note (généralement un bloc avec des étoiles et un attribut numérique), de la date et du texte court.
- Faites défiler la page vers le bas et trouvez le bloc de pagination. Cliquez sur le chiffre 2 et observez comment l'adresse change — un numéro de page s'ajoute généralement. C'est le modèle pour le parcours.
- Dans le script : chargez la page de liste via requests avec proxy, parsez via BeautifulSoup, extrayez les liens vers les avis et les aperçus, puis passez à la page de liste suivante. Pause entre les pages — 5-8 secondes, les agrégateurs sont plus sensibles que les cartes.
- Si vous avez besoin du texte complet de l'avis, et non de l'aperçu, faites un second passage : pour chaque lien, chargez la page de l'avis et extrayez le texte principal, les blocs avantages et inconvénients, la note par sous-critères.
iRecommend
La logique est analogue à Otzovik : une page d'objet avec une liste d'avis et des pages d'avis distinctes. La différence réside dans le balisage et dans le fait que la note s'exprime par le nombre d'étoiles colorées — comptez les éléments étoiles avec une classe active, plutôt que de chercher un nombre.
Flamp et Zoon
Pour ces plateformes, utilisez la méthode de l'étape 4 : ouvrez l'organisation, basculez sur Fetch/XHR, faites défiler les avis et trouvez la requête d'arrière-plan. Flamp renvoie les avis avec note, texte, date, réponse officielle et utilité. Zoon — avec note, texte, date et réponse de l'organisation. Les deux plateformes affichent le nombre total d'avis pour contrôler l'exhaustivité.
Mini-exemple de parsing HTML
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
Les noms de classes ici sont indicatifs — remplacez-les par les réels que vous avez vus dans le panneau Elements. Les contrôles de vacuité de l'élément sont obligatoires : si le balisage d'un avis diffère, le script ne doit pas planter entièrement.
Conseil : Sur les agrégateurs, les dates sont souvent écrites en mots : « hier », « il y a 3 jours », « 14 mars ». Prévoyez une fonction distincte de normalisation des dates qui traduit ces chaînes au format AAAA-MM-JJ par rapport à la date de collecte. Sans elle, le tri par date ne fonctionnera pas.
Résultat attendu : un CSV avec les avis d'un ou deux agrégateurs, où chaque avis a une note, une date et un texte, et pour Otzovik et iRecommend — également un lien vers la page complète.
Problèmes possibles : les sélecteurs cessent de trouver les éléments après quelques pages. Cause : la plateforme a renvoyé une page de vérification au lieu de la liste. Solution : vérifiez le titre de la page après chaque chargement, en cas de signes de vérification — pause, changement d'IP, nouvelle tentative après quelques minutes.
Vérification : Le nombre d'avis collectés depuis une page de liste est égal au nombre d'avis que vous voyez sur cette page dans le navigateur. Si vous en avez collecté moins — l'un des sélecteurs est trop restrictif.
Étape 7 : Connecter les proxys mobiles et configurer la rotation
Objectif de l'étape : faire en sorte que le scraper d'avis fonctionne de manière stable sur des dizaines et des centaines d'objets, en répartissant la charge et sans créer de flux anormal depuis une seule adresse.
Pourquoi précisément des proxys mobiles
Toutes les plateformes de ce guide sont orientées vers une audience mobile : la majorité des avis s'écrivent et se lisent depuis un smartphone. Les adresses IP mobiles des opérateurs de téléphonie sont des adresses derrière lesquelles se trouvent simultanément des centaines et des milliers d'abonnés réels. Les plateformes ne peuvent pas bloquer ces adresses sans pénaliser les utilisateurs réels, elles sont donc indulgentes. Pour la collecte d'avis, cela signifie moins de vérifications, moins de faux positifs de défense et une vitesse prévisible.
Configuration de la connexion
- Connectez-vous à votre espace client mobileproxy.space et ouvrez la liste de vos proxys.
- Copiez l'hôte, le port, le login et le mot de passe. Faites attention au protocole : pour requests, un proxy HTTP est plus pratique, mais SOCKS5 est aussi pris en charge après installation du complément
pip install requests[socks]. - Insérez les données dans la variable PROXY du script. Format : protocole, deux-points, deux barres obliques, login, deux-points, mot de passe, arobase, hôte, deux-points, port.
- Copiez depuis l'espace le lien de changement d'IP et enregistrez-le dans la variable ROTATE_URL.
- Exécutez une requête de test via le proxy vers n'importe quel service affichant votre IP. La réponse doit contenir une adresse d'opérateur mobile, et non votre fournisseur domestique.
Stratégie de rotation
Il existe deux approches, toutes deux fonctionnelles.
- Rotation par temps. Un intervalle de changement automatique d'IP est défini dans l'espace, par exemple toutes les 5 minutes. Le script ne fait rien — l'adresse change seule. Convient aux longues collectes tranquilles.
- Rotation par événement. Le script déclenche lui-même ROTATE_URL au moment voulu : après chaque N requêtes, au passage à un nouvel objet ou à la réception d'un code 429/403. Convient quand il faut garder le contrôle.
Règle pratique pour les avis : changez d'IP au passage à chaque nouvel objet et en plus après 40-60 requêtes au sein d'un même objet. Après le changement d'IP, faites une pause de 5-10 secondes — l'opérateur a besoin de temps pour que la nouvelle adresse devienne active.
Gestion des erreurs et réessais
Ajoutez dans la fonction fetch_page une enveloppe : en cas de codes 429, 403, 5xx ou de timeout — déclencher la rotation, attendre, réessayer la requête jusqu'à trois fois avec une pause croissante (10, 30, 90 secondes). Si trois tentatives n'ont pas aidé — inscrire l'objet dans le fichier failed.txt et passer au suivant. Ainsi, un objet problématique n'arrêtera pas toute la collecte, et vous reprendrez les trous séparément.
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
Combien de threads utiliser
Pour les débutants — un seul thread. Un proxy, une connexion, un parcours séquentiel. C'est lent, mais fiable : 500-1000 avis par heure sans aucun problème. Quand vous serez convaincu de la stabilité, vous pourrez ajouter un second proxy et lancer un second exemplaire du script sur l'autre moitié de la liste d'objets. Plus de 3-4 threads par plateforme pour les avis n'est presque jamais nécessaire.
Conseil : Accordez le User-Agent avec le type d'IP. Si vous passez par un proxy mobile, présentez-vous comme un navigateur mobile, comme dans l'exemple de l'étape 4. L'incohérence « IP mobile, mais Chrome desktop sous Windows » n'est pas critique en soi, mais la cohérence réduit le nombre de vérifications supplémentaires.
Résultat attendu : un script qui parcourt tout sources.csv pour une plateforme sans intervention manuelle, change d'IP lors du passage entre objets et inscrit les objets problématiques dans failed.txt.
Problèmes possibles : après un changement d'IP, les premières requêtes échouent en timeout. Solution : augmentez la pause après rotation à 15 secondes. Le proxy ne se connecte pas du tout — vérifiez si une liste blanche d'IP n'est pas activée dans l'espace, et ajoutez-y l'adresse de votre ordinateur.
Vérification : Lancez la collecte sur 10 objets d'affilée. Dans le log, il doit y avoir des mentions de changement d'IP entre objets, le fichier failed.txt vide ou ne contenant pas plus d'un objet, et le nombre total de lignes du résultat comparable à la somme des compteurs d'avis de la plateforme.
Étape 8 : Enregistrer, nettoyer et dédupliquer
Objectif de l'étape : transformer l'ensemble des CSV bruts de différentes plateformes en un tableau unique et propre, exploitable pour l'analyse.
Fusion des fichiers
- Assurez-vous que tous les fichiers bruts sont dans le dossier raw et ont les mêmes en-têtes selon schema.txt.
- Créez le fichier merge.py. Via pandas, lisez tous les CSV du dossier raw dans un seul DataFrame : la fonction pandas.concat fusionne une liste de tableaux.
- Vérifiez les types : rating doit être un nombre, published_at — une date. Convertissez via pandas.to_numeric et pandas.to_datetime avec le paramètre errors='coerce', pour que les valeurs incorrectes deviennent vides au lieu de casser le traitement.
Déduplication
Les doublons surviennent pour trois raisons : chevauchement des pages lors de la pagination, relances et un même avis publié par l'auteur sur plusieurs plateformes. Traitez dans l'ordre :
- Supprimez les doublons exacts sur la paire source et review_id — ce sont les répétitions dues à la pagination et aux redémarrages. Méthode drop_duplicates avec le paramètre subset.
- Trouvez les doublons flous au sein d'une même plateforme : même object_id, même date et 100 premiers caractères du texte identiques. Cela arrive quand la plateforme change l'identifiant lors de la modification d'un avis.
- Ne supprimez pas les doublons inter-plateformes, mais marquez-les dans une colonne dédiée. Le fait qu'une personne ait écrit la même chose sur Otzovik et dans Yandex Maps est en soi informatif.
Nettoyage du texte
- Retirez les doubles espaces et les sauts de ligne à l'intérieur du texte.
- Supprimez les phrases de service des plateformes qui se retrouvent dans le texte : « Lire en entier », « Afficher plus ».
- Remplacez les chaînes vides dans pros et cons par une valeur vide explicite, et non par la chaîne « non » ou « - ».
- Vérifiez l'encodage : si vous voyez des caractères illisibles, le fichier a été enregistré en utf-8. Réenregistrez depuis la source brute.
Export du résultat
Enregistrez le tableau final dans le dossier clean sous le nom reviews_all_AAAA-MM-JJ.xlsx via la méthode to_excel et parallèlement en CSV. Excel est pratique pour consulter, CSV — pour charger dans d'autres systèmes. Enregistrez en plus un fichier séparé avec la synthèse : nombre d'avis par plateforme, note moyenne par objet, part d'avis avec réponse de l'entreprise.
Conseil : Ajoutez au tableau propre une colonne text_len avec la longueur du texte. Les avis de moins de 30 caractères sont presque toujours inutiles à l'analyse des causes, en revanche les avis longs avec une note de 2-3 sont de l'or : les gens y expliquent en détail ce qui ne va pas.
Résultat attendu : un seul fichier propre avec les avis de toutes les plateformes, sans doublons exacts, avec des types de données corrects et une synthèse.
Problèmes possibles : après déduplication, trop de lignes ont disparu. Cause : review_id sur une plateforme s'est révélé vide pour tous les enregistrements, et tous ont été considérés comme doublons. Solution : vérifiez le remplissage de review_id par plateforme et, pour la plateforme problématique, formez un identifiant à partir de object_id, de la date et du hash du texte.
Vérification : Le nombre de lignes dans le fichier propre n'est pas inférieur de plus de 5-10 % à la somme des lignes des fichiers bruts. Dans la colonne rating, aucune valeur hors de la plage 1-5, dans la colonne published_at, aucune date future.
Vérification du résultat : checklist et test
Avant de tirer des conclusions des avis collectés, assurez-vous que la collecte s'est déroulée correctement. Parcourez la checklist en entier.
Checklist de préparation
- Pour chaque objet de sources.csv, le tableau propre contient au moins un avis, ou l'objet est inscrit dans failed.txt avec la cause.
- Le nombre d'avis par objet diffère du compteur de la plateforme de 10 % au maximum.
- La distribution des notes par objet correspond approximativement à la distribution affichée par la plateforme.
- L'avis le plus récent du tableau est daté au plus tard de la veille par rapport à la date de collecte, si l'objet est actif.
- Toutes les dates au format AAAA-MM-JJ, toutes les notes — des nombres.
- Aucun doublon exact sur source et review_id.
- Les noms des auteurs sont soit absents, soit remplacés par des hash, si la tâche n'exige pas de noms.
- Les fichiers de données brutes sont enregistrés avec leur date et non écrasés.
- Les tokens et données de proxy ne sont pas dans le script, mais dans un fichier de configuration séparé.
Comment tester par échantillon
- Choisissez 10 avis au hasard dans le tableau avec la fonction sample de pandas.
- Pour chacun, ouvrez la page de l'objet sur la plateforme et retrouvez l'avis par un fragment de texte.
- Vérifiez la note, la date et la présence de réponse de l'entreprise.
- Si 10 sur 10 concordent — parfait. Si 8-9 — vérifiez si les écarts ne sont pas liés à la modification de l'avis après la collecte. Si moins de 8 — il y a une erreur systématique dans le parsing, revenez à l'étape correspondante.
Indicateurs de réussite
Le succès se présente ainsi : vous pouvez ouvrir un seul tableau, le filtrer par n'importe quelle plateforme et n'importe quel objet, trier par date et par note et répondre en cinq minutes à la question de départ de l'étape 1. Par exemple, voir que 40 % des avis notés 1-2 sur un café dans Yandex Maps ces trois derniers mois mentionnent le temps d'attente, tandis que sur 2GIS les mêmes personnes louent le café mais critiquent le personnel. Si la question trouve sa réponse — la collecte a rempli sa mission.
Erreurs typiques et solutions
Voici rassemblés les problèmes auxquels presque tout le monde est confronté lorsqu'il configure un scraper d'avis pour la première fois. Format : problème, cause, solution.
1. Le script n'a collecté que les 20 premiers avis
Cause : la pagination n'est pas implémentée ou le paramètre d'offset est mal déterminé.
Solution : revenez dans le panneau de développement, faites défiler la liste d'avis deux fois et comparez les adresses de deux requêtes consécutives. Le paramètre qui a changé est l'offset ou le numéro de page. Assurez-vous que le script l'incrémente du bon pas.
2. Tous les avis arrivent avec la même date — la date de collecte
Cause : le champ published_at contient collected_at, ou la plateforme renvoie la date dans un champ au nom différent.
Solution : ouvrez le raw_json d'un avis et trouvez le champ contenant la date de publication. Il peut s'appeler date, created, published, time, updatedAt. Corrigez le nom du champ dans le script.
3. Le texte russe s'affiche mal dans Excel
Cause : le CSV est enregistré en utf-8 sans marque d'ordre des octets, et Excel l'ouvre dans un autre encodage.
Solution : enregistrez en utf-8-sig ou exportez directement en xlsx via to_excel.
4. La plateforme répond par un code 403 à chaque requête
Cause : les en-têtes obligatoires ne sont pas transmis, les cookies de session ne sont pas définis, ou la requête part trop fréquemment.
Solution : comparez avec la commande cURL de référence. Utilisez requests.Session et chargez d'abord une page d'objet ordinaire. Augmentez les pauses à 5 secondes. Changez d'IP via le proxy et attendez 10 minutes avant de réessayer.
5. Les notes collectées ne correspondent pas aux réelles
Cause : la plateforme stocke la note dans une autre échelle (par exemple de 0 à 100 ou de 1 à 10) ou un champ séparé contient la note par sous-critère et non la note globale.
Solution : vérifiez trois avis manuellement. Déterminez l'échelle et ramenez à cinq points par division avec arrondi. Documentez-le dans schema.txt.
6. Le nombre d'avis est différent à chaque exécution
Cause : le tri n'est pas fixé, et la plateforme renvoie des ensembles différents en mode « par pertinence ».
Solution : trouvez le paramètre de tri dans l'adresse de requête et fixez fermement le tri par date. Collectez jusqu'à rencontrer un avis plus ancien que la période voulue.
7. Le script plante sur un objet et ne continue pas
Cause : il n'y a pas de gestion des exceptions, toute erreur arrête le programme.
Solution : enveloppez le traitement de chaque objet dans try-except, inscrivez l'erreur et l'identifiant de l'objet dans failed.txt et passez au suivant. Vous reprendrez les trous lors d'une exécution séparée.
8. Après une semaine de fonctionnement, le script cesse soudain de trouver quoi que ce soit
Cause : la plateforme a modifié l'adresse de requête, la structure JSON ou les noms de classes dans le HTML.
Solution : c'est une partie normale de la vie de tout scraper. Répétez la procédure de recherche de la requête de l'étape 4 et mettez à jour l'adresse et les noms de champs. Gardez la liste des sélecteurs et des champs dans un fichier de configuration séparé, pour ne modifier qu'un seul endroit au lieu de tout le code.
9. Le proxy fonctionne, mais la vitesse est très faible
Cause : des réponses trop volumineuses (les marketplaces renvoient parfois des milliers d'avis dans un seul fichier) ou une charge sur la station de base de l'opérateur en heure de pointe.
Solution : augmentez le timeout, activez la compression via l'en-tête Accept-Encoding, planifiez les collectes volumineuses la nuit.
Fonctionnalités supplémentaires pour les avancés
Si le scénario de base est maîtrisé, voici où progresser. Ce bloc suppose que vous écrivez confortablement en Python.
Collecte incrémentale
Au lieu d'une recollecte complète, stockez pour chaque objet la date du dernier avis collecté. Lors de l'exécution suivante, collectez avec un tri par date et arrêtez-vous dès que vous rencontrez un avis pas plus récent que la date enregistrée. Ainsi, la mise à jour quotidienne sur 500 objets prend des minutes au lieu d'heures, et la charge sur les plateformes chute de dizaines de fois. Tenez compte du fait que les avis peuvent apparaître avec une date antérieure après modération — prévoyez un chevauchement de 2-3 jours.
Automatisation par navigateur pour les plateformes complexes
Google Maps et une partie des sections d'Ozon sont plus simples à collecter via un navigateur piloté : Playwright avec un proxy mobile connecté ouvre la page, fait défiler la liste d'avis et intercepte les réponses d'arrière-plan via un gestionnaire d'événements response. Vous obtenez le même JSON que dans le panneau de développement, mais sans avoir à reproduire manuellement les en-têtes et les cookies. Playwright prend en charge l'émulation d'appareils mobiles, ce qui s'accorde parfaitement avec une IP mobile. Le prix — la vitesse et la consommation de mémoire : un navigateur consomme 300-500 Mo, donc ne lancez pas plus de 2-3 instances.
Stockage en base de données
Quand il y a plus de 100 000 avis, le CSV devient peu pratique. Passez à SQLite (intégré à Python, fichier sur disque, zéro configuration) ou PostgreSQL. La table reviews avec un index unique sur la paire source et review_id protège automatiquement des doublons : l'insertion via INSERT avec la gestion de conflit ON CONFLICT DO NOTHING écarte les répétitions au niveau de la base.
Enrichissement et analyse
- Tonalité et thèmes. Passez les textes dans un modèle de langage avec un prompt du type « dégage 3 thèmes principaux et la tonalité générale ». Placez le résultat dans des colonnes séparées. Pour des dizaines de milliers d'avis, utilisez un traitement par lots et un cache pour ne pas payer deux fois pour un même texte.
- Dynamique des notes. Construisez la note moyenne par semaine pour chaque objet. Une chute brutale est le signal d'un problème que les avis expliqueront en mots.
- Rapidité de réaction de l'entreprise. L'écart entre published_at et la date de réponse de l'entreprise est un indicateur direct de la qualité du support, la vôtre et celle des concurrents.
- Dictionnaire des douleurs pour la publicité. L'analyse fréquentielle des noms et adjectifs dans les avis notés 1-2 donne une liste prête de formulations pour les créas et les pages d'atterrissage.
Surveillance de la santé du scraper
Configurez une exécution quotidienne via le planificateur de tâches Windows ou cron et ajoutez une vérification simple : si en 24 heures moins de 30 % de la moyenne hebdomadaire a été collecté ou si la part d'erreurs a dépassé 10 % — envoyez une notification dans Telegram via un bot. Ainsi, vous apprendrez le changement de balisage sur la plateforme le jour même, et non un mois plus tard, quand les données seront nécessaires.
Gestion du pool de proxys
En travaillant simultanément sur plusieurs plateformes, affectez à chacune un proxy mobile distinct. Ainsi, le comportement sur une plateforme n'influe pas sur la réputation de l'adresse sur une autre. Faites la rotation pour les cartes plus rarement (les objets sont généralement petits, 50-200 avis), pour les marketplaces — plus souvent (des milliers d'avis par fiche). Tenez un journal : heure, plateforme, IP, code de réponse. Au bout d'une semaine, ce journal montrera quels intervalles de rotation sont optimaux pour votre profil de charge.
FAQ : questions fréquentes sur la collecte d'avis
Est-il légal de collecter des avis depuis des pages publiques ?
La collecte d'informations publiquement accessibles pour sa propre analyse n'est pas interdite en soi, mais il y a des limites : les conditions d'utilisation des plateformes, les exigences de la loi 152-FZ sur le traitement des données personnelles, l'interdiction de créer des obstacles au fonctionnement du service. Respectez les pauses, anonymisez les auteurs, ne publiez pas les bases collectées et utilisez les API officielles partout où elles existent. En cas d'usage commercial des données, consultez un juriste.
Peut-on se passer de programmation ?
En partie. Pour vos propres objets, les espaces personnels suffisent. Pour de petites tâches ponctuelles, des extensions de navigateur de scraping conviendront, qui exportent dans un tableau les éléments visibles sur la page : vous faites défiler les avis manuellement, l'extension collecte. Pour une collecte régulière sur des dizaines d'objets, un script reste plus pratique et plus fiable, et les extraits prêts de ce guide peuvent être utilisés presque sans modification.
Pourquoi des proxys mobiles si je n'ai que 10 objets ?
Pour 10 objets et une collecte ponctuelle, vous pouvez essayer sans. Mais dès que vous mettrez à jour les données régulièrement ou élargirez la liste, les requêtes depuis une seule IP domestique commenceront à recevoir des vérifications supplémentaires. Le proxy mobile règle cela à l'avance, et le coût est sans commune mesure avec le temps passé à gérer les blocages.
Combien d'avis par heure peut-on réellement collecter ?
En un seul thread avec des pauses de 2-5 secondes — de 500 à 1500 avis par heure selon la taille du lot sur la plateforme. Les marketplaces qui renvoient des centaines d'avis en une seule réponse en donnent plus, les agrégateurs avec du HTML paginé — moins. Pour la plupart des tâches analytiques, c'est largement suffisant.
Comment collecter uniquement les nouveaux avis, sans tout reprendre ?
Enregistrez la date du dernier avis collecté par objet, triez par date lors de la requête et arrêtez-vous au premier avis déjà connu. Plus de détails dans le bloc sur la collecte incrémentale.
Les avis sans texte, seulement avec une note — faut-il les collecter ou non ?
Cela dépend de la tâche. Pour calculer la note moyenne et la dynamique — oui, ils influencent les chiffres. Pour l'analyse des causes — non, ils peuvent être filtrés au traitement. Collectez tout, filtrez au stade de l'analyse : recollecter coûte plus cher.
Que faire si la plateforme affiche un captcha ?
Arrêter la collecte pendant 10-15 minutes, changer d'IP via le proxy, réduire la fréquence des requêtes et vérifier les en-têtes. Le captcha est un signal que votre comportement paraît atypique. La tâche est de le rendre typique, et non de forcer à travers la vérification.
Comment stocker les noms des auteurs sans enfreindre la loi ?
Le mieux est de ne pas les stocker du tout. Si vous devez distinguer les avis d'un même auteur, utilisez un hash à sens unique du nom. Si les noms sont nécessaires (par exemple, pour répondre à un client via l'espace personnel), stockez-les uniquement dans le cadre du travail sur votre propre organisation et ne les transmettez pas à des tiers.
À quelle fréquence les scrapers d'avis se cassent-ils ?
Les grandes plateformes modifient leurs requêtes internes et leur balisage plusieurs fois par an. Avec une bonne surveillance, la réparation prend 20-40 minutes : répéter la recherche de la requête et mettre à jour les champs. Gardez les sélecteurs et les adresses dans un fichier de configuration, et les corrections seront ponctuelles.
Peut-on collecter sur toutes les plateformes avec un seul script ?
Oui, si l'on fait un squelette commun (proxy, réessais, écriture au schéma) et, pour chaque plateforme, une fonction-adaptateur distincte qui connaît l'adresse de requête et les noms de champs. C'est précisément ainsi que sont structurés les projets matures : un module commun et une dizaine de petits adaptateurs.
Conclusion
Résumons. Vous avez parcouru le chemin de la formulation de la question jusqu'au tableau propre d'avis issus de trois types de plateformes différents. Vous avez appris à trouver les requêtes d'arrière-plan via le panneau de développement, à les reproduire par script, à parser le HTML là où le JSON est inaccessible, à connecter des proxys mobiles avec rotation, à gérer les erreurs et à réessayer les requêtes, à fusionner et nettoyer les données. Vous avez aussi abordé les voies officielles d'export et le cadre juridique, ce qui protège à la fois les données et vous-même.
L'essentiel à retenir : les avis sont un type de données particulier, avec leur propre dynamique. Ils apparaissent en permanence, se modifient, passent la modération et portent des informations personnelles. C'est pourquoi un scraper d'avis n'est pas un script ponctuel, mais un petit système : collecte, stockage des données brutes, mise au schéma, déduplication, surveillance. Chaque élément de ce système, vous l'avez déjà construit sous forme basique.
Que faire ensuite :
- Élargissez sources.csv à une vraie liste d'objets et réalisez une collecte complète.
- Configurez une exécution incrémentale quotidienne via le planificateur.
- Ajoutez au moins une surcouche analytique : la dynamique de la note ou la thématisation des avis négatifs.
- Tenez un journal des modifications des plateformes et mettez à jour les adaptateurs à mesure des pannes.
Où progresser. Le niveau suivant, c'est l'automatisation de la réaction : notifications à l'équipe d'un avis négatif dans l'heure suivant sa publication, rapports comparatifs sur les concurrents une fois par semaine, intégration des thèmes issus des avis dans le plan produit et les hypothèses publicitaires. Les données, vous les avez déjà. Il reste à les transformer en décisions, et c'est là que commence la partie la plus intéressante du travail.
