Comment constituer un corpus pour un système RAG via des proxys mobiles sans récupérer des déchets : guide pas à pas
Sommaire de l'article
- Introduction : ce que vous allez obtenir et à qui cela s'adresse
- Préparation préalable : outils, accès, environnement
- Notions de base en langage simple
- Étape 1 : définir les limites du corpus et dresser la carte des sources
- Étape 2 : connecter le proxy mobile et vérifier que les requêtes passent bien par lui
- Étape 3 : écrire un collecteur soigné avec limites, rotation et journal
- Étape 4 : extraire le texte propre du html et des documents
- Étape 5 : filtrer les déchets : déduplication, modèles, qualité, langue
- Étape 6 : annoter les métadonnées et assembler le corpus final
- Vérification du résultat : checklist et test du corpus
- Erreurs typiques et solutions lors de la collecte d'un corpus pour rag
- Fonctionnalités supplémentaires pour les avancés
- Faq : questions fréquentes sur la collecte de corpus
- Conclusion : ce qui a été fait et où aller ensuite
Introduction : ce que vous allez obtenir et à qui cela s'adresse
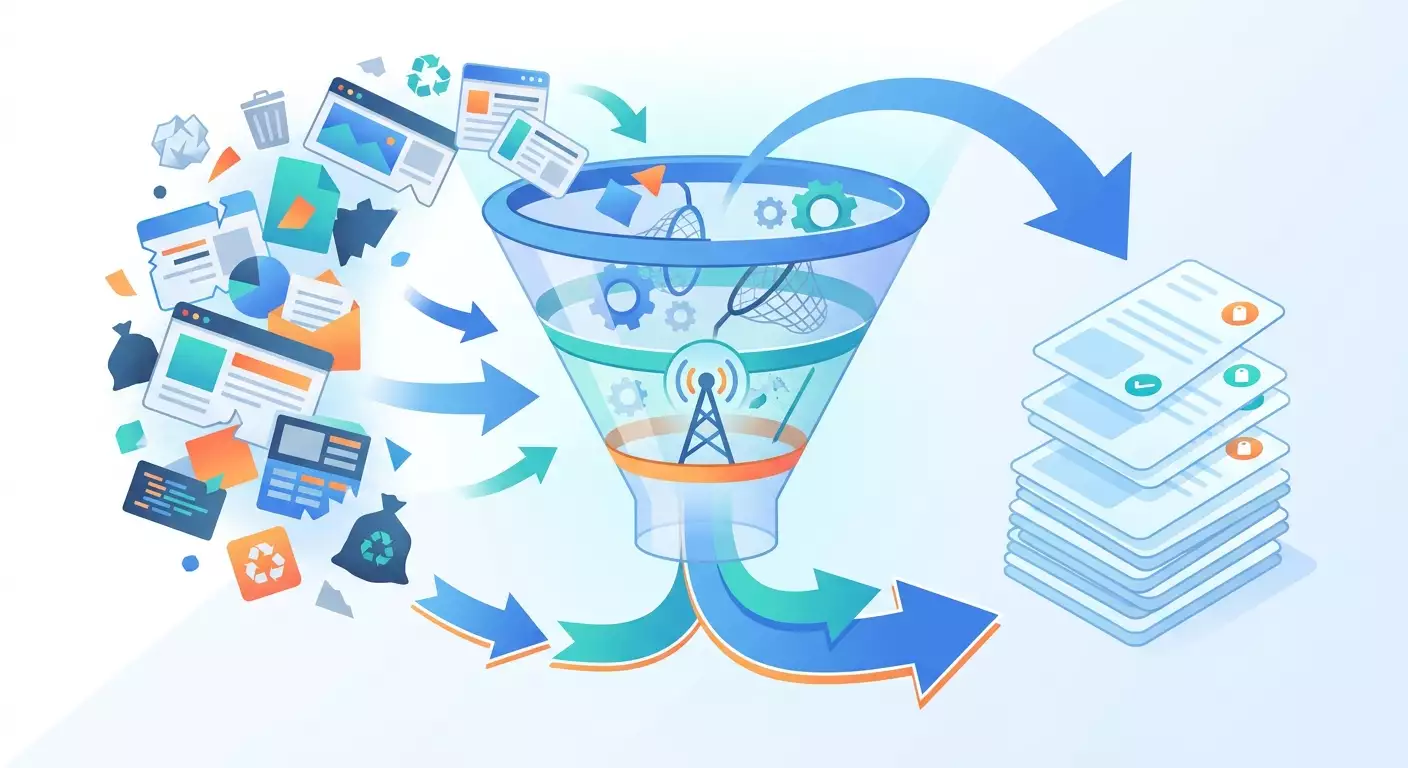
Un système RAG vaut exactement ce que vaut le corpus sur lequel il répond. Vous pouvez prendre le modèle de langage le plus puissant, connecter une base vectorielle coûteuse et obtenir en sortie des absurdités confiantes, si le corpus contient des menus de site, des pieds de page avec copyright, des doublons d'un même article en cinq versions et des pages « produit temporairement indisponible ». Le modèle ne distingue pas les déchets des connaissances. Il cherche simplement des fragments similaires et en assemble une réponse.
Ce guide pas à pas est consacré à une seule étape : la collecte du corpus. Nous ne verrons pas l'architecture de la base vectorielle, le choix des embeddings ni le découpage en chunks, il y a des articles dédiés sur le blog. Ici, nous nous arrêtons précisément à la frontière : vous avez sur votre disque un ensemble de documents propre, annoté et dédupliqué au format JSONL, prêt à être remis à n'importe quel pipeline d'indexation.
Ce que vous obtiendrez au final :
- une liste de sources aux limites claires : ce qu'on collecte, ce qu'on ne collecte pas ;
- un collecteur fonctionnel en Python qui passe par un proxy mobile, respecte les limites et ne fait pas tomber les sites des autres ;
- un dossier de pages et documents bruts, chacun avec ses métadonnées ;
- un script d'extraction du texte principal sans navigation, publicités ni blocs standardisés ;
- des filtres de qualité et une déduplication qui éliminent les déchets avant qu'ils n'atteignent l'index ;
- le fichier de corpus final et un rapport chiffré qui prouve que tout a été fait correctement.
À qui s'adresse ce guide. Aux marketeurs et chefs d'entreprise qui veulent constituer une base de connaissances dans leur niche et bâtir un assistant dessus. Aux spécialistes de l'arbitrage qui ont besoin d'un corpus sur les offres, les landing pages et les règles des plateformes publicitaires. Aux développeurs qui ont déjà connecté des proxys à leurs scripts et qui veulent désormais le faire proprement et de manière systématique. Le corps du texte est écrit pour les débutants, et il y a un bloc séparé pour les plus avancés à la fin.
Ce qu'il faut savoir au préalable. Savoir lancer des commandes dans le terminal et ouvrir des fichiers dans un éditeur de texte. Une notion de base de Python du niveau « je comprends ce que fait une boucle for ». Avoir accès à un proxy mobile : adresse, port, identifiant, mot de passe et lien de changement d'IP.
Combien de temps cela prendra. Préparer l'environnement : environ 30 minutes. Parcourir toutes les étapes : de 3 à 5 heures, selon la taille du corpus. La collecte de plusieurs milliers de pages peut tourner en arrière-plan pendant plusieurs heures, mais votre participation n'est pas nécessaire pendant ce temps.
Préparation préalable : outils, accès, environnement
Avant d'écrire la première ligne de code, mettons de l'ordre dans l'espace de travail. Cela économisera des heures de débogage plus tard.
Configuration requise
- Un ordinateur ou un serveur sous Windows 10/11, macOS ou Linux. Pour collecter des dizaines de milliers de pages, un VPS loué est plus pratique, mais pour un premier corpus un ordinateur portable suffit.
- Au moins 8 Go de mémoire vive. La déduplication de gros corpus aime la mémoire.
- Espace disque libre : au minimum 5 Go. Le HTML brut occupe 5 à 10 fois plus de place que le texte propre, et nous allons stocker les deux.
- Une connexion internet stable. Le proxy ajoute de la latence, donc une connexion domestique lente allongera sensiblement la collecte.
Quoi installer
- Python 3.11 ou plus récent. Téléchargez l'installateur depuis le site officiel, sous Windows cochez « Add Python to PATH » lors de l'installation. Vérifiez dans le terminal :
python --version. Une ligne du typePython 3.12.xdoit apparaître. - Un environnement virtuel. Créez un dossier de projet, par exemple
rag-corpus, entrez dedans et exécutezpython -m venv venv. Activez-le : sous Windowsvenv\Scripts\activate, sous macOS et Linuxsource venv/bin/activate. Au début de la ligne du terminal apparaîtra(venv). - Les bibliothèques. Installez-les en une commande :
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm. L'installation prendra 1 à 3 minutes. - Un éditeur de texte avec coloration syntaxique : VS Code, PyCharm Community ou n'importe quel autre.
Accès au proxy
Ouvrez le tableau de bord de votre service de proxy. Dans la fiche du proxy mobile acheté, trouvez quatre valeurs : l'hôte (adresse IP ou nom de domaine), le port pour HTTP et le port pour SOCKS5, l'identifiant et le mot de passe. Copiez séparément le lien de changement d'IP : c'est une URL sur laquelle il suffit de faire une requête GET pour que le proxy obtienne une nouvelle adresse chez l'opérateur. Notez tout cela dans un fichier .env dans le dossier du projet, et non directement dans le code.
Structure des dossiers
Créez dans le projet les dossiers suivants : raw pour les pages brutes, clean pour le texte extrait, corpus pour le fichier final, logs pour les journaux. Des dossiers vides au départ, c'est normal.
Sauvegardes
Un corpus se collecte longuement, et le perdre est frustrant. Convenez avec vous-même d'une règle : le dossier raw n'est jamais écrasé, seulement complété. Après chaque grande étape, archivez le résultat : tar -czf raw_backup_2026-03-01.tar.gz raw/ sous Linux et macOS, ou via l'archiveur intégré de Windows. Si vous vous trompez dans les filtres et supprimez trop de choses, vous pourrez toujours revenir aux données brutes sans les recollecter.
Conseil : Créez tout de suite un fichier sources.md et notez-y chaque décision : quels sites vous prenez, quelles sections vous excluez, pourquoi. Un mois plus tard, quand l'assistant commencera à répondre bizarrement, ce fichier vous sauvera la soirée.
Notions de base en langage simple
Si vous collectez des données pour un système RAG pour la première fois, plusieurs termes reviendront à chaque étape. Voyons-les brièvement.
Qu'est-ce que le RAG et pourquoi le corpus compte plus que le modèle
RAG (Retrieval-Augmented Generation) est une approche dans laquelle le modèle de langage reçoit, avant de répondre, une sélection de fragments issus de votre base de connaissances. Le modèle ne « connaît » pas vos documents, il lit les morceaux trouvés et répond à partir d'eux. D'où une règle simple : si la base contient des déchets, la recherche finira tôt ou tard par les ressortir, et la réponse s'appuiera sur la ligne « Abonnez-vous à la newsletter » au lieu de l'instruction. C'est pourquoi l'étape de collecte du corpus ne peut pas être sautée.
Corpus, document, métadonnées
Corpus désigne l'ensemble des textes qui iront dans le système RAG. Document désigne une unité de sens : un article, une page d'aide, un PDF d'instructions, une fiche produit. Métadonnées désigne le passeport du document : d'où il vient, quand il a été collecté, en quelle langue, qui en est l'auteur, à quelle section il appartient. Sans métadonnées, vous ne pourrez ni mettre à jour le corpus, ni expliquer à l'utilisateur d'où vient la réponse, ni filtrer ce qui est obsolète.
Proxy mobile et pourquoi il est utile lors de la collecte
Un proxy mobile est un serveur intermédiaire qui fait sortir vos requêtes vers internet via une adresse IP d'opérateur mobile. Pour la collecte de corpus, il résout trois problèmes pratiques. Premier : la répartition de charge. Au lieu de frapper un site depuis une seule adresse, vous passez par différentes, et chaque source voit un trafic calme et rare. Deuxième : la géographie. Beaucoup de sites affichent un contenu, des prix et des disponibilités différents selon la région, et un proxy mobile de la ville voulue donne précisément la version de la page que voient vos clients. Troisième : la stabilité des sessions longues. La rotation d'IP par lien permet de poursuivre la collecte pendant des heures sans dépendre d'une seule adresse.
La rotation est le changement d'adresse IP. Elle peut être programmée (toutes les N minutes) ou à la demande (vous appelez le lien quand vous en avez besoin). Pour la collecte de corpus, la seconde est plus pratique : on change de source, on change d'adresse.
Qu'est-ce qu'un déchet
Dans le contexte d'un corpus, un déchet est tout ce qui n'apporte pas de connaissances sur votre thème, mais occupe de la place dans l'index et dégrade la recherche :
- navigation, menus, pieds de page, fils d'Ariane, formulaires d'abonnement ;
- doublons exacts et quasi exacts d'un même texte à différentes adresses ;
- pages bouche-trou : « Page introuvable », « Produit épuisé », « Maintenance en cours » ;
- textes dans une autre langue, si le corpus est monolingue ;
- pages tronquées, où le proxy ou le site n'a renvoyé que la moitié du HTML ;
- contenu d'autrui que vous n'avez pas le droit d'utiliser.
Cadre juridique
Ne collectez que des données ouvertes, accessibles sans authentification, et vos propres documents. Respectez le fichier robots.txt : c'est la liste des règles du site sur les sections qu'on peut parcourir automatiquement. Ne collectez pas de données personnelles de tiers : noms avec numéros de téléphone, adresses, comptes. Si vous constituez un corpus à partir de vos documents internes, assurez-vous d'avoir le droit de les utiliser. Dans ce guide, le proxy est utilisé comme un outil de collecte distribuée honnête, et non comme un moyen de faire ce que la source a interdit.
Étape 1 : définir les limites du corpus et dresser la carte des sources
Objectif de l'étape : obtenir un fichier contenant la liste des sources, où pour chacune sont précisées les URL que l'on prend, celles que l'on exclut, la profondeur de parcours et le nombre de requêtes par minute autorisées.
La cause la plus fréquente d'un corpus pollué n'est pas une erreur technique, mais l'absence de limites. On lance un collecteur « sur tout le site », on obtient 40 000 pages dont 800 sur le thème, et ensuite on nettoie pendant une semaine. Faisons l'inverse : d'abord la carte, ensuite la collecte.
Instructions
- Formulez les questions auxquelles votre système RAG doit répondre. Écrivez 20 à 30 vraies questions d'utilisateurs. Par exemple, pour la base de connaissances d'un service de proxy : « Comment changer d'IP via un lien », « Pourquoi le proxy répond lentement », « Quels ports sont pris en charge ». Ces questions deviendront votre jeu de test à l'étape de vérification.
- Pour chaque question, notez où se trouve la réponse. Section d'aide, documentation, articles de blog, règlements PDF, pages produit. Tout ce qui n'est pas dans cette liste n'entre pas dans le corpus.
- Ouvrez chaque source dans le navigateur et étudiez la structure des adresses. En général, le contenu utile se trouve sous des préfixes clairs :
/help/,/docs/,/blog/,/faq/. Et les déchets ailleurs :/tag/,/search?,/cart/,/author/, pages de pagination du type?page=. - Vérifiez le robots.txt de la source. Ouvrez
https://domaine/robots.txt. Cherchez les lignesDisallow: ces chemins sont exclus sans discussion. Si unCrawl-delayy figure aussi, notez-le comme pause minimale entre les requêtes. - Trouvez le sitemap. Souvent il est indiqué dans robots.txt par la ligne
Sitemap:, ou se trouve à l'adresse/sitemap.xml. Le sitemap est une liste d'adresses prête à l'emploi, qui vous évitera le parcours récursif des liens et les déchets qui l'accompagnent. - Définissez la charge. Pour les petits sites, ne dépassez pas 10 à 15 requêtes par minute. Pour les grands portails avec CDN, jusqu'à 30 est acceptable. En cas de doute, prenez moins : le corpus n'est pas pressé.
- Définissez la géographie. Si le contenu dépend de la région (prix, livraison, disponibilité), décidez de quelle ville votre collecteur doit « regarder » et choisissez le proxy mobile correspondant.
- Formalisez tout dans un fichier
sources.json.
Exemple d'entrée pour une source :
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]Le champ rotate_every définit après combien de requêtes le collecteur appellera le lien de changement d'IP. Remplacez les guillemets simples par des guillemets doubles lors de l'enregistrement dans un vrai fichier JSON, ils sont ici affichés pour la lisibilité.
Attention : N'ajoutez pas aux sources les sites où le contenu utile n'est visible qu'après connexion à un compte. D'une part, cela viole les conditions d'utilisation de la plupart des plateformes. D'autre part, un tel corpus ne peut pas être légalement mis à jour ni diffusé en interne.
Conseil : Créez une source séparée pour vos propres documents : un dossier avec des PDF, DOCX et exports de votre CRM ou base de connaissances. Ils n'ont pas besoin d'être téléchargés via un proxy, mais nous les traiterons et nettoierons avec le même pipeline que les pages web.
Vérification : Vous avez un fichier sources.json où chaque source a des préfixes d'inclusion, des motifs d'exclusion, une limite de requêtes et une langue. Ouvrez 5 adresses aléatoires du sitemap correspondant à vos filtres et vérifiez que chacune contient un texte substantiel, et non un catalogue de liens.
Problèmes possibles
- Le site n'a pas de sitemap. Rassemblez la liste des adresses à partir de plusieurs pages sommaires à la main, ou via un parcours simple des liens uniquement à l'intérieur des préfixes autorisés, sur une profondeur de 2.
- Le sitemap contient 100 000 adresses. Filtrez par préfixes, puis prenez un échantillon de 200 adresses, collectez et évaluez la qualité avant de tout lancer.
- Le contenu utile est réparti sur plusieurs domaines. Créez une entrée distincte dans
sources.jsonpour chaque domaine, avec sa propre limite et sa propre géographie.
Étape 2 : connecter le proxy mobile et vérifier que les requêtes passent bien par lui
Objectif de l'étape : s'assurer que le script passe bien par le proxy mobile, que la rotation fonctionne et que les latences sont acceptables pour la collecte.
Instructions
- Créez un fichier
.envà la racine du projet et saisissez les valeurs du tableau de bord :
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxChaque valeur sur sa propre ligne. Ajoutez .env à .gitignore si vous utilisez un système de contrôle de version.
- Créez un fichier
proxy_check.pyavec le contenu suivant :
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP sans proxy:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP via proxy:', ip1, 'en', round(time.time() - t0, 2), 'sec') print('Changement d IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP après rotation:', ip2) print('Rotation réussie:', ip1 != ip2)Installez d'abord pip install python-dotenv. Dans le vrai fichier, les lignes de code sont chacune sur sa propre ligne.
- Lancez :
python proxy_check.py. - Lisez la sortie. La première IP doit être la vôtre, domestique ou serveur. La deuxième doit être différente et appartenir à un opérateur mobile. La troisième doit différer de la deuxième, et la dernière ligne doit afficher
True. - Mesurez la latence. Si une requête via le proxy dépasse 5 à 6 secondes, la collecte sera lente. Vérifiez que le proxy choisi est géographiquement proche des sites cibles, ou contactez le support du service.
- Testez SOCKS5 en alternative. Si le port HTTP donne un résultat instable, remplacez
http://dansproxy_urlparsocks5h://et le port par le port SOCKS5 du tableau de bord. Il faudrapip install requests[socks]. Le suffixehest important : il force le proxy à résoudre lui-même les noms de domaine.
Attention : Ne lancez pas la rotation d'IP plus souvent que ne le permet votre forfait. La plupart des proxys mobiles ont un intervalle minimal entre les changements, en général de 30 secondes à 2 minutes. Des requêtes trop fréquentes sur le lien de rotation sont soit ignorées, soit bloquent temporairement la fonction.
Conseil : Faites cinq mesures de latence d'affilée et notez la médiane. Ce nombre servira à l'étape suivante pour fixer correctement les timeouts : le timeout doit être environ 4 à 5 fois supérieur à la latence typique.
Vérification : Le script affiche trois adresses IP différentes, la ligne Rotation réussie: True, et la latence typique via le proxy ne dépasse pas 3 à 4 secondes. Si c'est le cas, le proxy est prêt.
Problèmes possibles
- Erreur 407 Proxy Authentication Required. Vérifiez l'identifiant et le mot de passe, assurez-vous qu'il n'y a pas d'espaces superflus. Si le mot de passe contient les caractères
@ou:, encodez-les viaurllib.parse.quote. - Erreur Connection refused ou timeout. Le proxy est peut-être lié à votre IP blanche. Allez dans le tableau de bord et ajoutez l'adresse actuelle du serveur à la liste des autorisées, ou passez à l'authentification par identifiant et mot de passe.
- L'IP n'a pas changé après la rotation. Augmentez la pause après la requête sur le lien de rotation à 15-20 secondes. Certains opérateurs ne délivrent pas une nouvelle adresse instantanément.
- Erreurs SSL. Mettez à jour la bibliothèque
certifiavecpip install -U certifi. Ne désactivez pas la vérification des certificats avec le paramètreverify=False: ce n'est pas sûr.
Étape 3 : écrire un collecteur soigné avec limites, rotation et journal
Objectif de l'étape : obtenir un script qui parcourt les adresses du sitemap, respecte robots.txt et les limites, passe par le proxy, change d'IP selon le planning, enregistre le HTML brut et tient un journal où chaque requête est visible.
Il est important de comprendre la philosophie ici. Un bon collecteur pour un système RAG est lent, poli et paranoïaquement détaillé dans ses logs. Un crawler rapide et agressif vous ramassera une montagne de pages tronquées et d'erreurs 429, et ensuite vous ne saurez plus ce qui est un déchet.
Instructions
- Créez un fichier
fetch.py. Structure du script : chargement des paramètres, analyse du sitemap, filtrage des adresses, boucle de requêtes avec pauses, enregistrement du résultat. - Chargez le sitemap et filtrez les adresses. Le sitemap est un XML où chaque adresse est dans une balise
loc. Parsez-le avec le standardxml.etree.ElementTree. Ne gardez que les adresses commençant parinclude_prefixeset ne contenant aucun desexclude_patterns. Enregistrez le résultat dansurls_help_center.txtet regardez-le à l'œil. - Ajoutez la vérification du robots.txt. Utilisez
urllib.robotparser.RobotFileParser: chargez le fichier une fois par domaine et avant chaque requête demandezcan_fetch(user_agent, url). Les adresses interdites sont ignorées et notées dans le journal avec la mentionrobots_disallow. - Définissez un User-Agent honnête. Par exemple :
CorpusCollector/1.0 (+contact: data@yourcompany.ru). Le propriétaire du site doit comprendre qui lui rend visite et comment le contacter. Ce n'est pas seulement de l'éthique, c'est aussi pratique : un agent clair tombe plus rarement sous des restrictions automatiques. - Implémentez les pauses. À partir de
rate_per_minute, calculez la pause de base :60 / rate_per_minutesecondes. Ajoutez une composante aléatoire de 20 à 40 pour cent, pour que les requêtes ne partent pas au métronome. Si le robots.txt contient unCrawl-delay, prenez le maximum des deux valeurs. - Implémentez la rotation. Comptez les requêtes, et quand le compteur atteint
rotate_every, appelez le lien de changement d'IP, attendez 10 secondes, remettez le compteur à zéro. La rotation vaut aussi la peine d'être faite au passage à la source suivante. - Traitez les réponses. Code 200 : on enregistre. Codes 301 et 302 :
requestsles gère tout seul, mais notez l'adresse finale : elle servira à la déduplication. Code 404 : on note dans le journal et on passe. Code 429 ou 503 signifie « trop fréquent » : on fait une pause de 5 minutes, on augmente la pause de base d'un facteur 1,5 et on réessaie une fois. Si la nouvelle tentative échoue, on passe et on continue. - Enregistrez le HTML brut avec son passeport. Pour chaque page, écrivez une ligne dans le fichier
raw/help_center.jsonl.
Fragment de code clé pour l'enregistrement et la boucle :
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))Notez la condition len(html) > 2000. Une page avec un contenu substantiel fait presque jamais moins de deux kilo-octets de HTML. C'est le premier filtre à déchets, le plus grossier, et il élimine les réponses vides et les pages bouche-trou dès l'entrée.
- Lancez sur un échantillon. Le premier lancement se fait sur 50 adresses. Regardez le journal, ouvrez deux ou trois HTML enregistrés dans le navigateur. Vérifiez que ce sont bien les pages attendues.
- Lancez la collecte complète. Sur le serveur, utilisez
nohup python fetch.py &ouscreen, pour que le processus survive à la fermeture du terminal. Collecter 3 000 pages à 12 requêtes par minute prendra environ 4 à 5 heures.
Attention : Ne lancez pas plusieurs copies du collecteur sur le même site en parallèle via un seul proxy. La rotation d'IP n'annule pas les limites de charge sur le serveur source. Si vous voulez accélérer, parallélisez sur différents sites, pas sur un seul.
Conseil : Notez dans le journal l'IP du proxy depuis laquelle chaque requête a été faite. Quand, à l'étape de nettoyage, vous découvrirez une série de pages tronquées, vous verrez immédiatement par l'IP et l'heure s'il s'agissait d'un incident de session précise, et vous ne recollecterez que celle-là.
Conseil : Ajoutez au collecteur une reprise : avant de lancer, lisez les adresses déjà collectées depuis raw/*.jsonl et ignorez-les. Ainsi, une coupure de connexion ou un redémarrage du serveur ne vous obligera pas à repartir de zéro.
Vérification : Dans le dossier raw se trouve un fichier JSONL, le nombre de lignes est proche du nombre d'adresses avec le statut 200 dans le journal, et une ligne choisie au hasard contient les champs url, fetched_at, proxy_ip et un HTML complet. La part d'erreurs et d'omissions dans le journal ne dépasse pas 5 pour cent.
Problèmes possibles
- Beaucoup de réponses 429. Vous êtes trop rapide pour ce site. Réduisez
rate_per_minutede moitié, augmentezrotate_every, pour que la rotation ne ressemble pas à un pic depuis de nouvelles adresses. - Les pages arrivent vides, bien que le statut soit 200. Le contenu est rendu en JavaScript. Ces sources nécessitent un rendu navigateur, dont il est question dans le bloc avancé. En attendant, marquez-les dans
sources.jsonavec le drapeauneeds_js: true. - La collecte tourne, mais très lentement. Vérifiez la latence du proxy de l'étape 2, assurez-vous que le timeout n'est pas réglé sur 120 secondes quand la latence typique est de 2, sinon chaque page bloquée mange deux minutes.
- Le script plante sur l'encodage. Utilisez
r.textavec vérification der.encoding; si le site renvoie un encodage incorrect, mettezr.encoding = r.apparent_encodingavant la lecture.
Étape 4 : extraire le texte propre du HTML et des documents
Objectif de l'étape : transformer le HTML brut et les fichiers en texte propre, où il ne reste que le contenu principal de la page : titre, paragraphes, listes, tableaux, sans menus, pieds de page, encarts publicitaires ni widgets.
C'est le moment où la qualité du corpus naît ou meurt. L'approche naïve « enlever toutes les balises » laisse dans le texte les éléments de menu, les boutons « Acheter », le texte du bandeau cookies et les listes d'articles similaires. Tout cela remontera ensuite dans les réponses du système RAG.
Instructions pour les pages web
- Créez un fichier
extract.py. Il litraw/*.jsonlligne par ligne et écrit le résultat dansclean/*.jsonl. - Utilisez la bibliothèque
trafilaturapour extraire le texte principal. Elle est entraînée à trouver la zone de contenu de la page et à écarter les blocs standardisés.
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- Le paramètre
favor_precision=Truepousse la bibliothèque à être plus stricte : elle préférera perdre un morceau de texte plutôt que d'attraper un menu. Pour un corpus RAG, c'est le bon choix. Si vous remarquez que des blocs utiles sont perdus, par exemple des tableaux de caractéristiques, passez àfavor_recall=Truepour la source concernée. - Ajoutez une méthode de secours. Si
trafilaturarenvoieNoneou un texte de moins de 200 caractères, essayez d'extraire le contenu par sélecteur CSS, que vous trouverez à la main : ouvrez la page dans le navigateur, appuyez sur F12, trouvez le bloc du texte principal, copiez sa classe, par exemplearticle-body. UtilisezBeautifulSouppour découper uniquement ce bloc. Notez le sélecteur danssources.jsonsouscontent_selector. - Normalisez le texte. Remplacez les espaces insécables par des espaces normaux, réduisez trois retours à la ligne ou plus à deux, supprimez les espaces en début et fin de ligne. Ne changez pas la casse et ne supprimez pas la ponctuation : cela dégraderait la recherche.
- Enregistrez avec les métadonnées d'origine. Copiez depuis l'enregistrement brut
url,final_url,fetched_at, ajoutezsourcedepuissources.json, les champs issus de l'extraction et la longueur du texte en caractères.
Instructions pour les PDF et DOCX
- PDF. Utilisez
pypdf: ouvrez le fichier, parcourez les pages, appelezpage.extract_text()et concaténez. Conservez le numéro de page pour chaque fragment : ce sont de précieuses métadonnées, qui permettront à l'utilisateur de retrouver l'endroit dans l'original. Si le texte revient vide, le PDF contient des scans, pas du texte : mettez ces fichiers de côté dans un dossier à part, la reconnaissance optique sort du cadre de ce guide. - DOCX. Utilisez
python-docx: parcourezdocument.paragraphsetdocument.tables. Les titres dans Word ont le styleHeading 1,Heading 2: conservez-les comme lignes à part avec une marque, ils seront utiles pour découper le document plus tard. - Supprimez les en-têtes et pieds de page. Dans les PDF d'instructions, le nom de l'entreprise, le numéro de version et « Page 3 sur 40 » se répètent à chaque page. Rassemblez toutes les lignes du document, trouvez celles qui reviennent sur plus de la moitié des pages et supprimez-les.
Attention : Ne supprimez pas les tableaux pour faire joli. Dans les instructions, les tarifs et les caractéristiques, ce sont précisément les tableaux qui contiennent les réponses aux questions concrètes : « quelle limite », « combien ça coûte », « quel port ». Conservez-les ligne par ligne, en séparant les cellules par une tabulation ou une barre verticale.
Conseil : Après l'extraction, prenez 20 documents au hasard et lisez-les en entier. Non pas en diagonale, mais vraiment. Une telle révision trouve plus de problèmes systémiques que n'importe quel filtre automatique : par exemple, vous verrez que sur toutes les pages du blog, un bloc « À lire aussi » avec trois titres s'est collé à la fin du texte.
Vérification : Dans le dossier clean se trouvent les fichiers JSONL. Le nombre d'enregistrements est au moins de 80 pour cent du nombre de pages brutes. Dans 10 enregistrements au hasard, le texte commence par le titre ou le premier paragraphe de l'article, pas par des éléments de menu, et se termine par le dernier paragraphe substantiel, pas par la mention « Tous droits réservés ».
Problèmes possibles
- Trop peu de texte est extrait. Site à mise en page non standard. Ajoutez
content_selectoret un chemin de secours viaBeautifulSoup. - Des boutons et des éléments de menu restent dans le texte. Activez
favor_precision, et pour les cas tenaces ajoutez une liste de lignes à supprimer : les lignes courtes du type « Partager », « Lire la suite », « Haut de page » sont supprimées si elles forment une ligne à part. - Le PDF renvoie un texte à l'envers ou avec des mots coupés. Essayez
pdfplumberà la place depypdf, il gère mieux les colonnes.
Étape 5 : filtrer les déchets : déduplication, modèles, qualité, langue
Objectif de l'étape : écarter les doublons, les pages bouche-trou, les blocs standardisés, les textes en langue étrangère et les documents trop courts ou cassés, en ne gardant que ce qui porte des connaissances.
Même après une extraction soignée, il reste de 15 à 40 pour cent de déchets dans le corpus. C'est normal. Ce qui n'est pas normal, c'est de les laisser passer dans l'index.
Instructions
- Créez un fichier
filter.pyqui litclean/*.jsonl, applique les filtres l'un après l'autre, écrit les documents retenus danscorpus/filtered.jsonlet les rejetés danscorpus/rejected.jsonlavec la raison. - Filtre 1 : longueur minimale. Les documents de moins de 300 caractères sont presque toujours des pages bouche-trou, des annonces ou des erreurs d'extraction. Rejetez avec la raison
too_short. Pour les fiches produit, le seuil peut être abaissé à 150. - Filtre 2 : phrases bouche-trou. Dressez la liste des phrases qui trahissent une page vide : « page introuvable », « produit indisponible », « accès restreint », « activez javascript », « travaux techniques en cours ». Si une telle phrase apparaît dans les 300 premiers caractères et que tout le texte fait moins de 1 500 caractères, rejetez avec la raison
placeholder. - Filtre 3 : langue. Utilisez
langdetect.detectsur les 1 000 premiers caractères. Si la langue ne correspond pas à celle indiquée dans la source, rejetez avec la raisonwrong_lang. Notez que sur les textes courts, le détecteur se trompe, donc appliquez-le après le filtre de longueur. - Filtre 4 : doublons exacts. Normalisez le texte : minuscules, espaces réduits, ponctuation enlevée. Calculez le
sha1. Si le hachage a déjà été vu, rejetez avec la raisonexact_dupet conservez le lien vers l'original. Sources typiques de doublons exacts : une même page enhttpethttps, avec et sanswww, avec et sans paramètre?utm_source, ainsi que les pages pour l'impression. - Filtre 5 : quasi-doublons. Ici, il faut MinHash de la bibliothèque
datasketch. Découpez le texte normalisé en shingles de 5 mots, construisez unMinHashavec 128 permutations, placez-le dans unMinHashLSHavec un seuil de 0,85. Un document qui a déjà un voisin similaire dans l'index est rejeté avec la raisonnear_dup. Ainsi disparaissent les versions d'un même article à des dates différentes, les pages produit qui ne diffèrent que par la couleur et les actualités republiées.
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- Filtre 6 : lignes standardisées. Rassemblez toutes les lignes de tous les documents d'une même source et comptez dans quel pourcentage de documents chacune apparaît. Les lignes présentes dans plus de 30 pour cent des documents et de moins de 200 caractères sont un modèle : avertissements, signatures, appels à s'abonner. Supprimez-les de tous les documents. Ce n'est pas un rejet de document, mais un nettoyage à l'intérieur de celui-ci.
- Filtre 7 : qualité du texte. Calculez des métriques simples : la part de lettres parmi tous les caractères doit être supérieure à 0,6 ; la longueur moyenne des mots entre 3 et 12 ; la part de lignes se terminant par un point supérieure à 0,3 pour les articles. Les documents hors de ces bornes sont en général des tableaux de codes, des dumps ou des extractions cassées. Rejetez avec la raison
low_quality, mais regardez absolument les rejets à l'œil : pour la documentation technique, il faut assouplir les seuils. - Filtre 8 : pages tronquées. Comparez
html_lende l'enregistrement brut avec la médiane de la source. Si le HTML fait moins de 30 pour cent de la médiane et que le texte s'interrompt au milieu d'une phrase sans point, c'est une réponse tronquée. Raisontruncated. Notez ces adresses dansrecollect.txtet recollectez-les via le proxy à l'étape 3. - Lancez le filtre et examinez le rapport. Le script doit afficher un tableau : combien de documents en entrée, combien rejetés pour chaque raison, combien il en reste.
Attention : Ne supprimez jamais les fichiers de clean et raw pendant la filtration. Le filtre écrit seulement de nouveaux fichiers. Si le seuil MinHash s'avère trop agressif et que vous perdez 40 pour cent de documents utiles, vous changerez simplement le nombre et relancerez le script en deux minutes.
Conseil : Le seuil de 0,85 pour les quasi-doublons est bon pour les articles et l'aide. Pour les fiches produit d'une même marque qui ne diffèrent que par la taille ou le volume, il les fusionnera en une seule. Décidez à l'avance si votre système RAG a besoin de toutes les variantes, et soit montez le seuil à 0,95, soit fusionnez les variantes en un seul document avec un tableau des différences dès l'étape d'extraction.
Conseil : Les documents rejetés ne sont pas des déchets, mais du matériel de débogage. Une fois par semaine, ouvrez rejected.jsonl, filtrez par raison et regardez 10 enregistrements au hasard. Si parmi les low_quality on trouve régulièrement des tableaux de tarifs utiles, il faut corriger les seuils.
Vérification : Le rapport de filtre montre une image raisonnable : un rejet total de 10 à 40 pour cent, dont les doublons constituent une part notable, et la raison truncated ne dépasse pas 2 à 3 pour cent. Dans le fichier filtered.jsonl, il n'y a pas deux documents avec le même texte normalisé, et 10 enregistrements au hasard ressemblent à des articles complets ou à des sections de documentation.
Problèmes possibles
- Le rejet dépasse 60 pour cent. Probablement des seuils de qualité trop stricts ou une erreur de normalisation, à cause de laquelle tous les textes se ressemblent. Affichez 20 rejets au hasard et trouvez la cause systémique.
- MinHash prend très longtemps. Sur un corpus de plus de 100 000 documents, réduisez
num_permà 64 ou calculez par source séparément. - Le détecteur de langue étiquette des textes russes comme bulgares ou macédoniens. Cela arrive sur de courts fragments comportant beaucoup de noms propres. Vérifiez la langue sur les 2 000 premiers caractères et acceptez n'importe quelle langue d'un groupe proche comme correspondance.
Étape 6 : annoter les métadonnées et assembler le corpus final
Objectif de l'étape : obtenir un fichier unique corpus/corpus_v1.jsonl, où chaque document a un identifiant stable, un ensemble complet de métadonnées et est prêt à être transmis au pipeline d'indexation.
Les métadonnées sont ce qui distingue un corpus d'un tas de texte. Elles permettent de mettre à jour des sources individuelles, d'expliquer à l'utilisateur l'origine de la réponse, de filtrer par date et par section et, surtout, de ne pas refaire tout le travail dans un mois.
Instructions
- Définissez le schéma du document. Fixez-le dans un fichier
schema.mdet ne le changez pas sans changer la version du corpus. Minimum recommandé :
doc_id: identifiant stable, par exemplesha1definal_url, pour qu'à la recollecte le document reçoive le même id ;source: nom de la source depuissources.json;urletfinal_url;title;section: section du site calculée à partir du premier segment du chemin après le préfixe, par exemplehelp/proxies;lang;published_at: date de publication, si extraite ;fetched_at: date de collecte ;geo: région du proxy depuis laquelle la collecte a été faite ;text;text_len,text_sha1;corpus_version: par exemplev1.
- Calculez la section. Analysez
final_urlavecurllib.parse.urlparse, prenez le chemin, enlevez le préfixe de la source, gardez un ou deux segments. La section deviendra plus tard un filtre dans le système RAG : l'utilisateur pose une question sur le paiement, la recherche se fait d'abord dans la sectionbilling. - Normalisez les dates. Toutes les dates doivent être au format ISO 8601 en UTC. Si la date de publication n'est pas trouvée, laissez le champ vide, et ne mettez pas la date de collecte : ce sont deux choses différentes, et les confondre est dangereux lors du filtrage des contenus obsolètes.
- Ajoutez le titre au texte. Si
textne commence pas partitle, insérez le titre en première ligne. Le titre porte des mots-clés importants pour la recherche. - Triez et écrivez. Triez les documents par
sourceetfinal_url, écrivez danscorpus/corpus_v1.jsonl. À côté, placezcorpus/manifest_v1.jsonavec le nombre de documents par source, la date de constitution, la version du schéma et les paramètres des filtres. - Faites une archive. Archivez
corpus,sources.json,schema.mdet le dossierlogs. Cette archive est une version reproductible de votre corpus.
Conseil : Gardez les données personnelles hors du corpus, tout simplement. Si des exemples du type « Ivan Petrov, +7 900... » apparaissent dans les textes d'aide, remplacez-les par des espaces réservés dès l'étape de constitution du corpus. Un système RAG ne doit pas pouvoir sortir le téléphone de quelqu'un, même s'il était en accès libre.
Vérification : Le fichier corpus_v1.jsonl s'ouvre, chaque ligne est un JSON valide avec les champs du schéma, tous les documents ont un doc_id unique, tous ont source, lang, fetched_at, text renseignés. Le fichier manifest_v1.json contient un récapitulatif correspondant au nombre de lignes.
Problèmes possibles
- Différentes adresses mènent à un même document et donnent des doc_id différents. Calculez l'id à partir de
final_urlaprès les redirections, en supprimant les paramètres de requête et le slash final. - Les dates sont extraites dans différents formats. Utilisez
dateutil.parser.parseavec le paramètredayfirst=Truepour les sources francophones.
Vérification du résultat : checklist et test du corpus
Le corpus est constitué. Avant de le porter à l'indexation, vérifions-le comme un produit, et non comme un fichier.
Checklist
- Le fichier
sources.jsonexiste avec les limites de chaque source et les limites indiquées. - Toutes les requêtes sont passées par un proxy mobile, chaque requête a un
proxy_ipdans le journal. - La part d'erreurs de collecte dans le journal ne dépasse pas 5 pour cent, les réponses 429 moins de 1 pour cent.
- Au moins 80 pour cent des documents ont été extraits des pages brutes.
- Le rejet à la filtration est entre 10 et 40 pour cent, toutes les raisons de rejet sont nommées.
- Le corpus ne contient pas de doublons exacts sur le texte normalisé.
- Chaque document a ses métadonnées obligatoires renseignées.
- Une archive existe avec les données brutes, le corpus, les journaux et les paramètres.
Comment tester
- Test sur les questions de l'étape 1. Reprenez vos 20 à 30 questions. Pour chacune, trouvez par une simple recherche de sous-chaîne ou via
greple document du corpus qui contient la réponse. Objectif : au moins 90 pour cent des questions couvertes. Si une question n'est pas couverte, trouvez la page avec la réponse dans le navigateur et comprenez pourquoi elle n'est pas passée : absente du sitemap, rejetée par les filtres, texte tronqué. - Test des déchets. Cherchez dans le corpus les chaînes « abonner », « panier », « cookie », « tous droits réservés », « lire aussi ». Chaque occurrence est un soupçon. Quelques-unes sont tolérables si elles font partie d'un texte substantiel ; des dizaines d'occurrences signifient que le filtre de modèles doit être retravaillé.
- Test des coupures. Comptez les documents dont le texte se termine ni par un point, ni par un point d'exclamation ou d'interrogation, ni par une parenthèse fermante. Ils doivent être moins de 5 pour cent. Regardez les autres à l'œil.
- Test de distribution. Construisez un histogramme des longueurs de documents. Un corpus sain d'aide ou de blog a un pic autour de 2 000 à 8 000 caractères et une longue queue. Un pic net près du seuil minimal indique des pages bouche-trou qui sont passées.
- Test de géographie. Si le contenu dépend de la région, ouvrez 5 pages avec des prix ou des disponibilités et comparez avec ce que voit une personne de la ville voulue. Les écarts signifient que le proxy est choisi dans une autre région ou que le site détermine la région non par l'IP mais par les cookies.
Indicateurs de réussite
Le corpus est prêt si la couverture des questions de test dépasse 90 pour cent, si la part de documents présentant des traces de déchets est inférieure à 3 pour cent, et si le manifest permet de reproduire entièrement la constitution. C'est seulement après cela que le corpus est transmis au pipeline d'indexation du système RAG.
Erreurs typiques et solutions lors de la collecte d'un corpus pour RAG
Problème : des éléments de menu et des appels à s'abonner apparaissent dans les réponses de l'assistant. Cause : l'extraction du texte fonctionnait en mode rappel, pas précision, le filtre de modèles n'a pas été lancé. Solution : activez favor_precision, implémentez la suppression des lignes présentes dans plus de 30 pour cent des documents de la source, refaites clean à partir de raw sans retélécharger.
Problème : l'assistant répond selon une version obsolète de l'instruction. Cause : l'ancienne et la nouvelle version de l'article cohabitent dans le corpus, les quasi-doublons n'ont pas été écartés ou le seuil est trop élevé. Solution : abaissez le seuil MinHash à 0,8 pour les sources avec versionnage, en cas de conflit gardez le document avec le published_at le plus récent.
Problème : une partie des pages est collectée vide, statut 200. Cause : le contenu est construit en JavaScript côté navigateur. Solution : marquez la source needs_js et utilisez le rendu via Playwright du bloc avancé, ou trouvez sur le site une API ou un RSS où le contenu est livré prêt.
Problème : la collecte s'arrête sur les erreurs 429 et 503. Cause : fréquence de requêtes trop élevée, la rotation d'IP a été utilisée au lieu de réduire la charge. Solution : réduisez la fréquence à 6-8 requêtes par minute, augmentez la dispersion aléatoire des pauses, mettez une pause de 5-10 minutes à la première 429. Rappelez-vous que la limite de charge concerne le respect de la source, pas le nombre d'adresses.
Problème : après la rotation, le site affiche le contenu d'une autre région. Cause : le proxy mobile a délivré une IP d'une autre ville, ou le site a déterminé la région par les cookies de la session précédente. Solution : fixez la région voulue dans le tableau de bord du proxy, réinitialisez la session requests après chaque rotation pour que les cookies ne soient pas transférés.
Problème : le corpus est constitué, mais la couverture des questions est de 60 pour cent. Cause : les limites des sources sont trop étroites, des pages utiles ont été écartées par les préfixes. Solution : reprenez les questions non couvertes, trouvez les réponses dans le navigateur, regardez leurs adresses et élargissez les include_prefixes.
Problème : la déduplication a mangé les fiches produit qui diffèrent par leurs caractéristiques. Cause : le seuil de quasi-doublons est trop bas pour des textes similaires. Solution : pour les sources de catalogue, montez le seuil à 0,95 ou fusionnez les variantes d'un même produit en un seul document à l'étape d'extraction.
Problème : les textes PDF arrivent en une seule ligne sans paragraphes. Cause : pypdf perd la mise en forme. Solution : passez à pdfplumber ou pymupdf, restaurez les paragraphes à partir des doubles retours à la ligne et des indentations.
Problème : des données personnelles sont entrées dans le corpus. Cause : il n'y a pas eu d'étape d'anonymisation. Solution : ajoutez avant l'écriture dans le corpus une recherche de téléphones, e-mails et noms via des motifs simples et un remplacement par des espaces réservés ; les documents litigieux partent en vérification manuelle.
Fonctionnalités supplémentaires pour les avancés
Si le pipeline de base fonctionne, voici où le développer.
Rendu de pages avec JavaScript via proxy
Installez pip install playwright et playwright install chromium. Lancez le navigateur avec le paramètre proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS}. Attendez le sélecteur du contenu principal via page.wait_for_selector, et non des secondes fixes. Récupérez page.content() et rangez-le dans le même format raw, pour que les étapes suivantes ne changent pas. Le rendu est 5 à 10 fois plus lent que les requêtes normales, donc appliquez-le uniquement aux sources marquées needs_js et réduisez la fréquence à 3-5 pages par minute.
Mise à jour incrémentale du corpus
Conservez dans le manifeste le text_sha1 de chaque document. À la collecte suivante, téléchargez les pages, mais n'extrayez et ne filtrez que celles dont le hachage HTML a changé ou dont la collecte remonte à plus de 30 jours. Utilisez les en-têtes If-Modified-Since et ETag : beaucoup de sites renverront un 304 sans corps, et vous économiserez du trafic proxy. Chaque mise à jour reçoit une nouvelle version du corpus : v2, v3, et les anciennes archives ne sont pas supprimées.
Corpus multirégional
Si l'entreprise a des filiales et que le contenu des sources dépend de la ville, prévoyez plusieurs proxys mobiles avec des géographies différentes. Collectez la même page depuis chaque région, conservez geo dans les métadonnées et dédupliquez uniquement à l'intérieur d'une région. Le système RAG pourra ensuite répondre « à Lyon la livraison est en 2 jours, à Marseille en 4 », en s'appuyant sur les vraies versions régionales des pages.
Notation de la qualité au lieu de seuils stricts
Au lieu de rejeter selon des seuils, calculez pour chaque document une note de qualité de 0 à 1 à partir des mêmes métriques : longueur, part de lettres, part de phrases complètes, répétitivité des lignes. Conservez la note dans les métadonnées. Le pipeline d'indexation pourra alors décider lui-même quoi prendre, et la recherche classer les documents fiables plus haut.
Déduplication sémantique
MinHash attrape les doublons lexicaux. Les reformulations d'une même instruction avec d'autres mots lui échappent. Pour les attraper, calculez les embeddings des documents et cherchez les paires avec une similarité cosinus supérieure à 0,95. C'est déjà la frontière avec l'étape d'indexation, donc ici ce n'est qu'une mention : décidez où tracer la frontière et ne faites pas deux fois le même travail.
Monitoring de la collecte
Sortez du journal les métriques : requêtes par minute, part de codes 200, latence moyenne, nombre de rotations. Un simple tableau de bord sur matplotlib ou un tableau dans le terminal toutes les 10 minutes montrera la dégradation avant que vous ne découvriez 500 pages vides le matin.
FAQ : questions fréquentes sur la collecte de corpus
Faut-il obligatoirement utiliser un proxy mobile pour collecter un corpus ? Pour vos propres documents et de petites sources, ce n'est pas obligatoire. Le proxy devient nécessaire quand les sources sont nombreuses, que la collecte dure des heures, que la version régionale du contenu importe, ou que vous ne voulez pas créer une charge visible sur le site depuis une seule adresse.
À quelle fréquence changer d'IP lors de la collecte ? Repère : toutes les 30 à 60 requêtes, ou au passage à une autre source. Plus souvent n'est pas nécessaire : le sens de la rotation est la répartition de charge et la stabilité de session, pas la fréquence en soi. Une rotation fréquente sans réduction du rythme global ne réduit pas la charge.
Combien de documents faut-il pour un système RAG opérationnel ? Pour un assistant sur un seul produit, 200 à 500 documents de qualité suffisent souvent. Pour une niche large, plusieurs milliers. La qualité compte plus que le volume : 500 articles propres donneront de meilleures réponses que 20 000 avec des déchets.
Peut-on collecter sur les réseaux sociaux et les marketplaces ? Uniquement les pages ouvertes dans les limites des règles de la plateforme et du robots.txt, sans données personnelles. Beaucoup de plateformes ont des API officielles pour obtenir le contenu, commencez par elles.
Que faire des images et des vidéos ? Dans le cadre d'un corpus textuel, ne conservez que les légendes, les textes alt et les transcriptions, s'ils existent sur la page. Les fichiers eux-mêmes n'entrent pas dans le corpus.
Pourquoi ne pas simplement télécharger le site entier avec un programme de téléchargement ? On peut, mais vous obtiendrez des dizaines de milliers de fichiers sans métadonnées, avec des doublons, des pages de service et sans journal. Ensuite, il faudra faire toutes les étapes de ce guide dans l'ordre inverse, en plus compliqué.
Comment savoir que les filtres n'ont pas supprimé ce qu'il fallait ? Regardez rejected.jsonl pour chaque raison, un échantillon de 10 à 20 enregistrements. Et vérifiez la couverture des questions de test : si des réponses ont disparu, cherchez-les dans les rejets.
Faut-il découper les documents en chunks à cette étape ? Non. Le découpage en fragments fait partie de l'indexation et dépend du modèle d'embeddings et de la taille du contexte. La tâche du corpus est de fournir des documents entiers avec métadonnées et balisage des titres, à partir desquels le chunker pourra découper intelligemment.
Comment mettre à jour le corpus sans tout recollecter ? Conservez les hachages, utilisez les requêtes conditionnelles If-Modified-Since, versionnez le corpus. Plus de détails dans le bloc avancé.
Que faire si le site interdit la collecte automatique dans robots.txt ? Respecter l'interdiction. Écrivez au propriétaire, souvent il donnera un export, une API ou une autorisation. Un corpus constitué contre les règles de la source crée des risques pour tout le projet.
Conclusion : ce qui a été fait et où aller ensuite
Vous avez parcouru tout le chemin, de l'idée au corpus prêt. Vous avez défini les limites et dressé la carte des sources avec limites et géographie. Vous avez connecté le proxy mobile et vérifié que la rotation fonctionne. Vous avez écrit un collecteur poli, qui respecte robots.txt, répartit la charge et tient un journal détaillé. Vous avez extrait le texte propre du HTML, des PDF et des DOCX. Vous avez écarté les doublons, les pages bouche-trou, les modèles et les pages cassées avec des raisons nommées. Vous avez annoté les métadonnées et assemblé un corpus versionné avec un manifeste. Vous l'avez testé sur de vraies questions.
Le résultat principal n'est pas le fichier sur le disque, mais un processus reproductible. Dans un mois, vous le relancerez et obtiendrez un corpus mis à jour en quelques heures, et non en une semaine. Et quand le système RAG commencera à répondre bizarrement, vous saurez exactement où chercher la cause : dans le journal de collecte, dans le rapport de filtre ou dans le manifeste.
Que faire ensuite. Transmettez corpus_v1.jsonl au pipeline d'indexation : découpage en fragments, embeddings, base vectorielle. C'est l'objet d'articles connexes du blog. Configurez un lancement régulier du collecteur selon un planning avec mise à jour incrémentale. Élargissez la carte des sources à mesure que le nombre de questions non couvertes augmente. Si l'entreprise est régionale, ajoutez les proxys des villes nécessaires et collectez les versions régionales du contenu.
Où progresser. Maîtrisez le rendu navigateur pour les sites complexes, la notation de la qualité des documents au lieu de seuils stricts, la déduplication sémantique et le monitoring de la collecte. Chacune de ces étapes améliore la qualité des réponses plus que le changement de modèle. Des données propres sont la moins chère des améliorations de votre système RAG. Bonne collecte.