如何通过移动代理为RAG系统收集语料库而不混入垃圾:分步指南
引言:你将获得什么,以及这适合谁
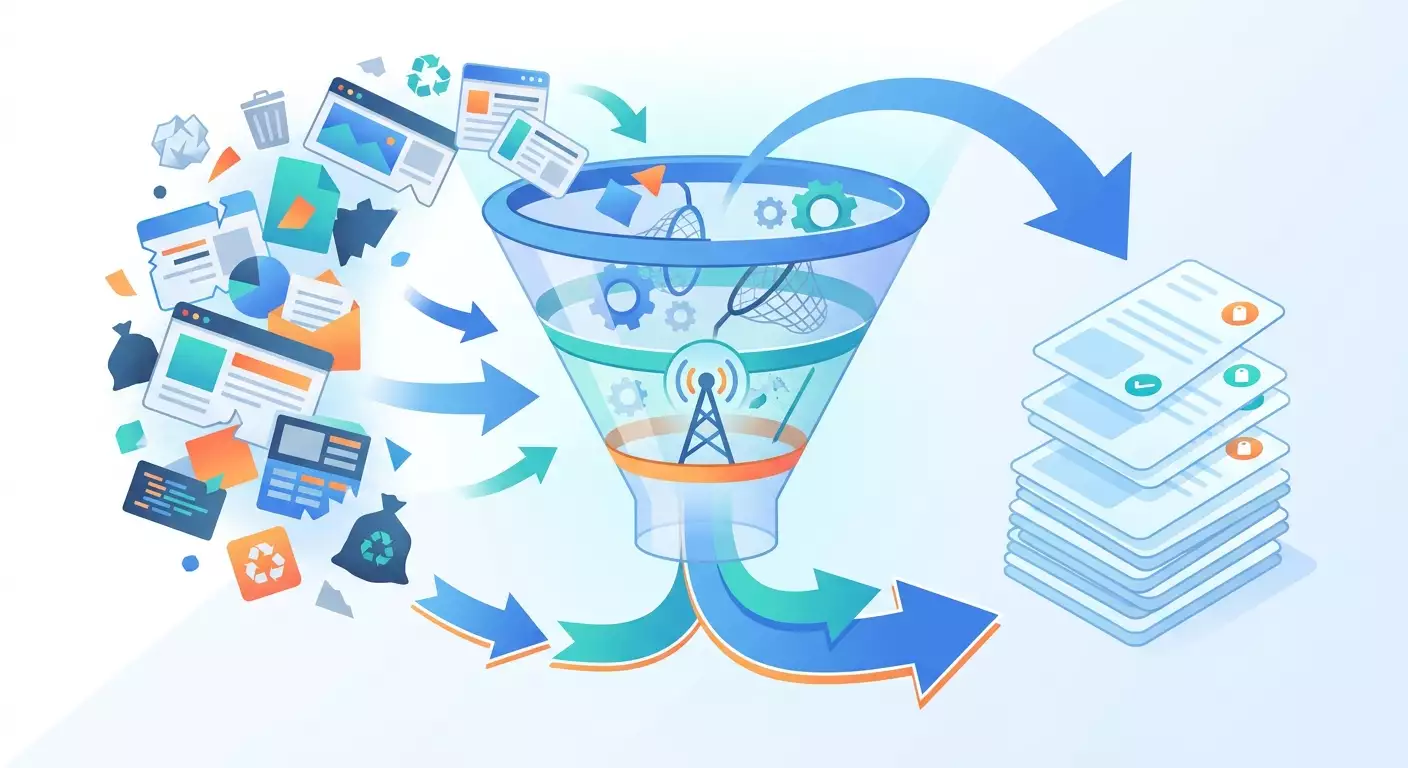
RAG系统的好坏,完全取决于它所依据的语料库质量。你可以用最强的语言模型、接上昂贵的向量数据库,但如果语料库里混进了网站菜单、带版权声明的页脚、同一篇文章的五个版本,以及“商品暂时缺货”的页面,那你得到的只会是自信满满的胡言乱语。模型分不清垃圾和知识。它只是寻找相似片段,然后把它们拼成答案。
这份分步指南只聚焦一个环节:语料库的收集。我们不会讨论向量数据库的架构、嵌入模型的选择和分块设置,博客里有专门的文章讲这些。这里我们只停留在边界上:你硬盘上有一个干净、有标注、已去重的JSONL格式文档集合,可以直接交给任何索引流水线。
你最终会得到:
- 一份边界清晰的来源清单:收集什么,不收集什么;
- 一个可用的Python采集器,通过移动代理访问,遵守频率限制,不会把别人网站搞垮;
- 一个包含原始页面和文档的文件夹,每份都带元数据;
- 一个提取正文的脚本,去掉导航、广告和模板区块;
- 质量过滤器和去重,在垃圾进入索引之前就把它筛掉;
- 最终的语料库文件和一份带数字的报告,让你一眼看出一切做得对不对。
这份指南适合谁。适合希望围绕自己所在行业收集知识库并搭建助手的营销人员和企业主。适合需要收集报价、落地页和广告平台规则语料库的套利从业者。适合已经给脚本接过代理、现在想做得更规范更系统的开发者。正文面向初学者,末尾有专门给进阶用户的板块。
需要提前知道什么。会运行终端命令,会用文本编辑器打开文件。对Python有基础认识,达到“看得懂for循环在做什么”的程度。能拿到移动代理的访问信息:地址、端口、用户名、密码和换IP的链接。
需要多少时间。环境准备约30分钟。走完所有步骤需要3到5小时,具体取决于语料库大小。采集几千个页面可以在后台跑几个小时,但这期间不需要你参与。
前期准备:工具、访问权限、环境
在写下第一行代码之前,先把工作环境整理好。这能帮你后面省下几个小时的调试时间。
系统要求
- 一台装有Windows 10/11、macOS或Linux的电脑或服务器。采集几万个页面时,租用的VPS更方便,但第一个语料库用笔记本就够了。
- 至少8GB内存。大语料库的去重很吃内存。
- 足够的磁盘空间:至少5GB。原始HTML比纯文本大5-10倍,而我们会两者都存。
- 稳定的网络。代理会增加延迟,所以慢速的家庭宽带会明显拖长采集时间。
需要安装什么
- Python 3.11或更新版本。从官网下载安装程序,Windows安装时勾选“Add Python to PATH”。在终端里验证:
python --version。应显示类似Python 3.12.x的行。 - 虚拟环境。创建项目文件夹,比如
rag-corpus,进入后执行python -m venv venv。激活:Windows上用venv\Scripts\activate,macOS和Linux上用source venv/bin/activate。终端行首会出现(venv)。 - 库。一条命令装好:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm。安装需要1-3分钟。 - 带代码高亮的文本编辑器:VS Code、PyCharm Community或任何其他编辑器。
代理访问权限
打开你代理服务的控制面板。在已购买的移动代理信息卡里找到四个值:主机(IP地址或域名)、端口(HTTP端口和SOCKS5端口)、用户名和密码。另外复制换IP链接:这是一个URL,只要发GET请求,代理就会从运营商那里拿到新地址。把所有这些记到项目文件夹的.env文件里,不要直接写进代码。
文件夹结构
在项目里创建以下文件夹:raw存放原始页面,clean存放提取的文本,corpus存放最终文件,logs存放日志。一开始空文件夹是正常的。
备份
语料库收集很耗时,丢了很心疼。跟自己约定一条规则:raw文件夹永远不覆写,只追加。每个大阶段后归档结果:Linux和macOS上tar -czf raw_backup_2026-03-01.tar.gz raw/,或者用Windows自带的压缩工具。如果过滤器出错删多了,随时可以回到原始数据,不用重新采集。
建议:立刻建一个sources.md文件,把每个决定都记下来:收了哪些网站,排除了哪些栏目,为什么。一个月后助手开始回答得奇怪时,这个文件能救你一个晚上。
基础概念,用大白话说
如果你是第一次为RAG系统收集数据,有几个术语会在每一步出现。简短说一下。
什么是RAG,以及为什么语料库比模型更重要
RAG(Retrieval-Augmented Generation,检索增强生成)是一种方法,语言模型在回答前会先从你的知识库中取一批片段。模型并不“知道”你的文档,它读的是检索到的片段,然后据此回答。由此得出一个简单规则:如果知识库里有垃圾,检索迟早会把它捞出来,答案就会依据“订阅我们的邮件”这句话,而不是操作说明。所以语料库收集这一步不能跳过。
语料库、文档、元数据
语料库是进入RAG系统的全部文本集合。文档是一个语义单元:一篇文章、一个帮助页面、一份PDF说明书、一张商品卡片。元数据是文档的护照:从哪来、什么时候采集、什么语言、作者是谁、属于哪个栏目。没有元数据,你既没法更新语料库,也没法向用户解释答案的来源,更没法过滤过时内容。
移动代理,以及为什么采集时需要它
移动代理是一种中介服务器,让你的请求通过蜂窝运营商的IP地址访问互联网。对语料库采集来说,它解决三个实际问题。第一:分散负载。与其从一个地址反复敲同一个网站,不如从不同地址访问,每个来源看到的都是平静、稀疏的流量。第二:地理位置。很多网站会根据地区显示不同的内容、价格和库存,而目标城市的移动代理能给你客户看到的那一版页面。第三:长会话的稳定性。通过链接轮换IP让你可以连续采集数小时,而不依赖单一地址。
轮换就是换IP地址。它可以是按计划(每N分钟)或按需(需要时调用链接)。采集语料库时后者更方便:换了来源就换地址。
什么算垃圾
在语料库语境下,垃圾是指所有不携带你所在领域知识、却占用索引空间并损害检索的内容:
- 导航、菜单、页脚、“面包屑”、订阅表单;
- 同一文本在不同地址上的精确和近似重复;
- 占位页面:“页面未找到”“商品已售罄”“正在维护”;
- 如果语料库是单语言的,其他语言的文本;
- 被截断的页面,代理或网站只返回了一半HTML;
- 你无权使用的他人内容。
法律框架
只采集无需登录即可访问的公开数据,以及你自己的文档。尊重robots.txt:这是网站关于哪些栏目可以自动抓取的规则清单。不要采集第三方的个人数据:带电话的姓名、地址、账号。如果是基于自己内部文档构建语料库,确保你有权使用它们。本指南中的代理是诚实分散采集的工具,不是做来源禁止之事的借口。
第1步:确定语料库边界,绘制来源地图
本阶段目标:得到一个来源清单文件,其中每个来源都写明了收哪些URL、排除哪些、抓取深度多少、每分钟允许多少请求。
语料库变脏最常见的原因根本不是技术错误,而是缺乏边界。有人一上来就“整站采集”,拿到4万个页面,其中真正相关的只有800个,然后花一周清理。我们反过来做:先画地图,再采集。
操作步骤
- 明确你的RAG系统应该回答哪些问题。写下20-30个真实的用户问题。比如代理服务的知识库:“怎么通过链接换IP”“为什么代理响应慢”“支持哪些端口”。这些问题将成为你验证阶段的测试集。
- 对每个问题记录答案在哪里。帮助中心、文档、博客文章、PDF规范、商品页面。不在这份清单里的,都不进语料库。
- 在浏览器里打开每个来源,研究地址结构。通常有用内容在清晰的前缀下:
/help/、/docs/、/blog/、/faq/。垃圾在另一些下:/tag/、/search?、/cart/、/author/、形如?page=的分页页。 - 检查来源的robots.txt。打开
https://域名/robots.txt。找到Disallow行:这些路径无条件排除。如果那里还有Crawl-delay,记下来作为请求之间的最小间隔。 - 找到站点地图。它常常在robots.txt里以
Sitemap:行标出,或者位于/sitemap.xml。站点地图是现成的地址清单,能让你免去递归跟踪链接以及随之而来的垃圾。 - 确定负载。对小型网站,每分钟不超过10-15次请求。对带CDN的大型门户,可达30次。如果拿不准,选更少的:语料库不着急。
- 确定地理范围。如果内容依赖地区(价格、配送、库存),决定你的采集器应该“从”哪个城市看,并选择相应的移动代理。
- 把所有内容整理进
sources.json文件。
一个来源的示例记录:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]字段rotate_every设定采集器每多少个请求后去调用换IP链接。保存到真实JSON文件时把单引号换成双引号,这里只是为了一目了然。
注意:不要把只有登录账号后才能看到有用内容的网站加入来源。第一,这违反大多数平台的服务条款。第二,这样的语料库无法合法更新和在公司内部传播。
建议:为自己的文档单独建一个来源:一个放PDF、DOCX以及从你的CRM或知识库导出的文件夹。它们不需要通过代理下载,但会用与网页相同的流水线处理和清洗。
检查:你有一个sources.json文件,其中每个来源都有包含前缀、排除模式、请求限制和语言。从站点地图里随机打开5个符合筛选条件的地址,确认每个都有实质性文本,而不是链接目录。
可能的问题
- 网站没有站点地图。从几个目录页手动收集地址清单,或者只在允许的前缀内做深度2的简单链接跟踪。
- 站点地图包含10万个地址。先按前缀过滤,然后取200个地址的样本,采集并评估质量,再决定是否全部跑。
- 有用内容分散在不同域名。在
sources.json里为每个域名建一条记录,各有自己的限制和地理设置。
第2步:接入移动代理,验证请求确实走了代理
本阶段目标:确认脚本确实通过移动代理访问,轮换有效,延迟在可接受范围内。
操作步骤
- 创建
.env文件,放在项目根目录,填入控制面板里的值:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxx每个值单独一行。如果使用版本控制,把.env加入.gitignore。
- 创建
proxy_check.py文件,内容如下:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP без прокси:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP через прокси:', ip1, 'за', round(time.time() - t0, 2), 'сек') print('Меняем IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP после ротации:', ip2) print('Ротация сработала:', ip1 != ip2)先安装pip install python-dotenv。真实文件里每行代码各占一行。
- 运行:
python proxy_check.py。 - 看输出。第一个IP应该是你家里或服务器的。第二个应该不同,且属于蜂窝运营商。第三个应该不同于第二个,最后一行应显示
True。 - 测延迟。如果通过代理的请求超过5-6秒,采集会很慢。检查所选的代理是否在地理上靠近目标网站,或者联系服务商支持。
- 测SOCKS5作为备选。如果HTTP端口结果不稳定,把
proxy_url里的http://换成socks5h://,端口换成控制面板里的SOCKS5端口。需要pip install requests[socks]。后缀h很重要:它让代理自己解析域名。
注意:不要比你套餐允许的频率更频繁地轮换IP。大多数移动代理都有最小换IP间隔,通常从30秒到2分钟。对轮换链接请求太频繁,要么被忽略,要么会暂时封禁该功能。
建议:连续测五次延迟,记下中位数。这个数字下一步会用到,用来正确设置超时:超时应约为典型延迟的4-5倍。
检查:脚本输出三个不同的IP地址,显示Ротация сработала: True,通过代理的典型延迟不超过3-4秒。如果都满足,代理就准备好了。
可能的问题
- 错误407 Proxy Authentication Required。检查用户名和密码,确认没有多余空格。如果密码里有
@或:符号,用urllib.parse.quote编码。 - 错误Connection refused或超时。代理可能绑定了你的白名单IP。进控制面板把当前服务器地址加入允许列表,或者切换到用户名密码认证。
- 轮换后IP没变。把轮换链接请求后的等待延长到15-20秒。有些运营商不是立刻分配新地址。
- SSL错误。用
pip install -U certifi更新certifi库。不要用verify=False参数关闭证书验证:这不安全。
第3步:编写稳健的采集器,带限制、轮换和日志
本阶段目标:得到一个脚本,遍历站点地图里的地址,遵守robots.txt和频率限制,通过代理访问,按计划换IP,保存原始HTML,并留下能看清每一次请求的日志。
这里要理解一个理念。好的RAG语料库采集器是慢的、礼貌的、日志上偏执般详细的。快的激进爬虫会给你一堆截断页面和429错误,然后你搞不清哪些是垃圾。
操作步骤
- 创建
fetch.py文件。脚本结构:加载配置、解析站点地图、过滤地址、带暂停的请求循环、保存结果。 - 加载站点地图并过滤地址。站点地图是XML,每个地址在
loc标签里。用标准xml.etree.ElementTree解析。只保留以include_prefixes开头且不含任何exclude_patterns的地址。把结果存到urls_help_center.txt,用眼睛看一遍。 - 接入robots.txt检查。用
urllib.robotparser.RobotFileParser:每个域名加载一次,每次请求前问can_fetch(user_agent, url)。禁止的地址跳过,并在日志里标robots_disallow。 - 设置诚实的User-Agent。例如:
CorpusCollector/1.0 (+contact: data@yourcompany.ru)。网站主应该知道是谁来了、怎么联系。这不仅是道德,也是实践:清晰的代理更少被自动限制。 - 实现暂停。从
rate_per_minute算出基础暂停:60 / rate_per_minute秒。加上20-40%的随机成分,让请求不像节拍器。如果robots.txt里有Crawl-delay,取两者中的最大值。 - 实现轮换。计数请求,当计数器达到
rotate_every时,调用换IP链接,等10秒,重置计数器。切换到下一个来源时也应轮换。 - 处理响应。200保存。301和302由
requests自己处理,但要记录最终地址:去重时会用到。404写日志并跳过。429或503表示“太快了”:暂停5分钟,把基础暂停加1.5倍,重试一次。如果重试没用,跳过继续。 - 保存原始HTML连同护照。每个页面往
raw/help_center.jsonl写一行。
保存和循环的关键代码片段:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))注意len(html) > 2000这个条件。有实质内容的页面几乎从不短于两千字节HTML。这是第一个、最粗的垃圾过滤器,它在入口就挡掉空响应和占位页。
- 先在小样本上运行。第一次跑50个地址。看日志,在浏览器里打开几个保存的HTML。确认就是那些页面。
- 跑完整采集。在服务器上用
nohup python fetch.py &或screen,让进程在关闭终端后仍存活。以每分钟12次请求采集3000个页面大约需要4-5小时。
注意:不要通过同一个代理对同一网站并行跑多个采集器副本。IP轮换不能替代对来源服务器负载的限制。想加速就按不同网站并行,而不是同一个网站。
建议:在日志里记录每次请求所用的代理IP。清理阶段发现一批截断页面时,你按IP和时间立刻能看出是不是某个会话出了问题,只需重采那一个。
建议:给采集器加断点续跑:启动前读取raw/*.jsonl里已采集的地址并跳过。这样断网或服务器重启不会让你从零开始。
检查:raw文件夹里有JSONL文件,行数接近日志中状态200的地址数,随机抽一行包含url、fetched_at、proxy_ip字段和完整HTML。日志中错误和跳过的比例不超过5%。
可能的问题
- 大量429响应。你对这个网站太快了。把
rate_per_minute减半,增大rotate_every,让轮换不像从新地址来的突发。 - 页面返回空,但状态是200。内容由JavaScript渲染。这类来源需要浏览器渲染,进阶板块会讲。先给它们在
sources.json里标needs_js: true。 - 采集在跑,但非常慢。检查第2步的代理延迟,确认典型延迟2秒时超时没设成120秒,否则每个卡住的页面要吃掉两分钟。
- 脚本因编码崩溃。用
r.text并检查r.encoding;如果网站返回的编码不对,读取前设置r.encoding = r.apparent_encoding。
第4步:从HTML和文档中提取纯文本
本阶段目标:把原始HTML和文件转成纯文本,只保留页面主内容:标题、段落、列表、表格,去掉菜单、页脚、广告插块和组件。
这是语料库质量诞生或死亡的时刻。天真的“删掉所有标签”做法会在文本里留下菜单项、“购买”按钮、cookie横幅文字和相关文章列表。这些后来都会在RAG系统的回答里冒出来。
网页操作步骤
- 创建
extract.py文件。它逐行读raw/*.jsonl,把结果写到clean/*.jsonl。 - 使用
trafilatura库提取正文。它经过训练,能找到页面内容区并丢弃模板区块。
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- 参数
favor_precision=True让库更严格:它宁愿丢掉一段文本,也不愿带上菜单。对RAG语料库这是正确选择。如果发现丢失了需要的块,比如规格表,对特定来源切换到favor_recall=True。 - 加一个备用方法。如果
trafilatura返回None或文本短于200字符,尝试按你手动找到的CSS选择器提取内容:在浏览器里打开页面,按F12,找到正文块,复制它的类名,比如article-body。用BeautifulSoup只剪出这个块。把选择器写进sources.json的content_selector。 - 规范化文本。把不换行空格换成普通空格,把三个及以上换行合并成两个,去掉行首行尾空格。不要改大小写,不要删标点:这会损害检索。
- 连同原始元数据一起保存。从原始记录复制
url、final_url、fetched_at,加上sources.json里的source、提取出来的字段和文本字符长度。
PDF和DOCX操作步骤
- PDF。用
pypdf:打开文件,遍历页面,调用page.extract_text()并合并。为每个片段保存页码:这是宝贵的元数据,用户能据此在原文里找到位置。如果返回空文本,说明PDF是扫描件而非文本:把这类文件放到单独文件夹,识别不在本指南范围内。 - DOCX。用
python-docx:遍历document.paragraphs和document.tables。Word里的标题有Heading 1、Heading 2样式:把它们保存为带标记的单独行,后面切分文档时很方便。 - 去掉页眉页脚。PDF说明书里每页都重复公司名、版本号和“第3页,共40页”。收集文档所有行,找出在超过一半页面上重复的行,删掉。
注意:不要为了好看删掉表格。在说明书、资费表和规格里,正是表格包含具体问题的答案:“限额多少”“多少钱”“哪个端口”。逐行保存它们,用制表符或竖线分隔单元格。
建议:提取后随机取20个文档完整读一遍。不是扫一眼,是认真读。这样一次复查发现的系统性问题比任何自动过滤器都多:比如你会看到所有博客页面末尾都粘了一个“延伸阅读”块,带三个标题。
检查:clean文件夹里有JSONL文件。记录数不低于原始页面数的80%。随机抽10条,文本以标题或文章首段开头,而不是菜单项,以最后一个有实质内容的段落结尾,而不是“版权所有”签名。
可能的问题
- 提取到的文本太少。网站排版非标准。加上
content_selector和通过BeautifulSoup的备用路径。 - 文本里还留着按钮和菜单项。开启
favor_precision,对顽固情况加一个停用字符串列表:像“分享”“阅读更多”“回到顶部”这样的短行,如果单独成行就删掉。 - PDF输出文本倒序或单词断裂。用
pdfplumber替代pypdf,它对分栏处理更好。
第5步:过滤垃圾:去重、模板、质量、语言
本阶段目标:筛掉重复、占位页、模板区块、外语文本以及过短或损坏的文档,只留下携带知识的内容。
即使提取得很仔细,语料库里仍会留下15%到40%的垃圾。这很正常。不正常的是让它进入索引。
操作步骤
- 创建
filter.py文件,读clean/*.jsonl,依次应用过滤器,通过的文档写入corpus/filtered.jsonl,被筛掉的写入corpus/rejected.jsonl并注明原因。 - 过滤器1:最小长度。短于300字符的文档几乎都是占位页、预告或提取错误。以
too_short原因筛掉。商品卡片阈值可降到150。 - 过滤器2:占位页停用短语。列一份能看出页面为空的短语清单:“页面未找到”“商品缺货”“访问受限”“请启用JavaScript”“正在技术维护”。如果这类短语出现在前300字符内且全文短于1500,以
placeholder原因筛掉。 - 过滤器3:语言。对前1000字符用
langdetect.detect。如果语言与来源指定不符,以wrong_lang原因筛掉。注意短文本上检测器会出错,所以要在长度过滤之后再用。 - 过滤器4:精确重复。规范化文本:小写、合并空格、去掉标点。计算
sha1。如果哈希已出现,以exact_dup原因筛掉,并保存指向原件的链接。精确重复的典型来源:同一页面的http和https版本、带和不带www、带和不带?utm_source参数、以及打印页。 - 过滤器5:近似重复。这里需要
datasketch库的MinHash。把规范化文本按5个词的shingle切分,构建128个排列的MinHash,放入阈值0.85的MinHashLSH。已有相似邻居在索引里的文档,以near_dup原因筛掉。这样能去掉不同日期的同一篇文章、只差颜色的商品页和再版的新闻。
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- 过滤器6:模板行。收集同一来源所有文档的所有行,统计每行出现在多少比例的文档中。出现在超过30%文档中且短于200字符的行就是模板:免责声明、签名、订阅号召。把它们从所有文档里删掉。这不是筛掉文档,而是文档内部清理。
- 过滤器7:文本质量。算一些简单指标:字母在全部字符中的比例应高于0.6;平均词长3到12;文章中以句号结尾的行比例高于0.3。超出这些范围的文档通常是代码表、转储或损坏的提取。以
low_quality原因筛掉,但一定要肉眼看看被筛掉的:技术文档的阈值需要放宽。 - 过滤器8:截断页面。把原始记录里的
html_len与来源中位数比较。如果HTML短于中位数的30%,且文本在句子中间没有句号就断了,这是截断响应。原因truncated。把这些地址记到recollect.txt,通过第3步的代理重采。 - 运行过滤并查看报告。脚本应输出一张表:输入多少文档,每个原因筛掉多少,剩多少。
注意:过滤过程中绝不要删除clean和raw里的文件。过滤器只写新文件。如果MinHash阈值太激进,你丢了40%有用文档,只需改个数字再跑一遍,两分钟的事。
建议:近似重复的0.85阈值适合文章和帮助文档。对同一品牌仅尺寸或容量不同的商品卡片,它会把它们并成一个。提前决定你的RAG系统是否需要所有变体,要么把阈值提到0.95,要么在提取阶段就把变体合并成一个带差异表的文档。
建议:被筛掉的文档不是废料,是调试材料。每周打开rejected.jsonl,按原因过滤,看10条随机记录。如果low_quality里经常出现有用的资费表,阈值就该改。
检查:过滤报告显示合理画面:总筛掉10%到40%,其中重复占显著比例,truncated原因不超过2-3%。filtered.jsonl里没有两个规范化文本相同的文档,随机抽10条看起来是完整的文章或文档章节。
可能的问题
- 筛掉超过60%。很可能是质量阈值太严,或规范化出错导致所有文本变得相似。输出20条随机被筛掉的,找出系统性原因。
- MinHash跑得极慢。语料库超过10万文档时,把
num_perm降到64,或按来源分别计算。 - 语言检测器把俄语文本标成保加利亚语或马其顿语。在专有名词多的短片段上会这样。对前2000字符检测,并把近缘语言组里的任何一种视为匹配。
第6步:标注元数据,组装最终语料库
本阶段目标:得到一个统一的corpus/corpus_v1.jsonl文件,每个文档有稳定标识符、完整元数据集,可直接交给索引流水线。
元数据是语料库与一堆文本的区别所在。它们让你能更新单个来源、向用户解释答案来源、按日期和栏目过滤,最重要的是,不用一个月后重做全部工作。
操作步骤
- 定义文档模式。写在
schema.md里,没有新版本不要改。推荐最低字段:
doc_id:稳定标识符,比如final_url的sha1,这样重采时文档得到同样的id;source:sources.json里的来源名;url和final_url;title;section:网站栏目,由前缀后路径的第一个段算出,比如help/proxies;lang;published_at:发布日期,如果提取到的话;fetched_at:采集日期;geo:采集所用代理的地区;text;text_len、text_sha1;corpus_version:比如v1。
- 算出栏目。用
urllib.parse.urlparse解析final_url,取路径,去掉来源前缀,留一到两段。栏目以后会成为RAG系统里的过滤器:用户问付款,检索优先走billing栏目。 - 规范化日期。所有日期转成UTC的ISO 8601。如果找不到发布日期,把字段留空,不要填采集日期:这是两回事,过滤过时材料时混淆很危险。
- 把标题加进文本。如果
text不以title开头,把标题作为第一行插入。标题携带对检索重要的关键词。 - 排序并写出。按
source和final_url排序文档,写入corpus/corpus_v1.jsonl。旁边放corpus/manifest_v1.json,记录各来源文档数、采集日期、模式版本和过滤参数。 - 做归档。把
corpus、sources.json、schema.md和logs文件夹打包。这个压缩包就是你语料库的可复现版本。
建议:把个人数据完全挡在语料库之外。如果帮助文本里出现“伊万·彼得罗夫,+7 900...”这样的例子,在语料库组装阶段就替换成占位符。RAG系统不应该能吐出别人的电话,即使它曾公开可见。
检查:corpus_v1.jsonl能打开,每行是符合模式字段的合法JSON,所有文档doc_id唯一,source、lang、fetched_at、text都填了。manifest_v1.json包含与行数一致的汇总。
可能的问题
- 不同地址指向同一文档却给出不同doc_id。用重定向后的
final_url算id,去掉查询参数和末尾斜杠。 - 日期提取格式不一。对俄语来源用
dateutil.parser.parse并带dayfirst=True参数。
结果验证:检查清单和语料库测试
语料库收集完了。在拿去索引之前,我们把它当产品而不是文件来检查。
检查清单
- 有
sources.json,每个来源都有边界和限制。 - 所有请求都走了移动代理,日志里每次请求都有
proxy_ip。 - 日志中采集错误比例不超过5%,429响应少于1%。
- 从原始页面提取出至少80%的文档。
- 过滤筛掉10%到40%,所有筛除原因都有命名。
- 语料库里没有规范化文本的精确重复。
- 每个文档都填了必填元数据。
- 有包含原始数据、语料库、日志和设置的归档。
如何测试
- 用第1步的问题测试。拿出你的20-30个问题。对每个问题用简单子串搜索或
grep在语料库里找包含答案的文档。目标:至少90%的问题有覆盖。如果问题没覆盖,在浏览器里找到有答案的页面,查清为什么没进来:不在站点地图、被过滤器筛掉、文本被截断。 - 垃圾测试。在语料库里找“订阅”“购物车”“cookie”“版权所有”“延伸阅读”这些字符串。每次出现都是嫌疑。如果它们是正文的一部分,出现几个可以接受;出现几十次说明模板过滤器需要改进。
- 截断测试。统计文本不以句号、感叹号、问号或右括号结尾的文档。应少于5%。其余的肉眼看看。
- 分布测试。画文档长度直方图。健康的帮助中心或博客语料库在2-8千字符处有峰和长尾。在最小阈值附近有陡峰说明占位页漏过了。
- 地理测试。如果内容依赖地区,打开5个带价格或库存的页面,与目标城市的人看到的内容比较。不一致说明代理选错了地区,或网站不是按IP而是按cookie判断地区。
成功指标
如果测试问题覆盖率高于90%,带垃圾特征的文档比例低于3%,且manifest能完整复现组装过程,语料库就准备好了。只有在这之后,语料库才交给RAG系统的索引流水线。
为RAG收集语料库时的常见错误与解决
问题:助手回答里出现菜单项和订阅号召。原因:文本提取工作在完整模式而非精确模式,模板过滤器没跑。解决:开启favor_precision,实现删除在来源超过30%文档中重复的行,从raw重做clean而不重新下载。
问题:助手依据旧版说明回答。原因:语料库里同时有文章的新旧版本,近似重复没筛掉或阈值太高。解决:对带版本性的来源把MinHash阈值降到0.8,冲突时保留published_at更晚的文档。
问题:部分页面采集为空,状态200。原因:内容由浏览器端JavaScript构建。解决:给来源标needs_js,用进阶板块的Playwright渲染,或者找网站的API或RSS,那里内容现成。
问题:采集在429和503错误上停住。原因:请求频率太高,把IP轮换当成了降低负载的替代。解决:把频率降到每分钟6-8次,增大暂停的随机幅度,首次429时暂停5-10分钟。记住负载限制是对来源的尊重,不是地址数量问题。
问题:轮换后网站显示其他地区的内容。原因:移动代理给了其他城市的IP,或网站根据上一会话的cookie判断地区。解决:在代理面板固定所需地区,每次轮换后重置requests会话,避免cookie被带过去。
问题:语料库建好了,但问题覆盖率只有60%。原因:来源边界定得太窄,有用页面被前缀筛掉了。解决:拿未覆盖的问题,在浏览器里找答案,看它们的地址,扩展include_prefixes。
问题:去重吞掉了仅规格不同的商品卡片。原因:对同质文本近似重复阈值太低。解决:对目录类来源把阈值提到0.95,或在提取阶段把同一商品的变体合并成一个文档。
问题:PDF文本变成没有段落的一整行。原因:pypdf丢失了排版。解决:改用pdfplumber或pymupdf,按双换行和缩进恢复段落。
问题:语料库里混进了个人数据。原因:没有脱敏环节。解决:写入语料库前加一步,用简单模板查找电话、邮箱和姓名并替换成占位符;有疑问的文档送人工检查。
进阶用户的高级功能
如果基础流水线跑通了,可以往这些方向发展。
通过代理渲染JavaScript页面
安装pip install playwright和playwright install chromium。用参数proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS}启动浏览器。通过page.wait_for_selector等待主内容选择器,而不是固定秒数。取page.content()存成同样的raw格式,后续步骤不变。渲染比普通请求慢5-10倍,所以只对带needs_js标记的来源用,频率降到每分钟3-5页。
增量更新语料库
在清单里保存每个文档的text_sha1。下次采集时下载页面,但只对HTML哈希变化或距上次采集超过30天的做提取和过滤。用If-Modified-Since和ETag头:很多网站会返回304无响应体,省代理流量。每次更新得到新版本语料库:v2、v3,旧归档不删。
多地区语料库
如果企业有分支机构,且来源内容依赖城市,准备几个不同地理的移动代理。从每个地区采同一页面,在元数据里保存geo,只在地区内去重。RAG系统以后能依据真实的地区版页面回答“喀山配送2天,新西伯利亚4天”。
用质量评分代替硬阈值
不按阈值筛掉,而是用同样指标给每个文档算0到1的质量分:长度、字母比例、完整句比例、行重复度。把分数存进元数据。这样索引流水线能自己决定取什么,检索能把可靠文档排更高。
语义去重
MinHash抓词汇重复。用不同词转述的同一说明它抓不到。要抓这些,计算文档嵌入,找余弦相似度高于0.95的对。这已经接近索引阶段,所以这里只是提一下:决定在哪划线,不要做重复工作。
采集监控
从日志里输出指标:每分钟请求数、200码比例、平均延迟、轮换次数。用matplotlib做简单仪表盘或每10分钟在终端打一张表,能在你早上发现500个空页面前更早看到退化。
FAQ:关于语料库收集的常见问题
收集语料库一定要用移动代理吗?对自己文档和小型来源不是必须。当来源多、采集要跑几小时、地区版内容重要,或你不想从一个地址给网站造成明显负载时,代理才变得必要。
采集时多久换一次IP?参考:每30-60次请求,或切换到另一来源时。不需要更频繁:轮换的意义在于分散负载和会话稳定,而不是频率本身。频繁轮换而不降低总速度,并不能减小负载。
可用的RAG系统需要多少文档?单个产品的助手常常200-500个高质量文档就够。宽泛行业需要几千个。质量比数量重要:500篇干净文章比2万篇带垃圾的给出更好的答案。
能收集社交媒体和电商平台吗?只能收平台规则和robots.txt允许范围内的公开页面,不带个人数据。很多平台有官方API获取内容,从它们开始。
图片和视频怎么办?在文本语料库范围内,只保存页面上有的图注、alt文本和字幕(如果有)。文件本身不进语料库。
为什么不能直接用下载工具整站下载?可以,但你会得到几万个没有元数据、带重复、带服务页、没日志的文件。然后你得反向做本指南的所有步骤,只是更难。
怎么知道过滤器没删掉需要的?按每个原因看rejected.jsonl,抽10-20条。并检查测试问题覆盖率:如果答案没了,去被筛掉的那里找。
这个阶段需要把文档切成块吗?不需要。分成片段是索引的一部分,取决于嵌入模型和上下文大小。语料库的任务是给出带元数据和标题标注的完整文档,让分块器能有意义地切。
怎么更新语料库而不重采全部?保存哈希,用If-Modified-Since条件请求,给语料库做版本。详见进阶板块。
如果网站robots.txt禁止自动采集怎么办?尊重禁令。联系网站主,他常常会给导出、API或授权。违背来源规则建立的语料库会给整个项目带来风险。
结语:做了什么,往哪走
你走完了从想法到现成语料库的全程。确定了边界,绘制了带限制和地理的来源地图。接入了移动代理,确认轮换有效。写了礼貌的采集器,遵守robots.txt、分散负载、保留详细日志。从HTML、PDF和DOCX中提取了纯文本。筛掉了重复、占位页、模板和损坏页面,并给每个原因命名。标注了元数据,组装了带清单的版本化语料库。用真实问题验证了它。
主要成果不是硬盘上的文件,而是可复现的流程。一个月后你再跑一次,几小时就能拿到更新后的语料库,而不是一周。当RAG系统开始回答得奇怪时,你会清楚知道去哪找原因:采集日志、过滤报告或清单。
接下来做什么。把corpus_v1.jsonl交给索引流水线:分块、嵌入、向量数据库。博客的相邻文章有讲。设置采集器按计划定期运行并增量更新。随着未覆盖问题增多,扩展来源地图。如果企业是地区性的,加上所需城市的代理,采集地区版内容。
往哪发展。掌握复杂网站的浏览器渲染、用文档质量评分代替硬阈值、语义去重和采集监控。这些每一步对回答质量的提升都超过换模型。干净数据是你手上最便宜的RAG系统改进。采集顺利。