从地图、电商平台和点评网站采集评论:新手分步指南
引言:你最终会得到什么
评论是了解产品、商店或场所最真实的信息来源。人们在评论中会主动讲述什么让他们满意、什么出了问题、为什么他们不会再回来,以及他们会给朋友什么建议。问题在于,评论分散在几十个平台上:地图、电商平台、点评网站、行业目录。手动阅读这些评论需要数周时间——这不现实。因此,我们需要系统化的采集。
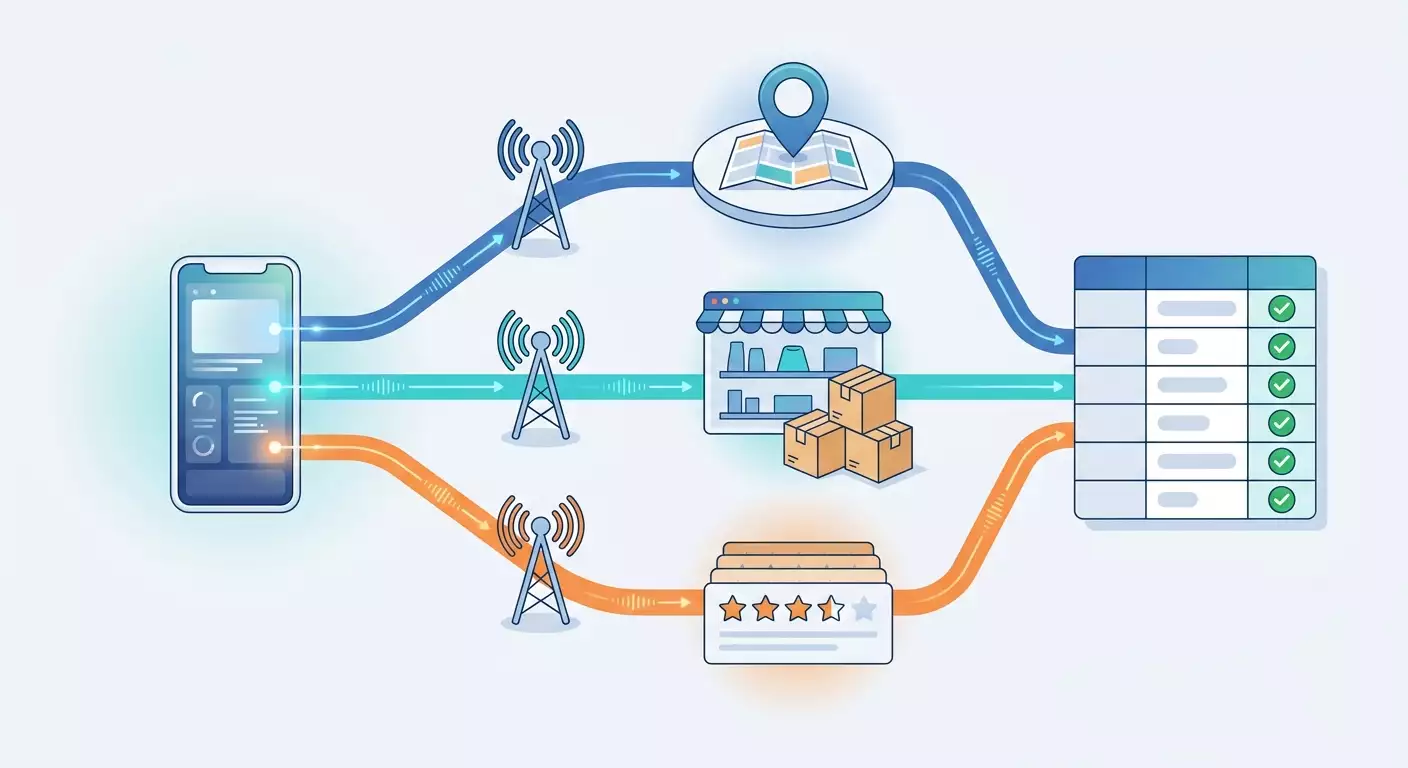
在本指南中,我们将讲解如何从三类平台采集评论:地图服务(Yandex地图、2GIS、Google Maps)、电商平台(Wildberries、Ozon、Yandex Market)和点评网站(Otzovik、iRecommend、Flamp、Zoon)。你将走完整个流程:从明确任务、设计表格,到可用的脚本、连接移动代理和数据清洗。
你将获得什么:
- 了解每类平台上的评论在哪里、以什么形式存在。
- 一套现成的评论表结构,可以导入Excel、Google表格或数据库。
- 一个可用的Python评论解析器,能够通过移动代理访问,不会给平台造成过大负担。
- 了解官方导出途径:个人后台、合作方API、导出功能。
- 一份采集数据质量检查清单和常见错误列表。
本指南适合谁。本指南面向营销人员、企业主、套利从业者和初级开发者。如果你从未写过代码——别担心。部分场景完全不需要编程,脚本部分我们会给出可直接复制并替换自己参数的现成代码片段。对于已经会编程的读者,文末有专门的进阶技巧板块。
需要提前了解什么。只要会使用浏览器、安装软件和处理表格就足够了。了解代理的基本概念会有帮助,但我们会在过程中解释关键术语。
本材料的重要边界。这里只讨论评论作为一种独立数据类型:文本、评分、日期、作者、商家回复。我们不涉及商品目录、价格和库存的解析——那是另一个话题,有其自身特点。如果你需要价格,本指南不适合你;如果你需要客户反馈——你来对地方了。
需要多少时间。准备环境大约需要30-40分钟。设计结构和从第一个平台进行首次采集大约需要一小时。完整走完三类平台的采集,包括配置代理和数据清洗,需要3-4小时。之后采集只需几分钟,因为脚本可以重复运行。
前期准备:工具和访问权限
在采集评论之前,需要准备好工作环境。以下是所需清单。不要跳过这一节,即使有些内容看起来显而易见:后续步骤中一半的问题都源于环境准备不足。
系统要求
- Windows 10/11、macOS或Linux电脑。近6-7年的任何笔记本电脑都可以。
- 至少4GB内存。采集数万条评论建议8GB。
- 稳定的网络。采集本身不需要高速度,但连接中断会导致数据缺失。
- 约2GB磁盘可用空间,用于Python、库和结果。
需要安装什么
- Python 3.11或更高版本。从Python官网下载安装程序。在Windows上安装时,务必在安装程序第一个界面勾选「Add Python to PATH」。没有它,终端中的python命令将无法运行。
- 代码编辑器。VS Code即可——免费且易于理解。安装后打开一次,确认它能启动。
- Python库。打开终端(Windows上是PowerShell,macOS上是Terminal),执行命令:
pip install requests pandas openpyxl。等待出现Successfully installed消息。这需要1-2分钟。 - Chrome或Yandex浏览器。用于通过开发者工具研究平台。它们已内置,无需单独安装。
- 表格编辑器。Excel、LibreOffice Calc或Google表格——用于查看结果。
需要哪些访问权限
- 移动代理访问权限。在mobileproxy.space注册,选择所需地区的套餐(俄罗斯平台选俄罗斯运营商),获取连接数据:主机、端口、登录名、密码。同时,在个人后台找到更换IP的链接——在轮换步骤中会用到。
- 平台个人后台访问权限,如果你采集的是关于自己企业的评论。包括Yandex Business、Wildberries卖家后台、Ozon Seller、Yandex Market卖家版、Google Business Profile。从中官方导出的数据是最干净的来源。
- 项目文件夹。在磁盘上创建一个文件夹,例如reviews_project,里面建两个子文件夹:raw用于原始数据,clean用于处理后的数据。这是你的保险:原始数据永远不会被覆盖。
建议:立即在项目文件夹中创建一个文本文件sources.txt,记录每个采集评论的地址及日期。一个月后你不会记得某张表是从哪里来的,而这样的日志能消除所有疑问。
备份
这里的备份不是指系统,而是指数据。养成习惯:每次运行解析器都将结果写入新文件,文件名带日期,例如reviews_ozon_2026-03-14.csv。旧文件至少一个月内不要删除。如果新采集因平台变化而损坏,你还有可用的版本。
检查:在终端输入python --version——应显示3.11或更高版本。然后输入python -c 'import requests, pandas; print(1)'——应无错误地输出数字1。如果两条命令都正常执行,环境就准备好了。
基础概念:评论的结构,以及为什么采集方式与商品目录不同
在启动任何东西之前,重要的是理解你在处理什么类型的数据。评论不仅仅是文本。它是一条包含多个字段的结构化记录,有其自身特点,这些特点在商品卡片中是不存在的。
用通俗语言解释关键术语
- 评论(review)——用户留下的关于对象(商品、商店、场所)的记录。通常包含评分、文本、日期、作者姓名,有时还有照片。
- 评论对象——评论所指向的事物:电商平台上的商品卡片、地图上的机构、点评网站上的公司。每个对象在平台上都有唯一标识符。
- 商家回复——企业代表在评论下的回复。对于分析支持质量来说,这是一个单独的字段。
- 分页——将评论分成页面或批次。平台每次返回比如20条评论,需要请求后续批次。
- 评论解析器——自动遍历所需对象、提取评论并存入表格的程序。可以是简单脚本,也可以是现成服务。
- 去重——删除重复项。同一条评论可能因分页或重复运行而两次进入样本。
- 移动代理——使用移动运营商IP地址的中间服务器。通过它们发出的请求看起来像普通智能手机用户的流量。平台对这类流量更宽容,因为一个移动IP背后有数百个真实用户。
- IP轮换——按设定间隔或按需更换代理地址。有助于分散负载,避免从单一地址产生异常请求流。
评论采集与目录采集的区别
商品目录相对静态:卡片存在,有价格和属性。评论则不同,这影响整个流程。
- 评论不断新增。需要能够只增量抓取新评论,而不是每次全部重新抓取。
- 评论单独加载。在大多数平台上,评论文本不在页面本身中,而是通过后台单独请求获取。这是好消息:这类请求返回现成的JSON,不需要解析HTML。
- 评论包含个人数据。作者姓名、头像,有时还有城市。这有法律要求——见下文。
- 评论可排序和筛选。默认情况下平台可能显示「有用」或「最新」。如果不固定排序,不同运行会采集到不同的集合。
- 评论会被编辑和删除。审核会移除部分记录,作者会更改评分。采集日期成为重要字段。
需要了解的法律框架
注意:评论包含姓名和其他关于个人的信息。在采集和存储时,请遵守联邦第152-FZ号个人数据法的要求:不要采集超出任务所需的数据,在分析不需要姓名的地方对作者进行匿名化处理,不要将数据库转交给第三方。同时阅读平台的用户协议和robots.txt文件:一些服务明确描述了允许的自动访问模式。如果你的任务有官方API或后台导出——始终从那里开始。
另一个原则是尊重性负载。你的评论解析器应该表现得像一位细心的用户,而不是请求洪流。请求之间的停顿、合理的线程数以及通过移动代理的轮换——不是小聪明,而是负责任采集的规范。平台封禁的不是自动化本身,而是干扰其运行的异常行为。
第1步:确定目标并列出来源清单
本阶段目标:获得一份具体、有限的评论采集对象清单,并明确需要哪些字段。没有这一步,解析器会变成无休止的项目。
明确评论要回答的问题
好的采集从问题开始。可用的表述示例:
- 「为什么竞争对手X在Wildberries上评分4.8,而我们在同一品类只有4.4?」
- 「过去半年,我们五家咖啡店在Yandex地图上的评论中最常被吐槽什么?」
- 「在线课程在Otzovik上的评论中,客户提到哪些痛点,可以用来做创意?」
注意:每个问题都包含平台、对象、时间段和信息类型。这正是决定采集设置的要素。
收集对象清单
- 在浏览器中打开平台,手动找到每个所需对象:商品卡片、地图上的机构、点评网站上的公司页面。
- 从地址栏复制页面的完整地址。
- 从地址中提取对象标识符。在Wildberries上是卡片地址catalog/后面的数字,在Ozon上是product/后面的数字及末尾连字符前的数字,在Yandex地图上是org/和名称后面的长数字,在2GIS上是firm/后面的数字。单独记录下来。
- 将所有内容填入sources.csv,列包括:平台、对象名称、地址、标识符、备注。
- 首次运行每个平台限制在3-5个对象。之后再扩展。
确定需要哪些字段
任何评论的最小字段集:平台上评论的标识符、对象标识符、平台、评分、文本、发布日期、采集日期。扩展字段集:作者姓名(或其哈希)、是否有照片、优点和缺点分开(电商平台和Otzovik上有)、商家回复及其日期、点赞或「有用」标记数、商品变体(尺寸、颜色)、购买确认状态。
建议:不要一次追求所有字段。采集最小字段集,加上2-3个对你的问题真正需要的字段。每个多余字段都是平台标记可能变化并破坏脚本的额外风险点。
预期结果:sources.csv文件包含5-15行,以及记录好的字段清单。每行都有填好的标识符。
可能的问题:无法理解地址中哪个是标识符。解决办法:在同一平台上打开两个相似对象并比较地址——相同的部分是模板,不同的部分就是标识符。
检查:你能读懂sources.csv的任意一行,并仅凭一个标识符在平台上手动打开所需对象。如果需要猜测——回去确认标识符。
第2步:设计评论表
本阶段目标:固定统一的记录格式,将所有平台的评论都归入其中。这样可以一起分析,而不是分散在五张不同的表里。
统一结构
在代码编辑器中创建schema.txt文件,按以下顺序列出列:
- review_id——平台上评论的标识符。如果平台不明确提供,我们自己从对象、作者和日期生成。
- source——平台短代码:yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon。
- object_id——来自sources.csv的对象标识符。
- object_name——便于阅读的对象名称。
- rating——1到5的数字。如果平台使用其他量表,转换为五分制并在备注中记录。
- text——评论完整文本,单行。换行符替换为空格。
- pros和cons——优点和缺点,如果平台分开的话。否则留空。
- author——作者姓名或其匿名化哈希。
- published_at——发布日期,格式YYYY-MM-DD。
- company_reply——商家回复文本,如果有的话。
- likes——有用标记数。
- has_photo——1或0。
- collected_at——采集日期和时间。
- url——对象页面地址。
为什么需要统一格式
每个平台以各自形式返回数据:有的日期是字符串「3天前」,有的是毫秒数,有的是文本「3月14日」。如果不在一开始就统一,分析时会淹没在例外情况中。应在写入时立即归入结构,而不是事后。
匿名化规则
如果任务不需要作者姓名(90%的分析任务都不需要),存储哈希而不是姓名。在Python中,通过hashlib模块一行即可完成:取作者姓名,加上平台代码,将结果转换为短字符串。这样你能区分同一作者的不同评论,但不会存储姓名本身。
建议:在结构中添加raw_json列,记录平台对具体评论的原始响应。它占空间,但允许你之后提取今天没想到的字段,而无需重新采集。
预期结果:schema.txt文件包含各列,以及带这些表头的空模板reviews_template.csv。
检查:在Excel中打开reviews_template.csv。你应看到一行表头,列数与schema.txt完全一致,没有多余的列。
第3步:使用官方途径——后台和API
本阶段目标:以最干净的方式导出关于自己企业的评论,完全不使用解析。如果你只分析自己,这一步可能就够了。
Yandex Business(Yandex地图上的评论)
- 以机构所有者账号登录Yandex Business。
- 在左侧菜单选择「评论」板块。
- 如果有多家机构,在顶部选择所需分店。
- 设置时间段和评分筛选。
- 评论列表显示文本、日期、评分和你的回复。没有直接导出到表格的按钮,因此大批量时可按页复制,或转到第4步。
Wildberries:卖家评论API
Wildberries有官方API板块用于处理评论和问题。它面向卖家,返回你商品的评论,包含评分、文本、优点和缺点、日期,还允许回复。
- 登录WB Partners卖家后台。
- 打开个人资料设置,进入「API访问」板块。
- 创建新令牌,勾选评论和问题的访问类别。命名要清晰,例如reviews_export。
- 立即复制令牌——它不会再次显示。保存到项目文件夹中的config.txt文件。
- 在Authorization头中携带此令牌调用评论列表方法。文档描述了分页和日期筛选参数。
Ozon Seller API和Yandex Market
Ozon通过Seller API为包含评论处理订阅的卖家提供评论访问。密钥在「设置」的「API密钥」子板块创建。Yandex Market通过合作伙伴API按业务标识符返回卖家商品的评论,密钥在卖家后台的访问设置板块发放。
Google Business Profile和2GIS企业版
Google地图上关于自己机构的评论可在Google Business Profile后台获取,确认权限后也可通过其API获取。2GIS为所有者提供后台,带评论通知和回复功能。
注意:令牌和API密钥是你企业账号的访问权限。切勿将它们直接写入代码,存放在单独文件中,不要放入共享文件夹和代码仓库。如果令牌意外泄露——立即在后台撤销并创建新的。
官方途径不够用时
上述所有方式只返回关于你自己对象的评论。分析竞争对手、市场或他人商品时它们不适用。这种情况下转到从公开页面采集——后续步骤专门讲这个。
预期结果:如果你处理自己的业务——得到第一张来自官方来源的评论表,已归入第2步的结构。
检查:导出中的评论数与后台同期显示的数量一致,误差在1-2条(导出时正在审核的评论)。
第4步:从地图采集评论——Yandex地图、2GIS、Google Maps
本阶段目标:学会找到地图加载评论的后台请求,并用脚本复现它。这项技能是通用的,适用于所有其他平台。
如何通过开发者工具找到评论请求
- 在Chrome中打开Yandex地图或2GIS上的机构页面。
- 按F12键。开发者面板会在右侧或下方打开。
- 切换到Network(网络)标签。如果为空——按F5刷新页面。
- 在请求列表上方的筛选栏点击Fetch/XHR按钮。只剩下获取数据的后台请求。
- 在机构页面转到评论区,向下滚动列表以加载下一批。
- 请求列表中出现新请求。其名称中通常有review或feedback字样。点击它。
- 打开Preview或Response标签。你会看到JSON结构,其中嵌套列表包含评论:文本、评分、日期、作者。
- 打开Headers标签。复制完整请求地址(Request URL),注意参数:通常有对象标识符、页码或偏移量、批次大小和排序。
- 在同一板块找到请求头:User-Agent、Accept、Referer。它们需要从脚本中传递。
建议:右键点击找到的请求,选择Copy,然后Copy as cURL。会得到带所有请求头的命令。方便粘贴到文本文件中作为基准:如果脚本突然停止工作,可以将其请求与基准比较。
各地图的特点
- Yandex地图。评论分批加载,带排序指定(按最新、按评分、按相关性)。务必固定一种排序,否则不同运行会得到不同集合。日期以机器可读形式返回,评分是数字。机构回复在单独的嵌套字段中。
- 2GIS。该服务有公开的评论服务,网站本身会调用。请求包含分店标识符以及limit和offset参数。响应中有文本、评分、日期、用户名、官方回复和有用计数。还会返回评论总数——用它检查完整性。
- Google Maps。三个平台中最复杂的:评论以打包格式出现在长响应中。对于几十个对象,用带官方密钥的Places API更简单——它按每个地点返回有限的最新评论,通常足以评估情感倾向。对于他人对象的完整采集需要浏览器自动化——这是进阶板块的话题。
编写第一个脚本
创建collect_maps.py文件并粘贴框架。请求地址和字段名从开发者面板中看到的内容替换——它们因平台而异,并可能随时间变化。
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
这里发生了什么。PROXY变量存储你的移动代理数据。User-Agent头将请求表示为移动浏览器——这与移动IP合理搭配。collect函数遍历页面,直到平台返回空列表,每页后暂停2.5秒。暂停不是形式:它使负载看起来像真人阅读。
运行并写入结果
- 在文件末尾添加调用函数,针对sources.csv中的一个对象,并通过csv模块以utf-8-sig编码写入CSV行,以便Excel正确打开俄文文本。
- 在项目文件夹中打开终端,执行
python collect_maps.py。 - 观察输出。每次请求后打印页码和已采集行数很有用。
- 在Excel中打开生成的文件,查看前20行。
预期结果:一张包含一个机构评论的CSV文件,行数大约等于机构页面上的评论计数。
可能的问题:响应返回403或为空。解决办法:将请求头与复制的cURL命令对照,特别是Referer和Accept。检查代理是否连接,是否响应了对任意网站的测试请求。将暂停增加到4-5秒。
检查:从文件中取三条随机评论,在机构页面上按文本找到它们。三条都应找到,评分和日期相同。
第5步:从电商平台采集评论——Wildberries、Ozon、Yandex Market
本阶段目标:将第4步的方法适配到电商平台,其评论绑定到商品并带有额外字段:优点、缺点、商品变体、照片。
Wildberries
在Wildberries上,评论不绑定到货号,而是绑定到合并卡片标识符,颜色和尺寸在其下分组。这很重要:如果按货号采集,会一次得到所有变体的评论,需要按变体字段筛选。
- 打开商品卡片,按F12,用Fetch/XHR筛选切换到Network标签。
- 滚动到评论区,点击「查看全部评论」。
- 找到名称中含feedbacks的请求。响应中有列表,包含文本、评分、日期、优点和缺点字段、作者姓名、颜色和尺寸、是否有照片的标记以及卖家回复。
- 注意响应中的评论总数——它有助于检查完整性。
- 复制地址和请求头,按第4步的模板替换到脚本中。这里可能没有分页——部分响应整体返回,有时文件非常大。将超时增加到60秒。
Ozon
Ozon积极保护数据并检查客户端行为。评论方面,网站使用内部请求获取页面组成,评论是其中一个块。实际操作顺序:
- 打开商品页面,然后从卡片链接转到评论区。
- 在开发者面板找到响应中包含content、score或rating和author字段数组的请求。名称可能不同,用面板搜索栏(在Network标签内按Ctrl+F)按内容查找。
- 将请求复制为cURL。注意请求头和cookie:Ozon对缺失很敏感。
- 从脚本复现时使用requests.Session,以便请求间保持cookie,先请求普通商品页面,然后再请求评论。这模仿了用户的自然路径。
- 保持4-6秒暂停,通过移动代理每30-50个请求更换IP。
注意:如果平台开始返回浏览器验证页面或验证码——这是停止的信号,而不是继续施压。降低频率,通过轮换链接更换IP,等待10-15分钟。系统性施压防护机制会导致整个地址池被封锁,违反平台规则。
Yandex Market
Yandex Market上的评论有两种类型:关于商品(所有卖家通用)和关于店铺。分析产品需要前者,分析服务需要后者。两种类型都分为优点、缺点和评论,还有评分和日期。评论请求用同样方法通过商品卡片「评论」标签的开发者面板找到。
归入结构
在电商平台上,文本字段通常由三部分组成。这样记录:pros写入pros列,cons写入cons列,一般评论写入text。如果分析需要一整段连续文本,在清洗阶段用分隔符合并三列,但原始数据中分开存储。
建议:电商平台上带照片和确认购买的评论明显更有信息量。在脚本中添加筛选:先采集全部,分析时单独看has_photo等于1的切片。通常那里有最详细的缺陷描述和真实使用场景。
预期结果:每个电商平台一个CSV,包含3-5个商品的评论,已归入统一结构。
可能的问题:采集的评论数少于页面计数。原因:平台限制返回深度,或只返回带文本的评论,隐藏无评论的评分。解决办法:比较页面上「总评分」和「带文本」计数——通常差异正源于此。
检查:在Excel中打开文件,按rating列建透视表。评分分布应大致符合商品卡片显示的:如果平台上70%是五星,你的样本应接近这个值。
第6步:从点评网站采集评论——Otzovik、iRecommend、Flamp、Zoon
本阶段目标:学会处理评论是带HTML标记的独立文章、而不是后台JSON的平台。
点评网站的区别
Otzovik和iRecommend以经典方式构建页面:每条评论是单独页面,有标题、长文本、评分、日期、优点和缺点,对象页面上是这些评论的链接列表和简短预览。Flamp和Zoon更接近地图:机构、评论列表、分批加载。因此,前两者需要解析HTML,后两者适用第4步的方法。
安装HTML解析库
在终端执行pip install beautifulsoup4 lxml。BeautifulSoup库允许你像在开发者面板中用眼睛找到元素一样,按标签和类查找页面元素。
从Otzovik逐步采集
- 在Otzovik上打开对象页面(商品、公司、课程)。
- 按F12并切换到Elements(元素)标签。
- 点击面板左上角的箭头图标,点击列表中第一条评论的标题。面板会高亮HTML元素。记录其标签和类——这是评论链接的选择器。
- 用同样方法找到评分元素(通常是带星星和数字属性的块)、日期和简短文本。
- 向下滚动页面,找到分页块。点击数字2,看地址如何变化——通常添加页码。这是遍历的模板。
- 在脚本中:通过requests带代理加载列表页,用BeautifulSoup解析,提取评论链接和预览,然后转到下一页列表。页面间暂停5-8秒,点评网站比地图更敏感。
- 如果需要完整评论文本而非预览,做第二遍:按每个链接加载评论页面,提取正文、优点和缺点块、分项评分。
iRecommend
逻辑与Otzovik类似:对象页面带评论列表和单独的评论页面。区别在标记和评分以点亮的星星数表示——计算带活动类的星星元素,而不是找数字。
Flamp和Zoon
对这两个平台使用第4步的方法:打开机构,切到Fetch/XHR,滚动评论,找到后台请求。Flamp返回带评分、文本、日期、官方回复和有用度的评论。Zoon——带评分、文本、日期和机构回复。两个平台都显示评论总数以供完整性检查。
HTML解析小示例
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
这里的类名是示例——替换为你在Elements面板中看到的实际值。必须检查元素是否为空:如果某条评论的标记不同,脚本不应整体崩溃。
建议:点评网站上日期常用文字表示:「昨天」、「3天前」、「3月14日」。建一个单独的日期规范化函数,将这些字符串相对于采集日期转换为YYYY-MM-DD格式。没有它,按时间排序将无法工作。
预期结果:来自一两个点评网站的评论CSV,每条评论有评分、日期和文本,Otzovik和iRecommend还有完整页面链接。
可能的问题:几页后选择器停止找到元素。原因:平台返回验证页面而不是列表。解决办法:每次加载后检查页面标题,出现验证迹象时——暂停、更换IP、几分钟后重试。
检查:从一页列表采集的评论数等于你在浏览器中该页看到的评论数。如果采集得更少——某个选择器太窄。
第7步:连接移动代理并配置轮换
本阶段目标:让评论解析器在数十上百个对象上稳定运行,分散负载,不产生单一地址的异常流。
为什么是移动代理
本指南中的所有平台都面向移动受众:大多数评论是用智能手机写和读的。移动运营商的移动IP地址是同时有数百上千真实用户使用的地址。平台无法在不损害真实用户的情况下封禁这类地址,因此对它们更宽容。对评论采集来说,这意味着更少的检查、更少的防护误报和可预测的速度。
配置连接
- 登录mobileproxy.space个人后台,打开代理列表。
- 复制主机、端口、登录名和密码。注意协议:requests用HTTP代理更方便,但安装扩展
pip install requests[socks]后也支持SOCKS5。 - 将数据填入脚本中的PROXY变量。格式:协议、冒号、两个斜杠、登录名、冒号、密码、@、主机、冒号、端口。
- 从后台复制更换IP的链接,保存到ROTATE_URL变量。
- 通过代理执行测试请求到任何显示你IP的服务。响应中应是移动运营商地址,而不是你的家庭宽带。
轮换策略
有两种方法,都可用。
- 按时间轮换。在后台设置自动更换IP的间隔,例如每5分钟。脚本什么都不做——地址自己变化。适合长时间平稳采集。
- 按事件轮换。脚本在需要时自己触发ROTATE_URL:每N个请求后、切换到新对象时、收到429/403代码时。适合需要控制的情况。
评论的实用规则:切换到每个新对象时更换IP,并在同一对象内每40-60个请求后再更换。更换IP后暂停5-10秒——运营商需要时间让新地址生效。
错误处理和重试
在fetch_page函数中添加包装:遇到429、403、5xx代码或超时时——触发轮换、等待、重试请求最多三次,暂停递增(10、30、90秒)。如果三次尝试都无效——将对象写入failed.txt并转到下一个。这样一个问题对象不会停止整个采集,之后再单独补采遗漏。
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
使用多少线程
新手——一个线程。一个代理、一个连接、顺序遍历。慢但可靠:每小时500-1000条评论无任何问题。确认一切稳定后,可以加第二个代理,在对象列表的另一半上运行第二个脚本实例。评论采集每个平台几乎从不需要超过3-4个线程。
建议:让User-Agent与IP类型一致。如果走移动代理,就表示为移动浏览器,如第4步示例。不一致「移动IP,但Windows上的桌面Chrome」本身不致命,但一致性会减少额外检查。
预期结果:脚本无需人工干预即可遍历一个平台的整个sources.csv,在对象间更换IP,并将问题对象写入failed.txt。
可能的问题:更换IP后前几个请求超时失败。解决办法:将轮换后的暂停增加到15秒。代理完全连不上——检查后台是否启用了IP白名单,把你的电脑地址加进去。
检查:连续对10个对象运行采集。日志中应有对象间更换IP的记录,failed.txt为空或最多包含一个对象,结果总行数与平台上评论计数之和相当。
第8步:保存、清洗和去重
本阶段目标:将来自不同平台的原始CSV集变成一张统一的干净表格,适合分析。
合并文件
- 确保所有原始文件都在raw文件夹中,且表头按schema.txt一致。
- 创建merge.py文件。通过pandas将raw文件夹中所有CSV读入一个DataFrame:pandas.concat函数合并表列表。
- 检查类型:rating应为数字,published_at应为日期。通过pandas.to_numeric和pandas.to_datetime及参数errors='coerce'转换,使不正确的值变为空,而不是破坏处理。
- 用drop_duplicates按source和review_id对删除行。
- 将结果保存到clean文件夹。
去重
重复源于三个原因:分页时页面重叠、重复运行、同一作者在多个平台发布的同一评论。按顺序处理:
- 按source和review_id对删除精确重复——这是分页和重启造成的重复。使用drop_duplicates方法及subset参数。
- 在同一平台内查找模糊重复:相同object_id、相同日期和文本前100个字符。当平台在编辑评论时更改标识符时会出现这种情况。
- 跨平台重复不要删除,而是用单独列标记。一个人在Otzovik和Yandex地图上写了同样内容,这一事实本身就有信息量。
文本清洗
- 去除文本中的双空格和换行符。
- 删除进入文本的平台服务性短语:「阅读全文」、「显示更多」。
- 将pros和cons中的空字符串替换为明确的空值,而不是字符串「无」或「-」。
- 检查编码:如果看到乱码,文件保存时不是utf-8。从原始来源重新保存。
导出结果
通过to_excel方法将最终表格保存到clean文件夹,名称reviews_all_YYYY-MM-DD.xlsx,同时保存为CSV。Excel便于查看,CSV便于加载到其他系统。另外保存一个汇总文件:各平台评论数、各对象平均评分、有商家回复的评论占比。
建议:在干净表格中添加text_len列,记录文本长度。短于30字符的评论对分析原因几乎无用,而评分2-3的长评论是金子:其中人们详细解释到底哪里不对。
预期结果:一个干净文件,包含所有平台的评论,无精确重复,数据类型正确,有汇总。
可能的问题:去重后丢掉太多行。原因:某平台的review_id对所有记录都为空,它们都算作重复。解决办法:检查各平台review_id的填充情况,对问题平台从object_id、日期和文本哈希生成标识符。
检查:干净文件行数比原始文件行数之和少不超过5-10%。rating列没有超出1-5范围的值,published_at列没有未来日期。
结果检查:清单和测试
在基于采集的评论得出结论之前,确保采集正确完成。完整走一遍清单。
就绪清单
- sources.csv中每个对象在干净表格中至少有一条评论,或对象带原因记入failed.txt。
- 每个对象的评论数与平台计数相差不超过10%。
- 对象的评分分布大致符合平台显示的分布。
- 如果对象活跃,表格中最新评论日期不晚于采集日期的昨天。
- 所有日期格式为YYYY-MM-DD,所有评分为数字。
- 按source和review_id对无精确重复。
- 作者姓名要么不存在,要么替换为哈希(如果任务不需要姓名)。
- 原始数据文件带日期保存,未被覆盖。
- 令牌和代理数据不在脚本内,而在单独的配置文件中。
如何抽样测试
- 用pandas的sample函数从表格中随机选10条评论。
- 对每条,在平台上打开对象页面,按文本片段找到评论。
- 核对评分、日期和商家回复。
- 如果10条全对——很好。如果8-9条——检查差异是否与采集后评论被编辑有关。如果少于8条——解析有系统性错误,回到相应步骤。
成功执行的指标
成功是这样的:你能打开一张表,按任意平台和对象筛选,按日期和评分排序,五分钟内回答第1步的原始问题。例如,看到过去三个月Yandex地图上咖啡店评分1-2的评论中40%提到等待时间,而2GIS上同样的人称赞咖啡但吐槽服务。如果问题得到回答——采集完成了任务。
常见错误和解决办法
以下是几乎每个初次配置评论解析器的人都会遇到的问题。格式:问题、原因、解决办法。
1. 脚本只采集了前20条评论
原因:未实现分页或偏移参数确定错误。
解决办法:回到开发者面板,滚动评论列表两次并比较两个连续请求的地址。变化的参数就是偏移或页码。确保脚本以正确的步长递增它。
2. 所有评论日期相同——采集日期
原因:published_at字段写入了collected_at,或平台用其他名称的字段返回日期。
解决办法:打开一条评论的raw_json,找到发布日期字段。它可能叫date、created、published、time、updatedAt。在脚本中修正字段名。
3. Excel中俄文文本显示不正确
原因:CSV以utf-8保存但无字节顺序标记,Excel以其他编码打开。
解决办法:以utf-8-sig编码保存,或直接通过to_excel导出为xlsx。
4. 平台对每个请求都返回403
原因:未传递必需请求头、未设置会话cookie,或请求过于频繁。
解决办法:与基准cURL命令对照。使用requests.Session并先加载普通对象页面。将暂停增加到5秒。通过代理更换IP并等待10分钟后重试。
5. 采集的评分与实际不符
原因:平台以其他量表存储评分(例如0到100或1到10),或单独字段存储的是分项评分而非总分。
解决办法:手动核对三条评论。确定量表并除算取整归入五分制。在schema.txt中记录。
6. 每次运行评论数不同
原因:未固定排序,平台在「按相关性」模式下返回不同集合。
解决办法:在请求地址中找到排序参数,硬性指定按日期排序。采集直到遇到早于所需时段的评论。
7. 脚本在一个对象上崩溃后不再继续
原因:没有异常处理,任何错误都停止程序。
解决办法:将每个对象的处理包在try-except中,将错误和对象标识符写入failed.txt,转到下一个。遗漏之后再单独运行补采。
8. 运行一周后脚本突然什么都找不到
原因:平台更改了请求地址、JSON结构或HTML类名。
解决办法:这是任何解析器生命周期的正常部分。重复第4步的请求查找流程,更新地址和字段名。将选择器和字段列表放在单独的配置文件中,这样只需改一处,而不是整个代码。
9. 代理能工作但速度很慢
原因:响应太大(电商平台有时一个文件返回数千条评论)或运营商基站在高峰时段负载高。
解决办法:增加超时,通过Accept-Encoding头启用压缩,将大批量采集安排到夜间。
进阶读者的额外功能
如果基础场景已掌握,以下是成长方向。本板块假设你能熟练编写Python。
增量采集
不进行全量重采,而是为每个对象保存最新已采集评论的日期。下次运行时按日期排序采集,遇到不晚于保存日期的评论就停止。这样每天更新500个对象只需几分钟而非数小时,平台负载降低数十倍。注意评论可能在审核后补发——留2-3天的重叠。
复杂平台的浏览器自动化
Google Maps和Ozon部分板块通过受控浏览器采集更简单:Playwright连接移动代理,打开页面,滚动评论列表,通过response事件处理器拦截后台响应。你得到与开发者面板相同的JSON,但无需手动复现请求头和cookie。Playwright支持移动设备模拟,与移动IP完美搭配。代价是速度和内存消耗:一个浏览器吃300-500MB,因此启动不超过2-3个实例。
数据库存储
当评论超过10万条时,CSV变得不方便。转到SQLite(内置于Python、磁盘文件、零配置)或PostgreSQL。reviews表在source和review_id对上建唯一索引,自动防止重复:通过INSERT及ON CONFLICT DO NOTHING处理冲突,在数据库层面丢弃重复。
丰富和分析
- 情感和主题。将文本通过语言模型,提示如「提取3个主要主题和整体情感」。结果放入单独列。对数万条评论使用批量处理和缓存,避免同一文本付费两次。
- 评分动态。为每个对象按周构建平均评分。急剧下降是问题的信号,评论会用文字解释。
- 公司响应速度。published_at与商家回复日期的差——支持质量的直接指标,自己和竞争对手的。
- 广告痛点词典。对评分1-2的评论中名词和形容词做频率分析,得到现成的创意和落地页表述列表。
解析器健康监控
通过Windows任务计划程序或cron设置每日运行,并添加简单检查:如果一天采集不到周平均的30%,或错误率超过10%——通过机器人发送Telegram通知。这样你当天就能知道平台标记变化,而不是一个月后需要数据时才发现。
代理池管理
同时处理多个平台时,为每个平台固定单独的移动代理。这样一个平台上的行为不会影响另一平台上地址的信誉。地图轮换少一些(对象通常不大,50-200条评论),电商平台更频繁(每卡片数千条评论)。记日志:时间、平台、IP、响应代码。一周后通过日志能看出哪些轮换间隔对你负载配置最优。
常见问题:评论采集FAQ
从公开页面采集评论合法吗?
为自身分析采集公开信息本身不违法,但有约束:平台用户协议、152-FZ对个人数据处理的要求、禁止妨碍服务运行。保持暂停、匿名化作者、不发布采集的数据库,并在有官方API的地方使用它。商业使用数据时咨询律师。
可以不用编程吗?
部分可以。自己的对象用个人后台就够。小型一次性任务可用浏览器解析扩展,将页面上可见元素导出到表格:你手动滚动评论,扩展采集。对数十个对象的定期采集,脚本更方便可靠,而本指南中的现成片段几乎可直接使用。
只有10个对象,为什么需要移动代理?
10个对象和一次性采集可以不用。但一旦开始定期更新数据或扩大列表,来自同一家庭IP的请求会开始收到额外检查。移动代理提前解决这个问题,成本与解决封锁所花的时间不可比。
每小时实际能采集多少评论?
单线程暂停2-5秒——每小时500到1500条,取决于平台批次大小。一次响应返回数百条评论的电商平台更多,分页HTML的点评网站更少。对大多数分析任务来说这已经足够。
如何只采集新评论,而不是全部重来?
为每个对象保存最后采集评论的日期,请求时按日期排序,遇到已知评论就停止。详见增量采集板块。
只有评分没文本的评论——采不采?
取决于任务。计算平均评分和动态——要,它们影响数字。分析原因——不要,处理时可筛掉。采集全部,分析时筛选:重采更贵。
如果平台显示验证码怎么办?
停止采集10-15分钟,通过代理更换IP,降低请求频率并检查请求头。验证码是信号,表明你的行为看起来不典型。任务是让它变得典型,而不是冲破验证。
如何存储作者姓名才不违法?
最好根本不存。如果需要区分同一作者的评论,用姓名的单向哈希。如果姓名必要(例如通过后台回复客户),只在处理自己机构时存储,不转交第三方。
评论解析器多久坏一次?
大平台每年更改内部请求和标记几次。监控良好时修复需20-40分钟:重复请求查找并更新字段。将选择器和地址放在配置文件中,修改将是点状的。
可以用一个脚本采集所有平台吗?
可以,如果做通用框架(代理、重试、写入结构),并为每个平台单独的适配器函数,知道请求地址和字段名。成熟项目就是这样:一个通用模块加十个小适配器。
结语
总结一下。你走完了从提出问题到获得来自三类不同平台评论的干净表格的路径。你学会了通过开发者面板找到后台请求、用脚本复现、在JSON不可用处解析HTML、连接带轮换的移动代理、处理错误和重试请求、合并和清洗数据。你还单独了解了官方导出途径和法律框架,这保护数据和保护你自己。
最值得记住的:评论是一种有自身动态的特殊数据类型。它们不断出现、被编辑、经过审核并携带个人信息。因此评论解析器不是一次性脚本,而是一个小系统:采集、原始数据存储、归入结构、去重、监控。这个系统的每个元素你已建成基础版本。
接下来做什么:
- 将sources.csv扩展到真实对象列表并进行完整采集。
- 通过计划程序设置每日增量运行。
- 至少添加一个分析增强:评分动态或负面评论主题化。
- 建立平台变化日志,随故障更新适配器。
发展方向。下一个层次是反应自动化:负面评论发布后一小时内通知团队、每周竞争对手对比报告、将评论主题整合到产品计划和广告假设中。数据你已拥有。剩下的就是将其转化为决策,而最有趣的工作从这里开始。
