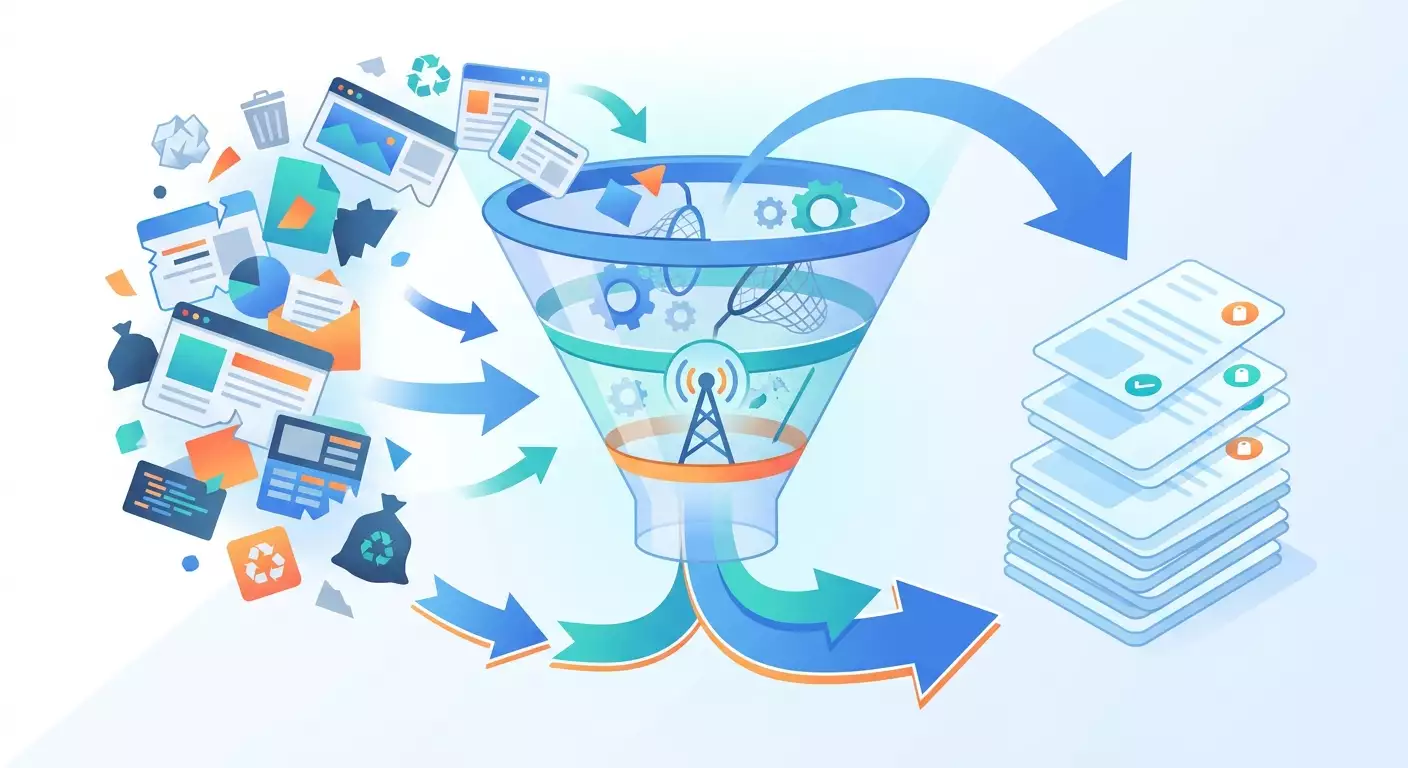
Mobil proxy ile RAG sistemi için veri seti nasıl toplanır ve çöp toplamadan: adım adım rehber
Makale içeriği
- Giriş: ne elde edeceksiniz ve bu kime hitap ediyor
- Ön hazırlık: araçlar, erişimler, ortam
- Temel kavramlar basit bir dille
- Adım 1: veri setinin sınırlarını belirleyin ve kaynak haritası oluşturun
- Adım 2: mobil proxy'yi bağlayın ve isteklerin onun üzerinden gittiğini doğrulayın
- Adım 3: limitler, rotasyon ve günlük içeren dikkatli bir toplayıcı yazın
- Adım 4: html ve belgelerden temiz metin çıkarın
- Adım 5: çöpü filtreleyin: tekilleştirme, şablonlar, kalite, dil
- Adım 6: meta verileri etiketleyin ve son veri setini oluşturun
- Sonucu doğrulama: kontrol listesi ve veri seti testi
- Rag için veri seti toplamada tipik hatalar ve çözümleri
- İ̇leri düzey kullanıcılar için ek olanaklar
- Sss: veri seti toplama hakkında sık sorulan sorular
- Sonuç: ne yapıldı ve bundan sonra nereye
Giriş: ne elde edeceksiniz ve bu kime hitap ediyor
RAG sistemi, cevap verdiği veri seti ne kadar iyiyse o kadar iyidir. En güçlü dil modelini alabilir, pahalı bir vektör veritabanı bağlayabilir ve eğer veri setine site menüsü, telif hakkı içeren altbilgiler, aynı makalenin beş farklı versiyonu ve "ürün geçici olarak stokta yok" sayfaları karıştıysa, çıktıda kendinden emin saçmalıklar alabilirsiniz. Model çöpü bilgiden ayırt edemez. Sadece benzer parçaları arar ve onları birleştirerek cevap oluşturur.
Bu adım adım rehber tek bir aşamaya odaklanmıştır: veri seti toplama. Vektör veritabanının yapısını, gömme seçimini ve parça ayarlarını ele almayacağız, blogda bunlarla ilgili ayrı materyaller var. Burada tam olarak sınıra odaklanacağız: diskinizde temiz, etiketlenmiş, tekilleştirilmiş ve herhangi bir indeksleme hattına verilebilecek JSONL formatında bir belge kümesi var.
Sonunda ne elde edeceksiniz:
- net sınırlara sahip kaynak listesi: neyi topluyoruz, neyi toplamıyoruz;
- mobil proxy üzerinden çalışan, limitlere uyan ve başkalarının sitelerini çökertmeyen çalışan bir Python toplayıcısı;
- her biri meta verilerle birlikte ham sayfalar ve belgeler içeren klasör;
- navigasyon, reklam ve şablon blokları olmadan ana metni çıkaran betik;
- indekse girmeden önce çöpü ayıklayan kalite filtreleri ve tekilleştirme;
- son veri seti dosyası ve her şeyin doğru yapıldığını gösteren sayılarla rapor.
Bu rehber kimin için. Kendi nişleri hakkında bir bilgi tabanı oluşturmak ve üzerine bir asistan inşa etmek isteyen pazarlamacılar ve işletme sahipleri için. Teklifler, açılış sayfaları ve reklam platformu kuralları hakkında bir veri setine ihtiyaç duyan arbitrajcılar için. Proxy'leri betiklere bağlamış ve şimdi bunu dikkatli ve sistematik bir şekilde yapmak isteyen geliştiriciler için. Ana metin yeni başlayanlar için yazılmıştır ve sonunda ileri düzey kullanıcılar için ayrı bir bölüm vardır.
Önceden bilmeniz gerekenler. Terminalde komut çalıştırabilmek ve dosyaları bir metin düzenleyicide açabilmek. Python hakkında "for döngüsünün ne yaptığını anlıyorum" düzeyinde temel bilgi. Mobil proxy'ye erişim: adres, port, kullanıcı adı, şifre ve IP değiştirme bağlantısı.
Ne kadar zaman gerekir. Ortam hazırlığı yaklaşık 30 dakika. Tüm adımları tamamlamak veri setinin boyutuna bağlı olarak 3 ila 5 saat. Birkaç bin sayfanın toplanması arka planda birkaç saat sürebilir, ancak bu süre zarfında sizin katılımınız gerekmez.
Ön hazırlık: araçlar, erişimler, ortam
İlk kod satırını yazmadan önce çalışma alanını düzenleyelim. Bu, daha sonra saatlerce hata ayıklamadan tasarruf etmenizi sağlar.
Sistem gereksinimleri
- Windows 10/11, macOS veya Linux yüklü bir bilgisayar veya sunucu. On binlerce sayfa toplamak için kiralık bir VPS daha uygundur, ancak ilk veri seti için bir dizüstü bilgisayar yeterlidir.
- En az 8 GB RAM. Büyük veri setlerinin tekilleştirilmesi bellek sever.
- Diskte boş alan: en az 5 GB. Ham HTML, temiz metinden 5-10 kat daha fazla yer kaplar ve biz her ikisini de saklayacağız.
- Kararlı internet. Proxy gecikme ekler, bu nedenle yavaş bir ev bağlantısı toplamayı önemli ölçüde uzatır.
Ne kurulmalı
- Python 3.11 veya daha yeni. Resmi web sitesinden yükleyiciyi indirin, Windows'ta kurulum sırasında "Add Python to PATH" kutusunu işaretleyin. Terminalde kontrol edin:
python --version.Python 3.12.xgibi bir satır görünmelidir. - Sanal ortam. Örneğin
rag-corpusadında bir proje klasörü oluşturun, içine girin vepython -m venv venvkomutunu çalıştırın. Etkinleştirin: Windows'tavenv\Scripts\activate, macOS ve Linux'tasource venv/bin/activate. Terminal satırının başında(venv)görünecektir. - Kütüphaneler. Tek komutla yükleyin:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm. Yükleme 1-3 dakika sürer. - Kod vurgulamalı metin düzenleyici: VS Code, PyCharm Community veya başka bir tane.
Proxy erişimleri
Proxy hizmetinizin kişisel hesabına gidin. Satın aldığınız mobil proxy'nin kartında dört değer bulun: ana bilgisayar (IP adresi veya alan adı), HTTP için port ve SOCKS5 için port, kullanıcı adı ve şifre. Ayrıca IP değiştirme bağlantısını kopyalayın: bu, proxy'nin operatörden yeni bir adres alması için bir GET isteği yapmanız gereken URL'dir. Tüm bunları kodun içine değil, proje klasöründeki .env dosyasına kaydedin.
Klasör yapısı
Proje içinde şu klasörleri oluşturun: ham sayfalar için raw, çıkarılan metin için clean, son dosya için corpus, günlükler için logs. Başlangıçta boş klasörler normaldir.
Yedeklemeler
Veri seti uzun sürede toplanır ve kaybetmek üzücüdür. Kendinizle bir kural üzerinde anlaşın: raw klasörü asla üzerine yazılmaz, sadece eklenir. Her büyük aşamadan sonra sonucu arşivleyin: Linux ve macOS'ta tar -czf raw_backup_2026-03-01.tar.gz raw/ veya Windows'un yerleşik arşivleyicisiyle. Filtrelerde hata yapıp yanlışlıkla bir şeyleri silerseniz, baştan toplamadan ham verilere her zaman geri dönebilirsiniz.
İpucu: Hemen bir sources.md dosyası oluşturun ve her kararı yazın: hangi siteleri alıyorsunuz, hangi bölümleri hariç tutuyorsunuz, neden. Bir ay sonra asistan garip cevaplar vermeye başladığında, bu dosya akşamınızı kurtaracak.
Temel kavramlar basit bir dille
RAG sistemi için ilk kez veri topluyorsanız, her adımda birkaç terimle karşılaşacaksınız. Bunları kısaca ele alalım.
RAG nedir ve neden veri seti modelden daha önemli
RAG (Retrieval-Augmented Generation), dil modelinin cevap vermeden önce bilgi tabanınızdan bir dizi parça aldığı bir yaklaşımdır. Model belgelerinizi "bilmez", bulunan parçaları okur ve onlara göre cevap verir. Buradan basit bir kural çıkar: veritabanında çöp varsa, arama er ya da geç tam da onu çıkarır ve cevap talimat yerine "Bültenimize abone olun" satırına dayanır. Bu nedenle veri seti toplama aşaması atlanamaz.
Veri seti, belge, meta veriler
Veri seti, RAG sistemine gidecek tüm metin kümesidir. Belge, bir anlamsal birimdir: makale, yardım sayfası, PDF talimatı, ürün kartı. Meta veriler, belgenin pasaportudur: nereden alındı, ne zaman toplandı, hangi dilde, yazarı kim, hangi bölüme ait. Meta veriler olmadan ne veri setini güncelleyebilir, ne kullanıcıya cevabın nereden geldiğini açıklayabilir, ne de eskiyen içeriği filtreleyebilirsiniz.
Mobil proxy ve toplamada neden gerekli
Mobil proxy, isteklerinizi bir cep telefonu operatörünün IP adresi üzerinden internete çıkaran bir aracı sunucudur. Veri seti toplamak için üç pratik sorunu çözer. Birincisi: yük dağıtımı. Tek bir adresten siteye vurmak yerine farklı adreslerden gidersiniz ve her kaynak sakin, seyrek trafik görür. İkincisi: coğrafya. Birçok site bölgeye bağlı olarak farklı içerik, fiyat ve stok gösterir ve istenen şehirdeki mobil proxy, müşterilerinizin gördüğü sayfa sürümünü size verir. Üçüncüsü: uzun oturumların kararlılığı. Bağlantı üzerinden IP rotasyonu, saatlerce toplamaya tek bir adrese bağlı kalmadan devam etmenizi sağlar.
Rotasyon, IP adresinin değiştirilmesidir. Programa göre (her N dakikada bir) ve istek üzerine (ihtiyaç duyduğunuzda bağlantıyı çekersiniz) olabilir. Veri seti toplamada ikincisi daha uygundur: kaynağı değiştirdiniz, adresi değiştirdiniz.
Neyin çöp sayılacağı
Veri seti bağlamında çöp, konunuzla ilgili bilgi taşımayan, ancak indekste yer kaplayan ve aramayı bozan her şeydir:
- navigasyon, menüler, altbilgiler, "sayfa yolu", abonelik formları;
- aynı metnin farklı adreslerdeki tam ve neredeyse tam kopyaları;
- yer tutucu sayfalar: "Sayfa bulunamadı", "Ürün tükendi", "Bakım çalışması var";
- veri seti tek dilli ise başka dildeki metinler;
- proxy veya sitenin HTML'nin yarısını döndürdüğü kesik sayfalar;
- kullanma hakkınız olmayan başkalarının içeriği.
Yasal çerçeve
Yalnızca yetkilendirme gerektirmeyen açık verileri ve kendi belgelerinizi toplayın. robots.txt dosyasına saygı gösterin: bu, sitenin hangi bölümlerinin otomatik olarak gezilebileceğine dair kurallar listesidir. Üçüncü tarafların kişisel verilerini toplamayın: telefon numaralı isimler, adresler, hesaplar. Kendi iç belgelerinizden bir veri seti oluşturuyorsanız, bunları kullanma hakkınız olduğundan emin olun. Bu rehberde proxy, kaynağın yasakladığı şeyi yapmanın bir yolu değil, dürüst dağıtılmış toplama için bir araç olarak kullanılır.
Adım 1: Veri setinin sınırlarını belirleyin ve kaynak haritası oluşturun
Aşamanın amacı: her kaynak için hangi URL'leri alacağımızın, hangilerini hariç tutacağımızın, hangi derinlikte gezineceğimizin ve dakikada kaç isteğe izin verdiğimizin belirtildiği bir kaynak listesi dosyası elde etmek.
Çöp veri setinin en yaygın nedeni teknik hatalar değil, sınırların olmamasıdır. Kişi "tüm site" için toplayıcıyı başlatır, 40 bin sayfa alır, bunlardan 800'ü konuyla ilgilidir ve sonra bir hafta temizler. Tersini yapalım: önce harita, sonra toplama.
Talimatlar
- RAG sisteminizin cevaplaması gereken soruları formüle edin. 20-30 gerçek kullanıcı sorusu yazın. Örneğin, bir proxy hizmeti bilgi tabanı için: "Bağlantı üzerinden IP nasıl değiştirilir", "Proxy neden yavaş yanıt veriyor", "Hangi portlar destekleniyor". Bu sorular doğrulama aşamasında test setiniz olacak.
- Her soru için cevabın nerede olduğunu yazın. Yardım bölümü, dokümantasyon, blog makaleleri, PDF yönetmelikleri, ürün sayfaları. Bu listede olmayan hiçbir şey veri setine girmez.
- Her kaynağı tarayıcıda açın ve adres yapısını inceleyin. Genellikle faydalı içerik anlaşılır önekler altında bulunur:
/help/,/docs/,/blog/,/faq/. Çöp ise diğerlerinde:/tag/,/search?,/cart/,/author/,?page=gibi sayfalama sayfaları. - Kaynağın robots.txt dosyasını kontrol edin.
https://alanadi/robots.txtadresini açın.Disallowsatırlarını bulun: bu yolları tartışmasız hariç tutun. Aynı dosyadaCrawl-delaybelirtilmişse, bunu istekler arasındaki minimum duraklama olarak kaydedin. - Site haritasını bulun. Genellikle robots.txt'de
Sitemap:satırıyla belirtilir veya/sitemap.xmladresinde bulunur. Site haritası, sizi özyinelemeli bağlantı gezintisinden ve ilgili çöpten kurtaracak hazır bir adres listesidir. - Yükü belirleyin. Küçük siteler için dakikada en fazla 10-15 istek koyun. CDN'li büyük portallar için 30'a kadar kabul edilebilir. Emin değilseniz, daha azını alın: veri seti acil değil.
- Coğrafyayı belirleyin. İçerik bölgeye bağlıysa (fiyatlar, teslimat, stok), toplayıcınızın hangi şehirden "bakması" gerektiğine karar verin ve uygun mobil proxy'yi seçin.
- Her şeyi
sources.jsondosyasına kaydedin.
Bir kaynak için örnek giriş:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]rotate_every alanı, toplayıcının kaç istekten sonra IP değiştirme bağlantısını çekeceğini belirler. Gerçek JSON dosyasına kaydederken tek tırnakları çift tırnakla değiştirin, burada sadece netlik için gösterilmiştir.
Dikkat: Faydalı içeriğin yalnızca hesaba giriş yaptıktan sonra görülebildiği siteleri kaynaklara eklemeyin. Birincisi, bu çoğu platformun kullanıcı sözleşmesini ihlal eder. İkincisi, böyle bir veri setini yasal olarak güncellemek ve şirket içinde dağıtmak imkansızdır.
İpucu: Kendi belgeleriniz için ayrı bir kaynak oluşturun: PDF, DOCX ve CRM veya bilgi tabanınızdan dışa aktarılanlar klasörü. Bunları proxy üzerinden indirmeye gerek yok, ancak web sayfalarıyla aynı hatta işleyip temizleyeceğiz.
Kontrol: Her kaynağın dahil etme önekleri, hariç tutma kalıpları, istek limiti ve dili olduğu sources.json dosyanız var. Site haritasından filtrelerinize uyan 5 rastgele adres açın ve her birinde bağlantı kataloğu değil, içerikli metin olduğundan emin olun.
Olası sorunlar
- Sitenin site haritası yok. Adres listesini birkaç içindekiler sayfasından manuel olarak veya yalnızca izin verilen önekler içinde 2 derinliğe kadar basit bağlantı gezintisiyle toplayın.
- Site haritası 100 bin adres içeriyor. Öneklere göre filtreleyin, ardından 200 adreslik bir örnek alın, toplayın ve kaliteyi değerlendirin, sonra hepsini başlatın.
- Faydalı içerik farklı alan adlarına dağılmış. Her alan adı için
sources.jsondosyasına ayrı bir giriş yapın, kendi limiti ve coğrafyasıyla.
Adım 2: Mobil proxy'yi bağlayın ve isteklerin onun üzerinden gittiğini doğrulayın
Aşamanın amacı: betiğin gerçekten mobil proxy üzerinden gittiğinden, rotasyonun çalıştığından ve gecikmelerin toplama için kabul edilebilir olduğundan emin olmak.
Talimatlar
- Proje kökünde bir
.envdosyası oluşturun ve kişisel hesabınızdaki değerleri girin:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxHer değer ayrı bir satırda. Sürüm kontrol sistemi kullanıyorsanız .env dosyasını .gitignore dosyasına ekleyin.
- Aşağıdaki içerikle
proxy_check.pydosyasını oluşturun:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP без прокси:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP через прокси:', ip1, 'за', round(time.time() - t0, 2), 'сек') print('Меняем IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP после ротации:', ip2) print('Ротация сработала:', ip1 != ip2)Öncelikle pip install python-dotenv komutunu çalıştırın. Gerçek dosyada kod satırları her biri kendi satırında yer alır.
- Çalıştırın:
python proxy_check.py. - Çıktıyı okuyun. İlk IP ev veya sunucu IP'niz olmalıdır. İkincisi farklı olmalı ve bir cep telefonu operatörüne ait olmalıdır. Üçüncüsü ikinciden farklı olmalı ve son satır
Truegöstermelidir. - Gecikmeyi ölçün. Proxy üzerinden istek 5-6 saniyeden fazla sürüyorsa toplama yavaş olacaktır. Seçilen proxy'nin hedef sitelere coğrafi olarak yakın olduğundan emin olun veya hizmet desteğiyle iletişime geçin.
- Alternatif olarak SOCKS5'i kontrol edin. HTTP portu kararsız sonuç veriyorsa,
proxy_urliçindekihttp://kısmınısocks5h://ile ve portu hesabınızdaki SOCKS5 portuyla değiştirin.pip install requests[socks]gerekir.hsoneki önemlidir: proxy'nin alan adlarını kendi başına çözmesini sağlar.
Dikkat: IP rotasyonunu tarifenizin izin verdiğinden daha sık çalıştırmayın. Çoğu mobil proxy'de minimum değişim aralığı vardır, genellikle 30 saniye ile 2 dakika arasında. Rotasyon bağlantısına çok sık istek ya yok sayılır ya da işlevi geçici olarak engeller.
İpucu: Art arda beş gecikme ölçümü yapın ve medyanı kaydedin. Bu sayı bir sonraki adımda zaman aşımlarını doğru ayarlamak için gerekli olacaktır: zaman aşımı tipik gecikmenin yaklaşık 4-5 katı olmalıdır.
Kontrol: Betik üç farklı IP adresi, Ротация сработала: True satırını ve proxy üzerinden tipik gecikmenin 3-4 saniyeyi geçmediğini gösteriyor. Her şey böyleyse proxy çalışmaya hazırdır.
Olası sorunlar
- Hata 407 Proxy Authentication Required. Kullanıcı adı ve şifreyi kontrol edin, fazladan boşluk olmadığından emin olun. Şifrede
@veya:karakterleri varsa, bunlarıurllib.parse.quoteile kodlayın. - Hata Connection refused veya zaman aşımı. Proxy, beyaz IP'nize bağlı olabilir. Hesabınıza gidin ve mevcut sunucu adresini izin verilenler listesine ekleyin veya kullanıcı adı ve şifreyle kimlik doğrulamaya geçin.
- Rotasyondan sonra IP değişmedi. Rotasyon bağlantısına yapılan istekten sonraki duraklamayı 15-20 saniyeye çıkarın. Bazı operatörler yeni adresi anında vermez.
- SSL hataları.
certifikütüphanesinipip install -U certifikomutuyla güncelleyin. Sertifika doğrulamasınıverify=Falseparametresiyle kapatmayın: bu güvenli değildir.
Adım 3: Limitler, rotasyon ve günlük içeren dikkatli bir toplayıcı yazın
Aşamanın amacı: site haritasındaki adresleri gezen, robots.txt ve limitlere uyan, proxy üzerinden giden, programa göre IP değiştiren, ham HTML'yi kaydeden ve her isteğin görüldüğü bir günlük tutan bir betik elde etmek.
Burada felsefeyi anlamak önemlidir. RAG sistemi için iyi bir toplayıcı yavaş, kibar ve günlüklerde paranoyak derecede ayrıntılıdır. Hızlı agresif bir tarayıcı size bir yığın kesik sayfa ve 429 hatası toplar, sonra bunlardan hangisinin çöp olduğunu anlayamazsınız.
Talimatlar
fetch.pydosyasını oluşturun. Betiğin yapısı: ayarları yükleme, site haritasını ayrıştırma, adresleri filtreleme, duraklamalı istek döngüsü, sonucu kaydetme.- Site haritasını yükleyin ve adresleri filtreleyin. Site haritası, her adresin
locetiketinde olduğu bir XML'dir. Standartxml.etree.ElementTreeile ayrıştırın. Yalnızcainclude_prefixesile başlayan veexclude_patternsiçermeyen adresleri bırakın. Sonucuurls_help_center.txtdosyasına kaydedin ve gözlerinizle bakın. - robots.txt kontrolünü bağlayın.
urllib.robotparser.RobotFileParserkullanın: dosyayı alan adı başına bir kez yükleyin ve her istekten öncecan_fetch(user_agent, url)sorgulayın. Yasaklanan adresleri atlayın ve günlüğerobots_disallownotuyla yazın. - Dürüst bir User-Agent ayarlayın. Örneğin:
CorpusCollector/1.0 (+contact: data@yourcompany.ru). Site sahibi kendisine kimin geldiğini ve nasıl iletişime geçeceğini anlamalıdır. Bu sadece etik değil, aynı zamanda pratiktir: anlaşılır bir ajan otomatik kısıtlamalara daha az yakalanır. - Duraklamaları uygulayın.
rate_per_minutedeğerinden temel duraklamayı hesaplayın:60 / rate_per_minutesaniye. İstekler metronom gibi gitmesin diye yüzde 20-40 rastgele bileşen ekleyin. robots.txt'deCrawl-delayvarsa, iki değerden maksimumu alın. - Rotasyonu uygulayın. İstekleri sayın ve sayaç
rotate_everydeğerine ulaştığında IP değiştirme bağlantısını çağırın, 10 saniye bekleyin, sayacı sıfırlayın. Bir sonraki kaynağa geçerken de rotasyon yapılmalıdır. - Yanıtları işleyin. 200 kodunu kaydedin. 301 ve 302 kodlarını
requestskendisi işler, ancak nihai adresi kaydedin: tekilleştirme için gerekli olacaktır. 404 kodunu günlüğe yazın ve atlayın. 429 veya 503 kodu "çok sık" anlamına gelir: 5 dakika ara verin, temel duraklamayı bir buçuk katına çıkarın ve bir kez tekrarlayın. Tekrar yardımcı olmazsa atlayın ve devam edin. - Ham HTML'yi pasaportuyla birlikte kaydedin. Her sayfa için
raw/help_center.jsonldosyasına bir satır yazın.
Kaydetme ve döngünün anahtar kod parçası:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))len(html) > 2000 koşuluna dikkat edin. İçerikli metne sahip bir sayfa neredeyse hiçbir zaman iki kilobayttan kısa HTML olmaz. Bu, çöpün ilk, en kaba filtresidir ve boş yanıtları ve yer tutucuları daha girişte ayıklar.
- Bir örnek üzerinde çalıştırın. İlk çalıştırmayı 50 adres üzerinde yapın. Günlüğe bakın, kaydedilen birkaç HTML'yi tarayıcıda açın. Bunların tam da o sayfalar olduğundan emin olun.
- Tam toplamayı başlatın. Sunucuda sürecin terminal kapanmasına dayanması için
nohup python fetch.py &veyascreenkullanın. Dakikada 12 istekle 3000 sayfa toplamak yaklaşık 4-5 saat sürer.
Dikkat: Aynı siteye bir proxy üzerinden paralel olarak birkaç toplayıcı kopyası çalıştırmayın. IP rotasyonu, kaynak sunucudaki yük limitlerini ortadan kaldırmaz. Hızlanmak istiyorsanız, tek bir site yerine farklı siteler arasında paralelleştirin.
İpucu: Günlüğe her isteğin yapıldığı proxy IP'sini kaydedin. Temizleme aşamasında bir grup kesik sayfa bulunduğunda, IP ve zamandan bunun belirli bir oturumun hatası olup olmadığını hemen görürsünüz ve yalnızca onu yeniden toplarsınız.
İpucu: Toplayıcıya sürdürme özelliği ekleyin: başlatmadan önce raw/*.jsonl dosyalarından zaten toplanmış adresleri okuyun ve onları atlayın. Böylece bağlantı kesilmesi veya sunucu yeniden başlatması sizi sıfırdan başlatmaz.
Kontrol: raw klasöründe bir JSONL dosyası var, satır sayısı günlükteki 200 durumlu adres sayısına yakın ve rastgele seçilen bir satır url, fetched_at, proxy_ip alanlarını ve tam HTML'yi içeriyor. Günlükteki hata ve atlama oranı yüzde 5'i geçmiyor.
Olası sorunlar
- Çok sayıda 429 yanıtı. Bu site için çok hızlısınız.
rate_per_minutedeğerini yarıya indirin, rotasyonun yeni adreslerden bir patlama gibi görünmemesi içinrotate_everydeğerini artırın. - Sayfalar durum 200 olmasına rağmen boş geliyor. İçerik JavaScript ile çiziliyor. Bu tür kaynaklar tarayıcı oluşturma gerektirir, ileri düzey bölümünde bundan bahsedilmiştir. Şimdilik
sources.jsondosyasındaneeds_js: truebayrağıyla işaretleyin. - Toplama devam ediyor ama çok yavaş. Adım 2'deki proxy gecikmesini kontrol edin, tipik gecikme 2 saniyeyken zaman aşımının 120 saniyeye ayarlanmadığından emin olun, aksi takdirde takılan her sayfa iki dakika yer.
- Betik kodlamada çöküyor.
r.textkullanın ver.encodingkontrol edin; site kodlamayı yanlış veriyorsa, okumadan öncer.encoding = r.apparent_encodingatayın.
Adım 4: HTML ve belgelerden temiz metin çıkarın
Aşamanın amacı: ham HTML ve dosyaları, sayfanın yalnızca ana içeriğinin kaldığı temiz metne dönüştürmek: başlık, paragraflar, listeler, tablolar, menüler, altbilgiler, reklam ekleri ve widget'lar olmadan.
Bu, veri seti kalitesinin doğduğu veya öldüğü andır. "Tüm etiketleri kaldır" gibi naif bir yaklaşım, metinde menü öğelerini, "Satın al" düğmelerini, çerez banner metnini ve benzer makale listelerini bırakır. Tüm bunlar daha sonra RAG sistemi cevaplarında yüzeye çıkar.
Web sayfaları için talimatlar
extract.pydosyasını oluşturun.raw/*.jsonldosyasını satır satır okur ve sonucuclean/*.jsonldosyasına yazar.- Ana metni çıkarmak için
trafilaturakütüphanesini kullanın. Sayfanın içerik alanını bulmak ve şablon bloklarını atmak için eğitilmiştir.
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }favor_precision=Trueparametresi kütüphaneyi daha katı olmaya zorlar: menüyü yakalamaktansa bir metin parçasını kaybetmeyi tercih eder. RAG sistemi veri seti için bu doğru seçimdir. Gerekli blokların, örneğin özellik tablolarının kaybolduğunu fark ederseniz, belirli bir kaynak içinfavor_recall=Trueseçeneğine geçin.- Yedek bir yöntem ekleyin.
trafilaturaNoneveya 200 karakterden kısa metin döndürürse, manuel olarak bulacağınız CSS seçicisiyle içeriği çıkarmayı deneyin: sayfayı tarayıcıda açın, F12'ye basın, ana metin bloğunu bulun, sınıfını kopyalayın, örneğinarticle-body. Yalnızca bu bloğu kesmek içinBeautifulSoupkullanın. Seçiciyisources.jsondosyasınacontent_selectorolarak yazın. - Metni normalleştirin. Bölünmez boşlukları normal boşluklarla değiştirin, üç veya daha fazla satır sonunu ikiye indirin, satırların başındaki ve sonundaki boşlukları kaldırın. Büyük/küçük harfi değiştirmeyin ve noktalama işaretlerini kaldırmayın: bu aramayı kötüleştirir.
- Orijinal meta verilerle birlikte kaydedin. Ham kayıttan
url,final_url,fetched_atkopyalayın,sources.jsondosyasındansource, çıkarmadan alanlar ve metin uzunluğunu karakter cinsinden ekleyin.
PDF ve DOCX için talimatlar
- PDF.
pypdfkullanın: dosyayı açın, sayfaları gezin,page.extract_text()çağırın ve birleştirin. Her parça için sayfa numarasını kaydedin: bu değerli meta verilerdir, kullanıcı orijinaldeki yeri bulabilir. Metin boş dönerse, PDF metin değil tarama içeriyordur: bu dosyaları ayrı bir klasöre ayırın, tanıma bu kılavuzun kapsamı dışındadır. - DOCX.
python-docxkullanın:document.paragraphsvedocument.tablesüzerinden geçin. Word'deki başlıklarHeading 1,Heading 2stiline sahiptir: bunları ayrı satırlar olarak işaretleyerek kaydedin, daha sonra belgeyi kesmek için kullanışlıdır. - Üstbilgi ve altbilgileri kaldırın. PDF talimatlarında her sayfada şirket adı, sürüm numarası ve "Sayfa 3 / 40" tekrarlanır. Belgenin tüm satırlarını toplayın, sayfaların yarısından fazlasında tekrarlananları bulun ve bunları silin.
Dikkat: Güzellik uğruna tabloları silmeyin. Talimatlar, tarifeler ve özelliklerde tam olarak tablolar belirli soruların cevaplarını içerir: "limit nedir", "ne kadar", "hangi port". Bunları satır satır koruyun, hücreleri sekme veya dikey çizgiyle ayırın.
İpucu: Çıkarmadan sonra 20 rastgele belge alın ve tamamen okuyun. Göz gezdirmeyin, okuyun. Böyle bir inceleme, herhangi bir otomatik filtreden daha fazla sistemik sorun bulur: örneğin, tüm blog sayfalarında metnin sonuna üç başlıklı "Ayrıca okuyun" bloğunun yapıştığını göreceksiniz.
Kontrol: clean klasöründe JSONL dosyaları var. Kayıt sayısı ham sayfa sayısının en az yüzde 80'i. Rastgele 10 kayıtta metin menü öğeleriyle değil, makalenin başlığı veya ilk paragrafıyla başlıyor ve "Tüm hakları saklıdır" imzasıyla değil, son içerikli paragrafla bitiyor.
Olası sorunlar
- Çok az metin çıkarılıyor. Standart dışı düzeni olan bir site.
content_selectorveBeautifulSoupüzerinden yedek bir yol ekleyin. - Metinde düğmeler ve menü öğeleri kalıyor.
favor_precisionetkinleştirin ve inatçı durumlar için bir durdurma satırları listesi ekleyin: "Paylaş", "Devamını oku", "Yukarı" gibi kısa satırları ayrı bir satırda duruyorlarsa silin. - PDF metni tersten veya kopuk kelimelerle veriyor.
pypdfyerinepdfplumberdeneyin, sütunlarla daha iyi çalışır.
Adım 5: Çöpü filtreleyin: tekilleştirme, şablonlar, kalite, dil
Aşamanın amacı: kopyaları, yer tutucuları, şablon bloklarını, yabancı dildeki metinleri ve çok kısa veya bozuk belgeleri ayıklayarak yalnızca bilgi taşıyanları bırakmak.
Dikkatli çıkarmadan sonra bile veri setinde yüzde 15 ila 40 arasında çöp kalır. Bu normaldir. Anormal olan, onu indekse kaçırmaktır.
Talimatlar
clean/*.jsonldosyasını okuyan, filtreleri sırayla uygulayan, geçen belgelericorpus/filtered.jsonldosyasına, ayıklananları sebep belirterekcorpus/rejected.jsonldosyasına yazan birfilter.pydosyası oluşturun.- Filtre 1: minimum uzunluk. 300 karakterden kısa belgeler neredeyse her zaman yer tutucu, özet veya çıkarma hatasıdır.
too_shortsebebiyle ayıklayın. Ürün kartları için eşik 150'ye düşürülebilir. - Filtre 2: yer tutucu durdurma ifadeleri. Sayfanın boş olduğunu gösteren ifadelerden bir liste yapın: "sayfa bulunamadı", "ürün mevcut değil", "erişim kısıtlı", "javascript'i etkinleştirin", "teknik çalışma var". Böyle bir ifade ilk 300 karakterde geçiyorsa ve tüm metin 1500 karakterden kısaysa,
placeholdersebebiyle ayıklayın. - Filtre 3: dil. İlk 1000 karakterde
langdetect.detectkullanın. Dil, kaynakta belirtilenle eşleşmiyorsa,wrong_langsebebiyle ayıklayın. Dedektörün kısa metinlerde hata yaptığını unutmayın, bu nedenle uzunluk filtresinden sonra uygulayın. - Filtre 4: tam kopyalar. Metni normalleştirin: küçük harf, boşlukları daralt, noktalama işaretlerini kaldır.
sha1hesaplayın. Karma zaten görüldüyse,exact_dupsebebiyle ayıklayın ve orijinaline bir bağlantı kaydedin. Tipik tam kopya kaynakları:httpvehttpsüzerinden aynı sayfa,wwwile ve olmadan,?utm_sourceparametresiyle ve olmadan, ayrıca yazdırma sayfaları. - Filtre 5: neredeyse kopyalar. Burada
datasketchkütüphanesinden MinHash gerekir. Normalleştirilmiş metni 5 kelimelik shingle'lara bölün, 128 permütasyonluMinHasholuşturun, 0.85 eşiğiyleMinHashLSHiçine koyun. İndekste zaten benzer bir komşusu olan belgeyinear_dupsebebiyle ayıklayın. Böylece farklı tarihli aynı makalenin versiyonları, yalnızca rengi farklı ürün sayfaları ve yeniden yayınlanan haberler gider.
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- Filtre 6: şablon satırları. Bir kaynağın tüm belgelerinin tüm satırlarını toplayın ve her birinin belgelerin yüzde kaçında geçtiğini sayın. Belgelerin yüzde 30'undan fazlasında geçen ve 200 karakterden kısa satırlar şablondur: yasal uyarılar, imzalar, abone olma çağrıları. Bunları tüm belgelerden silin. Bu, belgenin ayıklanması değil, içindeki temizliktir.
- Filtre 7: metin kalitesi. Basit metrikleri hesaplayın: tüm karakterler içinde harf oranı 0.6'dan yüksek olmalı; ortalama kelime uzunluğu 3 ile 12 arasında; makaleler için noktayla biten satırların oranı 0.3'ten yüksek. Bu sınırların dışındaki belgeler genellikle kod dökümleri, dökümler veya bozuk çıkarmalardır.
low_qualitysebebiyle ayıklayın, ancak ayıklananları mutlaka gözlerinizle inceleyin: teknik dokümantasyon için eşikler yumuşatılmalıdır. - Filtre 8: kesik sayfalar. Ham kayıttaki
html_lendeğerini kaynağın medyanıyla karşılaştırın. HTML medyanın yüzde 30'undan kısaysa ve metin cümlenin ortasında nokta olmadan kesiliyorsa, bu kesik bir yanıttır. Sebeptruncated. Bu adreslerirecollect.txtdosyasına yazın ve Adım 3'te proxy üzerinden yeniden toplayın. - Filtreyi çalıştırın ve raporu inceleyin. Betik bir tablo yazdırmalıdır: girişte kaç belge, her sebepten kaç tanesi ayıklandı, kaç tane kaldı.
Dikkat: Filtreleme sırasında clean ve raw dosyalarını asla silmeyin. Filtre yalnızca yeni dosyalar yazar. MinHash eşiği çok agresif çıktıysa ve faydalı belgelerin yüzde 40'ını kaybettiyseniz, sadece sayıyı değiştirir ve betiği iki dakika içinde yeniden çalıştırırsınız.
İpucu: Neredeyse kopyalar için 0.85 eşiği makaleler ve yardım için iyidir. Yalnızca boyut veya hacim açısından farklılık gösteren aynı markanın ürün kartları için bunları bir taneye indirger. RAG sisteminizin tüm varyantlara ihtiyacı olup olmadığına önceden karar verin ve ya eşiği 0.95'e yükseltin ya da varyantları çıkarma aşamasında farklar tablosuyla tek bir belgede birleştirin.
İpucu: Ayıklanan belgeler atık değil, hata ayıklama malzemesidir. Haftada bir rejected.jsonl dosyasını açın, sebebe göre filtreleyin ve 10 rastgele kayda bakın. low_quality arasında düzenli olarak faydalı tarife tabloları çıkıyorsa, eşikler düzeltilmelidir.
Kontrol: Filtre raporu makul bir tablo gösteriyor: toplam ayıklama yüzde 10 ila 40, bunların önemli bir kısmı kopyalar ve truncated sebebi yüzde 2-3'ü geçmiyor. filtered.jsonl dosyasında aynı normalleştirilmiş metne sahip iki belge yok ve rastgele 10 kayıt tamamlanmış makaleler veya dokümantasyon bölümleri gibi görünüyor.
Olası sorunlar
- Ayıklama yüzde 60'tan fazla. Muhtemelen kalite eşikleri çok katı veya tüm metinlerin benzer hale geldiği bir normalleştirme hatası. 20 rastgele ayıklanmış belgeyi yazdırın ve sistemik nedeni bulun.
- MinHash çok uzun sürüyor. 100 binden fazla belge içeren veri setinde
num_permdeğerini 64'e düşürün veya kaynak başına ayrı sayın. - Dil dedektörü Rusça metinleri Bulgarca veya Makedonca olarak işaretliyor. Bu, çok sayıda özel isim içeren kısa parçalarda olur. Dili ilk 2000 karakterde kontrol edin ve yakın diller grubundan herhangi birini eşleşme olarak kabul edin.
Adım 6: Meta verileri etiketleyin ve son veri setini oluşturun
Aşamanın amacı: her belgenin kararlı bir kimliğe, tam bir meta veri kümesine sahip olduğu ve indeksleme hattına aktarılmaya hazır olduğu tek bir corpus/corpus_v1.jsonl dosyası elde etmek.
Meta veriler, bir veri setini bir metin yığınından ayıran şeydir. Tek tek kaynakları güncellemenize, kullanıcıya cevabın kaynağını açıklamanıza, tarih ve bölüme göre filtrelemenize ve en önemlisi bir ay sonra tüm işi baştan yapmamanıza olanak tanır.
Talimatlar
- Belge şemasını tanımlayın.
schema.mddosyasına sabitleyin ve veri seti sürümü olmadan değiştirmeyin. Önerilen minimum:
doc_id: kararlı tanımlayıcı, örneğinfinal_url'ninsha1'i, böylece yeniden toplamada belge aynı kimliği alır;source:sources.jsondosyasından kaynak adı;urlvefinal_url;title;section: öneğe göre yolun ilk bölümünden hesaplanan site bölümü, örneğinhelp/proxies;lang;published_at: çıkarıldıysa yayın tarihi;fetched_at: toplama tarihi;geo: toplandığı proxy bölgesi;text;text_len,text_sha1;corpus_version: örneğinv1.
- Bölümü hesaplayın.
final_url'yiurllib.parse.urlparseile ayrıştırın, yolu alın, kaynak önekini kaldırın, bir iki segment bırakın. Bölüm daha sonra RAG sisteminde bir filtre olacak: kullanıcı ödeme hakkında sorarsa, arama önceliklebillingbölümünde yapılır. - Tarihleri normalleştirin. Tüm tarihleri UTC'de ISO 8601'e getirin. Yayın tarihi bulunamazsa, alanı boş bırakın, toplama tarihini koymayın: bunlar farklı şeylerdir ve eski materyalleri filtrelerken karıştırmak tehlikelidir.
- Başlığı metne ekleyin.
texttitleile başlamıyorsa, başlığı ilk satır olarak ekleyin. Başlık, arama için önemli olan anahtar kelimeleri taşır. - Sıralayın ve kaydedin. Belgeleri
sourcevefinal_url'ye göre sıralayın,corpus/corpus_v1.jsonldosyasına yazın. Yanına kaynak başına belge sayısı, toplama tarihi, şema sürümü ve filtre parametrelerini içerencorpus/manifest_v1.jsondosyasını koyun. - Arşiv yapın.
corpus,sources.json,schema.mdvelogsklasörünü arşivleyin. Bu arşiv, veri setinizin yeniden üretilebilir sürümüdür.
İpucu: Kişisel verileri veri setinin dışında tutun. Yardım metinlerinde "Ahmet Yılmaz, +90 500..." gibi örnekler geçiyorsa, bunları veri seti toplama aşamasında yer tutucularla değiştirin. RAG sistemi, açık kaynakta olsa bile birinin telefon numarasını verme yeteneğine sahip olmamalıdır.
Kontrol: corpus_v1.jsonl dosyası açılıyor, her satır şemadaki alanlarla geçerli JSON, tüm belgelerin doc_id'si benzersiz, tümünde source, lang, fetched_at, text dolu. manifest_v1.json dosyası satır sayısıyla eşleşen bir özet içeriyor.
Olası sorunlar
- Farklı adresler aynı belgeye gidiyor ve farklı doc_id veriyor. Kimliği yönlendirmelerden sonra
final_url'den hesaplayın, sorgu parametrelerini ve sonundaki eğik çizgiyi kaldırın. - Tarihler farklı formatlarda çıkarılıyor. Rusça kaynaklar için
dayfirst=Trueparametresiyledateutil.parser.parsekullanın.
Sonucu doğrulama: kontrol listesi ve veri seti testi
Veri seti toplandı. İndekslemeye götürmeden önce, onu bir dosya olarak değil, bir ürün olarak kontrol edelim.
Kontrol listesi
- Her kaynağın sınırlarını ve limitlerini belirten
sources.jsondosyası var. - Tüm istekler mobil proxy üzerinden gitti, günlükte her isteğin
proxy_ip'si var. - Günlüğe göre toplama hata oranı yüzde 5'i, 429 yanıtları yüzde 1'i geçmiyor.
- Ham sayfalardan en az yüzde 80 belge çıkarıldı.
- Filtrelemede ayıklama yüzde 10 ila 40, tüm ayıklama sebepleri adlandırılmış.
- Veri setinde normalleştirilmiş metne göre tam kopya yok.
- Her belgede zorunlu meta veriler dolu.
- Ham veriler, veri seti, günlükler ve ayarlarla birlikte bir arşiv var.
Nasıl test edilir
- Adım 1'deki sorularla test. 20-30 sorunuzu alın. Her biri için basit alt dize araması veya
grepile veri setinde cevabı içeren belgeyi bulun. Hedef: soruların en az yüzde 90'ı kapsanıyor. Soru kapsanmıyorsa, cevabı tarayıcıda bulun ve neden girmediğini araştırın: site haritasında yok muydu, filtreler mi ayıkladı, metin mi kesildi. - Çöp testi. Veri setinde "abone ol", "sepet", "çerez", "tüm hakları saklıdır", "ayrıca okuyun" dizelerini bulun. Her oluşum bir şüphedir. İçerikli metnin parçasıysa birkaç tanesi kabul edilebilir; onlarca oluşum, şablon filtresinin iyileştirilmesi gerektiği anlamına gelir.
- Kesilme testi. Metni nokta, ünlem, soru işareti veya kapanış paranteziyle bitmeyen belgeleri sayın. Yüzde 5'ten az olmalı. Kalanlara gözlerinizle bakın.
- Dağılım testi. Belge uzunluklarının histogramını çıkarın. Sağlıklı bir yardım veya blog veri seti 2-8 bin karakter civarında bir tepe ve uzun bir kuyruk gösterir. Minimum eşik civarında keskin bir tepe, sızan yer tutucuları gösterir.
- Coğrafya testi. İçerik bölgeye bağlıysa, fiyat veya stok içeren 5 sayfa açın ve istenen şehirden bir kişinin gördüğüyle karşılaştırın. Tutarsızlıklar, proxy'nin başka bir bölgeden seçildiğini veya sitenin bölgeyi IP'ye göre değil çerezlere göre belirlediğini gösterir.
Başarılı uygulama göstergeleri
Veri seti hazırdır, eğer test sorularının kapsamı yüzde 90'ın üzerindeyse, çöp belirtisi olan belgelerin oranı yüzde 3'ün altındaysa ve manifest derlemeyi tamamen yeniden üretmeye olanak tanıyorsa. Ancak bundan sonra veri seti RAG sisteminin indeksleme hattına aktarılır.
RAG için veri seti toplamada tipik hatalar ve çözümleri
Sorun: asistanın cevaplarında menü öğeleri ve abone olma çağrıları görünüyor. Nedeni: metin çıkarma kesinlik değil, bütünlük modunda çalıştı, şablon filtresi çalıştırılmadı. Çözümü: favor_precision etkinleştirin, kaynak belgelerinin yüzde 30'undan fazlasında tekrarlanan satırların kaldırılmasını uygulayın, yeniden indirmeden raw dosyasından clean dosyasını yeniden oluşturun.
Sorun: asistan eski talimat sürümüne göre cevap veriyor. Nedeni: veri setinde hem eski hem yeni makale sürümü yaşıyor, neredeyse kopyalar ayıklanmadı veya eşik çok yüksek. Çözümü: sürümleme olan kaynaklar için MinHash eşiğini 0.8'e düşürün, çakışmada daha sonraki published_at tarihli belgeyi bırakın.
Sorun: sayfaların bir kısmı boş toplandı, durum 200. Nedeni: içerik tarayıcı tarafında JavaScript ile oluşturuluyor. Çözümü: kaynağı needs_js olarak işaretleyin ve ileri düzey bölümdeki Playwright ile oluşturmayı kullanın veya sitenin içeriği hazır verdiği bir API veya RSS'sini bulun.
Sorun: toplama 429 ve 503 hatalarında duruyor. Nedeni: istek sıklığı çok yüksek, IP rotasyonu yükü azaltmak yerine kullanıldı. Çözümü: sıklığı dakikada 6-8 isteğe düşürün, rastgele duraklama dağılımını artırın, ilk 429'da 5-10 dakika ara verin. Yük limitinin kaynağa saygıyla ilgili olduğunu, adres sayısıyla ilgili olmadığını unutmayın.
Sorun: rotasyondan sonra site başka bir bölgenin içeriğini gösteriyor. Nedeni: mobil proxy başka bir şehrin IP'sini verdi veya site bölgeyi önceki oturumun çerezlerinden belirledi. Çözümü: proxy hesabınızda istenen bölgeyi sabitleyin, her rotasyondan sonra requests oturumunu sıfırlayın, böylece çerezler taşınmaz.
Sorun: veri seti toplandı ama soru kapsamı yüzde 60. Nedeni: kaynak sınırları çok dar tanımlandı, faydalı sayfalar öneklere göre ayıklandı. Çözümü: kapsanmayan soruları alın, cevapları tarayıcıda bulun, adreslerine bakın ve include_prefixes öneklerini genişletin.
Sorun: tekilleştirme, özellikleri farklı olan ürün kartlarını yedi. Nedeni: neredeyse kopya eşiği benzer metinler için çok düşük. Çözümü: katalog kaynakları için eşiği 0.95'e yükseltin veya bir ürünün varyantlarını çıkarma aşamasında tek bir belgede birleştirin.
Sorun: PDF metinleri paragrafsız tek bir satır olarak geliyor. Nedeni: pypdf biçimlendirmeyi kaybediyor. Çözümü: pdfplumber veya pymupdf'e geçin, paragrafları çift satır sonları ve girintilerle yeniden oluşturun.
Sorun: veri setine kişisel veriler girdi. Nedeni: anonimleştirme aşaması yoktu. Çözümü: veri setine yazmadan önce telefon, e-posta ve isimleri basit kalıplarla arayıp yer tutucularla değiştirme ekleyin; şüpheli belgeleri manuel incelemeye gönderin.
İleri düzey kullanıcılar için ek olanaklar
Temel hat çalışıyorsa, işte geliştirme yönleri.
Proxy üzerinden JavaScript ile sayfa oluşturma
pip install playwright ve playwright install chromium komutlarını çalıştırın. Tarayıcıyı proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS} parametresiyle başlatın. Sabit saniyeler yerine page.wait_for_selector ile ana içerik seçicisini bekleyin. page.content()'i alın ve sonraki adımların değişmemesi için aynı raw formatına kaydedin. Oluşturma normal isteklerden 5-10 kat daha yavaştır, bu nedenle yalnızca needs_js bayraklı kaynaklara uygulayın ve sıklığı dakikada 3-5 sayfaya düşürün.
Veri setinin artımlı güncellenmesi
Manifestte her belgenin text_sha1'ini saklayın. Bir sonraki toplamada sayfaları indirin, ancak yalnızca HTML karması değişenleri veya toplanmasından 30 günden fazla geçenleri çıkarın ve filtreleyin. If-Modified-Since ve ETag başlıklarını kullanın: birçok site gövdesiz 304 döndürür ve proxy trafiğinden tasarruf edersiniz. Her güncelleme yeni bir veri seti sürümü alır: v2, v3 ve eski arşivler silinmez.
Çok bölgeli veri seti
İşletmenin şubeleri varsa ve kaynak içeriği şehre bağlıysa, farklı coğrafyalara sahip birkaç mobil proxy oluşturun. Aynı sayfayı her bölgeden toplayın, meta verilerde geo saklayın ve yalnızca bölge içinde tekilleştirin. RAG sistemi daha sonra gerçek bölgesel sayfa sürümlerine dayanarak "Kazan'da teslimat 2 gün, Novosibirsk'te 4 gün" cevabını verebilir.
Katı eşikler yerine kalite etiketleme
Eşiklere göre ayıklamak yerine, her belge için aynı metriklerden 0 ile 1 arasında bir kalite puanı hesaplayın: uzunluk, harf oranı, tamamlanmış cümle oranı, satır tekrarlanabilirliği. Puanı meta verilerde saklayın. Böylece indeksleme hattı neyi alacağına kendisi karar verebilir ve arama güvenilir belgeleri daha yüksek sıralayabilir.
Anlamsal tekilleştirme
MinHash sözcüksel kopyaları yakalar. Aynı talimatın farklı kelimelerle yeniden anlatımlarını kaçırır. Bunları yakalamak için belgelerin gömmelerini hesaplayın ve kosinüs benzerliği 0.95'in üzerinde olan çiftleri arayın. Bu zaten indeksleme aşamasıyla sınırdır, bu nedenle burada sadece bir uyarı: sınırı nerede çizeceğinize karar verin ve aynı işi iki kez yapmayın.
Toplama izleme
Günlükten metrikleri çıkarın: dakikada istek, 200 kod oranı, ortalama gecikme, rotasyon sayısı. matplotlib ile basit bir kontrol paneli veya terminalde 10 dakikada bir tablo, sabah 500 boş sayfa bulmadan önce bozulmayı gösterecektir.
SSS: veri seti toplama hakkında sık sorulan sorular
Veri seti toplamak için mobil proxy kullanmak zorunlu mu? Kendi belgeleriniz ve küçük kaynaklar için gerekli değil. Proxy, kaynaklar çok olduğunda, toplama saatler sürdüğünde, içeriğin bölgesel sürümü önemli olduğunda veya tek bir adresten siteye belirgin yük yaratmak istemediğinizde gerekli hale gelir.
Toplama sırasında IP ne sıklıkla değiştirilmeli? Kılavuz: her 30-60 istekte veya başka bir kaynağa geçerken. Daha sık gerekmez: rotasyonun amacı yük dağıtımı ve oturum kararlılığıdır, sıklık değil. Genel hızı düşürmeden sık rotasyon yükü azaltmaz.
Çalışan bir RAG sistemi için kaç belge gerekir? Tek bir ürün asistanı için genellikle 200-500 kaliteli belge yeterlidir. Geniş bir niş için birkaç bin. Kalite hacimden önemlidir: 500 temiz makale, çöplü 20 binden daha iyi cevaplar verir.
Sosyal medya ve pazar yerlerinden veri toplanabilir mi? Yalnızca platformun kuralları ve robots.txt sınırları içinde açık sayfalar, kişisel veriler olmadan. Birçok platformun içerik almak için resmi API'leri vardır, onlarla başlayın.
Resimler ve videolarla ne yapmalı? Metin veri seti kapsamında yalnızca başlıkları, alt metinleri ve varsa transkriptleri saklayın. Dosyaların kendisi veri setine girmez.
Neden bir indirme programıyla tüm siteyi indiremiyorum? İndirebilirsiniz, ancak meta veriler olmadan, kopyalarla, hizmet sayfalarıyla ve günlük olmadan on binlerce dosya alırsınız. Sonra bu kılavuzun tüm adımlarını ters sırayla yapmanız gerekir, sadece daha zor.
Filtrelerin gerekli olanı silmediğini nasıl anlarım? Her sebep için rejected.jsonl dosyasına bakın, 10-20 kayıtlık bir örnek. Ve test sorularının kapsamını kontrol edin: cevaplar kaybolduysa, ayıklananlar arasında arayın.
Bu aşamada belgeleri parçalara bölmek gerekli mi? Hayır. Parçalara ayırma, indekslemenin bir parçasıdır ve gömme modeline ve bağlam boyutuna bağlıdır. Veri setinin görevi, parçalayıcının anlamlı bir şekilde kesebileceği başlık işaretleri ve meta verilerle tam belgeler sağlamaktır.
Her şeyi yeniden toplamadan veri seti nasıl güncellenir? Karmaları saklayın, If-Modified-Since koşullu isteklerini kullanın, veri setini sürümleyin. Daha fazla ayrıntı ileri düzey bölümde.
Site robots.txt'de otomatik toplamayı yasaklıyorsa ne yapmalı? Yasağa saygı gösterin. Site sahibine yazın, genellikle bir dışa aktarma, API veya izin verir. Kaynak kurallarına aykırı toplanan bir veri seti, tüm proje için risk oluşturur.
Sonuç: ne yapıldı ve bundan sonra nereye
Fikirden hazır veri setine kadar tüm yolu kat ettiniz. Sınırları belirlediniz ve limitler ve coğrafya ile kaynak haritası oluşturdunuz. Mobil proxy'yi bağladınız ve rotasyonun çalıştığından emin oldunuz. robots.txt'e uyan, yükü dağıtan ve ayrıntılı günlük tutan kibar bir toplayıcı yazdınız. HTML, PDF ve DOCX'ten temiz metin çıkardınız. Kopyaları, yer tutucuları, şablonları ve bozuk sayfaları adlandırılmış sebeplerle ayıkladınız. Meta verileri etiketlediniz ve manifestli sürümlenmiş bir veri seti oluşturdunuz. Gerçek sorularla test ettiniz.
Ana sonuç, diskteki dosya değil, yeniden üretilebilir süreçtir. Bir ay sonra tekrar çalıştırırsınız ve güncellenmiş veri setini bir haftada değil, birkaç saatte alırsınız. Ve RAG sistemi garip cevaplar vermeye başladığında, sorunun nerede aranacağını tam olarak bilirsiniz: toplama günlüğünde, filtre raporunda veya manifestte.
Bundan sonra ne yapmalı. corpus_v1.jsonl dosyasını indeksleme hattına aktarın: parçalara ayırma, gömmeler, vektör veritabanı. Bununla ilgili blogdaki ilgili makalelerde. Toplayıcının artımlı güncellemeyle düzenli çalışmasını ayarlayın. Kapsanmayan soruların sayısı arttıkça kaynak haritasını genişletin. İşletme bölgeselse, gerekli şehirlerin proxy'lerini ekleyin ve içeriğin bölgesel sürümlerini toplayın.
Nereye geliştirmeli. Karmaşık siteler için tarayıcı oluşturmayı, katı eşikler yerine belge kalitesi değerlendirmesini, anlamsal tekilleştirmeyi ve toplama izlemeyi öğrenin. Bu adımların her biri, modeli değiştirmekten daha güçlü bir şekilde cevapların kalitesini artırır. Temiz veriler, sahip olduğunuz en ucuz RAG sistemi iyileştirmesidir. İyi toplamalar.