Site anti-bot koruması: Ne kurmalı ve sizi parse ediyorlarsa nasıl uygulamalı
Makale içeriği
- Giriş: siteniz başkasının veritabanına dönüştüğünde
- Temeller: anti-bot koruması nedir ve kimi korur
- Derinlemesine bakış: modern bir anti-bot sistemi ziyaretçiyi nasıl "görür"
- Yöntem 1. teşhis: sizi kimin ve nasıl parse ettiğini öğrenmek
- Yöntem 2. birinci hat: sunucu ve ağ seviyesi
- Yöntem 3. i̇kinci hat: i̇stemci doğrulama ve challenge'la
- Yöntem 4. üçüncü hat: davranış, tuzaklar ve verilerin kendisinin korunması
- Anti-bot koruması uygularken tipik hatalar
- Uygulama için araçlar ve kaynaklar
- Vakalar: bunun gerçek projelerde nasıl çalıştığı
- Sss: zor sorulara yanıtlar
- Sonuç: bir satın alma değil, bir süreç olarak koruma
Giriş: Siteniz başkasının veritabanına dönüştüğünde
Bir düşünün: altı ay boyunca bir katalog oluşturdunuz, fiyatları tek tek doğruladınız, ürün kartları yazdınız, filtreleri yapılandırdınız. Sonra fark ediyorsunuz ki bir rakip fiyatlarını sizinkinden yirmi dakika sonra güncelliyor ve arama sonuçlarında sizin açıklamalarınızı kelimesi kelimesine kopyalayan siteler beliriyor. Sunucu yük altında inliyor, hosting faturası şişiyor ve analitikler geceleri hiç müşterinizin olmadığı bölgelerden garip trafik artışları gösteriyor. Tanıdık geldi mi? Bu scraping. Ve bu varsayımsal bir tehdit değil, değerli bir şeye sahip olan her sitenin günlük gerçeği.
Son yıllardaki sektör raporlarına göre, otomatik trafik internetteki tüm isteklerin yaklaşık yarısını oluşturuyor ve toplam hacmin yaklaşık üçte biri açıkça zararlı botlara ait. E-ticaret, ilan siteleri, seyahat projeleri ve içerik platformları için bu oran daha da yüksek olabiliyor. Üstelik 2026 trendi net: klasik scraper'lara büyük dil modelleri tabanlı ajanlar eklendi; bunlar sitelerde insanlardan farksız geziyor, içeriği okuyor ve karar veriyor. "Canlı" ve "otomatik" ziyaretçi arasındaki sınır gözümüzün önünde siliniyor.
mobileproxy.space kitlesi bu konuyu her iki taraftan da biliyor. Pazarlamacılar ve arbitrajcılar kendileri veri topluyor, geliştiriciler collector yazıyor, işletme sahipleri rakiplerini izliyor. Ama muhtemelen her birinizin kendi sitesi, iniş sayfası, katalogu veya API'si var ve şu anda birileri onları çoktan çekiyor. Bu yüzden bu yazıda bakış açımızı değiştiriyoruz: bugün sizi parse ediyorlar ve biz site anti-bot korumasını gerçek kullanıcıların hayatını zorlaştırmayacak, çalışacak şekilde nasıl kuracağınızı ele alıyoruz.
Önemli bir not. Satıcıları karşılaştırmıyor ve ticari hizmet sıralamaları yapmıyoruz — blogda buna ayrılmış bir yazı var. Burada konu uygulama: hangi koruma seviyeleri var, hangi sırayla kurulmalı, etki nasıl ölçülür ve her adımda hangi tuzaklar bekliyor. Yazının sonunda elinizde şunlar olacak:
- modern anti-bot sistemlerinin bir ziyaretçiyi nasıl "gördüğünü" ve IP bloğunun neden çoktan çözüm olmaktan çıktığını anlama;
- teşhis metodolojisi: bir günde sizi kimin ve nasıl parse ettiğini nasıl öğrenirsiniz;
- sunucu tarafı rate limiting'den davranışsal analize ve verilere yerleştirilen tuzaklara kadar adım adım talimatlarla üç savunma hattı;
- dönüşümü çökertmeden aşamalı uygulama çerçevesi;
- kontrol listeleri, araç listesi ve rakamlarla gerçek vaka incelemeleri.
Rahatınıza bakın. Yazı uzun ama her aşamada geri döneceğiniz bir çalışma yer imi olarak tasarlandı.
Temeller: Anti-bot koruması nedir ve kimi korur
Botlar farklıdır ve hepsini engellememek gerekir
İlk kabul edilmesi gereken şey: bot bir hakaret değildir. Arama motoru botları sayfalarınızı dizinler ve trafik getirir. Erişilebilirlik izleme, sitenin ayakta olduğunu kontrol eder. Ödeme sistemleri webhook çağırır. İş ortağı toplayıcılar sözleşmeyle feed çeker. Bunların hepsi ihtiyacınız olan ve işinize yarayan otomatik trafiktir. Site anti-bot korumasının işi otomasyonu bir olgu olarak yok etmek değil, faydalı ve izin verilebilir istekleri zararlılardan ayırmak ve zararlı olanları ekonomik açıdan anlamsız hale getirmektir.
İstenmeyen botlar kabaca birkaç kategoriye ayrılır:
- İçerik ve fiyat scraper'ları — kataloğu, açıklamaları, stokları, fiyatları, yorumları çekerler. Bu yazının ana karakteri.
- Sözleşmesiz toplayıcılar — verilerinizi alıp üçüncü kişilere erişim olarak satarlar.
- Hesap bilgisi deneme botları — sızmış kullanıcı adı-şifre çiftlerini deneyerek giriş formlarına saldırırlar.
- Scapler ve stok "sniper"ları — kıt ürünleri satın alır veya slotları saniyeler içinde rezerve ederler.
- Spam botları ve metrik şişiriciler — formları doldurur, sahte hesaplar açar, metrikleri bozarlar.
- Yapay zeka modeli crawler'ları — metni eğitim veya gerçek zamanlı yanıtlar için toplarlar. İzin verilebilirliğini her işletme kendisi belirler.
Dikkat edin: scraping tek başına nadiren siteyi bozar. Ama parazit yük yaratır (bazen kataloğa gelen tüm isteklerin %60-80'ine kadar), analitiği bozar, sayfa render ederken çağırdığınız dış API limitlerini tüketir ve en önemlisi, bu verileri topladığınız rekabet avantajını elinizden alır.
Scraping koruması ile DDoS koruması arasındaki fark
Birçok site sahibi bu iki görevi eşitleştirir ve anti-DDoS filtresinin neden scraper'ı geçirdiğine şaşırır. Fark temeldir. DDoS bir hacim darbesidir: saldırganın amacı kanalı veya sunucu kaynağını tüketmektir. Böyle bir saldırıyı metriklerden kolayca fark edersiniz ve ağ katmanında filtrelenir. Parser ise tam tersine görünmez olmaya çalışır: istekleri zamana yayar, on binlerce adrese dağıtır, tarayıcıyı taklit eder ve canlı insanların girdiği URL'leri ziyaret eder. Klasik DDoS filtresi düzgün, "sağlıklı" trafik görür ve geçirir. Bu yüzden bot koruması temelde farklı sinyaller gerektirir — bunları bir sonraki bölümde konuşacağız.
Üç savunma hattı: Kullanacağımız model
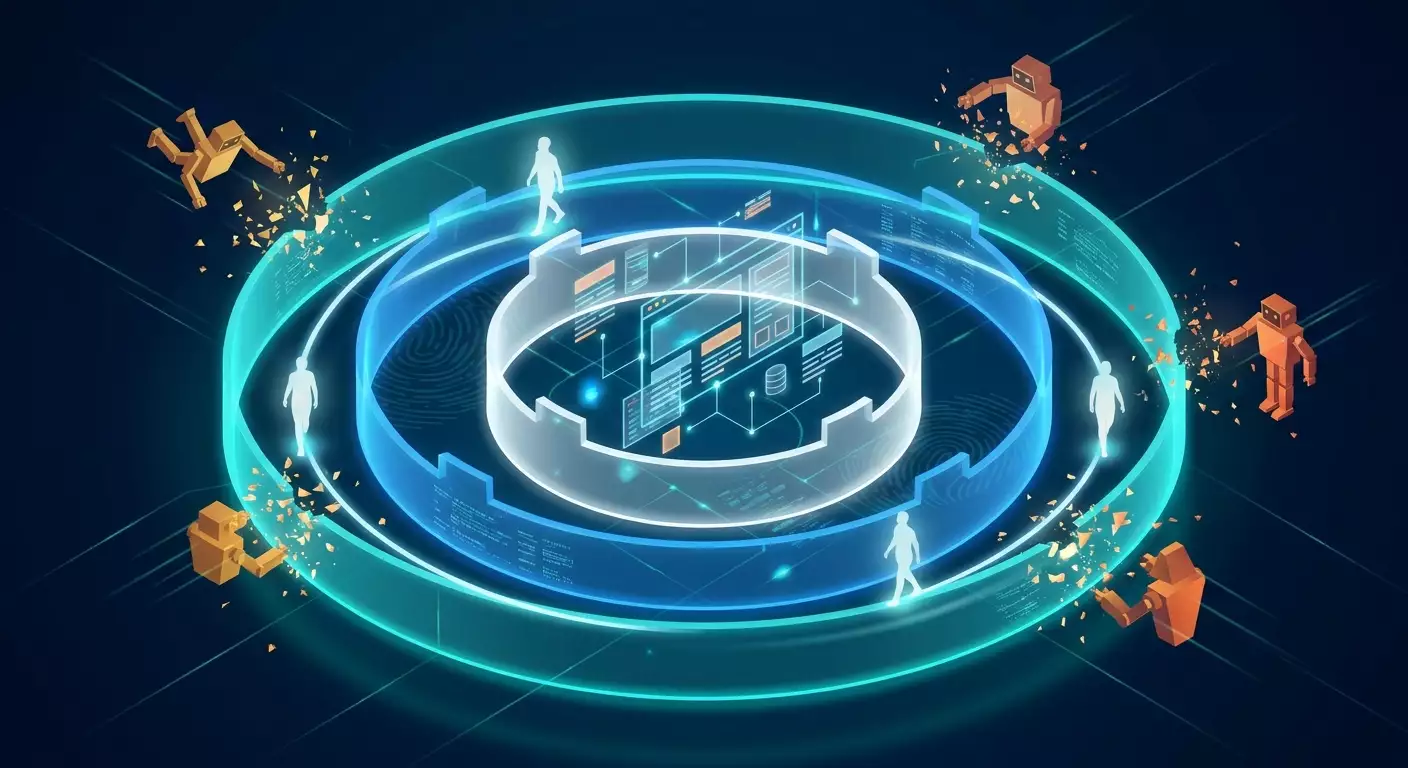
Teknolojide boğulmamak için site anti-bot korumasını üç eş merkezli katman olarak düşünmek faydalıdır. Benzetme ortaçağ kalesi: hendek ve dış duvar, kapıda nöbetçi ve son olarak kapıdan giren misafirin bile gözetim altında olduğu iç odalar.
- Ağ ve sunucu seviyesi. İstek hızı sınırlama, ağ itibarına göre filtreleme, WAF, başlıklara göre temel kurallar. Ucuz, hızlı, en basit botları keser.
- İstemci doğrulama seviyesi. JavaScript challenge'ları, TLS ve tarayıcı parmak izi analizi, doğru yerlerde captcha, iş kanıtı görevleri. Tarayıcısı olmayan scriptleri ve kötü yapılandırılmış headless araçlarını keser.
- Davranışsal seviye ve veri koruması. Eylem dizileri analizi, oturum puanlaması, honeypot tuzakları, verilerin obfuscation'ı ve filigranlanması. İlk iki turu geçen gelişmiş botlara karşı çalışır.
Sürekli geri döneceğimiz kilit nokta şu: tek başına hiçbir katman yeterli değildir. Güç, botun aynı anda üçünü de atlatmak zorunda kalmasında ve her ek engelin işinin maliyetini artırmasında. Sizi parse etmek verileri yasal yoldan satın almaktan veya başka şekilde toplamaktan daha pahalı hale geldiğinde scraping durur. Bu sihir değil, ekonomi.
Bundan sonra karşılaşacağınız temel terimler
- Rate limiting — bir kaynaktan birim zamanda gelen istek sayısını sınırlama.
- WAF (Web Application Firewall) — HTTP isteklerini kurallara göre filtreleyen uygulama katmanı güvenlik duvarı.
- Fingerprint (parmak izi) — istemcinin türünü veya belirli bir örneğini tanımlamayı sağlayan özellikler kümesi.
- Headless tarayıcı — grafik arayüzü olmayan, programatik olarak yönetilen tam tarayıcı.
- Challenge — erişim almak için istemcinin çözmesi gereken doğrulama görevi.
- False positive (yanlış pozitif) — korumanın canlı bir kullanıcıyı engellediği durum.
- Honeypot — tuzak: insan için görünmez, otomatik istemci için fark edilir olan öğe.
Derinlemesine bakış: Modern bir anti-bot sistemi ziyaretçiyi nasıl "görür"
Korumayı bilinçli kurmak için hangi sinyallere dayandığını anlamak gerekir. İşte asıl ilginç kısım burada başlıyor: son beş yılda sektör "IP'yi banla"dan yüzlerce özelliğe göre karar veren çok katmanlı puanlamaya geçti. Temel sinyal gruplarını inceleyelim.
Ağ sinyalleri ve IP'nin neden artık ana faktör olmadığı
Tarihsel olarak botun ilk işareti IP adresiydi. Veri merkezinden istekler mi? Muhtemelen script. Tek adresten bin istek mi? Kesinlikle script. Bu yaklaşım hâlâ doğrudan bulut sunucularından gelen tembel parser'lara karşı işe yarar ve uygulanmalıdır. Ama iki temel sınırlaması var.
Birincisi: yerleşik ve mobil adresler. Bu blogun kitlesi çoğundan iyi bilir ki, tek bir mobil operatör IP'si NAT sayesinde aynı anda birkaç bin gerçek aboneyi barındırabilir. Böyle bir adresi tek bir şüpheli istemci yüzünden bloklamak, şehrin bir bölgesini sitenizden koparmak demektir. Mobil ağlar için itibar veritabanları neredeyse işe yaramaz: dün bir scraper'ın kullandığı adres bugün sizin müşterinize ait. Bu yüzden doğru kurgulanmış site anti-bot koruması IP'yi yalnızca zayıf sinyallerden biri olarak kullanır, hüküm gerekçesi olarak değil.
İkincisi: dağıtıklık. Modern bir parser adresleri öyle döndürür ki her birine saatte 2-3 istek düşer. Böyle bir istemciyi kesmek için yeterli rate limiting eşiği, kataloğun on sekmesini açan gerçek kullanıcıları kaçınılmaz olarak vurur.
Ağ seviyesinde ne işe yarar? ASN işaretleri (ağın hosting sağlayıcısına ait olması), coğrafi anormallikler (çalışmadığınız ülkeden trafik), IP coğrafi konumu ile tarayıcı dili uyuşmazlığı, tek tek adresler değil alt ağlar bazında istatistikler.
Taşıma ve protokol katmanı parmak izleri
Birçok kişinin hafife aldığı sinyal. İstemci güvenli bir bağlantı kurduğunda, desteklediği şifrelerin, uzantıların ve bunların sırasının listesini içeren bir karşılama mesajı gönderir. Bu küme istemcinin kullandığı kütüphaneye bağlıdır. Windows'taki Chrome tarayıcısı bir karşılama oluşturur, Firefox başka, Python HTTP kütüphanesi ise tarayıcıya hiç benzemeyen üçüncüsünü. Bu kümenin hash'ine TLS parmak izi denir (yaygın şemalar JA3 ve daha yeni JA4).
Sihir şurada: bir parser User-Agent başlığını saniyeler içinde taklit edebilir, ama TLS parmak izini iddia edilen tarayıcıyla eşleşecek şekilde taklit etmek çok daha zordur. İstemci yeni Chrome olarak kendini tanıtıyorsa ama TLS karşılaması konsol kütüphanesine karşılık geliyorsa, karşımızda script var demektir. Benzer parmak izleri HTTP/2 (SETTINGS frame'lerinin sırası ve değerleri, stream öncelikleri) ve HTTP/3 için de vardır. "İddia edilen tarayıcı + TLS + HTTP/2" kombinasyonu tek satır JavaScript olmadan bile iyi bir sınıflandırma doğruluğu sağlar.
Tarayıcı parmak izi ve otomasyon belirtileri
İstemci JavaScript çalıştırdığında analiz alanı kat kat genişler. Koruma scripti yüzlerce parametre toplar: ekran çözünürlüğü ve pencere boyutuyla oranı, yazı tipi listesi, Canvas ve WebGL üzerinden grafik render sonucu, ses bağlamı özellikleri, saat dilimi, dil ayarları, ortama özgü nesnelerin varlığı ve davranışı. Otomasyon belirtileri ayrıca kontrol edilir: headless modun ortamda bıraktığı özellikler, iddia edilen platform ile gerçek yetenekler arasındaki uyuşmazlıklar, canlı cihazda her zaman gürültü olan yerlerde fazla "ideal" değerler.
Şunu anlamak önemli: amaç kişiyi kesin olarak tanımlamak değil (bu hem hukuki açıdan hassas hem de teknik olarak güvenilmez), ama içsel çelişkiler bulmaktır. Gerçek bir iPhone 32 mantıksal işlemci çekirdeği bildirmez. Android'deki gerçek Chrome, dokunmatik giriş yokken 1920x1080 ekran çözünürlüğüne sahip olamaz. Her çelişki şüphe puanına bir ekleme demektir.
Davranışsal sinyaller
Taklit edilmesi en zor sinyal sınıfı zaman içindeki davranıştır. İnsan fareyi mikroskobik titremeler ve hızlanmalarla hareket ettirir, sayfayı düzensiz kaydırır, okumak için duraklar, düğmenin tam merkezine değil bir yerine tıklar. İnsan ana sayfaya girer, kategoriye geçer, üç-dört ürüne bakar, geri döner. Bot ise artan ID'ye göre art arda beş yüz ürün kartı açar, her birini tam 1,2 saniye aralıkla, hiç resim yüklemez ve CSS istemez. En gelişmiş yönetilen tarayıcı parser'ları bile oturumun yapısıyla kendini ele verir: tüm kataloğu tek bir alıcı gibi davranarak çekmek imkansızdır.
Siyah-beyaz karar yerine puanlama
Modern sistemler "bot mu insan mı" sorusuna ikili yanıt vermez. Her isteğe veya oturuma bir risk puanı atarlar ve ardından politika uygulanır: düşük risk — geçir, orta — görünmez bir challenge göster veya yanıtı yavaşlat, yüksek — captcha veya blok, kritik — inandırıcı ama çarpıtılmış veri ver. Bu yaklaşım yanlış pozitifleri ciddi biçimde azaltır: şüpheli istemcinin önüne kapı kapatılmaz, canlı olduğunu kanıtlaması için şans verilir.
2026'da neler değişiyor
Koruma tasarımını şimdiden etkileyen birkaç trend:
- Yapay zeka ajanları yeni bir istemci sınıfı olarak. Dil modeli tabanlı ajanlar gerçek tarayıcıları yönetir, sayfaları okur ve neredeyse insan gibi davranır. Bir kısmı faydalıdır (alıcı getirirler), bir kısmı ise sadece daha akıllı scraper'lardır. Sitelerin bu trafik için açık bir politika belirlemesi gerekecek.
- "Etik" bot kimliğinin standartlaşması. Meşru otomatik istemcinin belirli bir şirkete ait olduğunu kriptografik olarak kanıtladığı mekanizmalar gelişiyor. Bu, faydalı botların challenge'sız geçirilmesini sağlar.
- Cihaz attestation'ı ve güven token'ları. İşletim sistemleri ve tarayıcılar, siteye parmak izi toplamadan "bu gerçek bir cihaz ve gerçek bir insan" onayı verme mekanizmaları deniyor. Uzun vadede korumayı basitleştirecek ama şu an kapsam sınırlı.
- HTTP/3 ve metadata şifrelemesinin büyümesi. Bazı alışıldık ağ sinyalleri daha az erişilebilir hale geliyor, bu da odağı davranışsal analize kaydırıyor.
- Kullanıcı verisi toplamaya yönelik düzenleyici baskı. Tarayıcı parmak izleri ve oturum saklama, kişisel veri mevzuatına dikkatli yaklaşım gerektiriyor. Koruma, minimum gerekli veriyi toplayacak şekilde tasarlanmalı.
Bu bölümün çıkarımı basit ve önemli: güvenilir scraping koruması tek bir "gümüş" işaret üzerine değil, zayıf sinyallerin kombinasyonu üzerine kurulur. Pratiğe geçerken bunu aklınızda tutun.
Yöntem 1. Teşhis: Sizi kimin ve nasıl parse ettiğini öğrenmek
Körlemesine koruma kurmak, bütçeyi harcamanın ve yanlış kişileri engellemenin kesin yoludur. Herhangi bir şey uygulamadan önce bir-iki gün keşfe ayırın. İyi haber: bunun için pahalı araçlara gerek yok, web sunucu logları ve onlara doğru sorular sorma becerisi yeterli.
Adım 1. Temsili dönem için tam logları toplayın
En az yedi gün, haftalık döngüyü yakalamak için. Loglarda şunlar olmalı: zaman, IP, istek metodu ve yolu, yanıt kodu, yanıt boyutu, User-Agent, Referer, işlem süresi. Web sunucunuz yalnızca standart formatı yazıyorsa genişletin. Günde milyonlarca isteği olan bir proje için logları doğrudan analitik bir veritabanına veya en azından tablo formatına aktarmak uygundur.
Adım 2. Trafik yapısındaki anormallikleri bulun
Loglara aşağıdaki soruları sorun ve yanıtları not edin — bu sizin temel çizginiz olacak.
- Saatlere göre dağılım. Canlı trafiğin günlük döngüsü vardır. Gece boyunca düz bir "raf" veya sabah 4'te ani bir artış ilk işarettir.
- Kaynak türü oranı. HTML sayfalarına yapılan isteklerin CSS, JS ve resimlere oranı nedir? Tarayıcıda bu yaklaşık 1'e 10-30'dur. Parser'da 1'e 0. Yalnızca HTML veya yalnızca JSON isteyen adresleri ve alt ağları bulun.
- Tarama derinliği. Bir oturumda 100'den fazla ürün kartı açan kim? ID'leri, sayfalama sayfalarını, filtre kombinasyonlarını sırayla tarayan kim?
- Başlıklar. Eski tarayıcı sürümleri, boş veya kütüphane User-Agent'ı, Accept-Language eksikliği, binlerce adreste aynı User-Agent.
- Yanıt kodları. Olmayan ID'lere toplu 404 — tarama işareti. Toplu 429 veya 403 — birileri zaten limitlerinize takılıyor.
- Otonom sistemler. IP'leri ASN'e göre gruplayın. Katalog trafiğinde hosting sağlayıcılarının payı %5-10'un üzerindeyse neredeyse kesinlikle botlar var.
Adım 3. Hasarı parayla ölçün
Bulguları iş diline çevirin, yoksa koruma bütçe alamaz. Şunları hesaplayın: parazit isteklerin payı ve altyapıdaki maliyeti; botların oluşturduğu dış ücretli API yükü (döviz kurları, geocoding, arama); analitik bozulması (sahte oturumlar reklam atıflarını bozar, bu pazarlamacıları doğrudan ilgilendirir); kopyalanan fiyat ve içerikten kaynaklanan kayıp gelir. "Botlar bize altyapıda ayda 180 bin ruble ve rekabet konumunda bilinmeyen bir tutara mal oluyor" gibi kaba bir tahmin bile yönetimle konuşmayı değiştirir.
Adım 4. Hipotezleri doğrulamak için tuzaklar kurun
Loglar birilerinin olduğunu gösterir ama tam olarak ne istediğini göstermez. Analizi aktif keşifle tamamlayın:
- Kanarya kayıtları. Kataloğa, arama motorları tarafından indekslenmeyen ve navigasyonda görünmeyen, ancak sayfalamadan doğrudan bağlantıyla erişilebilen benzersiz adlı olmayan bir ürün ekleyin. Bu adın başka bir sitede görünmesi scraping'in kanıtı ve kaynağın işaretidir.
- Gizli bağlantılar. İnsan için görünmez (ekran dışında, boyutsuz) ama HTML'de bulunan bağlantı. İnsan ona asla tıklamaz. Her tıklama bottur. Arama motoru botlarından kurallarla gizlemeyi unutmayın.
- Benzersiz boşluklar ve küçük varyasyonlar. Açıklamalarda daha sonra kopyalanan metni tanımlayabileceğiniz küçük benzersiz biçimlendirme özellikleri.
Adım 5. Parser profilleri oluşturun
Teşhisin sonucu üç-beş profilden oluşan bir tablo olmalı. Örneğin: "Profil A: JS'siz bulut scripti, gece boyunca ürün kartlarına 40 bin istek, eski Chrome User-Agent'ı, tek alt ağ". "Profil B: yerleşik adreslerde dağıtık istemci, adres başına 2-3 istek, JS çalıştırır, yalnızca fiyat filtresinde gezer". "Profil C: toplayıcı, dürüstçe kendini tanıtır, günde bir kez feed çeker". Her profil için hangi koruma katmanının onu durduracağı hemen belli olur. Profil A birinci hatta düşer. Profil B davranışsal analiz gerektirir. Profil C'ye belki de iş ortağı API'si önermek gerekir — bazen bu savaşmaktan daha kârlıdır.
Teşhis kontrol listesi
- 7+ günlük tam alanlı loglar toplandı.
- Trafiğin saatlere ve kaynak türlerine göre dağılımı oluşturuldu.
- "Değerli" URL'lere istek sayısına göre ilk 20 alt ağ ve ASN belirlendi.
- Anormal derinlik ve düzenliliğe sahip oturumlar bulundu.
- Parazit trafiğin payı ve maliyeti hesaplandı.
- Kanarya kayıtları ve gizli bağlantılar yerleştirildi.
- Hedef koruma katmanını belirten parser profilleri oluşturuldu.
- Dokunulmaması gereken meşru botlar belirlendi: arama motorları, ödeme webhook'ları, iş ortakları, izleme.
Yöntem 2. Birinci hat: Sunucu ve ağ seviyesi
Birinci hat temeldir. Gelişmiş bir parser'ı durdurmaz ama ilkel botların %50-70'ini tam anlamıyla bir günlük işle ve neredeyse bedava keser. Pahalı çözümler uğruna bu adımı atlamak hatadır: her isteği analiz etmek için neden ödeme yapasınız ki, yarısı basit bir kuralla elenebiliyorsa?
Doğru yapılmış istek hızı sınırlama
Rate limiting en bilinen ve en sık yanlış yapılandırılan araçtır. Tipik hata: tüm site için IP başına tek küresel limit. Sonuç — ya limit çok yumuşak ve işe yaramaz, ya çok katı ve ofisleri, üniversiteleri ve NAT'lı mobil ağları vurur. Doğru yaklaşım farklılaştırılmış limitler:
- Kaynak türüne göre. Statik içerik ve ana sayfa — cömert limitler. Ürün kartları, arama sonuçları, katalog JSON endpoint'leri — belirgin şekilde daha katı. Giriş ve kayıt formları — çok katı.
- Anahtara göre. Sadece IP değil. Kombinleyin: IP + yol, IP + User-Agent, oturum cookie'si, yetkili kullanıcılar için hesap kimliği. Mobil ağlar için /24 alt ağı veya yüksek eşikli ASN başına limit, tek adres başına katı limitten daha iyidir.
- Zaman pencerelerine göre. İki pencere: kısa (örneğin 10 saniyede 20 istek — ani artışlara karşı) ve uzun (örneğin saatte ürün kartlarına 600 istek — yavaş taramaya karşı). Yavaş ama ısrarcı parser ikinci pencereye takılır, canlı insan takılmaz.
- Tepki türüne göre. Limit aşımı blok anlamına gelmek zorunda değil. İlk kademe — yanıtı 2-5 saniye geciktirme. İkinci — Retry-After başlıklı 429 kodu. Üçüncü — 10-15 dakika geçici ban. Kademeli tırmanma insanları neredeyse hiç etkilemez ve botları ciddi yavaşlatır.
Popüler bir web sunucusu için kendinize uyarlayacağınız temel bölge yapılandırması örneği (değerler varsayımsal):
limit_req_zone $binary_remote_addr zone=catalog_burst:20m rate=3r/s;limit_req_zone $binary_remote_addr zone=login:10m rate=10r/m;location /catalog/ { limit_req zone=catalog_burst burst=15 delay=8; }location /login { limit_req zone=login burst=3 nodelay; limit_req_status 429; }delay parametresine dikkat edin: ani artışın bir kısmını hemen sunar, geri kalanını gecikmeli olarak — on sekme açan bir insan için konforlu, bir script için nahoş.
Ağ işaretlerine göre filtreleme
Otonom sistemler için bir politika oluşturun. Hosting sağlayıcıları ve bulutlar ilkel parser'ların çoğunun kaynağıdır. Tam blok her zaman uygun değildir (kurumsal proxy'ler ve bazı meşru hizmetler de oradan geçer), ama onlara katı limitler ve zorunlu JavaScript challenge uygulamak mantıklıdır. İş yapmadığınız ülkeler için de aynısı: blok değil, daha yüksek doğrulama seviyesi. "Zayıf sinyal puan ekler" yaklaşımını unutmayın, "tek sinyal her şeyi çözer" değil.
Başlık düzeyinde kurallar
WAF veya sunucu yapılandırması için birkaç ucuz ama etkili kural:
- Boş User-Agent'lı veya bilinen HTTP kütüphanesi imzalarına sahip istekleri hizmet dışı URL'lerde reddedin. Meşru entegrasyonlar genel sayfalar yerine anahtarlı özel API kullanmalıdır.
- Başlık tutarlılığı isteyin: kendini Chrome olarak tanıtan ama karakteristik istemci ipucu başlıkları olmayan istemci şüphelidir.
- Parser'ların eski site haritalarından çekmeye devam ettiği eski URL formatlarına 404 veya 410 döndürün.
- Sunucu yazılımı ve çerçeve sürümlerini başlıklarda gizleyin — scraping koruması için değil ama genel hijyen için.
Bot kuralları ve açık politika
Arama motoru botları için kurallar dosyası bir koruma aracı değildir — kötü niyetli bot onu görmezden gelir. Ama iki nedenle önemlidir. Birincisi, faydalı botlara açıkça izin vermenizi ve istenmeyen crawler'ları, yapay zeka modelleri için veri toplayanlar dahil, açıkça yasaklamanızı sağlar — dürüst operatörler bu kurallara uyar. İkincisi, pozisyonunuzu sabitler: teknik kurallar ve site kullanım koşullarının kombinasyonu, izinsiz veri toplamayı yapan kişi için durumu hukuken daha savunmasız hale getirir. Kullanıcı sözleşmesinde yazılı izin olmadan otomatik veri toplama yasağını mutlaka belirtin.
Koruma olarak önbellekleme
Beklenmedik bir teknik: CDN veya reverse proxy düzeyinde "değerli" sayfaların agresif önbelleklenmesi parser'ın veri çekmesini engellemez ama ana acıyı — uygulama ve veritabanı üzerindeki yükü — ortadan kaldırır. Bot kataloğu önbellekten çekiyorsa altyapınız neredeyse hiç etkilenmez. Bu bir zafer değil ama sonraki hatları yangın söndürmeden inşa etmek için kazanılmış zamandır.
Birinci hat kontrol listesi
- Farklı değere sahip URL grupları belirlendi ve her biri için farklı limitler yapılandırıldı.
- İki limit penceresi uygulandı: kısa ve uzun.
- Aşım tepkisi kademeli: gecikme, 429, geçici ban.
- Mobil ve yerleşik ağlar için limitler yumuşatıldı veya alt ağ başına hesaplanıyor.
- Hosting ASN'leri ve hedef dışı bölgeler ban yerine yüksek doğrulama moduna alındı.
- Kütüphane istemcilerini elemek için başlık kuralları yapılandırıldı.
- Bot politikası ve veri toplamaya yönelik hukuki yasak yazıldı.
- Pahalı sayfalar için önbellekleme açıldı.
- Arama motorları, ödeme sistemleri ve iş ortakları için istisnalar kontrol edildi ve belgelendi.
Yöntem 3. İkinci hat: İstemci doğrulama ve challenge'lar
Birinci hat isteğin kendi işaretlerine göre çalışır. İkinci hat daha ileri gider ve istemciye sorar: "Tarayıcı olduğunu kanıtla ve arkanda bir insan olduğunu kanıtla". Tam da burada JavaScript çalıştırmayan scriptler ve aceleyle yapılandırılmış headless araçları elenir. Bu katmanın araçlarını kullanıcı için "maliyet" artışına göre ele alalım.
TLS ve HTTP/2 parmak izleri: Sorunsuz filtre
Kullanıcının hiç fark etmediği şeyle başlayın. Yük dengeleyici veya reverse proxy'de bağlantının TLS parmak izini hesaplayın ve iddia edilen User-Agent ile karşılaştırın. Tipik mantık:
- Parmak izi bilinen bir HTTP kütüphanesine karşılık geliyor ve User-Agent tarayıcı iddia ediyor — yüksek risk.
- Parmak izi bir tarayıcıya karşılık geliyor ama başlıkta belirtilen aile veya sürüme uymuyor — orta risk.
- Parmak izi sitenizde ilk kez görülüyor ve aynı anda binlerce adreste mevcut — yeni bir parsing aracı şüphesi.
Uygulama detayı önemli: TLS parmak izinden ilk günden bloklamayın. Bir hafta istatistik toplayın, hangi parmak izlerinin gerçek kitlenize karşılık geldiğini öğrenin (mobil uygulama içi tarayıcılar ve mesajlaşma uygulaması web view'ları dahil, bunların parmak izleri kendine özgüdür) ve ancak sonra kuralları etkin moda alın. Yoksa Telegram'dan veya e-posta istemcisinden sitenize gelen kullanıcıları kesme riskiyle karşı karşıya kalırsınız.
JavaScript challenge'ı: Yürütme ortamı doğrulaması
Temel JS challenge'ı, erişim cookie'si almak için istemcinin çalıştırması gereken küçük bir scripttir. Cookie olmadan sunucu içerik yerine bir yer tutucu döndürür. HTTP kütüphanelerindeki basit scriptler JavaScript çalıştırmaz ve kapıda kalır. Daha gelişmiş sürüm ortam özelliklerini toplar ve sinyaller bölümünde konuştuğumuz tutarlılığı kontrol eder.
Uygulama için pratik öneriler:
- Challenge'ı herkese göstermeyin. Orta riskli isteklere ve değerli bölümlere uygulayın. Ana sayfa ve reklamın yönlendirdiği iniş sayfaları anında açılmalı — ilk ekrana kadar her fazladan saniye dönüşüme mal olur ve arbitrajcılar bunu herkesten iyi bilir.
- Challenge'ı görünmez yapın. Script arka planda 100-300 milisaniyede çalışmalı, beyaz ekran ve "tarayıcınızı kontrol ediyoruz" yazıları olmadan. Dürüst istemci için süreç fark edilmez.
- Sonucu IP'ye değil oturuma bağlayın. Erişim cookie'si imzalı olmalı, yaşam süresi olmalı ve istemcinin kilit özelliklerinin hash'ini içermelidir. Böylece yüzlerce parser thread'ine kopyalanıp dağıtılamaz.
- Challenge'ı düzenli değiştirin. Statik doğrulama bir hafta içinde çözülür. Kodu obfuscate edin, kontrol edilen parametreleri değiştirin, imza anahtarlarını döndürün.
- JS verilerinin sunucu verileriyle tutarlılığını kontrol edin. Script'ten gelen saat dilimi IP coğrafi konumuyla uyuşmuyor mu? İddia edilen platform TLS parmak iziyle uyuşmuyor mu? Her uyuşmazlık bir risk puanıdır.
İş kanıtı: Ekonomik bariyer
Kaptcha'ya alternatif olarak popülerleşen zarif bir teknik. Sunucu istemciye bir hesaplama görevi verir (örneğin hash'i belirli sayıda sıfırla başlayan bir değer bulmak). Telefondaki tarayıcı bunu 200-500 milisaniyede insan fark etmeden çözer. Ama 100 bin istek yapan bir parser bunun için saatlerce işlemci zamanı harcamak zorunda kalır. Görevin zorluğu risk puanıyla orantılı artırılabilir: şüpheli istemciye on kat daha zor bir görev. İnsan farkı hissetmez, bot ise çok hisseder.
Captcha: Nerede uygun, nerede zararlı
Captcha en görünür ve en sinir bozucu araçtır. Kullanıcı deneyimi araştırmaları istikrarlı biçimde gösteriyor: satın alma yolundaki her captcha dönüşümü düşürür, üstelik mobil kullanıcılar için kayıp daha yüksektir. Dolayısıyla kural basit: captcha son argümandır, ilk kontrol değil. Uygun uygulama noktaları:
- birkaç başarısız denemeden sonra giriş formları;
- kayıt ve şifre sıfırlama;
- geri bildirim ve yorum formlarının gönderimi;
- oturumun risk puanı zaten yüksekken istemci hâlâ katalogda gezmeye çalıştığı durumlar;
- kritik işlemlerin korunması: rezervasyon, promosyon kodu uygulama, kıt ürünü sepete ekleme.
Uygun olmayan noktalar: ana sayfa, ürün kartları, arama, reklam kampanyalarının iniş sayfaları. Kataloğa captcha koymak zorunda kalıyorsanız, önceki katmanlar çalışmıyor demektir ve tedavi edilmesi gereken onlardır. Ayrıca: iki binli yılların çarpık harfli resimleri değil, görünmez modlu ve uyarlanabilir zorluklu modern captcha'ları seçin.
API ve mobil uygulama koruması
Çoğu zaman parser'lar siteyi ziyaret bile etmez — frontend'inizin kullandığı JSON endpoint'lerini bulur ve HTML ayrıştırmadan temiz veriyi çekerler. Kontrol edin: katalog API'niz oturum cookie'si ve imzalı istek olmadan erişilebilir mi? Öyleyse tüm site koruması anlamsızdır. Minimum önlemler: challenge geçtikten sonra verilen kısa ömürlü imzalı token'lar; token'ı oturuma bağlama; yanıt boyutunu ve sayfalama derinliğini sınırlama; API için ayrı, daha katı limitler. Mobil uygulamalar için — platform araçlarıyla uygulama kimliği doğrulama ve sertifika pinning.
İkinci hat kontrol listesi
- TLS/HTTP2 parmak izleri hesaplanıyor, kitleniz hakkında haftalık istatistik toplandı.
- Parmak izi kuralları ancak analiz sonrası etkin moda alındı.
- JS challenge'ı görünmez şekilde uygulandı ve risk puanına göre uyarlanabilir.
- Erişim cookie'si imzalı, istemciye bağlı, yaşam süresi var.
- Uyarlanabilir zorluklu iş kanıtı uygulandı.
- Captcha yalnızca formlarda ve kritik işlemlerde, katalogda değil.
- Katalog API'si token'lar ve limitlerle korunuyor, oturum olmadan erişilemez.
- Tüm kontroller mesajlaşma uygulaması web view'larında ve mobil tarayıcılarda test edildi.
Yöntem 4. Üçüncü hat: Davranış, tuzaklar ve verilerin kendisinin korunması
Diyelim ki parser ilk iki turu geçti: yerleşik adreslerden geliyor, inandırıcı parmak izli gerçek bir tarayıcıyı yönetiyor, challenge'ları geçiyor. Peki sonra? Sonra "kimsin" sorusundan "ne yapıyorsun" sorusuna ve nihayetinde ganimetin kendisini değersizleştirmeye geçiyoruz. Bu, site anti-bot korumasının en entelektüel katmanıdır ve olgun bir sistemi kural kümesinden ayıran da tam olarak budur.
Oturumların davranışsal puanlaması
Üçüncü hattın temeli — oturum boyunca zaman içinde risk puanı biriktirme. Sayılması gereken işaretler:
- Navigasyonun derinliği ve yapısı. Saatte 50-100'den fazla ürün kartı, sayfalamayı sonuna kadar tarama, tüm filtre kombinasyonlarını deneme, kimlik numaralarının artan sırasına göre hareket.
- Ritim. İstekler arası çok düzenli aralıklar veya tam tersine ideal rastgele dağılmış aralıklar (insan ideal rastgele olamaz).
- Etkileşim eksikliği. Fare hareketi, kaydırma, dokunma, pencere boyutu değişikliği, odak olayı yok. Sayfa yüklendi ama kimse ona bakmıyor.
- Alışılmadık yollar. Ana sayfaya, sepete, iletişime hiç geçiş yok. Sadece veri içeren hedef sayfalar.
- Kaynakları görmezden gelme. Resimler, yazı tipleri, analitik scriptleri istenmiyor.
- Çok oturumlu işaretler. Aynı tarayıcı parmak izi yüzlerce adreste, aynı navigasyon desenli onlarca oturum bir dakika içinde başlıyor.
Puandaki artışa tepki aynı kademeli yaklaşım: önce yanıtları yavaşlatma, sonra daha zor challenge, sonra captcha, sonra oturumu bloklama. Üstelik IP'yi değil oturumu ve parmak izini bloklamak gerekir — mobil ağları hatırlayın.
Üretimde honeypot tuzakları
Teşhis sırasında kullandığımız tuzaklar kalıcı bir koruma unsuru olarak da mükemmel çalışır. Her gizli bağlantı, istemci tarafından doldurulan her görünmez form alanı, navigasyonda olmayan var olmayan URL'ye her istek — neredeyse sıfır yanlış pozitifli bir sinyal. İnsan sıfır boyutlu bir öğeye fiziksel olarak tıklayamaz. Güvenlik kuralları: tuzakları arama motoru botlarından gizleyin, engelli kullanıcılar için ekran okuyucu programlarının etkilenebileceği tuzaklar kullanmayın, tuzakların yerini ve biçimini düzenli olarak değiştirin.
Ganimeti değersizleştirme: Verilerin kendisiyle çalışma
Neredeyse kimsenin konuşmadığı ama genellikle herhangi bir bloktan daha etkili olan strateji. Botun veriyi almasını engelleyemiyorsanız, alınan şeyi işe yaramaz veya ihanete uğratıcı yapın.
- Şüpheli oturumlara veri zehirleme. Yüksek risk puanlı istemciye 403 hatası değil, çarpıtılmış fiyatlar ve stoklarla normal bir sayfa döndürün: fiyat artı-eksi %7, rastgele stok, değiştirilmiş puan. Parser ifşa edildiğini anlamaz ve rakibin veritabanına düşen çöpü toplamaya devam eder. Yeniden fiyatlandırmadan sonra fark edilen böyle bir olay, uzun süre parsing isteğini kırar. Dikkatli uygulayın: yalnızca çok yüksek kesinlikte, canlı bir müşteriye yanlış fiyat göstermemek için ve asla hukuki açıdan önemli bilgiler için değil.
- Verilerde filigranlar. Her oturuma özgü içerik mikro özellikleri: açıklamadaki kelime sırası, görünmez biçimlendirme varyasyonları, benzersiz "kanarya" ürünleri. Bunlarla verinin nereden sızdığını ve tam olarak hangi istemciyle ilgili olduğunu daha sonra kanıtlarsınız.
- Dinamik işaretleme. Değerli sayfalarda CSS sınıf adlarının ve HTML yapısının düzenli değişimi, seçicilere bağlı parser'ları kırar. Bu bir yarıştır ama her yineleme size bir release'e, saldırgana mantığı yeniden yazmaya mal olur.
- Kritik değerleri alışılmadık yolla render etme. Fiyat birkaç öğeden birleştirilebilir, CSS sözde öğeleriyle enjekte edilebilir, resim olarak verilebilir veya etkileşimden sonra gecikmeli yüklenebilir. Her yöntemin erişilebilirlik ve arama motoru optimizasyonu için bir bedeli vardır — tartın.
- Yanıtı sınırlama. Kimseye tüm kataloğu vermeyin: kesin sayfalama derinliği sınırı, filtrelerle daraltma zorunluluğu, "tüm ürünler tek listede" endpoint'inin olmaması.
Savaş yerine meşru kanal
Paradoksal ama işleyen bir teknik. Verileriniz sistematik olarak toplayıcılara, iş ortaklarına veya araştırmacılara gerekiyorsa, onlara anahtarlı, limitli ve kullanım koşullu resmi bir API verin. Yükün bir kısmı "gri" bölgeden kontrollü alana geçer ve genel sayfaları parse etmeye devam edenlerle sert çalışmak için hukuki ve teknik dayanağınız olur.
Üç hattın aşamalı uygulama çerçevesi
Süreç hakkında ayrıca konuşmak gerekir, çünkü başarısızlıkların çoğu teknolojiden değil acelecilikten kaynaklanır. Önerilen sıra:
- Gözlem modu (1-2 hafta). Tüm kurallar ve puanlama çalışır ama hiçbir şeyi bloklamaz — yalnızca kararları loglar. Kimi bloklayacağınızı görür ve gerçeklikle karşılaştırırsınız.
- Kalibrasyon. "Bloklanacaktı" listesindeki en üst oturumları manuel incelersiniz. Aralarında iş ortaklarınız, kendi izlemeniz, mesajlaşma uygulaması web view'ı ve garip ama canlı tarayıcılı kullanıcılar çıkacaktır. Eşikleri düzeltir, istisnalar eklersiniz.
- Yumuşak eylem (1-2 hafta). Yalnızca yavaşlatma ve görünmez challenge'ları açarsınız. Dönüşüm, hemen çıkma oranı, destek başvurularını izlersiniz.
- Kademeli kapsamla tam eylem. Captcha ve blokları önce trafiğin %10'unda, sonra %50'sinde, sonra tamamında açarsınız. Her adımda — metrik kontrolü.
- İşletim. Haftalık yanlış pozitif incelemesi, aylık eşik revizyonu, challenge ve tuzak rotasyonu, parser profillerinin güncellenmesi.
Kontrol için kilit metrikler
- Site bölümlerine göre bot olarak sınıflandırılan trafiğin payı.
- Captcha veya erişilemezlik şikayetiyle destek başvurularının sayısı.
- Öncesi ve sonrası dönüşüm ve hemen çıkma oranı, mobil kitle için ayrıca.
- Manuel kontrol edilen oturum örnekleminde yanlış pozitif payı (hedef — %0,5'ten az).
- Uygulama ve veritabanı üzerindeki yük, altyapı maliyeti.
- Fiyat değişikliğiniz ile bilinen bir rakipte görünmesi arasında geçen süre.
Anti-bot koruması uygularken tipik hatalar
Ne yapılacağını ele aldık. Şimdi ne yapılmaması gerektiğine — onlarca projenin deneyimine göre bu hatalar şaşırtıcı bir tutarlılıkla tekrarlanıyor.
Hata 1. Ana önlem olarak IP bloklama
En yaygın ve en zararlı olanı. Site sahibi bir adresten bin istek görür, banlar — ve bir ofis merkezini veya arkasında binlerce abone bulunan bir mobil operatör segmentini keser. Parser ise bu sırada bir sonraki adrese geçer. IP zayıf bir sinyaldir, yüksek doğrulama için nedendir ama ban için değil.
Hata 2. Her şeye captcha
"Her sayfaya captcha koyalım, botlar acı çeksin" tarzı tepki. Acı çeken botlar değil, dönüşüm olur: canlı insanlar gider, reklam içeriğe ulaşamayan kullanıcılara bütçe harcar, arama motoru botları yer tutucu alır. Captcha — formlar ve kritik işlemler için nokta atışı bir araçtır.
Hata 3. Gözlem modu olmadan blokları açma
Kurallar akşam yazılır, gece açılır, sabah destek ekibi şikayetlerde boğulur. Her zaman önce gözlem, sonra kalibrasyon, sonra eylem.
Hata 4. Unutulan meşru botlar
Bloklanan arama motoru botu — iki hafta sonra pozisyon kaybı. Bloklanan ödeme webhook'u — ödenmeyen siparişler. Bloklanan kendi izlemeniz — yanlış alarmlar. Herhangi bir kuralı açmadan önce istisna listesini oluşturun ve kontrol edin.
Hata 5. API ve mobil endpoint'lerin görmezden gelinmesi
Site örnek şekilde korunuyor ama frontend'in çağırdığı JSON tüm dünyaya token'sız açık. Parser temiz yapılandırılmış veri için teşekkür eder. Koruma tüm içerik dağıtım kanallarını kapsamalıdır.
Hata 6. Statik challenge'lar ve tuzaklar
Bir kez yapılandırılan koruma bir ay içinde çözülür ve atlatılır. Site anti-bot koruması bir proje değil, bir süreçtir: rotasyon, güncelleme, eşik revizyonu.
Hata 7. Yüksek kesinlik olmadan veri zehirleme
"Bozuk" fiyat gösterme cazibesi büyüktür ama canlı bir müşteriye gösterilen tek bir yanlış fiyat, hele hele o fiyattan verilen bir sipariş — itibar ve hukuki risktir. Yalnızca maksimum puanlı oturumlara uygulayın ve asla hukuki açıdan önemli bilgilere değil.
Hata 8. Unutulan erişilebilirlik
Tuzaklar ve alışılmadık render, ekran okuyucular ve engelli kullanıcılar için siteyi bozabilir. Korumayı yalnızca yeni Chrome'da değil, erişilebilirlik araçlarıyla da test edin.
Hata 9. Kullanıcılar hakkında aşırı veri toplama
Tarayıcı parmak izleri ve ayrıntılı davranış logları, kişisel veri mevzuatının uygulandığı bilgilerdir. Çözüm için gereken minimumu toplayın, saklama sürelerini sınırlayın, işleme gerçeğini gizlilik politikasına yansıtın.
Hata 10. Başarı metriklerinin olmaması
Koruma açıldı ama "daha iyi oldu mu?" sorusunu kimse yanıtlayamıyor. Teşhisten gelen temel çizgi ve dönüşüm kontrolü olmadan zaferi yenilgiden ayırt edemezsiniz.
Uygulama için araçlar ve kaynaklar
Satıcıları karşılaştırmayacağımıza söz vermiştik ve sözümüzü tutuyoruz. Aşağıda araç kategorileri ve her birinin neyden sorumlu olduğu var; böylece kendi ölçeğinize ve bütçenize uygun bir yığın kurabilirsiniz. Belirli çözümlerin adlarını kolayca kendiniz bulacaksınız; burada önemli olan mimaridir.
Web sunucusu ve reverse proxy seviyesi
Nginx, Apache, Caddy, HAProxy, Envoy. Ne verirler: esnek anahtarlarla rate limiting, başlık kuralları, koşullara göre farklı yanıtlar, modüller ve uzantılarla TLS parmak izi hesaplama. Bu sizin birinci hattınız ve günde birkaç milyon isteğe kadar olan bir proje için başlangıçta yeterli olabilir.
Korumalı WAF ve CDN
Yerleşik WAF ve bot filtreleme modlu bulut CDN'ler veya açık kural setleri üzerine kurulu kendi barındırdığınız WAF'ler. Ne verirler: ASN itibarı ve coğrafyaya göre filtreleme, yönetilen challenge'lar, temel puanlama, önbellekleme. Artı — hızlı açılış. Eksi — iş mantığınıza göre sınırlı yapılandırılabilirlik.
Uzmanlaşmış bot yönetim platformları
İstemci parmak izleri toplayan, davranışsal puanlama yürüten, uyarlanabilir challenge'lar uygulayan ve analitik paneli sunan ticari ve açık sistemler. Bot trafiği payı yüksekse, veriler değerliyse ve kendi geliştirmesi için ekibiniz yoksa haklıdırlar. Seçerken gözlem moduna, politika ayrıntı düzeyine, mobil uygulamalarınız ve web view desteğine ve kararların şeffaflığına bakın — belirli bir istemcinin neden bloklandığını anlamalısınız.
Kendi geliştirme için kütüphaneler
Tarayıcı parmak izi toplama, iş kanıtı uygulama, sunucu tarafında TLS parmak izi hesaplama, otomasyon belirtilerini tespit etme için açık kütüphaneler. Tam kontrol isteyen geliştiricisi olan ekipler için uygundur. Sürekli güncelleme gereğini unutmayın: headless mod belirtileri her tarayıcı sürümünde değişir.
Captcha ve alternatifleri
Görünmez modlu ve uyarlanabilir zorluklu modern doğrulama hizmetleri, ayrıca kullanıcı etkileşimi olmadan iş kanıtına dayalı çözümler. Seçim kriterleri: engelli kişiler için erişilebilirlik, bölgenizde gecikmesiz çalışma, kullanıcılar hakkında minimum veri toplama.
Analitik ve gözlemlenebilirlik
Log toplama ve analiz yığını (ELK ve benzerleri, ClickHouse, bulut analitik sistemleri), koruma metrikleri için panolar, trafik anormallikleri için uyarı sistemleri. Onlar olmadan körsünüz: kitle segmentleri bağlamında sistem kararlarını görmeden eşikleri kalibre etmek imkansızdır.
Test araçları
Ayrı bir öneri: korumanızı parser'ların kullandığı araçlarla test edin. Otomatik tarayıcı headless modda, popüler bir dilde HTTP istemcisi, ağ profilleme araçları. Kendi basit scriptiniz kataloğu serbestçe çekiyorsa iş bitmemiş demektir. Mobil proxy ile çalışan bir ekip için faydalı olan diğer senaryo: korumanın, adreslerin binlerce abone arasında paylaşıldığı mobil ağlardan gelen dürüst kullanıcıları bloklayıp bloklamadığını kontrol etmek.
İhtiyaç duyacağınız iç kaynaklar
- Eşikleri değiştirme yetkisi olan, korumadan sorumlu bir kişi.
- Destek ekibinin katılımıyla yanlış pozitif inceleme prosedürü.
- Hukuken gözden geçirilmiş kullanım koşulları ve gizlilik politikası.
- Verilerinize ihtiyaç duyan iş ortakları için resmi kanal.
Vakalar: Bunun gerçek projelerde nasıl çalıştığı
Uygulama pratiğinden rakamlarla ve çıkarımlarla üç anonimleştirilmiş hikaye. Ayrıntılar değiştirildi, öz korundu.
Vaka 1. Elektronik e-ticaret: Katalog isteklerinin %71'i botlardan
Durum. Orta ölçekli mağaza, yaklaşık 40 bin ürün, rakiplerin fiyatları kendisinden sonra yarım saat içinde değiştirdiğini fark etti. Log teşhisi gösterdi: gece ürün kartlarına isteklerin %71'i, gündüz %44'ü otomatikti. Ana profiller: JS'siz iki bulut scripti ve yalnızca fiyat sayfalarında gezen yerleşik adreslerde dağıtık bir istemci. Parazit trafiğin altyapı maliyeti ayda yaklaşık 140 bin ruble, ayrıca ücretli geocoding API limitleri gün ortasında tükeniyordu.
Çözüm. Birinci hat: bölümlere göre farklılaştırılmış limitler, hosting ASN'leri için katı mod, kartların önbelleklenmesi. İkinci hat: haftalık gözlemli TLS parmak izleri, katalog için görünmez JS challenge'ı, frontend JSON endpoint'inin token'larla korunması. Üçüncü hat: oturum derinliğine göre puanlama, gizli bağlantılar, kanarya ürünleri, maksimum puanlı oturumlar için %5-8 aralığında fiyat çarpıtma.
İki ay sonra sonuç. Kataloğa bot trafiğinin payı %9'a düştü. Bulut scriptleri ilk hafta kayboldu. Dağıtık istemci üç hafta dayandı, sonra kanarya ürünlerine göre çarpıtılmış fiyatlar toplamaya başladı ve bir ay sonra aktivite durdu. Uygulama üzerindeki yük %58 azaldı, altyapı giderleri ayda 96 bin ruble düştü. Dönüşüm istatistiksel olarak anlamlı değişmedi; captcha ile ilgili destek başvuruları yüz binlerce ziyaretçili kitlede iki ayda 11 oldu. Manuel örneklemde yanlış pozitif oranı %0,3.
Ders. Veri zehirleme en ısrarcı parser'a karşı belirleyici faktör oldu ama yalnızca önceki katmanlar yüksek sınıflandırma kesinliği sağladığı için işe yaradı.
Vaka 2. Hizmet ilan sitesi: İletişim ve ilanların korunması
Durum. Bireysel uzmanların ilanlarının olduğu platform, iletişim verilerinin toplu toplanmasından zarar görüyordu: uzmanların telefonları spam veritabanlarına gidiyordu, kullanıcılar şikayet edip ayrılıyordu. Toplama, yerleşik ve mobil adreslerden inandırıcı parmak izli yönetilen tarayıcılarla yapılıyordu; birinci hat neredeyse yardımcı olmuyordu.
Çözüm. Üçüncü hat ve veri korumasına ağırlık. İletişimler HTML'den çıkarıldı ve yalnızca tıklamayla, oturum token'lı imzalı istekle, oturum başına saatlik açıklama limitiyle ve risk puanı arttıkça daha zor iş kanıtıyla veriliyordu. Yetkili kullanıcılar için limit daha yüksek, misafirler için daha düşük. Etkileşim dikkate alınarak oturum puanlaması: iletişimi ona önceden kaydırmadan ve işaretçi hareketi olmadan açma puan ekliyordu. Captcha — yalnızca misafirler için saatte beşinci ve sonraki açıklamalarda.
Sonuç. Şüpheli istemcilerde oturum başına açılan iletişim sayısı yüzlerden 3-4'e düştü, ardından oturumlar bloklandı. Uzmanların spam şikayetleri çeyrekte %80 azaldı. Canlı kullanıcılarda "ilan görüntüleme — iletişim" dönüşümü %4 arttı — muhtemelen kaldırılan yük nedeniyle sayfalar hızlandığı için.
Ders. Parser parmak iziyle insandan ayırt edilemediğinde, veri teslim modelinin kendisini değiştirmek kurtarır: değerli olan eylemle, dozlu ve artan maliyetle verilir.
Vaka 3. B2B katalog: Ana sorun olarak yanlış pozitifler
Durum. Endüstriyel bileşen tedarikçisi, bulut bot korumasını gözlem yapmadan sert modda açtı. İki gün sonra — başvurularda %35 düşüş. İnceleme gösterdi: şirketin müşterileri ortak adresli ve eski tarayıcılı kurumsal ağlarda oturuyordu ve trafiğin önemli bir kısmı alışılmadık TLS parmak izli kurumsal mesajlaşma uygulaması web view'ından geliyordu. Sistem onları bot olarak değerlendirdi.
Çözüm. Gözlem moduna geri dönüş, iki hafta kalibrasyon, kilit müşterilerin parmak izleri ve alt ağları için beyaz liste oluşturma, kurumsal segmentleri "yalnızca yavaşlatma ve görünmez challenge, asla captcha" moduna alma. Ek olarak — daha önce kendi sistemleri için kataloğu parse eden üç distribütör için iş ortağı API'si.
Sonuç. Başvurular kalibrasyondan sonra bir hafta içinde toparlandı. Bot trafiği, distribütörlerin resmi API'ye geçmesi ve ilkel scriptlerin elenmesiyle %62 azaldı. Yanlış pozitifler — %0,2'den az.
Ders. Gözlem modu formalite değildir. Üstelik "parser"ların bir kısmı aslında savaşmak yerine API vermenin daha kolay olduğu iş ortaklarınızdır.
SSS: Zor sorulara yanıtlar
Scraping'i tamamen durdurmak mümkün mü?
Dürüst yanıt — hayır, veriler bir insan için halka açıksa, yeterince motive bir bot için de teknik olarak erişilebilirdir. Korumunun amacı toplamayı o kadar pahalı, yavaş ve güvenilmez yapmaktır ki ekonomik anlamını yitirsin. Çoğu ticari senaryoda bu yeterlidir: verileri bir gün gecikmeyle ve belirli bir çarpıtma yüzdesiyle alan rakip avantaj elde etmez.
Anti-bot koruması arama motoru sıralamasına zarar verir mi?
Yanlış yapılırsa evet: arama motoru botlarını bloklamak, onlara içerik yerine challenge vermek veya fiyatları resim olarak render etmek. Doğru kurulmuş koruma meşru botları (bildirilen adres aralıkları ve ters DNS kontrolüyle) tanır, doğrulama olmadan geçirir ve içeriği onlar için değiştirmez. Her politika değişikliğinden sonra webmaster araçlarıyla sayfa görünürlüğünü kontrol edin.
Mobil ağ kullanıcılarını bloklamadan siteyi nasıl korurum?
Mobil ağdan tek IP'yi asla banlamayın; limitleri yüksek eşikli alt ağ veya ASN başına sayın; ağ sinyalleri yerine oturum ve davranış sinyallerine güvenin; şüpheli istemcilere captcha değil görünmez challenge ve yavaşlatma uygulayın. Korumayı mutlaka ana operatörlerin ağlarında gerçek mobil cihazlarla test edin.
Korumayı kendim mi yapmalıyım yoksa hazır platform mu almalıyım?
Ölçeğe ve ekibe bağlı. Birinci hat ve temel challenge'lar bir geliştiricinin iki haftalık işiyle uygulanır ve ilkel botların büyük kısmını kapsar. Sürekli güncellenen davranışsal puanlama aslında ayrı bir üründür ve özel güvenlik ekibi olmayan projeler için yıllık bazda hazır platform genellikle daha ucuzdur. Makul yol — kendi temel önlemlerinizle başlayın, sorunun kalanını ölçün ve ancak sonra uzman bir araca ihtiyaç olup olmadığına karar verin.
Yapay zeka modeli crawler'larına nasıl yaklaşmalıyız?
Yalnızca teknik değil iş kararı olarak. Yapay zeka asistanlarının yanıtlarında görünmek size kitle getiriyorsa — bot kuralları aracılığıyla taramaya izin verin ve engellemeyin. İçeriğiniz sizin ürününüzse ve modelin onu yeniden anlatması trafiğinizi alıyorsa — açıkça yasaklayın ve teknik önlemlerle destekleyin. Dürüst operatörler crawler'larını duyurur ve kurallara uyar; dürüst olmayanlar diğer scraper'larla birlikte genel site anti-bot korumasına girer.
Parser'lara çarpıtılmış veri vermek yasal mı?
Teknik olarak kendi kaynağınızda farklı istemcilere farklı içerik gösterme hakkınız var, ancak çarpıtılmış bilginin gerçek bir tüketiciyle işlem için gerekçe olduğu durumları hariç tutmak ve kanunun doğru bir şekilde açıklanmasını zorunlu kıldığı bilgileri çarpıtmamak gerekir. Zehirlemeyi yalnızca maksimum sınıflandırma kesinliği olan oturumlara uygulayın, yetkili kullanıcılar için devre dışı bırakın ve sektörünüzle ilgili bir avukata danışın.
Koruma ne sıklıkla güncellenmeli?
Eşikler ve istisnalar — ilk aylarda haftalık, sonrasında aylık. Challenge'lar ve tuzaklar — 4-8 haftada bir rotasyon veya atlatma tespit edildiğinde. Parser profilleri — trafik tablosundaki her belirgin değişimde yeniden gözden geçirilmeli. Tarayıcılardaki otomasyon belirtileri — her büyük tarayıcı sürümüyle. Bakımsız koruma bir-iki çeyrekte bozulur.
Büyük bütçeli bir rakip parse ediyorsa ne yapmalıyım?
Odağı bloklamadan değersizleştirme ve kanıtlara kaydırın: kanarya kayıtları ve filigranlar hukuki argüman sağlar, veri zehirleme ganimeti güvenilmez kılar, yanıt derinliğinin sınırlanması kataloğun tamamen çekilmesini engeller. Paralel olarak olayları belgeleyin ve kullanım koşullarını ihlal eden sistematik toplamaya karşı ihtar çalışmasının perspektiflerini değerlendirin — kanıt varsa bu genellikle teknik yarıştan daha etkili olur.
Bütçe ve zaman sınırlıysa nereden başlanmalı?
Loglarla bir gün teşhis. Sonra: iki pencereli farklılaştırılmış rate limiting, pahalı sayfaların önbelleklenmesi, JSON endpoint'lerinin token'larla kapatılması, gizli bağlantı tuzakları ve kanarya ürünleri. Bu set neredeyse maliyetsiz olarak bir haftada uygulanır ve sorunların büyük kısmını keser. Sonrası — ölçmek ve bir sonraki katmanın gerekli olup olmadığına karar vermek.
Sonuç: Bir satın alma değil, bir süreç olarak koruma
Söylenen her şeyi tek bir düşünceye indirgersek, o şu olur: site anti-bot koruması kurulup unutulan bir kutu değil, üç uyumlu katmandan oluşan bir sistem ve sürekli kalibrasyon sürecidir. Ağ katmanı ilkel botları neredeyse bedava keser. İstemci doğrulama scriptleri ve özensiz yapılandırılmış otomatik tarayıcıları yakalar. Davranışsal analiz ve verinin kendisiyle çalışma, gelişmiş parser'ların çabasını bile anlamsız kılar. Hepsini birleştiren ise puanlama ilkesidir: tek işaretle kapıyı kapatmamak, zayıf sinyalleri biriktirmek ve orantılı tepki vermek.
Süreç de en az o kadar önemli. Uygulamadan önce teşhis, blokları açmadan önce gözlem modu, kademeli kapsam, koruma metriklerinin yanında dönüşüm metrikleri, düzenli rotasyon — başarılı projeleri bir hafta içinde müşteri şikayetleri yüzünden geri alanlardan ayıran tam olarak budur. Ve adreslerin arkasındaki insanları hatırlayın: mobil ağlar, kurumsal proxy'ler ve mesajlaşma uygulaması web view'larındaki kullanıcılar sizin canlı alıcılarınızdır ve koruma onlara dostluk testini geçmelidir.
Bugün hemen yapılacaklar:
- Bir haftalık logları çıkarın ve teşhis bölümündeki soruları yanıtlayın. Bu ücretsizdir ve birkaç saat sürer.
- Bot trafiğinin altyapıda ve kayıp gelirde size ne kadara mal olduğunu hesaplayın. Bu rakam bütçeyi belirleyecek.
- Kontrol listesine göre birinci hattı uygulayın: limitler, önbellek, başlık kuralları, API koruması.
- Tuzakları ve kanarya kayıtlarını yerleştirin — aylarca sizin için çalışacaklar.
- İkinci ve üçüncü hatları her adımda gözlem moduyla aşamalı olarak planlayın.
- Koruma bakım takvimi oluşturun ve bir sorumlu atayın.
Topladığınız ve oluşturduğunuz veriler bir varlıktır. Her varlık gibi onlar da değerleriyle orantılı ve yaratıldıkları kişileri engellemeyen bir korumayı hak eder. Umarız bu rehber, loglara ilk bakıştan olgun ve sakin çalışan bir sisteme kadar her aşamada geri döneceğiniz bir yer imi olur.
