Zbieranie opinii z map, marketplace'ów i agregatorów: instrukcja krok po kroku dla początkujących
Spis treści
- Wprowadzenie: co z tego wyniesiesz
- Wstępne przygotowanie: narzędzia i dostępy
- Podstawowe pojęcia: jak zbudowane są opinie i dlaczego zbiera się je inaczej niż katalogi
- Krok 1: określamy cel i tworzymy listę źródeł
- Krok 2: projektujemy tabelę opinii
- Krok 3: wykorzystujemy oficjalne ścieżki — panele i api
- Krok 4: zbieramy opinie z map — mapy yandex, 2gis, google maps
- Krok 5: zbieramy opinie z marketplace'ów — wildberries, ozon, yandex market
- Krok 6: zbieramy opinie z agregatorów — otzovik, irecommend, flamp, zoon
- Krok 7: podłączamy mobilne proxy i konfigurujemy rotację
- Krok 8: zapisujemy, czyścimy i deduplikujemy
- Sprawdzenie wyniku: checklista i testowanie
- Typowe błędy i rozwiązania
- Dodatkowe możliwości dla zaawansowanych
- Faq: częste pytania o zbieranie opinii
- Zakończenie
Wprowadzenie: co z tego wyniesiesz
Opinie to najuczciwsze źródło informacji o produkcie, sklepie czy lokalu. Ludzie sami opowiadają w nich, co im się podobało, co się zepsuło, dlaczego więcej nie wrócą i co doradziliby znajomym. Problem w tym, że opinie są rozrzucone po dziesiątkach platform: mapach, marketplace'ach, agregatorach, katalogach branżowych. Czytanie ich ręcznie tygodniami jest nierealne. Dlatego potrzebne jest systematyczne zbieranie.
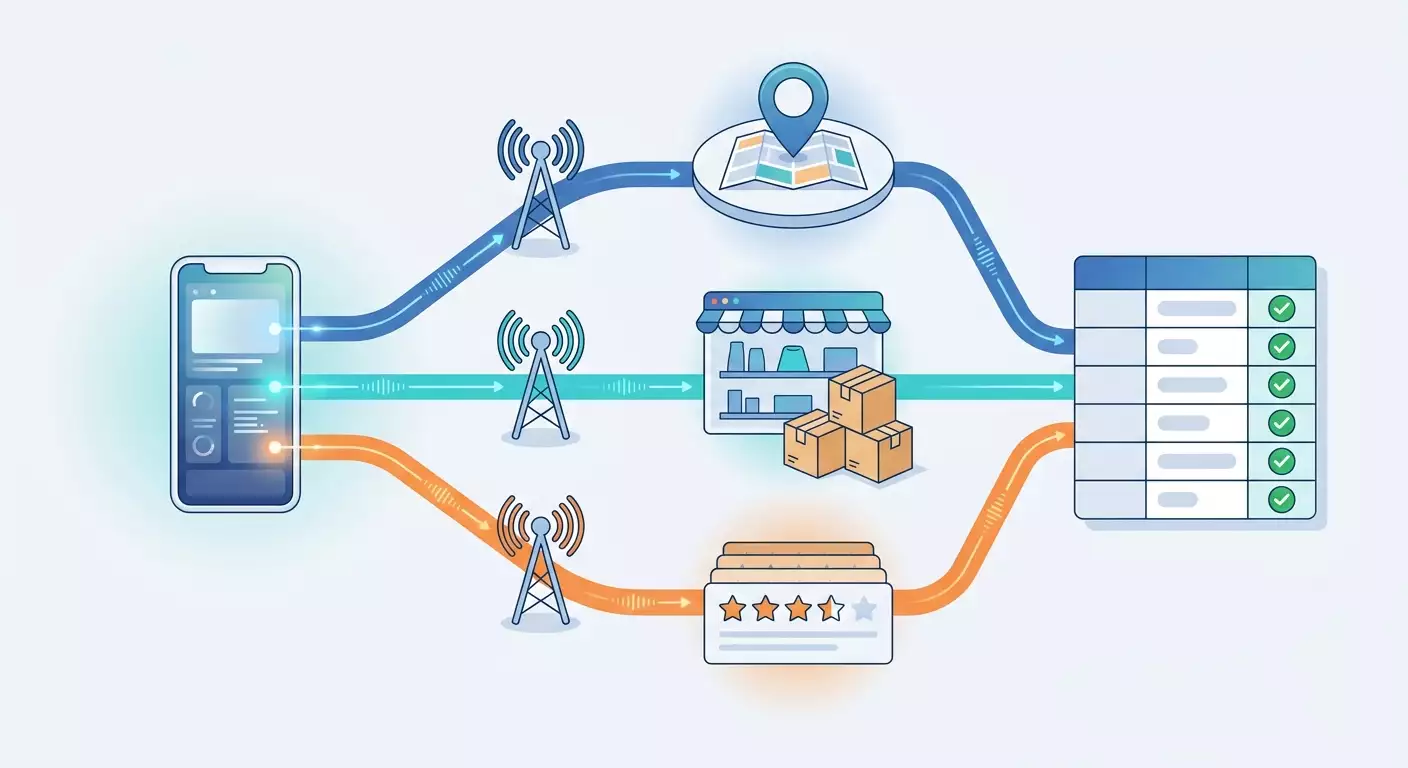
W tym przewodniku omówimy, jak zbierać opinie z trzech typów platform: serwisów mapowych (Mapy Yandex, 2GIS, Google Maps), marketplace'ów (Wildberries, Ozon, Yandex Market) i agregatorów (Otzovik, iRecommend, Flamp, Zoon). Przejdziesz całą drogę: od postawienia zadania i zaprojektowania tabeli, przez działający skrypt i podłączenie mobilnych proxy, aż po czyszczenie danych.
Co otrzymasz w rezultacie:
- Zrozumienie, gdzie i w jakiej formie leżą opinie na każdym typie platform.
- Gotową strukturę tabeli opinii, którą można wgrać do Excela, Google Sheets lub bazy danych.
- Działający parser opinii w Pythonie, który potrafi chodzić przez mobilne proxy i nie przeciąża platform.
- Znajomość oficjalnych ścieżek eksportu: paneli, API partnerskich, eksportów.
- Checklistę sprawdzania jakości zebranych danych i listę typowych błędów.
Dla kogo jest ten przewodnik. Jest skierowany do marketerów, właścicieli firm, specjalistów od arbitrażu i początkujących programistów. Jeśli nigdy nie pisałeś kodu — nie martw się. Część scenariuszy wykonasz bez programowania, a do skryptów dajemy gotowe fragmenty, które wystarczy skopiować i podstawić własne wartości. Dla tych, którzy już umieją programować, na końcu jest osobny blok z zaawansowanymi technikami.
Co trzeba wiedzieć wcześniej. Wystarczy umieć obsługiwać przeglądarkę, instalować programy i pracować z tabelami. Podstawowe pojęcie o tym, czym są proxy, pomoże, ale kluczowe terminy wyjaśnimy po drodze.
Ważna granica tego materiału. Mówimy tu tylko o opiniach jako osobnym typie danych: tekście, ocenie, dacie, autorze, odpowiedzi firmy. Nie omawiamy parsowania katalogów produktów, cen i stanów magazynowych — to osobny temat o własnych specyfikach. Jeśli potrzebujesz cen, ten przewodnik nie będzie odpowiedni, a jeśli potrzebujesz informacji zwrotnej od klientów — jesteś we właściwym miejscu.
Ile czasu to zajmie. Przygotowanie środowiska zajmie około 30-40 minut. Zaprojektowanie struktury i pierwsze zbieranie z jednej platformy — mniej więcej godzinę. Pełne przejście przez wszystkie trzy typy platform z konfiguracją proxy i czyszczeniem danych zajmie 3-4 godziny. Później zbieranie będzie zajmować minuty, bo skrypt można uruchamiać wielokrotnie.
Wstępne przygotowanie: narzędzia i dostępy
Zanim zaczniesz zbierać opinie, trzeba przygotować miejsce pracy. Poniżej lista tego, co będzie potrzebne. Nie pomijaj tego rozdziału, nawet jeśli coś wydaje się oczywiste: połowa problemów w kolejnych krokach wynika właśnie z nieprzygotowanego środowiska.
Wymagania systemowe
- Komputer z Windows 10/11, macOS lub Linux. Wystarczy dowolny laptop z ostatnich 6-7 lat.
- Minimum 4 GB pamięci RAM. Do zbierania dziesiątek tysięcy opinii lepiej 8 GB.
- Stabilny internet. Samo zbieranie nie wymaga dużej prędkości, ale przerwy w połączeniu prowadzą do luk w danych.
- Około 2 GB wolnego miejsca na dysku na Pythona, biblioteki i wyniki.
Co trzeba zainstalować
- Python 3.11 lub nowszy. Pobierz instalator z oficjalnej strony Pythona. Przy instalacji na Windows koniecznie zaznacz pole „Add Python to PATH” na pierwszym ekranie instalatora. Bez tego komenda python nie będzie działać w terminalu.
- Edytor kodu. Wystarczy VS Code — darmowy i przejrzysty. Po instalacji otwórz go raz, żeby upewnić się, że się uruchamia.
- Biblioteki Python. Otwórz terminal (na Windows — PowerShell, na macOS — Terminal) i wykonaj komendę:
pip install requests pandas openpyxl. Poczekaj na komunikat Successfully installed. Zajmie to 1-2 minuty. - Przeglądarka Chrome lub Yandex Browser. Potrzebna do badania platform przez narzędzia deweloperskie. Są wbudowane, nic osobno nie trzeba instalować.
- Edytor tabel. Excel, LibreOffice Calc lub Google Sheets — do przeglądania wyników.
Jakie dostępy będą potrzebne
- Dostęp do mobilnych proxy. Zarejestruj się na mobileproxy.space, wybierz taryfę z odpowiednim geo (dla rosyjskich platform — rosyjscy operatorzy) i otrzymaj dane połączenia: host, port, login, hasło. Znajdź też w panelu link do zmiany IP — przyda się w kroku z rotacją.
- Dostęp do paneli platform, jeśli zbierasz opinie o własnej firmie. To Yandex Biznes, panel sprzedawcy Wildberries, Ozon Seller, Yandex Market dla sprzedawców, Google Business Profile. Oficjalne eksporty stamtąd to najczystsze źródło.
- Folder projektu. Utwórz na dysku folder, np. reviews_project, a w nim dwa podfoldery: raw na surowe dane i clean na przetworzone. To twoje zabezpieczenie: surowe dane nigdy nie są nadpisywane.
Rada: Od razu załóż w folderze projektu plik tekstowy sources.txt i zapisuj tam każdy adres, z którego zbierasz opinie, wraz z datą. Po miesiącu nie przypomnisz sobie, skąd wzięła się dana tabela, a taki dziennik rozwieje wszystkie wątpliwości.
Kopie zapasowe
Kopia zapasowa dotyczy tu nie systemu, a danych. Przyjmij zasadę: każde uruchomienie parsera zapisuje wynik do nowego pliku z datą w nazwie, np. reviews_ozon_2026-03-14.csv. Starych plików nie usuwaj przynajmniej przez miesiąc. Jeśli nowe zbieranie okaże się uszkodzone z powodu zmian na platformie, zostanie ci działająca wersja.
Sprawdzenie: Wpisz w terminalu python --version — powinna pojawić się wersja 3.11 lub wyższa. Następnie wpisz python -c 'import requests, pandas; print(1)' — powinna pojawić się cyfra 1 bez błędów. Jeśli obie komendy zadziałały, środowisko jest gotowe.
Podstawowe pojęcia: jak zbudowane są opinie i dlaczego zbiera się je inaczej niż katalogi
Zanim coś uruchomisz, ważne jest zrozumienie, z jakim typem danych pracujesz. Opinia to nie tylko tekst. To ustrukturyzowany zapis z kilkoma polami, który ma cechy nieobecne w karcie produktu.
Kluczowe terminy prostym językiem
- Opinia (review) — zapis pozostawiony przez użytkownika o obiekcie: produkcie, sklepie, lokalu. Zwykle zawiera ocenę, tekst, datę, imię autora, a czasem zdjęcia.
- Obiekt opinii — to, o czym jest opinia: karta produktu na marketplace'ie, organizacja na mapie, firma na agregatorze. Każdy obiekt ma unikalny identyfikator na platformie.
- Odpowiedź firmy — replika przedstawiciela biznesu pod opinią. Dla analizy jakości wsparcia to osobne pole.
- Paginacja — podział opinii na strony lub porcje. Platforma oddaje np. po 20 opinii na raz i trzeba pobierać kolejne porcje.
- Parser opinii — program, który automatycznie obchodzi potrzebne obiekty, wyciąga opinie i składa je w tabelę. Może być prostym skryptem lub gotowym serwisem.
- Deduplikacja — usuwanie powtórzeń. Ta sama opinia może trafić do zbioru dwa razy z powodu paginacji lub ponownych uruchomień.
- Mobilne proxy — serwery pośredniczące z adresami IP operatorów komórkowych. Zapytania przez nie wyglądają jak ruch zwykłego użytkownika ze smartfona. Platformy są przychylniejsze takiemu ruchowi, bo za jednym mobilnym IP stoją setki realnych ludzi.
- Rotacja IP — zmiana adresu proxy co zadany interwał lub na żądanie. Pomaga rozłożyć obciążenie i nie tworzyć nienaturalnego strumienia zapytań z jednego adresu.
Czym zbieranie opinii różni się od zbierania katalogu
Katalog produktów jest względnie statyczny: karta jest, ma cenę i cechy. Opinie żyją inaczej i to wpływa na cały proces.
- Opinie stale się dodają. Trzeba umieć dociągać tylko nowe, a nie zdejmować wszystko za każdym razem.
- Opinie ładują się osobno. Na większości platform tekst opinii nie przychodzi w samej stronie, a osobnym zapytaniem w tle. To dobra wiadomość: takie zapytania oddają gotowy JSON, nie trzeba parsować HTML.
- Opinie zawierają dane osobowe. Imię autora, awatar, czasem miasto. Dotyczą tego wymogi prawa — o tym poniżej.
- Opinie są sortowane i filtrowane. Domyślnie platforma może pokazywać „przydatne” lub „nowe”. Jeśli nie ustalisz sortowania, przy różnych uruchomieniach zbiersz różne zbiory.
- Opinie są edytowane i usuwane. Moderacja zdejmuje część wpisów, autorzy zmieniają oceny. Data zbierania staje się ważnym polem.
Ramy prawne, które trzeba rozumieć
Uwaga: Opinie zawierają imiona i inne dane o ludziach. Przy zbieraniu i przechowywaniu przestrzegaj wymogów ustawy o ochronie danych osobowych: nie zbieraj więcej, niż potrzeba do zadania, anonimizuj autorów tam, gdzie imię nie jest potrzebne do analizy, nie przekazuj bazy osobom trzecim. Przeczytaj też regulamin platformy i plik robots.txt: niektóre serwisy wprost opisują dozwolone tryby automatycznego dostępu. Jeśli do twojego zadania istnieje oficjalne API lub eksport z panelu — zawsze zaczynaj od tego.
Jeszcze jedna zasada — z szacunkiem do obciążenia. Twój parser opinii powinien zachowywać się jak uważny użytkownik, a nie jak strumień zapytań. Pauzy między zapytaniami, rozsądna liczba wątków i rotacja przez mobilne proxy to nie spryt, a norma odpowiedzialnego zbierania. Platformy blokują nie sam fakt automatyzacji, a nienaturalne zachowanie, które przeszkadza w ich pracy.
Krok 1: Określamy cel i tworzymy listę źródeł
Cel etapu: uzyskać konkretną, ograniczoną listę obiektów, z których będziemy zbierać opinie, i zrozumieć, jakich pól potrzebujemy. Bez tego kroku parser zamienia się w nieskończony projekt.
Sformułuj pytanie, na które odpowiedzą opinie
Dobre zbieranie zaczyna się od pytania. Przykłady działających sformułowań:
- „Dlaczego konkurent X na Wildberries ma ocenę 4,8, a my 4,4 w tej samej kategorii?”
- „Na co najczęściej narzekają w opiniach o naszych pięciu kawiarniach na Mapach Yandex w ostatnim półroczu?”
- „Jakie problemy klientów pojawiają się w opiniach o kursach online na Otzoviku, żeby wykorzystać je w kreacjach?”
Zwróć uwagę: w każdym pytaniu jest platforma, obiekt, okres i typ informacji. To właśnie określa ustawienia zbierania.
Zbierz listę obiektów
- Otwórz platformę w przeglądarce i znajdź ręcznie każdy potrzebny obiekt: kartę produktu, organizację na mapie, stronę firmy na agregatorze.
- Skopiuj pełny adres strony z paska adresu.
- Wyodrębnij z adresu identyfikator obiektu. Na Wildberries to liczba w adresie karty po catalog/, na Ozon — liczba po product/ i myślniku na końcu, na Mapach Yandex — długa liczba po org/ i nazwie, w 2GIS — liczba po firm/. Zapisz ją osobno.
- Wpisz wszystko do tabeli sources.csv z kolumnami: platforma, nazwa obiektu, adres, identyfikator, komentarz.
- Na pierwsze uruchomienie ogranicz się do 3-5 obiektów na platformę. Później to rozszerzysz.
Zdecyduj, jakich pól potrzebujesz
Minimalny zestaw pól dla każdej opinii: identyfikator opinii na platformie, identyfikator obiektu, platforma, ocena, tekst, data publikacji, data zbierania. Zestaw rozszerzony: imię autora (lub jego hash), obecność zdjęć, osobno zalety i wady (jest na marketplace'ach i Otzoviku), odpowiedź firmy i jej data, liczba polubień lub oznaczeń „przydatne”, wariant produktu (rozmiar, kolor), status potwierdzonego zakupu.
Rada: Nie gonić za wszystkimi polami naraz. Zbieraj minimalny zestaw plus 2-3 pola, które naprawdę są potrzebne do twojego pytania. Każde zbędne pole to dodatkowe miejsce, gdzie struktura platformy może się zmienić i zepsuć skrypt.
Oczekiwany rezultat: plik sources.csv z 5-15 wierszami i zapisana lista pól. Każdy wiersz ma wypełniony identyfikator.
Możliwe problemy: nie wiadomo, gdzie w adresie jest identyfikator. Rozwiązanie: otwórz dwa podobne obiekty na jednej platformie i porównaj adresy — części wspólne to szablon, różniące się to identyfikator.
Sprawdzenie: Potrafisz przeczytać dowolny wiersz sources.csv i po samym identyfikatorze otworzyć ręcznie potrzebny obiekt na platformie. Jeśli musisz zgadywać — wróć i uściślij identyfikatory.
Krok 2: Projektujemy tabelę opinii
Cel etapu: ustalić jednolity format zapisu, do którego będą sprowadzane opinie ze wszystkich platform. To pozwoli analizować je razem, a nie w pięciu różnych tabelach.
Jednolity schemat
Utwórz w edytorze kodu plik schema.txt i wypisz kolumny w takiej kolejności:
- review_id — identyfikator opinii na platformie. Jeśli platforma nie oddaje go wprost, tworzymy go sami z obiektu, autora i daty.
- source — krótki kod platformy: yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon.
- object_id — identyfikator obiektu z sources.csv.
- object_name — czytelna nazwa dla wygody.
- rating — liczba od 1 do 5. Jeśli platforma używa innej skali, sprowadzamy do pięciostopniowej i zapisujemy to w komentarzu.
- text — pełny tekst opinii w jednym wierszu. Podziały wierszy zamieniamy na spację.
- pros i cons — zalety i wady, jeśli platforma je rozdziela. Inaczej puste.
- author — imię autora lub jego zanonimizowany hash.
- published_at — data publikacji w formacie RRRR-MM-DD.
- company_reply — tekst odpowiedzi firmy, jeśli jest.
- likes — liczba oznaczeń przydatności.
- has_photo — 1 lub 0.
- collected_at — data i godzina zbierania.
- url — adres strony obiektu.
Dlaczego potrzebny jest właśnie jednolity format
Każda platforma oddaje dane w swojej formie: gdzieś data to ciąg „3 dni temu”, gdzieś liczba milisekund, gdzieś tekst „14 marca”. Jeśli nie sprowadzisz wszystkiego do wspólnej postaci na wejściu, przy analizie utoniesz w wyjątkach. Sprowadzać do schematu trzeba od razu przy zapisie, a nie później.
Zasady anonimizacji
Jeśli do zadania nie potrzebujesz imion autorów (a w 90% zadań analitycznych nie potrzebujesz), przechowuj hash zamiast imienia. W Pythonie robi się to jedną linijką przez moduł hashlib: bierze się imię autora, dodaje kod platformy, a wynik zamienia w krótki ciąg. Tak odróżnisz opinie jednego autora od siebie, ale nie będziesz przechowywać samego imienia.
Rada: Dodaj do schematu kolumnę raw_json, do której będzie zapisywana surowa odpowiedź platformy dla konkretnej opinii. Zajmuje miejsce, ale pozwala później wyciągnąć pole, o którym dziś nie pomyślałeś, bez ponownego zbierania.
Oczekiwany rezultat: plik schema.txt z kolumnami i pusty szablon tabeli reviews_template.csv z tymi nagłówkami.
Sprawdzenie: Otwórz reviews_template.csv w Excelu. Powinieneś zobaczyć jeden wiersz nagłówków, w którym są dokładnie te kolumny, co w schema.txt, i ani jednej zbędnej.
Krok 3: Wykorzystujemy oficjalne ścieżki — panele i API
Cel etapu: wyeksportować opinie o własnej firmie najczystszą metodą, bez parsowania w ogóle. Jeśli analizujesz tylko siebie, ten krok może wystarczyć.
Yandex Biznes (opinie na Mapach Yandex)
- Zaloguj się do Yandex Biznes na koncie właściciela organizacji.
- W lewym menu wybierz sekcję „Opinie”.
- Na górze wybierz potrzebny oddział, jeśli organizacji jest kilka.
- Ustaw filtr po okresie i ocenie.
- Lista opinii wyświetla się z tekstem, datą, oceną i twoimi odpowiedziami. Bezpośredniego przycisku eksportu do tabeli nie ma, więc przy dużych wolumenach użyj kopiowania ze stron albo przejdź do kroku 4.
Wildberries: API opinii dla sprzedawców
Wildberries ma oficjalną sekcję API do pracy z opiniami i pytaniami. Jest dostępna dla sprzedawców i oddaje opinie o twoich towarach z oceną, tekstem, zaletami i wadami, datą, a także pozwala na nie odpowiadać.
- Zaloguj się do panelu sprzedawcy WB Partners.
- Otwórz ustawienia profilu, sekcję „Dostęp do API”.
- Utwórz nowy token, zaznaczając kategorię dostępu do opinii i pytań. Nazwij go zrozumiale, np. reviews_export.
- Skopiuj token od razu — ponownie się nie pokaże. Zapisz w pliku config.txt w folderze projektu.
- Odwołuj się do metod listy opinii z tym tokenem w nagłówku Authorization. Dokumentacja opisuje parametry paginacji i filtrowania po datach.
Ozon Seller API i Yandex Market
Ozon udostępnia dostęp do opinii przez Seller API dla sprzedawców z subskrypcją obejmującą pracę z opiniami. Klucz tworzy się w sekcji „Ustawienia”, podsekcji „Klucze API”. Yandex Market oddaje opinie o towarach sprzedawcy przez API partnerskie po identyfikatorze biznesu, klucz wydaje się w panelu sprzedawcy w sekcji ustawień dostępu.
Google Business Profile i 2GIS dla biznesu
Opinie o własnej organizacji na Google Maps są dostępne w panelu Google Business Profile i przez jego API po potwierdzeniu uprawnień. 2GIS oferuje właścicielom panel z powiadomieniami o opiniach i możliwością odpowiedzi.
Uwaga: Tokeny i klucze API to dostęp do twojego konta biznesowego. Nigdy nie wstawiaj ich bezpośrednio do kodu, trzymaj je w osobnym pliku, który nie trafia do wspólnych folderów i repozytoriów. Jeśli token przypadkiem wyciekł — natychmiast go unieważnij w panelu i utwórz nowy.
Kiedy oficjalne ścieżki nie wystarczają
Wszystkie wymienione sposoby dają opinie tylko o twoich obiektach. Do analizy konkurencji, rynku czy cudzych produktów nie pasują. Wtedy przechodzimy do zbierania ze stron publicznych — temu poświęcone są kolejne kroki.
Oczekiwany rezultat: jeśli pracujesz z własną firmą — pierwsza tabela opinii z oficjalnego źródła sprowadzona do schematu z kroku 2.
Sprawdzenie: Liczba opinii w eksporcie zgadza się z liczbą, którą pokazuje panel za ten sam okres, z tolerancją 1-2 wpisów na opinie, które w chwili eksportu przechodziły moderację.
Krok 4: Zbieramy opinie z map — Mapy Yandex, 2GIS, Google Maps
Cel etapu: nauczyć się znajdować zapytanie w tle, którym mapa dociąga opinie, i odtwarzać je skryptem. Ta umiejętność jest uniwersalna i przyda się na wszystkich pozostałych platformach.
Jak znaleźć zapytanie z opiniami przez narzędzia deweloperskie
- Otwórz w Chrome stronę organizacji na Mapach Yandex lub 2GIS.
- Naciśnij klawisz F12. Z prawej lub z dołu otworzy się panel deweloperski.
- Przejdź na zakładkę Network (Sieć). Jeśli jest pusta — odśwież stronę klawiszem F5.
- W pasku filtra nad listą zapytań naciśnij przycisk Fetch/XHR. Zostaną tylko zapytania w tle po dane.
- Na stronie organizacji przejdź do sekcji opinii i przewiń listę w dół, żeby dociągnęła się kolejna porcja.
- Na liście zapytań pojawi się nowe. W jego nazwie zwykle jest słowo review lub feedback. Kliknij na nie.
- Otwórz zakładkę Preview lub Response. Zobaczysz strukturę JSON, gdzie zagnieżdżoną listą idą opinie: tekst, ocena, data, autor.
- Otwórz zakładkę Headers. Skopiuj pełny adres zapytania (Request URL) i zwróć uwagę na parametry: zwykle jest tam identyfikator obiektu, numer strony lub przesunięcie, rozmiar porcji i sortowanie.
- Znajdź w tej samej sekcji nagłówki zapytania: User-Agent, Accept, Referer. Będą potrzebne do przekazania ze skryptu.
Rada: Kliknij prawym przyciskiem na znalezione zapytanie i wybierz Copy, a następnie Copy as cURL. Otrzymasz komendę ze wszystkimi nagłówkami. Wygodnie wkleić ją do pliku tekstowego jako wzorzec: jeśli skrypt nagle przestanie działać, porównasz jego zapytanie z wzorcowym.
Specyfika każdej mapy
- Mapy Yandex. Opinie dociągają się porcjami ze wskazaniem sortowania (po nowości, po ocenie, po trafności). Koniecznie ustal jedno sortowanie, inaczej przy różnych uruchomieniach zbiory się rozjadą. Data przychodzi w formacie maszynowym, ocena — liczbą. Odpowiedzi organizacji leżą w osobnym zagnieżdżonym polu.
- 2GIS. Serwis ma publiczną usługę opinii, do której odwołuje się sama strona. Zapytanie zawiera identyfikator oddziału oraz parametry limitu i przesunięcia. W odpowiedzi jest tekst, ocena, data, nazwa użytkownika, oficjalna odpowiedź i licznik przydatności. Przychodzi też łączna liczba opinii — użyj jej do sprawdzenia kompletności.
- Google Maps. Najtrudniejsza z trzech platform: opinie przychodzą w spakowanym formacie wewnątrz długich odpowiedzi. Dla kilkudziesięciu obiektów prościej użyć Places API z oficjalnym kluczem — oddaje ograniczony zestaw ostatnich opinii o każdym miejscu, co często wystarcza do oceny sentymentu. Do pełnego zbierania po cudzych obiektach potrzebna będzie automatyzacja przeglądarki — to temat zaawansowanego bloku.
Piszemy pierwszy skrypt
Utwórz plik collect_maps.py i wklej szkielet. Adres zapytania i nazwy pól podstaw z tego, co zobaczyłeś w panelu deweloperskim — różnią się między platformami i mogą się zmieniać w czasie.
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
Przeanalizujmy, co tu się dzieje. Zmienna PROXY przechowuje dane twojego mobilnego proxy. Nagłówek User-Agent przedstawia zapytanie jako przeglądarkę mobilną — to logicznie łączy się z mobilnym IP. Funkcja collect chodzi po stronach, aż platforma zwróci pustą listę, i po każdej stronie robi pauzę 2,5 sekundy. Pauza to nie formalność: sprawia, że obciążenie przypomina czytanie przez żywego człowieka.
Uruchomienie i zapis wyniku
- Na końcu pliku dodaj wywołanie funkcji dla jednego obiektu z sources.csv i zapis wierszy do CSV przez moduł csv z kodowaniem utf-8-sig, żeby Excel poprawnie otworzył polski tekst.
- Otwórz terminal w folderze projektu i wykonaj
python collect_maps.py. - Obserwuj wyjście. Warto drukować numer strony i liczbę zebranych wierszy po każdym zapytaniu.
- Otwórz otrzymany plik w Excelu i przejrzyj pierwsze 20 wierszy.
Oczekiwany rezultat: plik CSV z opiniami jednej organizacji, gdzie liczba wierszy jest zbliżona do licznika opinii na stronie organizacji.
Możliwe problemy: odpowiedź przychodzi z kodem 403 lub pusta. Rozwiązanie: porównaj nagłówki ze skopiowaną komendą cURL, szczególnie Referer i Accept. Sprawdź, że proxy jest podłączone i odpowiedziało na testowe zapytanie do dowolnej strony. Zwiększ pauzę do 4-5 sekund.
Sprawdzenie: Weź trzy losowe opinie z pliku i znajdź je na stronie organizacji po tekście. Wszystkie trzy powinny się znaleźć, z tymi samymi ocenami i datami.
Krok 5: Zbieramy opinie z marketplace'ów — Wildberries, Ozon, Yandex Market
Cel etapu: dostosować podejście z kroku 4 do marketplace'ów, gdzie opinie są przypisane do produktów i mają dodatkowe pola: zalety, wady, wariant produktu, zdjęcia.
Wildberries
Na Wildberries opinie są przypisane nie do artykułu, a do łączącego identyfikatora karty, pod którym zgrupowane są kolory i rozmiary. To ważne: jeśli zbierzesz opinie po artykule, otrzymasz je dla wszystkich wariantów naraz i trzeba będzie filtrować po polu wariantu.
- Otwórz kartę produktu, naciśnij F12, przejdź na zakładkę Network z filtrem Fetch/XHR.
- Przewiń do bloku opinii i naciśnij „Zobacz wszystkie opinie”.
- Znajdź zapytanie, w którego nazwie jest feedbacks. W odpowiedzi będzie lista z tekstem, oceną, datą, polami zalet i wad, imieniem autora, kolorem i rozmiarem, oznaczeniem obecności zdjęć i odpowiedzią sprzedawcy.
- Zwróć uwagę na łączną liczbę opinii w odpowiedzi — pomoże sprawdzić kompletność.
- Skopiuj adres i nagłówki, podstaw do skryptu według wzoru z kroku 4. Paginacji tu może nie być — część odpowiedzi przychodzi w całości, czasem bardzo dużym plikiem. Zwiększ timeout do 60 sekund.
Ozon
Ozon aktywnie chroni dane i sprawdza zachowanie klienta. Do opinii strona używa wewnętrznego zapytania o skład strony, w którym opinie to jeden z bloków. Praktyczna kolejność działań:
- Otwórz stronę produktu, następnie przejdź do sekcji opinii po linku z karty.
- W panelu deweloperskim znajdź zapytanie, w którego odpowiedzi jest tablica z polami content, score lub rating i author. Może nazywać się różnie, szukaj po zawartości przez pasek wyszukiwania panelu (kombinacja Ctrl+F wewnątrz zakładki Network).
- Skopiuj zapytanie jako cURL. Zwróć uwagę na nagłówki i cookies: Ozon jest wrażliwy na ich brak.
- Przy odtwarzaniu ze skryptu użyj sesji requests.Session, żeby cookies zachowały się między zapytaniami, i zrób pierwsze zapytanie na zwykłą stronę produktu, a dopiero potem po opinie. To imituje naturalną ścieżkę użytkownika.
- Trzymaj pauzy 4-6 sekund i zmieniaj IP przez mobilne proxy co 30-50 zapytań.
Uwaga: Jeśli platforma zaczęła oddawać stronę sprawdzania przeglądarki lub captchę — to sygnał, żeby się zatrzymać, a nie naciskać dalej. Zmniejsz częstotliwość, zmień IP przez link rotacji i poczekaj 10-15 minut. Systematyczne naciskanie na mechanizmy ochronne prowadzi do blokady całej puli adresów i jest sprzeczne z regulaminami platform.
Yandex Market
Opinie na Yandex Market bywają dwóch typów: o produkcie (wspólne dla wszystkich sprzedawców) i o sklepie. Do analizy produktu potrzebne są pierwsze, do analizy serwisu — drugie. U obu typów jest podział na zalety, wady i komentarz, a także ocena i data. Zapytanie o opinie znajduje się tym samym sposobem przez panel deweloperski na zakładce „Opinie” karty produktu.
Sprowadzanie do schematu
Na marketplace'ach pole tekstu często składa się z trzech części. Zapisuj je tak: pros — do kolumny pros, cons — do kolumny cons, a ogólny komentarz — do text. Jeśli do analizy potrzebny jest jeden ciągły tekst, na etapie czyszczenia połącz trzy kolumny przez separator, ale w surowych danych przechowuj osobno.
Rada: Na marketplace'ach opinie ze zdjęciami i potwierdzonym zakupem są wyraźnie bardziej informacyjne. Dodaj filtr w skrypcie: najpierw zbieraj wszystko, a przy analizie patrz osobno na wycinek z has_photo równym 1. Często właśnie tam są najszczegółowsze opisy defektów i realnych scenariuszy użycia.
Oczekiwany rezultat: po jednym CSV na każdy marketplace z opiniami o 3-5 produktach, sprowadzonymi do jednolitego schematu.
Możliwe problemy: liczba zebranych opinii jest mniejsza niż licznik na stronie. Przyczyna: platforma ogranicza głębokość wyników lub oddaje opinie tylko z tekstem, ukrywając oceny bez komentarza. Rozwiązanie: porównaj liczniki „wszystkich ocen” i „z tekstem” na stronie — zwykle rozbieżność wyjaśnia się właśnie tym.
Sprawdzenie: Otwórz plik w Excelu, zbuduj tabelę przestawną po kolumnie rating. Rozkład ocen powinien w przybliżeniu odpowiadać temu, co pokazuje karta produktu: jeśli na platformie 70% to piątki, w twojej próbce powinno być zbliżone.
Krok 6: Zbieramy opinie z agregatorów — Otzovik, iRecommend, Flamp, Zoon
Cel etapu: nauczyć się pracować z platformami, gdzie opinie to samodzielne artykuły z HTML, a nie JSON w tle.
Czym różnią się agregatory
Otzovik i iRecommend budują strony klasycznie: każda opinia to osobna strona z tytułem, długim tekstem, oceną, datą, zaletami i wadami, a na stronie obiektu leży lista linków do tych opinii z krótkimi zapowiedziami. Flamp i Zoon są bliżej map: organizacja, lista opinii, dociąganie porcjami. Odpowiednio, dla pierwszych dwóch potrzebne jest parsowanie HTML, dla drugich pasuje metoda z kroku 4.
Instalacja biblioteki do parsowania HTML
Wykonaj w terminalu pip install beautifulsoup4 lxml. Biblioteka BeautifulSoup pozwala znajdować elementy strony po tagach i klasach, tak jak znajdujesz je wzrokiem w panelu deweloperskim.
Zbieranie z Otzovika krok po kroku
- Otwórz stronę obiektu (produktu, firmy, kursu) na Otzoviku.
- Naciśnij F12 i przejdź na zakładkę Elements (Elementy).
- Naciśnij ikonę strzałki w lewym górnym rogu panelu i kliknij na tytuł pierwszej opinii na liście. W panelu podświetli się element HTML. Zapisz jego tag i klasę — to selektor linku do opinii.
- Tym samym sposobem znajdź elementy oceny (zwykle blok z gwiazdkami i atrybutem liczbowym), daty i krótkiego tekstu.
- Przewiń stronę w dół i znajdź blok paginacji. Kliknij na cyfrę 2 i zobacz, jak zmienił się adres — zwykle dodaje się numer strony. To szablon do obchodzenia.
- W skrypcie: ładuj stronę listy przez requests z proxy, parsuj przez BeautifulSoup, wyciągaj linki do opinii i zapowiedzi, a potem przechodź na następną stronę listy. Pauza między stronami — 5-8 sekund, agregatory są wrażliwsze od map.
- Jeśli potrzebny jest pełny tekst opinii, a nie zapowiedź, zrób drugie przejście: po każdym linku ładuj stronę opinii i wyodrębniaj główny tekst, bloki zalet i wad, ocenę po podkryteriach.
iRecommend
Logika podobna do Otzovika: strona obiektu z listą opinii i osobne strony opinii. Różnica w strukturze i w tym, że ocena jest wyrażona liczbą wypełnionych gwiazdek — licz elementy gwiazdek z aktywną klasą, a nie szukaj liczby.
Flamp i Zoon
Dla tych platform użyj metody z kroku 4: otwórz organizację, przełącz na Fetch/XHR, przewiń opinie i znajdź zapytanie w tle. Flamp oddaje opinie z oceną, tekstem, datą, oficjalną odpowiedzią i przydatnością. Zoon — z oceną, tekstem, datą i odpowiedzią organizacji. Obie platformy pokazują łączną liczbę opinii do kontroli kompletności.
Mini-przykład parsowania HTML
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
Nazwy klas są tu umowne — podstaw prawdziwe, które zobaczyłeś w panelu Elements. Sprawdzenia na pusty element są obowiązkowe: jeśli struktura jednej opinii się różni, skrypt nie powinien się wywalić w całości.
Rada: Na agregatorach daty są często zapisane słowami: „wczoraj”, „3 dni temu”, „14 marca”. Załóż osobną funkcję normalizacji dat, która tłumaczy takie ciągi na format RRRR-MM-DD względem daty zbierania. Bez niej sortowanie po czasie nie będzie działać.
Oczekiwany rezultat: CSV z opiniami z jednego-dwóch agregatorów, gdzie dla każdej opinii jest ocena, data i tekst, a dla Otzovika i iRecommend — jeszcze link do pełnej strony.
Możliwe problemy: selektory przestały znajdować elementy po kilku stronach. Przyczyna: platforma oddała stronę sprawdzania zamiast listy. Rozwiązanie: sprawdzaj tytuł strony po każdym ładowaniu, przy oznakach sprawdzania — pauza, zmiana IP, powtórka po kilku minutach.
Sprawdzenie: Liczba zebranych opinii z jednej strony listy równa się liczbie opinii, które widzisz na tej stronie w przeglądarce. Jeśli zebrało się mniej — jeden z selektorów jest zbyt wąski.
Krok 7: Podłączamy mobilne proxy i konfigurujemy rotację
Cel etapu: sprawić, żeby parser opinii działał stabilnie na dziesiątkach i setkach obiektów, rozkładając obciążenie i nie tworząc nienaturalnego strumienia z jednego adresu.
Dlaczego właśnie mobilne proxy
Wszystkie platformy z tego przewodnika są nastawione na mobilną publiczność: większość opinii pisze się i czyta ze smartfonów. Mobilne adresy IP operatorów to adresy, za którymi jednocześnie jest setki i tysiące realnych abonentów. Platformy nie mogą blokować takich adresów bez szkody dla prawdziwych użytkowników, więc są do nich przychylne. Dla zbierania opinii oznacza to mniej sprawdzeń, mniej fałszywych alarmów ochrony i przewidywalną prędkość.
Konfiguracja połączenia
- Zaloguj się do panelu mobileproxy.space i otwórz listę swoich proxy.
- Skopiuj host, port, login i hasło. Zwróć uwagę na protokół: dla requests wygodniejsze jest HTTP proxy, ale SOCKS5 też jest obsługiwane po instalacji dodatku
pip install requests[socks]. - Wstaw dane do zmiennej PROXY w skrypcie. Format: protokół, dwukropek, dwa ukośniki, login, dwukropek, hasło, małpa, host, dwukropek, port.
- Skopiuj z panelu link do zmiany IP i zapisz w zmiennej ROTATE_URL.
- Wykonaj testowe zapytanie przez proxy do dowolnego serwisu pokazującego twoje IP. W odpowiedzi powinien być adres operatora mobilnego, a nie twojego domowego dostawcy.
Strategia rotacji
Są dwa podejścia i oba działają.
- Rotacja po czasie. W panelu ustawia się interwał automatycznej zmiany IP, np. co 5 minut. Skrypt nic nie robi — adres zmienia się sam. Pasuje do długich spokojnych zbiorów.
- Rotacja po zdarzeniu. Skrypt sam szarpie ROTATE_URL w odpowiednim momencie: po każdych N zapytaniach, przy przejściu do nowego obiektu lub przy otrzymaniu kodu 429/403. Pasuje, gdy potrzebna jest kontrola.
Praktyczna zasada dla opinii: zmieniaj IP przy przejściu do każdego nowego obiektu i dodatkowo po 40-60 zapytaniach w obrębie jednego obiektu. Po zmianie IP zrób pauzę 5-10 sekund — operator potrzebuje czasu, żeby nowy adres stał się aktywny.
Obsługa błędów i powtórzenia
Dodaj do funkcji fetch_page opakowanie: przy kodach 429, 403, 5xx lub timeout — wywołaj rotację, poczekaj, powtórz zapytanie do trzech razy ze zwiększającą się pauzą (10, 30, 90 sekund). Jeśli trzy próby nie pomogły — zapisz obiekt do pliku failed.txt i przejdź do następnego. Tak jeden problematyczny obiekt nie zatrzyma całego zbierania, a luki później dociągniesz osobno.
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
Ile wątków używać
Dla początkujących — jeden wątek. Jedno proxy, jedno połączenie, sekwencyjne obchodzenie. To wolne, ale niezawodne: 500-1000 opinii na godzinę bez jednego problemu. Kiedy upewnisz się, że wszystko jest stabilne, możesz dodać drugie proxy i uruchomić drugi egzemplarz skryptu na drugiej połowie listy obiektów. Więcej niż 3-4 wątki na platformę dla opinii prawie nigdy nie jest potrzebne.
Rada: Uzgodnij User-Agent z typem IP. Jeśli idziesz przez mobilne proxy, przedstawiaj się jako przeglądarka mobilna, jak w przykładzie z kroku 4. Rozbieżność „mobilne IP, ale desktopowy Chrome na Windows” sama w sobie nie jest krytyczna, ale spójność zmniejsza liczbę dodatkowych sprawdzeń.
Oczekiwany rezultat: skrypt, który przechodzi cały sources.csv po jednej platformie bez ręcznej interwencji, zmienia IP przy przejściu między obiektami i zapisuje problematyczne obiekty do failed.txt.
Możliwe problemy: po zmianie IP pierwsze zapytania padają z timeoutem. Rozwiązanie: zwiększ pauzę po rotacji do 15 sekund. Proxy w ogóle się nie łączy — sprawdź, czy w panelu nie jest włączona biała lista IP, i dodaj tam adres swojego komputera.
Sprawdzenie: Uruchom zbieranie po 10 obiektach pod rząd. W logu powinny być wpisy o zmianie IP między obiektami, plik failed.txt pusty lub z nie więcej niż jednym obiektem, a łączna liczba wierszy w wyniku porównywalna z sumą liczników opinii na platformie.
Krok 8: Zapisujemy, czyścimy i deduplikujemy
Cel etapu: zamienić zbiór surowych CSV z różnych platform w jedną czystą tabelę, nadającą się do analizy.
Łączenie plików
- Upewnij się, że wszystkie surowe pliki leżą w folderze raw i mają takie same nagłówki zgodnie z schema.txt.
- Utwórz plik merge.py. Przez pandas przeczytaj wszystkie CSV z folderu raw do jednego DataFrame: funkcja pandas.concat łączy listę tabel.
- Sprawdź typy: rating powinien być liczbą, published_at — datą. Sprowadź przez pandas.to_numeric i pandas.to_datetime z parametrem errors='coerce', żeby niepoprawne wartości stały się puste, a nie zepsuły przetwarzania.
Deduplikacja
Powtórzenia pojawiają się z trzech powodów: nakładanie się stron przy paginacji, ponowne uruchomienia i ta sama opinia, opublikowana przez autora na kilku platformach. Obsługuj po kolei:
- Usuń dokładne duplikaty po parze source i review_id — to powtórzenia od paginacji i restartów. Metoda drop_duplicates z parametrem subset.
- Znajdź nieostre duplikaty w obrębie jednej platformy: ten sam object_id, ta sama data i pierwsze 100 znaków tekstu. Tak bywa, gdy platforma zmienia identyfikator przy edycji opinii.
- Duplikatów międzyplatformowych nie usuwaj, a oznacz osobną kolumną. Fakt, że ktoś napisał to samo na Otzoviku i w Mapach Yandex, sam w sobie jest informacyjny.
Czyszczenie tekstu
- Usuń podwójne spacje i podziały wierszy w tekście.
- Usuń serwisowe frazy platform, które trafiają do tekstu: „Czytaj całość”, „Pokaż więcej”.
- Zamień puste ciągi w pros i cons na wyraźną wartość pustą, a nie na ciąg „brak” lub „-”.
- Sprawdź kodowanie: jeśli widzisz krzaki, plik został zapisany nie w utf-8. Zapisz ponownie z surowego źródła.
Eksport wyniku
Zapisz wynikową tabelę w folderze clean pod nazwą reviews_all_RRRR-MM-DD.xlsx przez metodę to_excel i równolegle w CSV. Excel jest wygodny do przeglądania, CSV — do wgrywania do innych systemów. Dodatkowo zapisz osobny plik z podsumowaniem: liczba opinii po platformach, średnia ocena po obiektach, udział opinii z odpowiedzią firmy.
Rada: Dodaj do czystej tabeli kolumnę text_len z długością tekstu. Opinie krótsze niż 30 znaków prawie zawsze są bezużyteczne do analizy przyczyn, za to długie opinie z oceną 2-3 to złoto: ludzie szczegółowo wyjaśniają w nich, co dokładnie jest nie tak.
Oczekiwany rezultat: jeden czysty plik z opiniami ze wszystkich platform, bez dokładnych duplikatów, z poprawnymi typami danych i podsumowaniem.
Możliwe problemy: po deduplikacji zniknęło zbyt wiele wierszy. Przyczyna: review_id na jakiejś platformie okazał się pusty dla wszystkich rekordów i wszystkie policzyły się jako duplikaty. Rozwiązanie: sprawdź wypełnienie review_id po platformach i dla problematycznej platformy utwórz identyfikator z object_id, daty i hasha tekstu.
Sprawdzenie: Liczba wierszy w czystym pliku nie jest mniejsza niż o 5-10% od sumy wierszy surowych plików. W kolumnie rating nie ma wartości poza zakresem 1-5, w kolumnie published_at nie ma dat z przyszłości.
Sprawdzenie wyniku: checklista i testowanie
Zanim wyciągniesz wnioski z zebranych opinii, upewnij się, że zbieranie przebiegło poprawnie. Przejdź checklistę w całości.
Checklista gotowości
- Dla każdego obiektu z sources.csv w czystej tabeli jest co najmniej jedna opinia albo obiekt zapisany w failed.txt z przyczyną.
- Liczba opinii po każdym obiekcie różni się od licznika na platformie nie więcej niż o 10%.
- Rozkład ocen po obiekcie w przybliżeniu zgadza się z rozkładem, który pokazuje platforma.
- Najświeższa opinia w tabeli jest datowana nie później niż na wczoraj względem daty zbierania, jeśli obiekt jest aktywny.
- Wszystkie daty w formacie RRRR-MM-DD, wszystkie oceny — liczby.
- Dokładnych duplikatów po source i review_id nie ma.
- Imiona autorów albo nie występują, albo są zamienione na hashe, jeśli zadanie nie wymaga imion.
- Pliki surowych danych są zachowane z datą i nie nadpisane.
- Tokeny i dane proxy nie leżą w skrypcie, a są wyniesione do osobnego pliku konfiguracji.
Jak przetestować wybiórczo
- Wybierz losowe 10 opinii z tabeli funkcją sample w pandas.
- Dla każdej otwórz stronę obiektu na platformie i znajdź opinię po fragmencie tekstu.
- Porównaj ocenę, datę i obecność odpowiedzi firmy.
- Jeśli zgadza się 10 z 10 — świetnie. Jeśli 8-9 — sprawdź, czy rozbieżności nie są związane z edycją opinii po zebraniu. Jeśli mniej niż 8 — jest błąd systemowy w parsowaniu, wróć do odpowiedniego kroku.
Wskaźniki udanego wykonania
Sukces wygląda tak: możesz otworzyć jedną tabelę, przefiltrować ją po dowolnej platformie i obiekcie, posortować po dacie i ocenie i w pięć minut odpowiedzieć na pierwotne pytanie z kroku 1. Na przykład zobaczyć, że 40% opinii z oceną 1-2 o kawiarni na Mapach Yandex z ostatnich trzech miesięcy wspomina czas oczekiwania, a na 2GIS ci sami ludzie chwalą kawę, ale narzekają na personel. Jeśli pytanie znajduje odpowiedź — zbieranie spełniło swoje zadanie.
Typowe błędy i rozwiązania
Poniżej zebrano problemy, z którymi spotyka się prawie każdy, kto po raz pierwszy konfiguruje parser opinii. Format: problem, przyczyna, rozwiązanie.
1. Skrypt zebrał tylko pierwsze 20 opinii
Przyczyna: nie zaimplementowano paginacji lub błędnie określono parametr przesunięcia.
Rozwiązanie: wróć do panelu deweloperskiego, przewiń listę opinii dwa razy i porównaj adresy dwóch kolejnych zapytań. Parametr, który się zmienił, to właśnie przesunięcie lub numer strony. Upewnij się, że skrypt zwiększa go o właściwy krok.
2. Wszystkie opinie przychodzą z jedną datą — datą zbierania
Przyczyna: w pole published_at zapisuje się collected_at, albo platforma oddaje datę w polu o innej nazwie.
Rozwiązanie: otwórz raw_json jednej opinii i znajdź pole z datą publikacji. Może nazywać się date, created, published, time, updatedAt. Popraw nazwę pola w skrypcie.
3. Polski tekst w Excelu wyświetla się nieprawidłowo
Przyczyna: CSV zapisany w utf-8 bez znacznika kolejności bajtów, Excel otwiera go w innym kodowaniu.
Rozwiązanie: zapisuj z kodowaniem utf-8-sig albo eksportuj od razu do xlsx przez to_excel.
4. Platforma odpowiada kodem 403 na każde zapytanie
Przyczyna: nie przekazano obowiązkowych nagłówków, nie ustawiono cookies sesji lub zapytanie idzie zbyt często.
Rozwiązanie: porównaj z wzorcową komendą cURL. Użyj requests.Session i najpierw załaduj zwykłą stronę obiektu. Zwiększ pauzy do 5 sekund. Zmień IP przez proxy i poczekaj 10 minut przed powtórzeniem.
5. Zebrane oceny nie zgadzają się z rzeczywistymi
Przyczyna: platforma przechowuje ocenę w innej skali (np. od 0 do 100 lub od 1 do 10) albo w osobnym polu jest ocena po podkryterium, a nie ogólna.
Rozwiązanie: porównaj ręcznie trzy opinie. Określ skalę i sprowadź do pięciostopniowej przez dzielenie z zaokrągleniem. Udokumentuj to w schema.txt.
6. Liczba opinii przy każdym uruchomieniu jest inna
Przyczyna: nie ustalono sortowania i platforma oddaje różne zbiory w trybie „po trafności”.
Rozwiązanie: znajdź parametr sortowania w adresie zapytania i sztywno ustaw sortowanie po dacie. Zbieraj do momentu, aż natrafisz na opinię starszą niż potrzebny okres.
7. Skrypt pada na jednym obiekcie i nie idzie dalej
Przyczyna: brak obsługi wyjątków, każdy błąd zatrzymuje program.
Rozwiązanie: opakuj przetwarzanie każdego obiektu w try-except, zapisz błąd i identyfikator obiektu do failed.txt i przejdź do następnego. Luki dociągniesz osobnym uruchomieniem.
8. Po tygodniu pracy skrypt nagle przestał cokolwiek znajdować
Przyczyna: platforma zmieniła adres zapytania, strukturę JSON lub nazwy klas w HTML.
Rozwiązanie: to normalna część życia każdego parsera. Powtórz procedurę szukania zapytania z kroku 4 i zaktualizuj adres i nazwy pól. Trzymaj listę selektorów i pól w osobnym pliku konfiguracji, żeby poprawiać jedno miejsce, a nie cały kod.
9. Proxy działa, ale prędkość jest bardzo niska
Przyczyna: zbyt duże odpowiedzi (marketplace'y czasem oddają tysiące opinii jednym plikiem) lub obciążenie stacji bazowej operatora w godzinach szczytu.
Rozwiązanie: zwiększ timeout, włącz kompresję przez nagłówek Accept-Encoding, zaplanuj duże zbiory na godziny nocne.
Dodatkowe możliwości dla zaawansowanych
Jeśli opanowałeś podstawowy scenariusz, oto kierunki rozwoju. Ten blok zakłada, że pewnie piszesz w Pythonie.
Zbieranie przyrostowe
Zamiast pełnego przeczesywania przechowuj dla każdego obiektu datę najświeższej zebranej opinii. Przy następnym uruchomieniu zbieraj z sortowaniem po dacie i zatrzymuj się, gdy tylko natrafisz na opinię nie nowszą niż zapisana data. Tak codzienne odświeżanie po 500 obiektach zajmuje minuty zamiast godzin, a obciążenie platform spada dziesiątki razy. Uwzględnij, że opinie mogą pojawiać się z datą wsteczną po moderacji — rób nakładkę 2-3 dni.
Automatyzacja przeglądarki dla trudnych platform
Google Maps i część sekcji Ozona łatwiej zbierać przez sterowaną przeglądarkę: Playwright z podłączonym mobilnym proxy otwiera stronę, przewija listę opinii i przechwytuje odpowiedzi w tle przez handler zdarzeń response. Otrzymujesz ten sam JSON, co w panelu deweloperskim, ale bez konieczności ręcznego odtwarzania nagłówków i cookies. Playwright obsługuje emulację urządzeń mobilnych, co świetnie łączy się z mobilnym IP. Cena — prędkość i zużycie pamięci: jedna przeglądarka zjada 300-500 MB, więc uruchamiaj nie więcej niż 2-3 egzemplarze.
Przechowywanie w bazie danych
Kiedy opinii jest więcej niż 100 tysięcy, CSV staje się niewygodny. Przechodź na SQLite (wbudowany w Pythona, plik na dysku, zero konfiguracji) lub PostgreSQL. Tabela reviews z unikalnym indeksem po parze source i review_id automatycznie chroni przed duplikatami: wstawianie przez INSERT z obsługą konfliktu ON CONFLICT DO NOTHING odrzuca powtórzenia na poziomie bazy.
Wzbogacanie i analiza
- Sentyment i tematy. Przepuść teksty przez model językowy z promptem typu „wyodrębnij 3 główne tematy i ogólny sentyment”. Wynik kładź do osobnych kolumn. Dla dziesiątek tysięcy opinii używaj przetwarzania wsadowego i cache, żeby nie płacić dwa razy za ten sam tekst.
- Dynamika ocen. Zbuduj średnią ocenę po tygodniach dla każdego obiektu. Gwałtowny spadek to sygnał o problemie, który opinie wyjaśnią słowami.
- Szybkość reakcji firmy. Różnica między published_at a datą odpowiedzi firmy to bezpośredni wskaźnik jakości wsparcia, własnego i konkurencji.
- Słownik bólów do reklamy. Analiza częstości rzeczowników i przymiotników w opiniach z oceną 1-2 daje gotową listę sformułowań do kreacji i stron docelowych.
Monitoring zdrowia parsera
Ustaw codzienne uruchamianie przez harmonogram zadań Windows lub cron i dodaj proste sprawdzenie: jeśli w ciągu doby zebrano mniej niż 30% średniej z tygodnia lub udział błędów przekroczył 10% — wyślij powiadomienie na Telegram przez bota. Tak dowiesz się o zmianie struktury na platformie tego samego dnia, a nie po miesiącu, gdy dane będą potrzebne.
Zarządzanie pulą proxy
Pracując z kilkoma platformami naraz, przypisz do każdej osobne mobilne proxy. Tak zachowanie na jednej platformie nie wpływa na reputację adresu na innej. Rotację dla map rób rzadziej (obiekty zwykle są małe, 50-200 opinii), dla marketplace'ów — częściej (tysiące opinii na kartę). Prowadź dziennik: czas, platforma, IP, kod odpowiedzi. Po tygodniu po tym dzienniku będzie widać, jakie interwały rotacji są optymalne dla twojego profilu obciążenia.
FAQ: częste pytania o zbieranie opinii
Czy zbieranie opinii ze stron publicznych jest legalne?
Zbieranie publicznie dostępnych informacji do własnej analizy samo w sobie nie jest zabronione, ale są ograniczenia: regulaminy platform, wymogi ustawy o ochronie danych osobowych, zakaz utrudniania pracy serwisu. Przestrzegaj pauz, anonimizuj autorów, nie publikuj zebranych baz i używaj oficjalnych API tam, gdzie są. Przy komercyjnym wykorzystaniu danych skonsultuj się z prawnikiem.
Czy można obejść się bez programowania?
Częściowo. Dla własnych obiektów wystarczą panele. Do niewielkich jednorazowych zadań przydadzą się rozszerzenia przeglądarki do parsowania, które eksportują widoczne na stronie elementy do tabeli: ty ręcznie przewijasz opinie, rozszerzenie zbiera. Do regularnego zbierania po dziesiątkach obiektów skrypt jest jednak wygodniejszy i niezawodniejszy, a gotowe fragmenty z tego przewodnika można użyć prawie bez zmian.
Po co mobilne proxy, jeśli mam tylko 10 obiektów?
Dla 10 obiektów i jednorazowego zbierania można spróbować i bez nich. Ale gdy tylko zaczniesz odświeżać dane regularnie lub rozszerzysz listę, zapytania z jednego domowego IP zaczną dostawać dodatkowe sprawdzenia. Mobilne proxy rozwiązuje to z góry, a koszt jest nieporównywalny z czasem, który uchodzi na rozwiązywanie blokad.
Ile opinii na godzinę realnie można zebrać?
W jednym wątku z pauzami 2-5 sekund — od 500 do 1500 opinii na godzinę w zależności od rozmiaru porcji na platformie. Marketplace'y oddające setki opinii jednym zapytaniem dają więcej, agregatory ze stronicowanym HTML — mniej. Dla większości zadań analitycznych to więcej niż wystarczy.
Jak zbierać tylko nowe opinie, a nie wszystko od nowa?
Zapisuj datę ostatniej zebranej opinii po każdym obiekcie, sortuj po dacie przy zapytaniu i zatrzymuj się na pierwszej już znanej opinii. Więcej — w bloku o zbieraniu przyrostowym.
Opinie bez tekstu, tylko z oceną — zbierać czy nie?
Zależy od zadania. Do obliczenia średniej oceny i dynamiki — tak, wpływają na liczby. Do analizy przyczyn — nie, można je odfiltrować przy przetwarzaniu. Zbieraj wszystko, a filtruj na etapie analizy: ponowne zbieranie jest droższe.
Co robić, jeśli platforma pokazuje captchę?
Zatrzymać zbieranie na 10-15 minut, zmienić IP przez proxy, zmniejszyć częstotliwość zapytań i sprawdzić nagłówki. Captcha to sygnał, że twoje zachowanie wygląda nietypowo. Zadanie — uczynić je typowym, a nie przebijać się przez sprawdzenie.
Jak przechowywać imiona autorów, żeby nie łamać prawa?
Najlepiej wcale nie przechowywać. Jeśli trzeba odróżniać opinie jednego autora, użyj jednostronnego hasha z imienia. Jeśli imiona są konieczne (np. do odpowiedzi klientowi przez panel), przechowuj je tylko w ramach pracy z własną organizacją i nie przekazuj osobom trzecim.
Jak często psują się parsery opinii?
Duże platformy zmieniają wewnętrzne zapytania i strukturę kilka razy w roku. Przy dobrym monitoringu naprawa zajmuje 20-40 minut: powtórzyć szukanie zapytania i zaktualizować pola. Trzymaj selektory i adresy w pliku konfiguracji, a poprawki będą punktowe.
Czy jednym skryptem można zbierać ze wszystkich platform?
Tak, jeśli zrobisz wspólny szkielet (proxy, powtórzenia, zapis do schematu) i dla każdej platformy osobną funkcję-adapter, która zna adres zapytania i nazwy pól. Tak właśnie zbudowane są dojrzałe projekty: jeden wspólny moduł i dziesiątka małych adapterów.
Zakończenie
Podsumujmy. Przeszedłeś drogę od postawienia pytania do czystej tabeli opinii z trzech różnych typów platform. Nauczyłeś się znajdować zapytania w tle przez panel deweloperski, odtwarzać je skryptem, parsować HTML tam, gdzie JSON jest niedostępny, podłączać mobilne proxy z rotacją, obsługiwać błędy i powtarzać zapytania, łączyć i czyścić dane. Osobno rozgryzłeś oficjalne ścieżki eksportu i ramy prawne, co chroni i dane, i ciebie.
Najważniejsze, co warto wynieść: opinie to szczególny typ danych o własnej dynamice. Pojawiają się stale, są edytowane, przechodzą moderację i niosą informacje osobowe. Dlatego parser opinii to nie jednorazowy skrypt, a mały system: zbieranie, przechowywanie surowych danych, sprowadzanie do schematu, deduplikacja, monitoring. Każdy element tego systemu już zbudowałeś w podstawowej wersji.
Co dalej:
- Rozszerz sources.csv do realnej listy obiektów i przeprowadź pełne zbieranie.
- Ustaw codzienne uruchamianie przyrostowe przez harmonogram.
- Dodaj co najmniej jedną nakładkę analityczną: dynamikę oceny lub tematyzację negatywnych opinii.
- Załóż dziennik zmian platform i aktualizuj adaptery w miarę awarii.
Kierunki rozwoju. Następny poziom to automatyzacja reakcji: powiadomienia dla zespołu o negatywnej opinii w ciągu godziny od publikacji, raporty porównawcze o konkurencji raz w tygodniu, integracja tematów z opinii w plan produktu i hipotezy reklamowe. Dane już masz. Zostało zamienić je w decyzje, a tu zaczyna się najciekawsza część pracy.
