Jak zbudować korpus dla systemu RAG przez mobilne proxy i nie zebrać śmieci: przewodnik krok po kroku
Spis treści
- Wprowadzenie: co otrzymasz i dla kogo jest ten przewodnik
- Przygotowanie wstępne: narzędzia, dostępy, środowisko
- Podstawowe pojęcia prostym językiem
- Krok 1: określamy granice korpusu i tworzymy mapę źródeł
- Krok 2: podłączamy mobilne proxy i sprawdzamy, czy żądania przez nie przechodzą
- Krok 3: piszemy staranny kolektor z limitami, rotacją i dziennikiem
- Krok 4: wyodrębniamy czysty tekst z html i dokumentów
- Krok 5: filtrujemy śmieci: deduplikacja, szablony, jakość, język
- Krok 6: oznaczamy metadane i składamy końcowy korpus
- Weryfikacja wyniku: lista kontrolna i testowanie korpusu
- Typowe błędy i rozwiązania przy zbieraniu korpusu dla rag
- Dodatkowe możliwości dla zaawansowanych
- Faq: częste pytania o zbieranie korpusu
- Zakończenie: co zostało zrobione i dokąd iść dalej
Wprowadzenie: co otrzymasz i dla kogo jest ten przewodnik
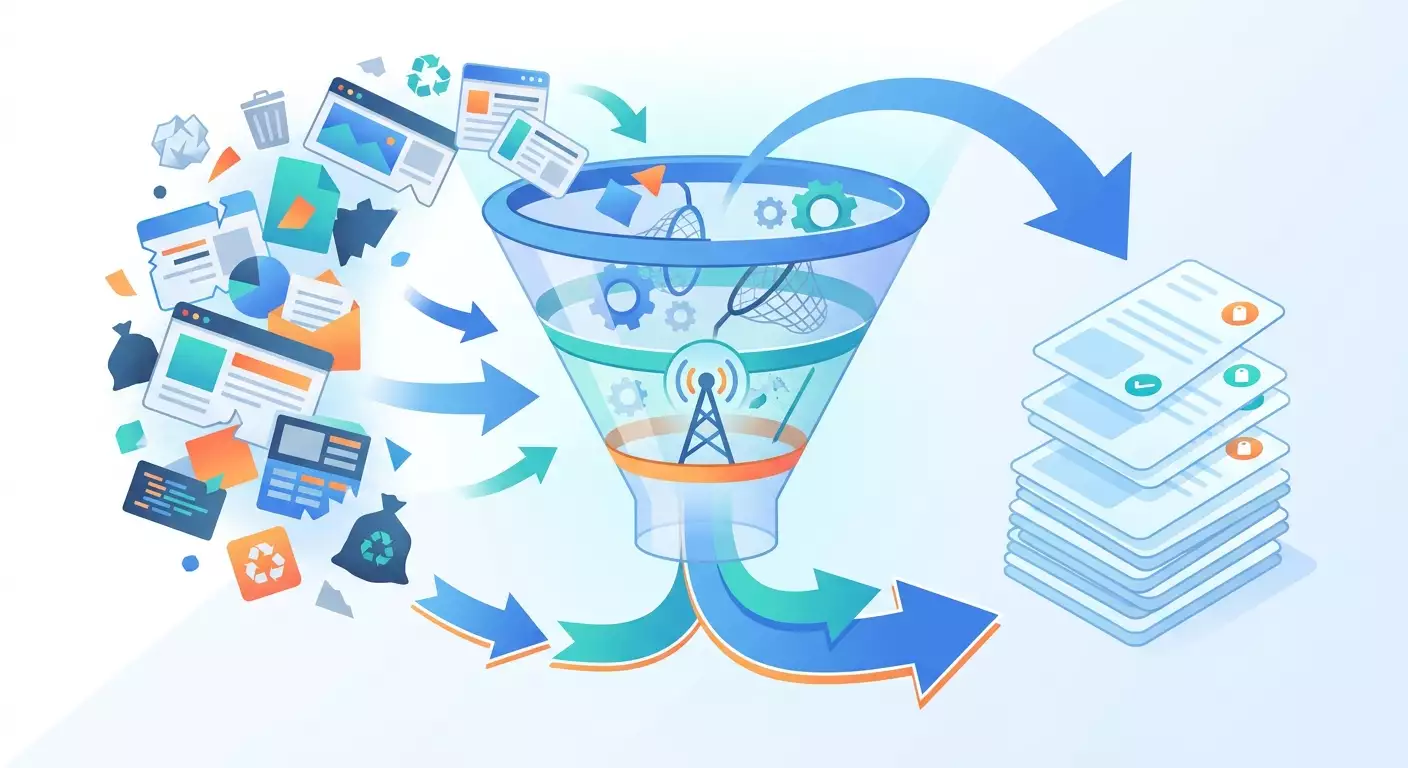
System RAG jest tak dobry, jak dobry jest korpus, na którym odpowiada. Możesz wziąć najsilniejszy model językowy, podłączyć drogą bazę wektorową i otrzymać pewną siebie bzdurę, jeśli do korpusu trafią menu strony, stopki z prawami autorskimi, duplikaty tego samego artykułu w pięciu wersjach i strony „produkt tymczasowo niedostępny”. Model nie odróżnia śmieci od wiedzy. Po prostu szuka podobnych fragmentów i składa z nich odpowiedź.
Ten przewodnik krok po kroku poświęcony jest jednemu etapowi: zbieraniu korpusu. Nie będziemy omawiać budowy bazy wektorowej, wyboru embeddingów ani konfiguracji chunków – o tym są osobne materiały na blogu. Zatrzymamy się dokładnie na granicy: na dysku leży czysty, oznaczony, zdeduplikowany zestaw dokumentów w formacie JSONL, który można przekazać do dowolnego pipeline'u indeksowania.
Co otrzymasz w efekcie:
- listę źródeł z jasnymi granicami: co zbieramy, a czego nie;
- działający kolektor w Pythonie, który korzysta z mobilnego proxy, przestrzega limitów i nie przeciąża cudzych stron;
- folder z surowymi stronami i dokumentami, każdy z metadanymi;
- skrypt do ekstrakcji głównego tekstu bez nawigacji, reklam i szablonowych bloków;
- filtry jakości i deduplikację, które odsieją śmieci, zanim trafią do indeksu;
- gotowy plik korpusu i raport z liczbami, które pokazują, że wszystko zrobiono poprawnie.
Dla kogo jest ten przewodnik. Dla marketerów i właścicieli firm, którzy chcą zbudować bazę wiedzy o swojej niszy i stworzyć na niej asystenta. Dla specjalistów od arbitrażu, którym potrzebny jest korpus o ofertach, landing page'ach i zasadach platform reklamowych. Dla programistów, którzy już podłączali proxy do skryptów i teraz chcą robić to starannie i systematycznie. Główny tekst jest napisany dla początkujących, a na końcu znajduje się osobny blok dla zaawansowanych.
Co trzeba wiedzieć wcześniej. Umieć uruchamiać polecenia w terminalu i otwierać pliki w edytorze tekstu. Mieć podstawowe pojęcie o Pythonie na poziomie „rozumiem, co robi pętla for”. Mieć dostęp do mobilnego proxy: adres, port, login, hasło i link do zmiany IP.
Ile czasu to zajmie. Przygotowanie środowiska około 30 minut. Przejście wszystkich kroków od 3 do 5 godzin, w zależności od objętości korpusu. Samo zbieranie kilku tysięcy stron może trwać w tle kilka godzin, ale twój udział w tym czasie nie jest potrzebny.
Przygotowanie wstępne: narzędzia, dostępy, środowisko
Zanim napiszesz pierwszą linię kodu, uporządkuj miejsce pracy. To oszczędzi ci godziny debugowania później.
Wymagania systemowe
- Komputer lub serwer z Windows 10/11, macOS lub Linux. Do zbierania dziesiątek tysięcy stron wygodniejszy jest wynajęty VPS, ale do pierwszego korpusu wystarczy laptop.
- Co najmniej 8 GB pamięci RAM. Deduplikacja dużych korpusów lubi pamięć.
- Wolne miejsce na dysku: minimum 5 GB. Surowy HTML zajmuje 5-10 razy więcej niż czysty tekst, a będziemy przechowywać jedno i drugie.
- Stabilny internet. Proxy dodaje opóźnienie, więc wolne domowe łącze znacznie wydłuży zbieranie.
Co zainstalować
- Python 3.11 lub nowszy. Pobierz instalator z oficjalnej strony, przy instalacji na Windows zaznacz „Add Python to PATH”. Sprawdź w terminalu:
python --version. Powinien pojawić się wiersz typuPython 3.12.x. - Środowisko wirtualne. Utwórz folder projektu, na przykład
rag-corpus, wejdź do niego i wykonajpython -m venv venv. Aktywuj: na Windowsvenv\Scripts\activate, na macOS i Linuxsource venv/bin/activate. Na początku wiersza terminala pojawi się(venv). - Biblioteki. Zainstaluj jedną komendą:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm. Instalacja zajmie 1-3 minuty. - Edytor tekstu z podświetlaniem kodu: VS Code, PyCharm Community lub inny.
Dostępy do proxy
Otwórz panel swojego serwisu proxy. W karcie kupionego mobilnego proxy znajdź cztery wartości: host (adres IP lub nazwa domeny), port dla HTTP i port dla SOCKS5, login i hasło. Osobno skopiuj link do zmiany IP: to URL, do którego wystarczy wysłać żądanie GET, aby proxy otrzymało nowy adres od operatora. Zapisz to wszystko w pliku .env w folderze projektu, a nie bezpośrednio w kodzie.
Struktura folderów
Utwórz w projekcie następujące foldery: raw dla surowych stron, clean dla wyekstrahowanego tekstu, corpus dla pliku wynikowego, logs dla dzienników. Puste foldery na starcie to norma.
Kopie zapasowe
Korpus zbiera się długo i szkoda go stracić. Ustal z sobą zasadę: folder raw nigdy nie jest nadpisywany, tylko uzupełniany. Po każdym większym etapie archiwizuj wynik: tar -czf raw_backup_2026-03-01.tar.gz raw/ na Linux i macOS lub przez wbudowany archiwizator Windows. Jeśli popełnisz błąd w filtrach i usuniesz za dużo, zawsze możesz wrócić do surowych danych, nie zbierając ich ponownie.
Wskazówka: Od razu załóż plik sources.md i zapisuj w nim każdą decyzję: które strony bierzesz, które sekcje wykluczasz i dlaczego. Za miesiąc, gdy asystent zacznie odpowiadać dziwnie, ten plik uratuje ci wieczór.
Podstawowe pojęcia prostym językiem
Jeśli po raz pierwszy zbierasz dane dla systemu RAG, kilka terminów pojawi się w każdym kroku. Omówmy je krótko.
Czym jest RAG i dlaczego korpus jest ważniejszy od modelu
RAG (Retrieval-Augmented Generation) to podejście, w którym model językowy przed odpowiedzią otrzymuje zestaw fragmentów z twojej bazy wiedzy. Model nie „zna” twoich dokumentów, czyta znalezione fragmenty i odpowiada na ich podstawie. Stąd prosta zasada: jeśli w bazie są śmieci, wyszukiwanie prędzej czy później wyciągnie właśnie je, a odpowiedź będzie oparta na zdaniu „Zapisz się do newslettera” zamiast instrukcji. Dlatego etap zbierania korpusu jest nie do pominięcia.
Korpus, dokument, metadane
Korpus to cały zestaw tekstów, które trafią do systemu RAG. Dokument to jedna jednostka znaczeniowa: artykuł, strona pomocy, instrukcja PDF, karta produktu. Metadane to paszport dokumentu: skąd pochodzi, kiedy został zebrany, w jakim języku, kto jest autorem, do jakiej sekcji należy. Bez metadanych nie będziesz mógł ani zaktualizować korpusu, ani wyjaśnić użytkownikowi, skąd pochodzi odpowiedź, ani odfiltrować przestarzałych treści.
Mobilne proxy i po co je stosować przy zbieraniu
Mobilne proxy to serwer pośredniczący, który wysyła twoje żądania do internetu przez adres IP operatora komórkowego. Przy zbieraniu korpusu rozwiązuje trzy praktyczne problemy. Po pierwsze: rozłożenie obciążenia. Zamiast pukać do strony z jednego adresu, chodzisz z różnych, a każde źródło widzi spokojny, rzadki ruch. Po drugie: geografia. Wiele stron pokazuje różną treść, ceny i dostępność w zależności od regionu, a mobilne proxy z wybranego miasta daje dokładnie tę wersję strony, którą widzą twoi klienci. Po trzecie: stabilność długich sesji. Rotacja IP przez link pozwala kontynuować zbieranie godzinami, nie zależąc od jednego adresu.
Rotacja to zmiana adresu IP. Może być według harmonogramu (co N minut) i na żądanie (pociągasz link, kiedy chcesz). Przy zbieraniu korpusu wygodniejsza jest ta druga: zmieniasz źródło, zmieniasz adres.
Co uznać za śmieci
W kontekście korpusu śmieci to wszystko, co nie niesie wiedzy na twój temat, ale zajmuje miejsce w indeksie i psuje wyszukiwanie:
- nawigacja, menu, stopki, „okruszki”, formularze subskrypcji;
- dokładne i prawie dokładne duplikaty tego samego tekstu pod różnymi adresami;
- strony-zaślepki: „Strona nie znaleziona”, „Produkt wyprzedany”, „Trwają prace serwisowe”;
- teksty w innym języku, jeśli korpus jest jednojęzyczny;
- ucięte strony, na których proxy lub strona zwróciły połowę HTML;
- cudze treści, których nie masz prawa używać.
Ramy prawne
Zbieraj tylko otwarte dane, dostępne bez logowania, oraz własne dokumenty. Szanuj plik robots.txt: to lista zasad strony o tym, które sekcje można odwiedzać automatycznie. Nie zbieraj danych osobowych osób trzecich: imion z telefonami, adresów, kont. Jeśli budujesz korpus na własnych dokumentach wewnętrznych, upewnij się, że masz prawo ich używać. Proxy w tym przewodniku służy jako narzędzie uczciwego, rozproszonego zbierania, a nie jako sposób na robienie tego, czego źródło zabroniło.
Krok 1: Określamy granice korpusu i tworzymy mapę źródeł
Cel etapu: otrzymać plik z listą źródeł, gdzie dla każdego opisano, które URL-e bierzemy, które wykluczamy, z jaką głębokością odwiedzamy i ile żądań na minutę dopuszczamy.
Najczęstszą przyczyną zaśmieconego korpusu nie są błędy techniczne, ale brak granic. Człowiek uruchamia kolektor „na całą stronę”, otrzymuje 40 tysięcy stron, z których na temat jest 800, a potem przez tydzień je czyści. Zróbmy odwrotnie: najpierw mapa, potem zbieranie.
Instrukcja
- Sformułuj pytania, na które ma odpowiadać twój system RAG. Zapisz 20-30 rzeczywistych pytań użytkowników. Na przykład dla bazy wiedzy serwisu proxy: „Jak zmienić IP przez link”, „Dlaczego proxy odpowiada wolno”, „Jakie porty są obsługiwane”. Te pytania staną się twoim zestawem testowym na etapie weryfikacji.
- Dla każdego pytania zapisz, gdzie leży odpowiedź. Sekcja pomocy, dokumentacja, artykuły na blogu, regulaminy PDF, strony produktów. Wszystko, czego nie ma na tej liście, nie trafia do korpusu.
- Otwórz każde źródło w przeglądarce i przestudiuj strukturę adresów. Zazwyczaj przydatna treść leży pod jasnymi prefiksami:
/help/,/docs/,/blog/,/faq/. A śmieci pod innymi:/tag/,/search?,/cart/,/author/, strony paginacji typu?page=. - Sprawdź robots.txt źródła. Otwórz
https://domena/robots.txt. Znajdź linieDisallow: te ścieżki wykluczamy bez dyskusji. Jeśli jest tam teżCrawl-delay, zapisz go jako minimalną pauzę między żądaniami. - Znajdź mapę strony. Często jest podana w robots.txt w linii
Sitemap:lub leży pod adresem/sitemap.xml. Mapa strony to gotowa lista adresów, która uwolni cię od rekurencyjnego odwiedzania linków i związanych z tym śmieci. - Określ obciążenie. Dla małych stron ustaw nie więcej niż 10-15 żądań na minutę. Dla dużych portali z CDN dopuszczalne do 30. Jeśli masz wątpliwości, bierz mniej: korpus nie pali się.
- Określ geografię. Jeśli treść zależy od regionu (ceny, dostawa, dostępność), zdecyduj, z którego miasta ma „patrzeć” twój kolektor, i wybierz odpowiednie mobilne proxy.
- Zapisz wszystko w pliku
sources.json.
Przykładowy wpis dla jednego źródła:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]Pole rotate_every określa, po ilu żądaniach kolektor pociągnie link zmiany IP. Zamień pojedyncze cudzysłowy na podwójne przy zapisie do rzeczywistego pliku JSON – tutaj pokazano je dla czytelności.
Uwaga: Nie dodawaj do źródeł stron, na których przydatna treść jest widoczna tylko po zalogowaniu. Po pierwsze, narusza to regulamin większości platform. Po drugie, takiego korpusu nie da się legalnie aktualizować i rozpowszechniać w firmie.
Wskazówka: Załóż osobne źródło dla własnych dokumentów: folder z PDF, DOCX i eksportami z twojego CRM lub bazy wiedzy. Nie trzeba ich pobierać przez proxy, ale będziemy je przetwarzać i czyścić tym samym pipeline'em co strony internetowe.
Weryfikacja: Masz plik sources.json, w którym każde źródło ma prefiksy włączenia, wzorce wykluczenia, limit żądań i język. Otwórz 5 losowych adresów z mapy strony, które spełniają twoje filtry, i upewnij się, że na każdym jest merytoryczny tekst, a nie katalog linków.
Możliwe problemy
- Strona nie ma mapy strony. Zbierz listę adresów z kilku stron-spisów ręcznie lub przez proste odwiedzanie linków tylko w dozwolonych prefiksach na głębokość 2.
- Mapa strony zawiera 100 tysięcy adresów. Odfiltruj po prefiksach, następnie weź próbkę 200 adresów, zbierz i oceń jakość, zanim uruchomisz wszystko.
- Przydatna treść jest rozrzucona po różnych domenach. Załóż osobny wpis w
sources.jsondla każdej domeny, z własnym limitem i własną geografią.
Krok 2: Podłączamy mobilne proxy i sprawdzamy, czy żądania przez nie przechodzą
Cel etapu: upewnić się, że skrypt rzeczywiście chodzi przez mobilne proxy, rotacja działa, a opóźnienia są akceptowalne dla zbierania.
Instrukcja
- Utwórz plik
.envw katalogu głównym projektu i wpisz wartości z panelu:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxKażda wartość w osobnej linii. Dodaj .env do .gitignore, jeśli używasz systemu kontroli wersji.
- Utwórz plik
proxy_check.pyo następującej zawartości:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP bez proxy:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP przez proxy:', ip1, 'za', round(time.time() - t0, 2), 'sek') print('Zmieniamy IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP po rotacji:', ip2) print('Rotacja zadziałała:', ip1 != ip2)Najpierw zainstaluj pip install python-dotenv. Linie kodu w rzeczywistym pliku znajdują się każda w osobnym wierszu.
- Uruchom:
python proxy_check.py. - Przeczytaj wynik. Pierwszy IP powinien być twoim domowym lub serwerowym. Drugi powinien się różnić i należeć do operatora komórkowego. Trzeci powinien różnić się od drugiego, a ostatnia linia pokazać
True. - Zmierz opóźnienie. Jeśli żądanie przez proxy zajmuje więcej niż 5-6 sekund, zbieranie będzie wolne. Sprawdź, czy wybrane proxy jest geograficznie blisko docelowych stron, lub skontaktuj się z pomocą serwisu.
- Sprawdź SOCKS5 jako alternatywę. Jeśli port HTTP daje niestabilny wynik, zamień
http://wproxy_urlnasocks5h://i port na port SOCKS5 z panelu. Będziesz potrzebowaćpip install requests[socks]. Sufikshjest ważny: zmusza proxy do samodzielnego rozwiązywania nazw domen.
Uwaga: Nie uruchamiaj rotacji IP częściej, niż pozwala twój plan. Większość mobilnych proxy ma minimalny interwał między zmianami, zwykle od 30 sekund do 2 minut. Zbyt częste żądania do linku rotacji są albo ignorowane, albo tymczasowo blokują funkcję.
Wskazówka: Wykonaj pięć pomiarów opóźnienia pod rząd i zapisz medianę. Ta liczba przyda się w następnym kroku, aby poprawnie ustawić limity czasu: limit powinien być około 4-5 razy większy niż typowe opóźnienie.
Weryfikacja: Skrypt wyświetla trzy różne adresy IP, wiersz Rotacja zadziałała: True, a typowe opóźnienie przez proxy nie przekracza 3-4 sekund. Jeśli tak jest, proxy jest gotowe do pracy.
Możliwe problemy
- Błąd 407 Proxy Authentication Required. Sprawdź login i hasło, upewnij się, że nie ma w nich zbędnych spacji. Jeśli w haśle są znaki
@lub:, zakoduj je przezurllib.parse.quote. - Błąd Connection refused lub timeout. Proxy może być przypisane do twojego białego IP. Wejdź do panelu i dodaj aktualny adres serwera do listy dozwolonych albo przełącz się na autoryzację loginem i hasłem.
- IP po rotacji się nie zmienił. Zwiększ pauzę po żądaniu do linku rotacji do 15-20 sekund. Niektórzy operatorzy wydają nowy adres nie od razu.
- Błędy SSL. Zaktualizuj bibliotekę
certifikomendąpip install -U certifi. Nie wyłączaj weryfikacji certyfikatów parametremverify=False: to niebezpieczne.
Krok 3: Piszemy staranny kolektor z limitami, rotacją i dziennikiem
Cel etapu: otrzymać skrypt, który przechodzi po adresach z mapy strony, przestrzega robots.txt i limitów, chodzi przez proxy, zmienia IP według harmonogramu, zapisuje surowy HTML i prowadzi dziennik, w którym widać każde żądanie.
Tu ważne jest zrozumienie filozofii. Dobry kolektor dla systemu RAG jest wolny, uprzejmy i paranoicznie dokładny w logach. Szybki agresywny crawler zbierze ci górę uciętych stron i błędów 429, a potem nie będziesz wiedział, co z tego to śmieci.
Instrukcja
- Utwórz plik
fetch.py. Struktura skryptu: wczytanie ustawień, parsowanie mapy strony, filtrowanie adresów, pętla żądań z pauzami, zapis wyniku. - Wczytaj mapę strony i odfiltruj adresy. Mapa strony to XML, w którym każdy adres leży w tagu
loc. Sparsuj ją standardowymxml.etree.ElementTree. Zostaw tylko adresy zaczynające się odinclude_prefixesi niezawierające żadnego zexclude_patterns. Zapisz wynik dourls_help_center.txti spójrz na niego oczami. - Podłącz sprawdzanie robots.txt. Użyj
urllib.robotparser.RobotFileParser: wczytaj plik raz na domenę i przed każdym żądaniem pytajcan_fetch(user_agent, url). Zabronione adresy pomijaj i zapisuj w dzienniku z adnotacjąrobots_disallow. - Ustaw uczciwy User-Agent. Na przykład:
CorpusCollector/1.0 (+contact: data@yourcompany.ru). Właściciel strony powinien rozumieć, kto do niego przyszedł i jak się skontaktować. To nie tylko etyka, ale i praktyka: zrozumiały agent rzadziej trafia pod automatyczne ograniczenia. - Zaimplementuj pauzy. Z
rate_per_minuteoblicz podstawową pauzę:60 / rate_per_minutesekund. Dodaj losowy składnik 20-40 procent, aby żądania nie szły metronomem. Jeśli w robots.txt jestCrawl-delay, weź maksimum z dwóch wartości. - Zaimplementuj rotację. Licz żądania, a gdy licznik osiągnie
rotate_every, wywołaj link zmiany IP, poczekaj 10 sekund, wyzeruj licznik. Rotację warto też zrobić przy przejściu do następnego źródła. - Obsłuż odpowiedzi. Kod 200 zapisujemy. Kody 301 i 302
requestsobsłuży sam, ale zapisz końcowy adres: przyda się do deduplikacji. Kod 404 zapisujemy w dzienniku i pomijamy. Kod 429 lub 503 oznacza „za często”: rób pauzę 5 minut, zwiększ podstawową pauzę półtora raza i powtórz raz. Jeśli powtórka nie pomogła, pomiń i idź dalej. - Zapisuj surowy HTML razem z paszportem. Dla każdej strony zapisuj jedną linię w pliku
raw/help_center.jsonl.
Kluczowy fragment kodu zapisu i pętli:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))Zwróć uwagę na warunek len(html) > 2000. Strona z merytorycznym tekstem prawie nigdy nie jest krótsza niż dwa kilobajty HTML. To pierwszy, najprostszy filtr śmieci i odsiewa puste odpowiedzi i zaślepki już na wejściu.
- Uruchom na próbce. Pierwsze uruchomienie zrób na 50 adresach. Spójrz na dziennik, otwórz parę zapisanych HTML w przeglądarce. Upewnij się, że to te same strony.
- Uruchom pełne zbieranie. Na serwerze użyj
nohup python fetch.py &lubscreen, aby proces przetrwał zamknięcie terminala. Zebranie 3000 stron przy 12 żądaniach na minutę zajmie około 4-5 godzin.
Uwaga: Nie uruchamiaj kilku kopii kolektora na tę samą stronę równolegle przez jedno proxy. Rotacja IP nie znosi limitów obciążenia serwera źródła. Jeśli chcesz przyspieszyć, równoleglij po różnych stronach, a nie po jednej.
Wskazówka: Zapisuj w dzienniku IP proxy, z którego wykonano każde żądanie. Gdy na etapie czyszczenia odkryjesz partię uciętych stron, po IP i czasie od razu zobaczysz, czy to była awaria konkretnej sesji, i zbierzesz ponownie tylko ją.
Wskazówka: Dodaj do kolektora wznawianie: przed uruchomieniem odczytaj już zebrane adresy z raw/*.jsonl i pomijaj je. Wtedy zerwanie połączenia lub restart serwera nie zmusi cię do zaczynania od zera.
Weryfikacja: W folderze raw leży plik JSONL, liczba linii w nim jest bliska liczbie adresów ze statusem 200 w dzienniku, a losowo wybrana linia zawiera pola url, fetched_at, proxy_ip i pełny HTML. Udział błędów i pominięć w dzienniku nie przekracza 5 procent.
Możliwe problemy
- Wiele odpowiedzi 429. Jesteś za szybki dla tej strony. Zmniejsz
rate_per_minuteo połowę, zwiększrotate_every, aby rotacja nie wyglądała jak skok z nowych adresów. - Strony przychodzą puste, mimo statusu 200. Treść rysuje JavaScript. Takie źródła wymagają renderowania w przeglądarce – o tym w bloku zaawansowanym. Na razie oznacz je w
sources.jsonflagąneeds_js: true. - Zbieranie idzie, ale bardzo wolno. Sprawdź opóźnienie proxy z Kroku 2, upewnij się, że limit czasu nie jest ustawiony na 120 sekund przy typowym opóźnieniu 2, bo każda zawieszona strona zjada dwie minuty.
- Skrypt pada na kodowaniu. Używaj
r.textz sprawdzeniemr.encoding; jeśli strona podaje kodowanie niepoprawnie, podstawr.encoding = r.apparent_encodingprzed odczytem.
Krok 4: Wyodrębniamy czysty tekst z HTML i dokumentów
Cel etapu: zamienić surowy HTML i pliki w czysty tekst, w którym pozostała tylko główna treść strony: nagłówek, akapity, listy, tabele, bez menu, stopek, wstawek reklamowych i widgetów.
To moment, w którym rodzi się albo umiera jakość korpusu. Naiwne podejście „usunąć wszystkie tagi” zostawia w tekście punkty menu, przyciski „Kup”, tekst banera cookies i listy podobnych artykułów. Wszystko to potem wypływa w odpowiedziach systemu RAG.
Instrukcja dla stron internetowych
- Utwórz plik
extract.py. Czytaraw/*.jsonllinia po linii i zapisuje wynik doclean/*.jsonl. - Użyj biblioteki
trafilaturado ekstrakcji głównego tekstu. Jest wyszkolona, by znajdować obszar treści strony i odrzucać bloki szablonowe.
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- Parametr
favor_precision=Truezmusza bibliotekę do bycia surowszą: woli stracić kawałek tekstu, niż przygarnąć menu. Dla korpusu RAG to właściwy wybór. Jeśli zauważysz, że giną potrzebne bloki, na przykład tabele charakterystyk, przełącz nafavor_recall=Truedla konkretnego źródła. - Dodaj metodę zapasową. Jeśli
trafilaturazwróciNonelub tekst krótszy niż 200 znaków, spróbuj wyodrębnić treść po selektorze CSS, który znajdziesz ręcznie: otwórz stronę w przeglądarce, naciśnij F12, znajdź blok z głównym tekstem, skopiuj jego klasę, na przykładarticle-body. UżyjBeautifulSoupdo wycięcia tylko tego bloku. Wpisz selektor dosources.jsonjakocontent_selector. - Znormalizuj tekst. Zamień twarde spacje na zwykłe, zwiń trzy i więcej przejść do nowej linii w dwa, usuń spacje na początku i końcu linii. Nie zmieniaj wielkości liter i nie usuwaj znaków interpunkcyjnych: to pogorszy wyszukiwanie.
- Zapisz razem z oryginalnymi metadanymi. Skopiuj z surowego rekordu
url,final_url,fetched_at, dodajsourcezsources.json, pola z ekstrakcji i długość tekstu w znakach.
Instrukcja dla PDF i DOCX
- PDF. Użyj
pypdf: otwórz plik, przejdź po stronach, wywołajpage.extract_text()i połącz. Zapisz numer strony dla każdego fragmentu: to cenne metadane, dzięki nim użytkownik będzie mógł znaleźć miejsce w oryginale. Jeśli tekst wraca pusty, PDF zawiera skany, a nie tekst: takie pliki odłóż do osobnego folderu, rozpoznawanie jest poza zakresem tego przewodnika. - DOCX. Użyj
python-docx: przejdź podocument.paragraphsidocument.tables. Nagłówki w Wordzie mają stylHeading 1,Heading 2: zapisuj je jako osobne linie z adnotacją, po nich wygodnie będzie później dzielić dokument. - Usuwaj nagłówki i stopki. W instrukcjach PDF na każdej stronie powtarza się nazwa firmy, numer wersji i „Strona 3 z 40”. Zbierz wszystkie linie dokumentu, znajdź te, które powtarzają się na więcej niż połowie stron, i usuń je.
Uwaga: Nie usuwaj tabel dla urody. W instrukcjach, cennikach i charakterystykach to właśnie tabele zawierają odpowiedzi na konkretne pytania: „jaki limit”, „ile kosztuje”, „jaki port”. Zapisuj je wiersz po wierszu, rozdzielając komórki tabulatorem lub pionową kreską.
Wskazówka: Po ekstrakcji weź 20 losowych dokumentów i przeczytaj je w całości. Nie prześlizgnij się, ale przeczytaj. Jeden taki przegląd znajduje więcej problemów systemowych niż jakikolwiek automatyczny filtr: na przykład zobaczysz, że na wszystkich stronach bloga na końcu tekstu przykleił się blok „Czytaj także” z trzema nagłówkami.
Weryfikacja: W folderze clean leżą pliki JSONL. Liczba rekordów nie jest mniejsza niż 80 procent liczby surowych stron. W losowych 10 rekordach tekst zaczyna się od nagłówka lub pierwszego akapitu artykułu, a nie od punktów menu, i kończy się ostatnim merytorycznym akapitem, a nie podpisem „Wszelkie prawa zastrzeżone”.
Możliwe problemy
- Wyodrębnia się za mało tekstu. Strona z niestandardowym układem. Dodaj
content_selectori ścieżkę zapasową przezBeautifulSoup. - W tekście zostają przyciski i punkty menu. Włącz
favor_precision, a dla upartych przypadków dodaj listę linii do zatrzymania: krótkie linie typu „Udostępnij”, „Czytaj dalej”, „Do góry” usuwaj, jeśli stoją w osobnej linii. - PDF zwraca tekst od tyłu lub z rozerwanymi słowami. Spróbuj
pdfplumberzamiastpypdf, lepiej radzi sobie z kolumnami.
Krok 5: Filtrujemy śmieci: deduplikacja, szablony, jakość, język
Cel etapu: odsiać duplikaty, zaślepki, bloki szablonowe, teksty w obcym języku i zbyt krótkie lub uszkodzone dokumenty, zostawiając tylko to, co niesie wiedzę.
Nawet po starannej ekstrakcji w korpusie zostaje od 15 do 40 procent śmieci. To normalne. Nienormalne jest przepuścić je do indeksu.
Instrukcja
- Utwórz plik
filter.py, który czytaclean/*.jsonl, stosuje filtry po kolei, zapisuje przechodzące dokumenty docorpus/filtered.jsonl, a odsiane docorpus/rejected.jsonlz podaniem przyczyny. - Filtr 1: minimalna długość. Dokumenty krótsze niż 300 znaków to prawie zawsze zaślepki, zapowiedzi lub błędy ekstrakcji. Odsiewaj z przyczyną
too_short. Dla kart produktów próg można obniżyć do 150. - Filtr 2: frazy zaślepek. Utwórz listę fraz, po których widać, że strona jest pusta: „strona nie znaleziona”, „produkt niedostępny”, „dostęp ograniczony”, „włącz JavaScript”, „trwają prace techniczne”. Jeśli taka fraza występuje w pierwszych 300 znakach, a cały tekst jest krótszy niż 1500, odsiewaj z przyczyną
placeholder. - Filtr 3: język. Użyj
langdetect.detectna pierwszych 1000 znakach. Jeśli język nie zgadza się z podanym w źródle, odsiewaj z przyczynąwrong_lang. Pamiętaj, że na krótkich tekstach detektor się myli, więc stosuj go po filtrze długości. - Filtr 4: dokładne duplikaty. Znormalizuj tekst: małe litery, zwiń spacje, usuń znaki interpunkcyjne. Oblicz
sha1. Jeśli hash już się pojawił, odsiewaj z przyczynąexact_dupi zapisuj link do oryginału. Typowe źródła dokładnych duplikatów: ta sama strona pohttpihttps, zwwwi bez, z parametrem?utm_sourcei bez, a także strony do druku. - Filtr 5: prawie duplikaty. Tu potrzebny jest MinHash z biblioteki
datasketch. Podziel znormalizowany tekst na shingle po 5 słów, zbudujMinHashze 128 permutacjami, włóż doMinHashLSHz progiem 0.85. Dokument, który ma już podobnego sąsiada w indeksie, odsiewaj z przyczynąnear_dup. Tak znikają wersje jednego artykułu z różnymi datami, strony produktów różniące się tylko kolorem i przedrukowane newsy.
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- Filtr 6: linie szablonowe. Zbierz wszystkie linie wszystkich dokumentów jednego źródła i policz, w jakim procencie dokumentów występuje każda. Linie występujące w więcej niż 30 procentach dokumentów i krótsze niż 200 znaków to szablon: disclaimery, podpisy, wezwania do subskrypcji. Usuń je ze wszystkich dokumentów. To nie odsiew dokumentu, ale czyszczenie w jego wnętrzu.
- Filtr 7: jakość tekstu. Policz proste metryki: udział liter wśród wszystkich znaków powinien być wyższy niż 0.6; średnia długość słowa od 3 do 12; udział linii kończących się kropką wyższy niż 0.3 dla artykułów. Dokumenty poza tymi granicami to z reguły tabele kodów, dumpy lub uszkodzone ekstrakcje. Odsiewaj z przyczyną
low_quality, ale koniecznie przejrzyj odsiane oczami: dla dokumentacji technicznej progi trzeba złagodzić. - Filtr 8: ucięte strony. Porównaj
html_lenz surowego rekordu z medianą dla źródła. Jeśli HTML jest krótszy niż 30 procent mediany, a tekst urywa się w środku zdania bez kropki, to ucięta odpowiedź. Przyczynatruncated. Takie adresy zapisz wrecollect.txti zbierz ponownie przez proxy w Kroku 3. - Uruchom filtr i przeanalizuj raport. Skrypt powinien wyświetlić tabelę: ile dokumentów na wejściu, ile odsiano z każdej przyczyny, ile zostało.
Uwaga: Nigdy nie usuwaj plików z clean i raw w trakcie filtrowania. Filtr tylko pisze nowe pliki. Jeśli próg MinHash okazał się zbyt agresywny i straciłeś 40 procent przydatnych dokumentów, po prostu zmienisz liczbę i uruchomisz skrypt ponownie w dwie minuty.
Wskazówka: Próg 0.85 dla prawie duplikatów jest dobry dla artykułów i pomocy. Dla kart produktów jednej marki, różniących się tylko rozmiarem lub pojemnością, złoży je w jeden. Zdecyduj z góry, czy twój system RAG potrzebuje wszystkich wariantów, i albo podnieś próg do 0.95, albo połącz warianty w jeden dokument z tabelą różnic już na etapie ekstrakcji.
Wskazówka: Odsiane dokumenty to nie odpady, ale materiał do debugowania. Raz w tygodniu otwieraj rejected.jsonl, filtruj po przyczynie i patrz na 10 losowych rekordów. Jeśli wśród low_quality regularnie trafiają się przydatne tabele cenników, progi trzeba poprawić.
Weryfikacja: Raport filtra pokazuje rozsądny obraz: sumaryczny odsiew od 10 do 40 procent, z czego duplikaty stanowią zauważalny udział, a przyczyna truncated daje nie więcej niż 2-3 procent. W pliku filtered.jsonl nie ma dwóch dokumentów z identycznym znormalizowanym tekstem, a losowe 10 rekordów wygląda jak zakończone artykuły lub sekcje dokumentacji.
Możliwe problemy
- Odsiew większy niż 60 procent. Najprawdopodobniej zbyt surowe progi jakości lub błąd normalizacji, przez który wszystkie teksty stały się podobne. Wyświetl 20 losowych odsianych i znajdź przyczynę systemową.
- MinHash działa bardzo długo. Na korpusie większym niż 100 tysięcy dokumentów zmniejsz
num_permdo 64 lub licz osobno dla każdego źródła. - Detektor języka oznacza rosyjskie teksty jako bułgarskie lub macedońskie. Tak bywa na krótkich fragmentach z dużą liczbą nazw własnych. Sprawdzaj język na pierwszych 2000 znakach i przyjmuj każdy z grupy bliskich języków jako zgodność.
Krok 6: Oznaczamy metadane i składamy końcowy korpus
Cel etapu: otrzymać jeden plik corpus/corpus_v1.jsonl, w którym każdy dokument ma stabilny identyfikator, pełny zestaw metadanych i jest gotowy do przekazania do pipeline'u indeksowania.
Metadane to to, co odróżnia korpus od kupy tekstu. Pozwalają aktualizować poszczególne źródła, wyjaśniać użytkownikowi pochodzenie odpowiedzi, filtrować po dacie i sekcji oraz, co najważniejsze, nie wykonywać całej pracy od nowa po miesiącu.
Instrukcja
- Zdefiniuj schemat dokumentu. Ustal go w pliku
schema.mdi nie zmieniaj bez wersji korpusu. Zalecane minimum:
doc_id: stabilny identyfikator, na przykładsha1zfinal_url, aby przy ponownym zbieraniu dokument dostał ten sam id;source: nazwa źródła zsources.json;urlifinal_url;title;section: sekcja strony obliczona z pierwszego segmentu ścieżki po prefiksie, na przykładhelp/proxies;lang;published_at: data publikacji, jeśli wyekstrahowana;fetched_at: data zebrania;geo: region proxy, z którego zebrano;text;text_len,text_sha1;corpus_version: na przykładv1.
- Oblicz sekcję. Sparsuj
final_urlprzezurllib.parse.urlparse, weź ścieżkę, usuń prefiks źródła, zostaw jeden-dwa segmenty. Sekcja stanie się później filtrem w systemie RAG: użytkownik pyta o płatności, wyszukiwanie idzie najpierw po sekcjibilling. - Znormalizuj daty. Wszystkie daty sprowadź do ISO 8601 w UTC. Jeśli data publikacji nie została znaleziona, zostaw pole puste, a nie wstawiaj daty zebrania: to różne rzeczy i mylenie ich jest niebezpieczne przy filtrowaniu przestarzałych materiałów.
- Dodaj nagłówek do tekstu. Jeśli
textnie zaczyna się odtitle, wstaw nagłówek pierwszą linią. Nagłówek niesie słowa kluczowe, które są ważne dla wyszukiwania. - Posortuj i zapisz. Posortuj dokumenty po
sourceifinal_url, zapisz docorpus/corpus_v1.jsonl. Obok połóżcorpus/manifest_v1.jsonz liczbą dokumentów według źródeł, datą złożenia, wersją schematu i parametrami filtrów. - Zrób archiwum. Zarchiwizuj
corpus,sources.json,schema.mdi folderlogs. To archiwum to odtwarzalna wersja twojego korpusu.
Wskazówka: Trzymaj dane osobowe poza korpusem w ogóle. Jeśli w tekstach pomocy pojawiają się przykłady typu „Jan Kowalski, +48 500...”, zamień je na placeholdery już na etapie zbierania korpusu. System RAG nie powinien umieć podać czyjegoś telefonu, nawet jeśli był w otwartym dostępie.
Weryfikacja: Plik corpus_v1.jsonl otwiera się, każda linia to poprawny JSON z polami ze schematu, wszystkie dokumenty mają unikalny doc_id, wszystkie mają wypełnione source, lang, fetched_at, text. Plik manifest_v1.json zawiera podsumowanie zgodne z liczbą linii.
Możliwe problemy
- Różne adresy prowadzą do jednego dokumentu i dają różne doc_id. Licz id z
final_urlpo przekierowaniach, z usunięciem parametrów zapytania i końcowego ukośnika. - Daty są wyodrębniane w różnych formatach. Użyj
dateutil.parser.parsez parametremdayfirst=Truedla źródeł polskojęzycznych.
Weryfikacja wyniku: lista kontrolna i testowanie korpusu
Korpus zebrany. Zanim zaniesiesz go do indeksowania, sprawdźmy go jako produkt, a nie jako plik.
Lista kontrolna
- Jest
sources.jsonz granicami każdego źródła i podanymi limitami. - Wszystkie żądania szły przez mobilne proxy, w dzienniku każde żądanie ma
proxy_ip. - Udział błędów zbierania według dziennika nie przekracza 5 procent, odpowiedzi 429 mniej niż 1 procent.
- Z surowych stron wyekstrahowano nie mniej niż 80 procent dokumentów.
- Odsiew na filtrowaniu od 10 do 40 procent, wszystkie przyczyny odsiewu nazwane.
- W korpusie nie ma dokładnych duplikatów według znormalizowanego tekstu.
- Każdy dokument ma wypełnione obowiązkowe metadane.
- Jest archiwum z surowymi danymi, korpusem, dziennikami i ustawieniami.
Jak testować
- Test na pytaniach z Kroku 1. Weź swoje 20-30 pytań. Dla każdego prostym wyszukiwaniem podciągu lub przez
grepznajdź dokument w korpusie, który zawiera odpowiedź. Cel: nie mniej niż 90 procent pytań ma pokrycie. Jeśli pytanie nie jest pokryte, znajdź stronę z odpowiedzią w przeglądarce i ustal, dlaczego nie trafiła: nie było jej w mapie strony, odsiewy filtry, ucięła się treść. - Test na śmieci. Znajdź w korpusie ciągi „zapisz się”, „koszyk”, „cookie”, „wszelkie prawa zastrzeżone”, „czytaj także”. Każde wystąpienie to podejrzenie. Dopuszczalne są jednostki, jeśli są częścią merytorycznego tekstu; dziesiątki wystąpień oznaczają, że filtr szablonowy trzeba dopracować.
- Test na urwania. Policz dokumenty, których tekst kończy się nie kropką, nie wykrzyknikiem czy znakiem zapytania i nie nawiasem zamykającym. Ich powinno być mniej niż 5 procent. Resztę obejrzyj oczami.
- Test na rozkład. Zbuduj histogram długości dokumentów. Zdrowy korpus pomocy lub bloga ma szczyt w okolicach 2-8 tysięcy znaków i długi ogon. Ostry szczyt przy minimalnym progu mówi o zaślepkach, które przeszły.
- Test na geografię. Jeśli treść zależy od regionu, otwórz 5 stron z cenami lub dostępnością i porównaj z tym, co widzi człowiek z wybranego miasta. Rozbieżności oznaczają, że proxy jest z innego regionu lub strona określa region nie po IP, ale po cookies.
Wskaźniki udanego wykonania
Korpus jest gotowy, jeśli pokrycie pytań testowych jest wyższe niż 90 procent, udział dokumentów z oznakami śmieci jest niższy niż 3 procent, a manifest pozwala w pełni odtworzyć złożenie. Dopiero wtedy korpus jest przekazywany do pipeline'u indeksowania systemu RAG.
Typowe błędy i rozwiązania przy zbieraniu korpusu dla RAG
Problem: w odpowiedziach asystenta pojawiają się punkty menu i wezwania do subskrypcji. Przyczyna: ekstrakcja tekstu działała w trybie zupełności, a nie precyzji, filtr szablonowy nie został uruchomiony. Rozwiązanie: włącz favor_precision, zaimplementuj usuwanie linii powtarzających się w więcej niż 30 procentach dokumentów źródła, złóż ponownie clean z raw bez ponownego pobierania.
Problem: asystent odpowiada na podstawie przestarzałej wersji instrukcji. Przyczyna: w korpusie żyje i stara, i nowa wersja artykułu, prawie duplikaty nie zostały odsiane lub próg jest zbyt wysoki. Rozwiązanie: obniż próg MinHash do 0.8 dla źródeł z wersjonowaniem, przy konflikcie zostaw dokument z późniejszą published_at.
Problem: część stron zebrana pusta, status 200. Przyczyna: treść budowana JavaScriptem po stronie przeglądarki. Rozwiązanie: oznacz źródło needs_js i użyj renderowania przez Playwright z bloku zaawansowanego albo znajdź u strony API lub RSS, gdzie treść jest podana gotowa.
Problem: zbieranie zatrzymuje się na błędach 429 i 503. Przyczyna: zbyt wysoka częstotliwość żądań, rotacja IP użyta zamiast zmniejszenia obciążenia. Rozwiązanie: zmniejsz częstotliwość do 6-8 żądań na minutę, zwiększ losowy rozrzut pauz, ustaw pauzę 5-10 minut przy pierwszym 429. Pamiętaj, że limit obciążenia to szacunek dla źródła, a nie liczba adresów.
Problem: po rotacji strona pokazuje treść innego regionu. Przyczyna: mobilne proxy wydało IP innego miasta albo strona określiła region po cookies poprzedniej sesji. Rozwiązanie: przypisz w panelu proxy właściwy region, resetuj sesję requests po każdej rotacji, aby cookies się nie przenosiły.
Problem: korpus zebrany, ale pokrycie pytań 60 procent. Przyczyna: granice źródeł zbyt wąskie, przydatne strony zostały odsiane po prefiksach. Rozwiązanie: weź niepokryte pytania, znajdź odpowiedzi w przeglądarce, spójrz na ich adresy i rozszerz include_prefixes.
Problem: deduplikacja zjadła karty produktów różniące się charakterystykami. Przyczyna: próg prawie duplikatów zbyt niski dla jednorodnych tekstów. Rozwiązanie: dla źródeł katalogowych podnieś próg do 0.95 lub połącz warianty jednego produktu w jeden dokument na etapie ekstrakcji.
Problem: teksty PDF idą ciągłą linią bez akapitów. Przyczyna: pypdf gubi formatowanie. Rozwiązanie: przejdź na pdfplumber lub pymupdf, odtwarzaj akapity po podwójnych przejściach do nowej linii i wcięciach.
Problem: do korpusu trafiły dane osobowe. Przyczyna: nie było etapu anonimizacji. Rozwiązanie: dodaj przed zapisem do korpusu wyszukiwanie telefonów, emaili i imion przez proste wzorce i zamianę na placeholdery; sporne dokumenty kieruj do ręcznej weryfikacji.
Dodatkowe możliwości dla zaawansowanych
Jeśli podstawowy pipeline działa, oto kierunki rozwoju.
Renderowanie stron z JavaScript przez proxy
Zainstaluj pip install playwright i playwright install chromium. Uruchamiaj przeglądarkę z parametrem proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS}. Czekaj na selektor głównej treści przez page.wait_for_selector, a nie na stałe sekundy. Pobieraj page.content() i zapisuj w tym samym formacie raw, aby dalsze kroki się nie zmieniały. Renderowanie jest 5-10 razy wolniejsze od zwykłych żądań, więc stosuj je tylko do źródeł z flagą needs_js i zmniejsz częstotliwość do 3-5 stron na minutę.
Inkrementalna aktualizacja korpusu
Przechowuj w manifeście text_sha1 każdego dokumentu. Przy następnym zbieraniu pobieraj strony, ale ekstrahuj i filtruj tylko te, u których zmienił się hash HTML lub minęło więcej niż 30 dni od zebrania. Używaj nagłówków If-Modified-Since i ETag: wiele stron zwróci 304 bez ciała, i zaoszczędzisz ruch proxy. Każda aktualizacja otrzymuje nową wersję korpusu: v2, v3, a stare archiwa nie są usuwane.
Korpus wieloregionalny
Jeśli firma ma oddziały, a treść źródeł zależy od miasta, załóż kilka mobilnych proxy z różną geografią. Zbieraj tę samą stronę z każdego regionu, przechowuj geo w metadanych i deduplikuj tylko w obrębie regionu. System RAG będzie potem mógł odpowiadać „w Krakowie dostawa 2 dni, w Gdańsku 4”, opierając się na rzeczywistych regionalnych wersjach stron.
Oznaczanie jakości zamiast sztywnych progów
Zamiast odsiewać po progach, licz dla każdego dokumentu ocenę jakości od 0 do 1 z tych samych metryk: długość, udział liter, udział zakończonych zdań, powtarzalność linii. Zapisuj ocenę w metadanych. Wtedy pipeline indeksowania sam będzie mógł decydować, co brać, a wyszukiwanie rankingować wiarygodne dokumenty wyżej.
Deduplikacja semantyczna
MinHash łapie duplikaty leksykalne. Parafrazy jednej instrukcji innymi słowami przepuści. Do ich wyłapania licz embeddingi dokumentów i szukaj par o podobieństwie cosinusowym wyższym niż 0.95. To już granica z etapem indeksowania, więc tu tylko wzmianka: zdecyduj, gdzie postawić granicę, i nie wykonuj jednej pracy dwa razy.
Monitoring zbierania
Wyciągaj z dziennika metryki: żądań na minutę, udział kodów 200, średnie opóźnienie, liczba rotacji. Prosty dashboard na matplotlib lub tabela w terminalu co 10 minut pokaże degradację wcześniej, niż rano odkryjesz 500 pustych stron.
FAQ: częste pytania o zbieranie korpusu
Czy trzeba używać mobilnego proxy do zbierania korpusu? Dla własnych dokumentów i małych źródeł nie jest to konieczne. Proxy staje się potrzebne, gdy źródeł jest wiele, zbieranie trwa godzinami, ważna jest regionalna wersja treści lub nie chcesz tworzyć zauważalnego obciążenia strony z jednego adresu.
Jak często zmieniać IP przy zbieraniu? Orientacyjnie: co 30-60 żądań lub przy przejściu do innego źródła. Częściej nie trzeba: sens rotacji to rozłożenie obciążenia i stabilność sesji, a nie sama częstotliwość. Częsta rotacja bez zmniejszenia ogólnego tempa nie zmniejsza obciążenia.
Ile dokumentów trzeba do działającego systemu RAG? Dla asystenta jednego produktu często wystarczy 200-500 dobrych dokumentów. Dla szerokiej niszy kilka tysięcy. Jakość ważniejsza od ilości: 500 czystych artykułów da lepsze odpowiedzi niż 20 tysięcy ze śmieciami.
Czy można zbierać z mediów społecznościowych i marketplace'ów? Tylko otwarte strony w granicach zasad platformy i robots.txt, bez danych osobowych. Wiele platform ma oficjalne API do pobierania treści, zacznij od nich.
Co robić z obrazkami i wideo? W ramach tekstowego korpusu zapisuj tylko podpisy, teksty alt i transkrypcje, jeśli są na stronie. Same pliki nie trafiają do korpusu.
Dlaczego nie można po prostu pobrać całej strony programem do pobierania? Można, ale otrzymasz dziesiątki tysięcy plików bez metadanych, z duplikatami, stronami serwisowymi i bez dziennika. Potem trzeba będzie wykonać wszystkie kroki tego przewodnika w odwrotnej kolejności, tylko trudniej.
Jak poznać, że filtry nie usunęły potrzebnego? Patrz na rejected.jsonl według każdej przyczyny, próbkę 10-20 rekordów. I sprawdzaj pokrycie pytań testowych: jeśli odpowiedzi zniknęły, szukaj ich w odsianych.
Czy trzeba dzielić dokumenty na chunki na tym etapie? Nie. Podział na fragmenty to część indeksowania i zależy od modelu embeddingów i rozmiaru kontekstu. Zadaniem korpusu jest dać całe dokumenty z metadanymi i oznaczeniem nagłówków, po których chunker będzie mógł ciąć sensownie.
Jak aktualizować korpus, aby nie zbierać wszystkiego od nowa? Przechowuj hashe, używaj żądań warunkowych If-Modified-Since, wersjonuj korpus. Więcej w bloku zaawansowanym.
Co zrobić, jeśli strona zabrania automatycznego zbierania w robots.txt? Uszanować zakaz. Napisz do właściciela, często da eksport, API lub zgodę. Korpus zebrany wbrew zasadom źródła tworzy ryzyko dla całego projektu.
Zakończenie: co zostało zrobione i dokąd iść dalej
Przeszedłeś całą drogę od pomysłu do gotowego korpusu. Określiłeś granice i stworzyłeś mapę źródeł z limitami i geografią. Podłączyłeś mobilne proxy i upewniłeś się, że rotacja działa. Napisałeś uprzejmy kolektor, który przestrzega robots.txt, rozkłada obciążenie i prowadzi szczegółowy dziennik. Wyodrębniłeś czysty tekst z HTML, PDF i DOCX. Odsiałeś duplikaty, zaślepki, szablony i uszkodzone strony z nazwanymi przyczynami. Oznaczyłeś metadane i złożyłeś wersjonowany korpus z manifestem. Sprawdziłeś go na rzeczywistych pytaniach.
Główny wynik to nie plik na dysku, ale odtwarzalny proces. Za miesiąc uruchomisz go ponownie i otrzymasz zaktualizowany korpus w kilka godzin, a nie w tydzień. A gdy system RAG zacznie odpowiadać dziwnie, będziesz dokładnie wiedział, gdzie szukać przyczyny: w dzienniku zbierania, w raporcie filtra czy w manifeście.
Co dalej. Przekaż corpus_v1.jsonl do pipeline'u indeksowania: podział na fragmenty, embeddingi, baza wektorowa. O tym w pokrewnych artykułach na blogu. Skonfiguruj regularne uruchamianie kolektora według harmonogramu z inkrementalną aktualizacją. Rozszerzaj mapę źródeł w miarę wzrostu liczby niepokrytych pytań. Jeśli firma jest regionalna, dodaj proxy potrzebnych miast i zbierz regionalne wersje treści.
Dokąd się rozwijać. Opanuj renderowanie w przeglądarce dla trudnych stron, ocenę jakości dokumentów zamiast sztywnych progów, deduplikację semantyczną i monitoring zbierania. Każdy z tych kroków podnosi jakość odpowiedzi mocniej niż zmiana modelu. Czyste dane to najtańsze ulepszenie systemu RAG, jakie masz. Udanych zbiorów.