Bewertungen sammeln von Karten, Marktplätzen und Aggregatoren: Schritt-für-Schritt-Anleitung für Anfänger
Inhalt des Artikels
- Einleitung: was sie am ende haben werden
- Vorbereitung: werkzeuge und zugänge
- Grundbegriffe: wie bewertungen aufgebaut sind und warum man sie anders sammelt als kataloge
- Schritt 1: ziel definieren und quellenliste erstellen
- Schritt 2: die bewertungstabelle entwerfen
- Schritt 3: offizielle wege nutzen – konten und apis
- Schritt 4: bewertungen von karten sammeln – yandex maps, 2gis, google maps
- Schritt 5: bewertungen von marktplätzen sammeln – wildberries, ozon, yandex market
- Schritt 6: bewertungen von aggregatoren sammeln – otzovik, irecommend, flamp, zoon
- Schritt 7: mobile proxys anbinden und rotation einrichten
- Schritt 8: speichern, bereinigen und deduplizieren
- Ergebnisprüfung: checkliste und test
- Typische fehler und lösungen
- Zusätzliche möglichkeiten für fortgeschrittene
- Faq: häufige fragen zum sammeln von bewertungen
- Fazit
Einleitung: Was Sie am Ende haben werden
Bewertungen sind die ehrlichste Informationsquelle über ein Produkt, einen Shop oder eine Einrichtung. Menschen erzählen darin selbst, was ihnen gefallen hat, was kaputtging, warum sie nicht wiederkommen und was sie Freunden empfehlen würden. Das Problem: Bewertungen sind über Dutzende Plattformen verstreut – Karten, Marktplätze, Aggregatoren, Branchenverzeichnisse. Sie wochenlang manuell zu lesen ist unrealistisch. Deshalb braucht man eine systematische Sammlung.
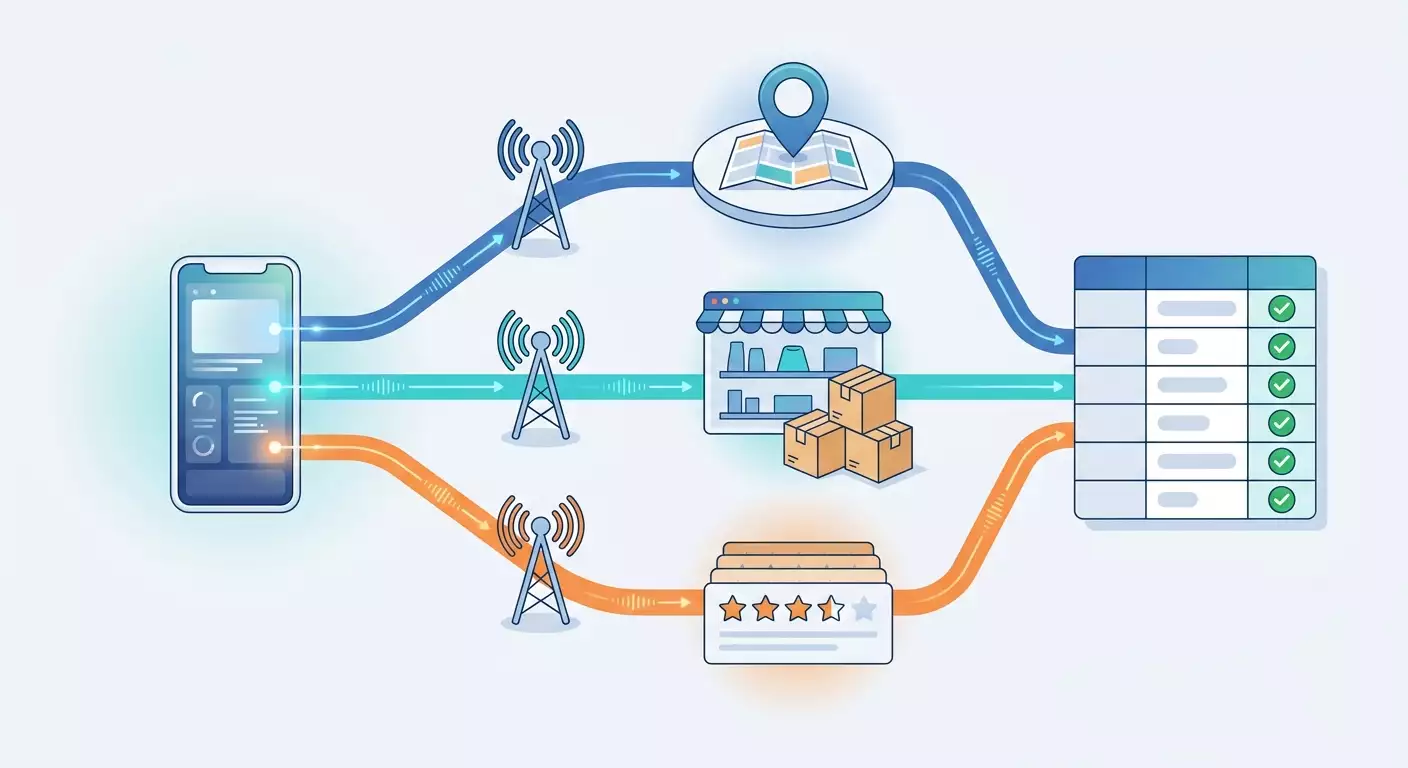
In dieser Anleitung schauen wir uns an, wie man Bewertungen von drei Arten von Plattformen sammelt: Kartendienste (Yandex Maps, 2GIS, Google Maps), Marktplätze (Wildberries, Ozon, Yandex Market) und Aggregatoren (Otzovik, iRecommend, Flamp, Zoon). Sie durchlaufen den gesamten Weg: von der Aufgabenstellung und dem Tabellendesign bis zum funktionierenden Skript, der Anbindung mobiler Proxys und der Datenbereinigung.
Was Sie als Ergebnis bekommen:
- Ein Verständnis dafür, wo und in welcher Form Bewertungen auf jeder Art von Plattform liegen.
- Eine fertige Struktur der Bewertungstabelle, die Sie in Excel, Google Tabellen oder eine Datenbank laden können.
- Einen funktionierenden Bewertungs-Parser in Python, der über mobile Proxys läuft und die Plattformen nicht überlastet.
- Kenntnis der offiziellen Exportwege: Nutzerkonten, Partner-APIs, Exporte.
- Eine Checkliste zur Qualitätsprüfung der gesammelten Daten und eine Liste typischer Fehler.
Für wen dieser Leitfaden ist. Er richtet sich an Marketer, Geschäftsinhaber, Affiliate-Marketer und angehende Entwickler. Wenn Sie noch nie Code geschrieben haben – keine Angst. Ein Teil der Szenarien läuft ganz ohne Programmierung, und für die Skripte geben wir fertige Fragmente, die Sie nur kopieren und mit Ihren Werten versehen müssen. Für diejenigen, die bereits programmieren können, gibt es am Ende einen separaten Block mit fortgeschrittenen Techniken.
Was Sie vorher wissen sollten. Es reicht, wenn Sie einen Browser bedienen, Programme installieren und mit Tabellen arbeiten können. Ein Grundverständnis davon, was ein Proxy ist, hilft, aber wir erklären die Schlüsselbegriffe im Verlauf.
Wichtige Grenze dieses Materials. Hier sprechen wir nur über Bewertungen als eigenen Datentyp: Text, Bewertung, Datum, Autor, Antwort des Unternehmens. Wir behandeln nicht das Parsen von Produktkatalogen, Preisen und Beständen – das ist ein eigenes Thema mit eigenen Besonderheiten. Wenn Sie Preise brauchen, passt dieser Leitfaden nicht, aber wenn Sie Kundenfeedback brauchen – sind Sie hier richtig.
Wie viel Zeit Sie brauchen. Für die Vorbereitung der Umgebung etwa 30-40 Minuten. Für das Design der Struktur und die erste Sammlung von einer Plattform etwa eine Stunde. Ein vollständiger Durchlauf über alle drei Plattformtypen mit Proxy-Einrichtung und Datenbereinigung dauert 3-4 Stunden. Danach dauert das Sammeln nur Minuten, weil das Skript wiederverwendet werden kann.
Vorbereitung: Werkzeuge und Zugänge
Bevor Sie Bewertungen sammeln, müssen Sie den Arbeitsplatz vorbereiten. Unten finden Sie die Liste dessen, was Sie brauchen. Überspringen Sie diesen Abschnitt nicht, auch wenn etwas offensichtlich erscheint: Die Hälfte der Probleme in den nächsten Schritten entsteht genau durch eine unvorbereitete Umgebung.
Systemanforderungen
- Ein Computer mit Windows 10/11, macOS oder Linux. Jeder Laptop der letzten 6-7 Jahre reicht.
- Mindestens 4 GB Arbeitsspeicher. Für das Sammeln von Zehntausenden Bewertungen besser 8 GB.
- Stabile Internetverbindung. Das Sammeln selbst erfordert keine hohe Geschwindigkeit, aber Verbindungsabbrüche führen zu Datenlücken.
- Etwa 2 GB freier Speicherplatz auf der Festplatte für Python, Bibliotheken und Ergebnisse.
Was Sie installieren müssen
- Python 3.11 oder neuer. Laden Sie den Installer von der offiziellen Python-Website herunter. Setzen Sie bei der Installation unter Windows unbedingt das Häkchen bei „Add Python to PATH“ auf dem ersten Bildschirm des Installers. Ohne das funktioniert der Befehl python im Terminal nicht.
- Code-Editor. VS Code eignet sich – kostenlos und verständlich. Öffnen Sie ihn nach der Installation einmal, um sicherzustellen, dass er startet.
- Python-Bibliotheken. Öffnen Sie das Terminal (unter Windows – PowerShell, unter macOS – Terminal) und führen Sie den Befehl aus:
pip install requests pandas openpyxl. Warten Sie auf die Meldung Successfully installed. Das dauert 1-2 Minuten. - Browser Chrome oder Yandex Browser. Wird benötigt, um Plattformen mit den Entwicklertools zu untersuchen. Sie sind integriert, es muss nichts extra installiert werden.
- Tabelleneditor. Excel, LibreOffice Calc oder Google Tabellen – zum Ansehen der Ergebnisse.
Welche Zugänge Sie brauchen
- Zugang zu mobilen Proxys. Registrieren Sie sich bei mobileproxy.space, wählen Sie einen Tarif mit dem gewünschten Geo (für russische Plattformen – russische Anbieter) und erhalten Sie die Verbindungsdaten: Host, Port, Login, Passwort. Finden Sie außerdem im Nutzerkonto den Link zum IP-Wechsel – er wird beim Schritt mit der Rotation benötigt.
- Zugang zu den Nutzerkonten der Plattformen, wenn Sie Bewertungen über Ihr eigenes Unternehmen sammeln. Das sind Yandex Business, das Verkäuferkonto von Wildberries, Ozon Seller, Yandex Market für Verkäufer, Google Business Profile. Offizielle Exporte von dort sind die sauberste Quelle.
- Projektordner. Erstellen Sie auf der Festplatte einen Ordner, zum Beispiel reviews_project, und darin zwei Unterordner: raw für Rohdaten und clean für aufbereitete Daten. Das ist Ihre Absicherung: Rohdaten werden niemals überschrieben.
Tipp: Legen Sie im Projektordner sofort eine Textdatei sources.txt an und notieren Sie dort jede Adresse, von der Sie Bewertungen sammeln, zusammen mit dem Datum. In einem Monat werden Sie sich nicht mehr erinnern, woher die eine oder andere Tabelle stammt, und ein solches Journal klärt alle Fragen.
Backups
Backups betreffen hier nicht das System, sondern die Daten. Machen Sie es zur Regel: Jeder Parser-Lauf schreibt das Ergebnis in eine neue Datei mit Datum im Namen, zum Beispiel reviews_ozon_2026-03-14.csv. Löschen Sie alte Dateien mindestens einen Monat lang nicht. Wenn die neue Sammlung wegen Änderungen auf der Plattform fehlerhaft ist, bleibt Ihnen eine funktionierende Version.
Prüfung: Geben Sie im Terminal python --version ein – es sollte Version 3.11 oder höher erscheinen. Geben Sie dann python -c 'import requests, pandas; print(1)' ein – es sollte die Zahl 1 ohne Fehler erscheinen. Wenn beide Befehle funktioniert haben, ist die Umgebung bereit.
Grundbegriffe: Wie Bewertungen aufgebaut sind und warum man sie anders sammelt als Kataloge
Bevor Sie etwas starten, ist es wichtig zu verstehen, mit welchem Datentyp Sie arbeiten. Eine Bewertung ist nicht nur Text. Sie ist ein strukturierter Eintrag mit mehreren Feldern und hat Besonderheiten, die eine Produktkarte nicht hat.
Schlüsselbegriffe einfach erklärt
- Bewertung (Review) – ein von einem Nutzer hinterlassener Eintrag über ein Objekt: Produkt, Shop, Einrichtung. Enthält normalerweise eine Bewertung, Text, Datum, Name des Autors und manchmal Fotos.
- Bewertungsobjekt – das, worüber die Bewertung ist: Produktkarte auf einem Marktplatz, Organisation auf einer Karte, Unternehmen auf einem Aggregator. Jedes Objekt hat eine eindeutige Kennung auf der Plattform.
- Antwort des Unternehmens – die Erwiderung eines Vertreters des Geschäfts unter der Bewertung. Für die Analyse der Support-Qualität ist das ein separates Feld.
- Paginierung – die Aufteilung der Bewertungen in Seiten oder Portionen. Die Plattform liefert zum Beispiel 20 Bewertungen auf einmal, und man muss die nächsten Portionen anfordern.
- Bewertungs-Parser – ein Programm, das automatisch die benötigten Objekte durchläuft, Bewertungen extrahiert und sie in eine Tabelle schreibt. Kann ein einfaches Skript oder ein fertiger Dienst sein.
- Deduplizierung – das Entfernen von Duplikaten. Dieselbe Bewertung kann wegen Paginierung oder wiederholter Läufe zweimal in die Auswahl gelangen.
- Mobile Proxys – Zwischenserver mit IP-Adressen mobiler Anbieter. Anfragen über sie sehen aus wie der Traffic eines normalen Smartphone-Nutzers. Plattformen sind gegenüber solchem Traffic loyaler, weil hinter einer mobilen IP Hunderte echte Menschen stehen.
- IP-Rotation – der Wechsel der Proxy-Adresse in einem festgelegten Intervall oder auf Anfrage. Hilft, die Last zu verteilen und keinen anomalen Anfragenstrom von einer Adresse zu erzeugen.
Wie sich das Sammeln von Bewertungen vom Sammeln eines Katalogs unterscheidet
Ein Produktkatalog ist relativ statisch: Die Karte existiert, sie hat einen Preis und Eigenschaften. Bewertungen leben anders, und das beeinflusst den gesamten Prozess.
- Bewertungen kommen ständig hinzu. Man muss nur die neuen nachladen können, statt jedes Mal alles neu zu erfassen.
- Bewertungen werden separat nachgeladen. Auf den meisten Plattformen kommt der Bewertungstext nicht in der Seite selbst, sondern über eine separate Anfrage im Hintergrund. Das ist eine gute Nachricht: Solche Anfragen liefern fertiges JSON, HTML muss nicht geparst werden.
- Bewertungen enthalten personenbezogene Daten. Name des Autors, Avatar, manchmal Stadt. Dafür gibt es gesetzliche Anforderungen – dazu unten mehr.
- Bewertungen werden sortiert und gefiltert. Standardmäßig kann die Plattform „hilfreiche“ oder „neue“ anzeigen. Wenn Sie die Sortierung nicht festlegen, sammeln Sie bei verschiedenen Läufen unterschiedliche Datensätze.
- Bewertungen werden bearbeitet und gelöscht. Die Moderation entfernt einen Teil der Einträge, Autoren ändern Bewertungen. Das Sammeldatum wird zu einem wichtigen Feld.
Rechtliche Rahmenbedingungen, die man verstehen muss
Achtung: Bewertungen enthalten Namen und andere Angaben über Personen. Beachten Sie beim Sammeln und Speichern die Anforderungen des Föderalen Gesetzes 152-FZ über personenbezogene Daten: Sammeln Sie nicht mehr als für die Aufgabe nötig, anonymisieren Sie Autoren dort, wo der Name für die Analyse nicht erforderlich ist, geben Sie die Datenbank nicht an Dritte weiter. Lesen Sie außerdem die Nutzungsbedingungen der Plattform und die Datei robots.txt: Manche Dienste beschreiben direkt zulässige Modi des automatischen Zugriffs. Wenn es für Ihre Aufgabe eine offizielle API oder einen Export aus dem Nutzerkonto gibt – beginnen Sie immer damit.
Ein weiteres Prinzip ist die rücksichtsvolle Last. Ihr Bewertungs-Parser sollte sich wie ein aufmerksamer Nutzer verhalten, nicht wie ein Anfragenstrom. Pausen zwischen Anfragen, eine vernünftige Anzahl von Threads und Rotation über mobile Proxys sind kein Trick, sondern die Norm verantwortungsvollen Sammelns. Plattformen blockieren nicht die Tatsache der Automatisierung, sondern anomales Verhalten, das ihre Arbeit stört.
Schritt 1: Ziel definieren und Quellenliste erstellen
Ziel dieser Etappe: eine konkrete, begrenzte Liste von Objekten erhalten, von denen wir Bewertungen sammeln, und verstehen, welche Felder wir brauchen. Ohne diesen Schritt wird der Parser zu einem endlosen Projekt.
Formulieren Sie die Frage, die die Bewertungen beantworten sollen
Eine gute Sammlung beginnt mit einer Frage. Beispiele funktionierender Formulierungen:
- „Warum hat der Wettbewerber X auf Wildberries eine Bewertung von 4,8 und wir 4,4 in derselben Kategorie?“
- „Was wird in den Bewertungen über unsere fünf Cafés auf Yandex Maps in den letzten sechs Monaten am häufigsten kritisiert?“
- „Welche Kundenschmerzen werden in den Bewertungen über Online-Kurse auf Otzovik erwähnt, um sie in Creatives zu nutzen?“
Beachten Sie: In jeder Frage gibt es Plattform, Objekt, Zeitraum und Art der Information. Genau das bestimmt die Einstellungen der Sammlung.
Erstellen Sie die Liste der Objekte
- Öffnen Sie die Plattform im Browser und finden Sie jedes benötigte Objekt manuell: Produktkarte, Organisation auf der Karte, Unternehmensseite auf dem Aggregator.
- Kopieren Sie die vollständige Adresse der Seite aus der Adressleiste.
- Extrahieren Sie aus der Adresse die Kennung des Objekts. Auf Wildberries ist das die Zahl in der Adresse der Karte nach catalog/, auf Ozon – die Zahl nach product/ und dem Bindestrich am Ende, auf Yandex Maps – die lange Zahl nach org/ und dem Namen, in 2GIS – die Zahl nach firm/. Notieren Sie sie separat.
- Tragen Sie alles in die Tabelle sources.csv mit den Spalten ein: Plattform, Objektname, Adresse, Kennung, Kommentar.
- Beschränken Sie sich beim ersten Lauf auf 3-5 Objekte pro Plattform. Skalieren können Sie später.
Entscheiden Sie, welche Felder Sie brauchen
Der minimale Feldsatz für jede Bewertung: Kennung der Bewertung auf der Plattform, Kennung des Objekts, Plattform, Bewertung, Text, Veröffentlichungsdatum, Sammeldatum. Der erweiterte Satz: Name des Autors (oder sein Hash), Vorhandensein von Fotos, Vor- und Nachteile separat (gibt es auf Marktplätzen und Otzovik), Antwort des Unternehmens und deren Datum, Anzahl der Likes oder „hilfreich“-Markierungen, Produktvariante (Größe, Farbe), Status des bestätigten Kaufs.
Tipp: Jagen Sie nicht allen Feldern auf einmal hinterher. Sammeln Sie den minimalen Satz plus 2-3 Felder, die für Ihre Frage wirklich nötig sind. Jedes zusätzliche Feld ist ein zusätzlicher Ort, an dem sich das Markup der Plattform ändern und das Skript brechen kann.
Erwartetes Ergebnis: Datei sources.csv mit 5-15 Zeilen und eine notierte Feldliste. Jede Zeile hat eine ausgefüllte Kennung.
Mögliche Probleme: Es gelingt nicht, in der Adresse die Kennung zu erkennen. Lösung: Öffnen Sie zwei ähnliche Objekte auf derselben Plattform und vergleichen Sie die Adressen – die übereinstimmenden Teile sind das Muster, die abweichenden die Kennung.
Prüfung: Sie können jede Zeile von sources.csv lesen und anhand einer Kennung manuell das benötigte Objekt auf der Plattform öffnen. Wenn Sie dafür raten müssen – gehen Sie zurück und präzisieren Sie die Kennungen.
Schritt 2: Die Bewertungstabelle entwerfen
Ziel dieser Etappe: ein einheitliches Aufzeichnungsformat festlegen, in das Bewertungen von allen Plattformen überführt werden. Das ermöglicht es, sie gemeinsam zu analysieren statt in fünf verschiedenen Tabellen.
Einheitliches Schema
Erstellen Sie im Code-Editor die Datei schema.txt und listen Sie die Spalten in dieser Reihenfolge auf:
- review_id – Kennung der Bewertung auf der Plattform. Wenn die Plattform sie nicht explizit liefert, bilden wir sie selbst aus Objekt, Autor und Datum.
- source – kurzer Code der Plattform: yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon.
- object_id – Kennung des Objekts aus sources.csv.
- object_name – lesbarer Name zur Bequemlichkeit.
- rating – Zahl von 1 bis 5. Wenn die Plattform eine andere Skala verwendet, führen wir sie auf eine Fünf-Punkte-Skala zurück und notieren das im Kommentar.
- text – vollständiger Text der Bewertung in einer Zeile. Zeilenumbrüche ersetzen wir durch Leerzeichen.
- pros und cons – Vor- und Nachteile, wenn die Plattform trennt. Sonst leer.
- author – Name des Autors oder sein anonymisierter Hash.
- published_at – Veröffentlichungsdatum im Format JJJJ-MM-TT.
- company_reply – Text der Antwort des Unternehmens, falls vorhanden.
- likes – Anzahl der Nützlichkeits-Markierungen.
- has_photo – 1 oder 0.
- collected_at – Datum und Uhrzeit der Sammlung.
- url – Adresse der Objektseite.
Warum genau ein einheitliches Format nötig ist
Jede Plattform liefert Daten in ihrer eigenen Form: Mal ist das Datum der String „vor 3 Tagen“, mal eine Millisekundenzahl, mal der Text „14. März“. Wenn Sie nicht alles am Eingang auf eine gemeinsame Form bringen, ertrinken Sie bei der Analyse in Ausnahmen. Die Überführung ins Schema muss sofort beim Schreiben erfolgen, nicht später.
Regeln zur Anonymisierung
Wenn für die Aufgabe keine Autorennamen nötig sind (und in 90% der analytischen Aufgaben sind sie nicht nötig), speichern Sie statt des Namens einen Hash. In Python geht das mit einer Zeile über das Modul hashlib: Man nimmt den Namen des Autors, fügt den Code der Plattform hinzu, und das Ergebnis wird in einen kurzen String umgewandelt. So können Sie Bewertungen desselben Autors voneinander unterscheiden, ohne den Namen selbst zu speichern.
Tipp: Fügen Sie ins Schema die Spalte raw_json ein, in die die ursprüngliche Antwort der Plattform zu einer bestimmten Bewertung geschrieben wird. Sie braucht Platz, erlaubt es aber später, ein Feld zu extrahieren, an das Sie heute nicht gedacht haben, ohne eine erneute Sammlung.
Erwartetes Ergebnis: Datei schema.txt mit den Spalten und eine leere Tabellenvorlage reviews_template.csv mit diesen Überschriften.
Prüfung: Öffnen Sie reviews_template.csv in Excel. Sie sollten eine Kopfzeile sehen, in der genau die Spalten aus schema.txt stehen und keine überflüssige.
Schritt 3: Offizielle Wege nutzen – Konten und APIs
Ziel dieser Etappe: Bewertungen über Ihr eigenes Unternehmen auf dem saubersten Weg exportieren, ganz ohne Parsing. Wenn Sie nur sich selbst analysieren, kann dieser Schritt ausreichen.
Yandex Business (Bewertungen auf Yandex Maps)
- Melden Sie sich bei Yandex Business mit dem Konto des Organisationsinhabers an.
- Wählen Sie im linken Menü den Bereich „Bewertungen“.
- Wählen Sie oben die gewünschte Filiale, wenn es mehrere Organisationen gibt.
- Stellen Sie den Filter nach Zeitraum und Bewertung ein.
- Die Liste der Bewertungen wird mit Text, Datum, Bewertung und Ihren Antworten angezeigt. Es gibt keine direkte Export-Schaltfläche in eine Tabelle, daher nutzen Sie für große Mengen das Kopieren seitenweise oder gehen Sie zu Schritt 4 über.
Wildberries: Bewertungs-API für Verkäufer
Wildberries hat einen offiziellen API-Bereich für die Arbeit mit Bewertungen und Fragen. Er ist für Verkäufer verfügbar und liefert Bewertungen zu Ihren Produkten mit Bewertung, Text, Vor- und Nachteilen, Datum sowie die Möglichkeit, darauf zu antworten.
- Melden Sie sich im Verkäuferkonto WB Partner an.
- Öffnen Sie die Profileinstellungen, Bereich „API-Zugang“.
- Erstellen Sie ein neues Token und markieren Sie die Zugriffskategorie für Bewertungen und Fragen. Benennen Sie es verständlich, zum Beispiel reviews_export.
- Kopieren Sie das Token sofort – es wird nicht erneut angezeigt. Speichern Sie es in der Datei config.txt im Projektordner.
- Rufen Sie die Methoden der Bewertungsliste mit diesem Token im Header Authorization auf. Die Dokumentation beschreibt die Parameter für Paginierung und Filterung nach Datum.
Ozon Seller API und Yandex Market
Ozon bietet Zugang zu Bewertungen über die Seller API für Verkäufer mit einem Abonnement, das die Arbeit mit Bewertungen umfasst. Der Schlüssel wird im Bereich „Einstellungen“, Unterbereich „API-Schlüssel“ erstellt. Yandex Market liefert Bewertungen zu Produkten des Verkäufers über die Partner-API anhand der Business-ID, der Schlüssel wird im Verkäuferkonto im Bereich der Zugangseinstellungen ausgestellt.
Google Business Profile und 2GIS für Unternehmen
Bewertungen über die eigene Organisation auf Google Maps sind im Konto von Google Business Profile und über dessen API nach Bestätigung der Rechte verfügbar. 2GIS bietet Inhabern ein Konto mit Benachrichtigungen über Bewertungen und der Möglichkeit zur Antwort.
Achtung: Tokens und API-Schlüssel sind der Zugang zu Ihrem Geschäftskonto. Fügen Sie sie niemals direkt in den Code ein, bewahren Sie sie in einer separaten Datei auf, die nicht in gemeinsame Ordner und Repositories gelangt. Wenn ein Token versehentlich geleakt wurde – widerrufen Sie es sofort im Konto und erstellen Sie ein neues.
Wenn offizielle Wege nicht ausreichen
Alle genannten Wege liefern Bewertungen nur über Ihre eigenen Objekte. Für die Analyse von Wettbewerbern, Markt oder fremden Produkten sind sie nicht geeignet. In diesem Fall gehen wir zum Sammeln von öffentlichen Seiten über – dem sind die folgenden Schritte gewidmet.
Erwartetes Ergebnis: Wenn Sie mit Ihrem eigenen Unternehmen arbeiten – die erste Tabelle mit Bewertungen aus einer offiziellen Quelle, überführt in das Schema aus Schritt 2.
Prüfung: Die Anzahl der Bewertungen im Export stimmt mit der Zahl überein, die das Konto für denselben Zeitraum anzeigt, mit einer Abweichung von 1-2 Einträgen für Bewertungen, die zum Zeitpunkt des Exports in der Moderation waren.
Schritt 4: Bewertungen von Karten sammeln – Yandex Maps, 2GIS, Google Maps
Ziel dieser Etappe: lernen, die Hintergrundanfrage zu finden, mit der die Karte Bewertungen nachlädt, und sie per Skript zu reproduzieren. Diese Fähigkeit ist universell und nützlich auf allen anderen Plattformen.
Wie man die Anfrage mit Bewertungen über die Entwicklertools findet
- Öffnen Sie in Chrome die Seite der Organisation auf Yandex Maps oder 2GIS.
- Drücken Sie die Taste F12. Rechts oder unten öffnet sich das Entwicklerpanel.
- Wechseln Sie zum Tab Network (Netzwerk). Wenn er leer ist – aktualisieren Sie die Seite mit F5.
- Klicken Sie in der Filterzeile über der Anfragenliste auf Fetch/XHR. Es bleiben nur Hintergrundanfragen für Daten übrig.
- Gehen Sie auf der Seite der Organisation zum Bereich Bewertungen und scrollen Sie die Liste nach unten, um die nächste Portion nachzuladen.
- In der Anfragenliste erscheint eine neue. In ihrem Namen kommt normalerweise das Wort review oder feedback vor. Klicken Sie darauf.
- Öffnen Sie den Tab Preview oder Response. Sie sehen die JSON-Struktur, in der Bewertungen als verschachtelte Liste stehen: Text, Bewertung, Datum, Autor.
- Öffnen Sie den Tab Headers. Kopieren Sie die vollständige Adresse der Anfrage (Request URL) und achten Sie auf die Parameter: Normalerweise gibt es dort die Kennung des Objekts, die Seitennummer oder den Offset, die Portionsgröße und die Sortierung.
- Finden Sie im selben Bereich die Anfrage-Header: User-Agent, Accept, Referer. Sie müssen aus dem Skript übergeben werden.
Tipp: Klicken Sie mit der rechten Maustaste auf die gefundene Anfrage und wählen Sie Copy, dann Copy as cURL. Daraus wird ein Befehl mit allen Headern. Es ist praktisch, ihn als Referenz in eine Textdatei einzufügen: Wenn das Skript plötzlich nicht mehr funktioniert, vergleichen Sie seine Anfrage mit der Referenz.
Besonderheiten jeder Karte
- Yandex Maps. Bewertungen werden in Portionen mit Angabe der Sortierung nachgeladen (nach Neuheit, nach Bewertung, nach Relevanz). Legen Sie unbedingt eine Sortierung fest, sonst weichen die Datensätze bei verschiedenen Läufen voneinander ab. Das Datum kommt maschinenlesbar, die Bewertung als Zahl. Antworten der Organisation liegen in einem separaten verschachtelten Feld.
- 2GIS. Der Dienst hat einen öffentlichen Bewertungsservice, auf den die Website selbst zugreift. Die Anfrage enthält die Kennung der Filiale sowie Parameter für Limit und Offset. Die Antwort enthält Text, Bewertung, Datum, Nutzernamen, offizielle Antwort und Nützlichkeitszähler. Außerdem kommt die Gesamtzahl der Bewertungen – nutzen Sie sie zur Prüfung der Vollständigkeit.
- Google Maps. Die schwierigste der drei Plattformen: Bewertungen kommen in einem gepackten Format innerhalb langer Antworten. Für ein paar Dutzend Objekte ist es einfacher, die Places API mit einem offiziellen Schlüssel zu nutzen – sie liefert einen begrenzten Satz der letzten Bewertungen pro Ort, was oft für die Einschätzung der Tonalität ausreicht. Für die vollständige Sammlung über fremde Objekte ist Browser-Automatisierung erforderlich – das ist ein Thema des fortgeschrittenen Blocks.
Wir schreiben das erste Skript
Erstellen Sie die Datei collect_maps.py und fügen Sie das Grundgerüst ein. Setzen Sie die Anfrageadresse und die Feldnamen aus dem ein, was Sie im Entwicklerpanel gesehen haben – sie unterscheiden sich zwischen Plattformen und können sich mit der Zeit ändern.
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
Schauen wir, was hier passiert. Die Variable PROXY speichert die Daten Ihres mobilen Proxys. Der Header User-Agent stellt die Anfrage als mobilen Browser dar – das passt logisch zur mobilen IP. Die Funktion collect läuft durch die Seiten, bis die Plattform eine leere Liste zurückgibt, und macht nach jeder Seite eine Pause von 2,5 Sekunden. Die Pause ist keine Formalität: Sie macht die Last dem Lesen eines echten Menschen ähnlich.
Start und Schreiben des Ergebnisses
- Fügen Sie am Ende der Datei den Aufruf der Funktion für ein Objekt aus sources.csv und das Schreiben der Zeilen in CSV über das Modul csv mit der Kodierung utf-8-sig hinzu, damit Excel den russischen Text korrekt öffnet.
- Öffnen Sie das Terminal im Projektordner und führen Sie
python collect_maps.pyaus. - Beobachten Sie die Ausgabe. Es ist nützlich, nach jeder Anfrage die Seitennummer und die Anzahl der gesammelten Zeilen auszugeben.
- Öffnen Sie die erhaltene Datei in Excel und sehen Sie sich die ersten 20 Zeilen an.
Erwartetes Ergebnis: eine CSV-Datei mit Bewertungen einer Organisation, bei der die Zeilenzahl ungefähr dem Bewertungszähler auf der Organisationsseite entspricht.
Mögliche Probleme: Die Antwort kommt mit Code 403 oder leer. Lösung: Vergleichen Sie die Header mit dem kopierten cURL-Befehl, insbesondere Referer und Accept. Prüfen Sie, dass der Proxy verbunden ist und auf eine Testanfrage an eine beliebige Website geantwortet hat. Erhöhen Sie die Pause auf 4-5 Sekunden.
Prüfung: Nehmen Sie drei zufällige Bewertungen aus der Datei und finden Sie sie anhand des Textes auf der Seite der Organisation. Alle drei sollten gefunden werden, mit denselben Bewertungen und Daten.
Schritt 5: Bewertungen von Marktplätzen sammeln – Wildberries, Ozon, Yandex Market
Ziel dieser Etappe: den Ansatz aus Schritt 4 an Marktplätze anpassen, bei denen Bewertungen an Produkte gebunden sind und zusätzliche Felder haben: Vor- und Nachteile, Produktvariante, Fotos.
Wildberries
Bei Wildberries sind Bewertungen nicht an die Artikelnummer gebunden, sondern an die zusammenfassende Kennung der Karte, unter der Farben und Größen gruppiert sind. Das ist wichtig: Wenn Sie Bewertungen nach Artikelnummer sammeln, erhalten Sie sie für alle Varianten gleichzeitig, und Sie müssen nach dem Feld der Variante filtern.
- Öffnen Sie die Produktkarte, drücken Sie F12, wechseln Sie zum Tab Network mit dem Filter Fetch/XHR.
- Scrollen Sie zum Bewertungsblock und klicken Sie auf „Alle Bewertungen ansehen“.
- Finden Sie die Anfrage, in deren Namen feedbacks vorkommt. In der Antwort gibt es eine Liste mit Text, Bewertung, Datum, Feldern für Vor- und Nachteile, Namen des Autors, Farbe und Größe, Kennzeichen für das Vorhandensein von Fotos und Antwort des Verkäufers.
- Achten Sie auf die Gesamtzahl der Bewertungen in der Antwort – sie hilft bei der Prüfung der Vollständigkeit.
- Kopieren Sie die Adresse und die Header und setzen Sie sie ins Skript nach dem Muster aus Schritt 4 ein. Eine Paginierung kann hier fehlen – ein Teil der Antworten kommt komplett, manchmal als sehr große Datei. Erhöhen Sie den Timeout auf 60 Sekunden.
Ozon
Ozon schützt Daten aktiv und prüft das Verhalten des Clients. Für Bewertungen nutzt die Website eine interne Anfrage für den Seitenaufbau, in dem die Bewertungen einer der Blöcke sind. Praktische Vorgehensweise:
- Öffnen Sie die Produktseite und gehen Sie dann über den Link aus der Karte zum Bereich Bewertungen.
- Finden Sie im Entwicklerpanel die Anfrage, deren Antwort ein Array mit den Feldern content, score oder rating und author enthält. Sie kann unterschiedlich heißen, suchen Sie nach dem Inhalt über die Suchleiste des Panels (Tastenkombination Ctrl+F im Tab Network).
- Kopieren Sie die Anfrage als cURL. Achten Sie auf Header und Cookies: Ozon reagiert empfindlich auf deren Fehlen.
- Verwenden Sie bei der Reproduktion aus dem Skript eine Session requests.Session, damit Cookies zwischen Anfragen erhalten bleiben, und stellen Sie die erste Anfrage an eine normale Produktseite und erst dann an die Bewertungen. Das ahmt den natürlichen Nutzerpfad nach.
- Halten Sie Pausen von 4-6 Sekunden ein und wechseln Sie die IP über den mobilen Proxy alle 30-50 Anfragen.
Achtung: Wenn die Plattform begonnen hat, eine Browser-Prüfseite oder ein Captcha auszugeben – das ist ein Signal, aufzuhören statt weiterzudrücken. Reduzieren Sie die Frequenz, wechseln Sie die IP über den Rotationslink und warten Sie 10-15 Minuten. Systematischer Druck auf Schutzmechanismen führt zur Sperrung des gesamten Adresspools und widerspricht den Regeln der Plattformen.
Yandex Market
Bewertungen auf Yandex Market gibt es in zwei Arten: über das Produkt (gemeinsam für alle Verkäufer) und über den Shop. Für die Produktanalyse braucht man die ersten, für die Serviceanalyse die zweiten. Beide Arten haben eine Trennung in Vor- und Nachteile sowie einen Kommentar, außerdem Bewertung und Datum. Die Anfrage für Bewertungen finden Sie auf dieselbe Weise über das Entwicklerpanel im Tab „Bewertungen“ der Produktkarte.
Überführung ins Schema
Auf Marktplätzen besteht das Textfeld oft aus drei Teilen. Schreiben Sie sie so: pros in die Spalte pros, cons in die Spalte cons, und den allgemeinen Kommentar in text. Wenn für die Analyse ein durchgehender Text nötig ist, vereinen Sie die drei Spalten in der Bereinigungsphase über ein Trennzeichen, aber in den Rohdaten halten Sie sie getrennt.
Tipp: Auf Marktplätzen sind Bewertungen mit Fotos und bestätigtem Kauf deutlich informativer. Fügen Sie einen Filter ins Skript ein: Sammeln Sie zuerst alles, und schauen Sie sich bei der Analyse separat den Ausschnitt mit has_photo gleich 1 an. Oft stehen genau dort die ausführlichsten Beschreibungen von Defekten und realen Nutzungsszenarien.
Erwartetes Ergebnis: je eine CSV pro Marktplatz mit Bewertungen zu 3-5 Produkten, überführt in ein einheitliches Schema.
Mögliche Probleme: Die Zahl der gesammelten Bewertungen ist kleiner als der Zähler auf der Seite. Ursache: Die Plattform begrenzt die Tiefe der Ausgabe oder liefert nur Bewertungen mit Text und verbirgt Bewertungen ohne Kommentar. Lösung: Vergleichen Sie die Zähler „alle Bewertungen“ und „mit Text“ auf der Seite – normalerweise erklärt genau das die Abweichung.
Prüfung: Öffnen Sie die Datei in Excel, erstellen Sie eine Pivot-Tabelle nach der Spalte rating. Die Verteilung der Bewertungen sollte ungefähr dem entsprechen, was die Produktkarte zeigt: Wenn die Plattform 70% Fünfer zeigt, sollte Ihre Stichprobe einen ähnlichen Wert haben.
Schritt 6: Bewertungen von Aggregatoren sammeln – Otzovik, iRecommend, Flamp, Zoon
Ziel dieser Etappe: lernen, mit Plattformen zu arbeiten, bei denen Bewertungen eigenständige Artikel mit HTML-Markup sind und kein JSON im Hintergrund.
Wie sich Aggregatoren unterscheiden
Otzovik und iRecommend bauen Seiten auf klassische Weise auf: Jede Bewertung ist eine eigene Seite mit Überschrift, langem Text, Bewertung, Datum, Vor- und Nachteilen, und auf der Objektseite liegt eine Liste von Links zu diesen Bewertungen mit kurzen Vorschauen. Flamp und Zoon sind näher an den Karten: Organisation, Bewertungsliste, Nachladen in Portionen. Entsprechend braucht man für die ersten beiden HTML-Parsing, für die zweiten passt die Methode aus Schritt 4.
Installation der Bibliothek für HTML-Parsing
Führen Sie im Terminal pip install beautifulsoup4 lxml aus. Die Bibliothek BeautifulSoup erlaubt es, Seitenelemente nach Tags und Klassen zu finden, so wie Sie sie mit den Augen im Entwicklerpanel finden.
Schritt-für-Schritt-Sammlung von Otzovik
- Öffnen Sie die Seite des Objekts (Produkt, Unternehmen, Kurs) auf Otzovik.
- Drücken Sie F12 und wechseln Sie zum Tab Elements (Elemente).
- Klicken Sie auf das Pfeilsymbol in der linken oberen Ecke des Panels und dann auf die Überschrift der ersten Bewertung in der Liste. Im Panel wird das HTML-Element hervorgehoben. Notieren Sie sich sein Tag und seine Klasse – das ist der Selektor für den Link zur Bewertung.
- Finden Sie auf dieselbe Weise die Elemente für Bewertung (normalerweise ein Block mit Sternen und numerischem Attribut), Datum und Kurztext.
- Scrollen Sie die Seite nach unten und finden Sie den Paginierungsblock. Klicken Sie auf die Zahl 2 und schauen Sie, wie sich die Adresse geändert hat – normalerweise wird die Seitennummer hinzugefügt. Das ist das Muster für den Durchlauf.
- Im Skript: Laden Sie die Listenseite über requests mit Proxy, parsen Sie mit BeautifulSoup, extrahieren Sie die Links zu den Bewertungen und die Vorschauen, und gehen Sie dann zur nächsten Listenseite über. Die Pause zwischen den Seiten – 5-8 Sekunden, Aggregatoren sind empfindlicher als Karten.
- Wenn der vollständige Text der Bewertung nötig ist und nicht nur die Vorschau, machen Sie einen zweiten Durchlauf: Laden Sie für jeden Link die Bewertungsseite und extrahieren Sie den Haupttext, die Blöcke für Vor- und Nachteile sowie die Bewertung nach Unterkriterien.
iRecommend
Die Logik ähnelt Otzovik: eine Objektseite mit Bewertungsliste und separate Bewertungsseiten. Der Unterschied liegt im Markup und darin, dass die Bewertung durch die Anzahl der ausgefüllten Sterne ausgedrückt wird – zählen Sie die Sterne-Elemente mit aktiver Klasse, statt nach einer Zahl zu suchen.
Flamp und Zoon
Für diese Plattformen nutzen Sie die Methode aus Schritt 4: Öffnen Sie die Organisation, wechseln Sie zu Fetch/XHR, scrollen Sie die Bewertungen und finden Sie die Hintergrundanfrage. Flamp liefert Bewertungen mit Bewertung, Text, Datum, offizieller Antwort und Nützlichkeit. Zoon – mit Bewertung, Text, Datum und Antwort der Organisation. Beide Plattformen zeigen die Gesamtzahl der Bewertungen zur Kontrolle der Vollständigkeit.
Mini-Beispiel für HTML-Parsing
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
Die Klassennamen sind hier beispielhaft – setzen Sie die realen ein, die Sie im Panel Elements gesehen haben. Prüfungen auf leere Elemente sind Pflicht: Wenn das Markup einer Bewertung abweicht, darf das Skript nicht komplett abstürzen.
Tipp: Auf Aggregatoren sind Daten oft in Worten geschrieben: „gestern“, „vor 3 Tagen“, „14. März“. Legen Sie eine separate Funktion zur Datumsnormalisierung an, die solche Strings relativ zum Sammeldatum ins Format JJJJ-MM-TT umwandelt. Ohne sie funktioniert die Sortierung nach Zeit nicht.
Erwartetes Ergebnis: CSV mit Bewertungen von einem oder zwei Aggregatoren, bei dem jede Bewertung Bewertung, Datum und Text hat und bei Otzovik und iRecommend zusätzlich einen Link zur vollständigen Seite.
Mögliche Probleme: Die Selektoren finden nach einigen Seiten keine Elemente mehr. Ursache: Die Plattform hat eine Prüfseite statt der Liste ausgeliefert. Lösung: Prüfen Sie nach jeder Ladung den Seitentitel; beim Auftreten von Prüfanzeichen – Pause, IP-Wechsel, Wiederholung nach einigen Minuten.
Prüfung: Die Zahl der gesammelten Bewertungen von einer Listenseite entspricht der Zahl der Bewertungen, die Sie auf dieser Seite im Browser sehen. Wenn weniger gesammelt wurden – ist einer der Selektoren zu eng.
Schritt 7: Mobile Proxys anbinden und Rotation einrichten
Ziel dieser Etappe: dafür sorgen, dass der Bewertungs-Parser bei Dutzenden und Hunderten von Objekten stabil läuft, die Last verteilt und keinen anomalen Strom von einer Adresse erzeugt.
Warum genau mobile Proxys
Alle Plattformen aus diesem Leitfaden sind auf ein mobiles Publikum ausgerichtet: Die meisten Bewertungen werden vom Smartphone aus geschrieben und gelesen. Mobile IP-Adressen von Mobilfunkanbietern sind Adressen, hinter denen sich gleichzeitig Hunderte und Tausende reale Teilnehmer befinden. Plattformen können solche Adressen nicht ohne Schaden für echte Nutzer blockieren und sind ihnen daher gegenüber loyal. Für das Sammeln von Bewertungen bedeutet das weniger Prüfungen, weniger Fehlalarme des Schutzes und eine vorhersehbare Geschwindigkeit.
Einrichtung der Verbindung
- Melden Sie sich im Nutzerkonto von mobileproxy.space an und öffnen Sie die Liste Ihrer Proxys.
- Kopieren Sie Host, Port, Login und Passwort. Achten Sie auf das Protokoll: Für requests ist ein HTTP-Proxy bequemer, aber SOCKS5 wird ebenfalls unterstützt, wenn Sie das Zusatzpaket
pip install requests[socks]installieren. - Setzen Sie die Daten in die Variable PROXY im Skript ein. Format: Protokoll, Doppelpunkt, zwei Schrägstriche, Login, Doppelpunkt, Passwort, At-Zeichen, Host, Doppelpunkt, Port.
- Kopieren Sie aus dem Konto den Link zum IP-Wechsel und speichern Sie ihn in der Variable ROTATE_URL.
- Führen Sie eine Testanfrage über den Proxy an einen beliebigen Dienst aus, der Ihre IP anzeigt. In der Antwort sollte eine Adresse eines Mobilfunkanbieters stehen, nicht die Ihres Heim-Providers.
Rotationsstrategie
Es gibt zwei Ansätze, und beide funktionieren.
- Rotation nach Zeit. Im Konto wird ein Intervall für den automatischen IP-Wechsel festgelegt, zum Beispiel alle 5 Minuten. Das Skript tut nichts – die Adresse ändert sich von selbst. Geeignet für lange, ruhige Sammlungen.
- Rotation nach Ereignis. Das Skript ruft selbst ROTATE_URL im richtigen Moment auf: nach jeweils N Anfragen, beim Wechsel zu einem neuen Objekt oder beim Erhalt von Code 429/403. Geeignet, wenn Kontrolle nötig ist.
Praktische Regel für Bewertungen: Wechseln Sie die IP beim Übergang zu jedem neuen Objekt und zusätzlich nach 40-60 Anfragen innerhalb eines Objekts. Machen Sie nach dem IP-Wechsel eine Pause von 5-10 Sekunden – der Anbieter braucht Zeit, damit die neue Adresse aktiv wird.
Fehlerbehandlung und Wiederholungen
Fügen Sie in die Funktion fetch_page eine Hülle ein: Bei Codes 429, 403, 5xx oder Timeout – Rotation aufrufen, warten, Anfrage bis zu dreimal mit steigender Pause wiederholen (10, 30, 90 Sekunden). Wenn drei Versuche nicht geholfen haben – das Objekt in die Datei failed.txt schreiben und zum nächsten übergehen. So stoppt ein problematisches Objekt nicht die ganze Sammlung, und Sie holen die Lücken später separat nach.
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
Wie viele Threads nutzen
Für Anfänger – ein Thread. Ein Proxy, eine Verbindung, sequenzielles Durchlaufen. Das ist langsam, aber zuverlässig: 500-1000 Bewertungen pro Stunde ohne ein einziges Problem. Wenn Sie überzeugt sind, dass alles stabil läuft, können Sie einen zweiten Proxy hinzufügen und eine zweite Skriptinstanz auf der anderen Hälfte der Objektliste starten. Mehr als 3-4 Threads pro Plattform für Bewertungen sind fast nie nötig.
Tipp: Stimmen Sie den User-Agent auf den IP-Typ ab. Wenn Sie über einen mobilen Proxy gehen, stellen Sie sich als mobiler Browser dar, wie im Beispiel aus Schritt 4. Die Abweichung „mobile IP, aber Desktop-Chrome unter Windows“ ist an sich nicht kritisch, aber Konsistenz senkt die Zahl zusätzlicher Prüfungen.
Erwartetes Ergebnis: ein Skript, das die gesamte sources.csv für eine Plattform ohne manuelles Eingreifen durchläuft, die IP beim Wechsel zwischen Objekten ändert und problematische Objekte in failed.txt schreibt.
Mögliche Probleme: Nach dem IP-Wechsel fallen die ersten Anfragen mit Timeout aus. Lösung: Erhöhen Sie die Pause nach der Rotation auf 15 Sekunden. Der Proxy verbindet sich gar nicht – prüfen Sie, ob im Konto eine Whitelist von IPs aktiviert ist, und fügen Sie dort die Adresse Ihres Computers hinzu.
Prüfung: Starten Sie die Sammlung über 10 Objekte hintereinander. Im Log sollten Einträge über IP-Wechsel zwischen Objekten stehen, die Datei failed.txt leer sein oder höchstens ein Objekt enthalten, und die Gesamtzahl der Zeilen im Ergebnis vergleichbar mit der Summe der Bewertungszähler auf der Plattform sein.
Schritt 8: Speichern, bereinigen und deduplizieren
Ziel dieser Etappe: einen Satz roher CSVs von verschiedenen Plattformen in eine einzige saubere Tabelle verwandeln, die für die Analyse geeignet ist.
Zusammenführen der Dateien
- Stellen Sie sicher, dass alle Rohdateien im Ordner raw liegen und dieselben Überschriften gemäß schema.txt haben.
- Erstellen Sie die Datei merge.py. Lesen Sie über pandas alle CSVs aus dem Ordner raw in einen DataFrame: Die Funktion pandas.concat vereint eine Liste von Tabellen.
- Prüfen Sie die Typen: rating sollte eine Zahl sein, published_at ein Datum. Überführen Sie sie mit pandas.to_numeric und pandas.to_datetime mit dem Parameter errors='coerce', damit fehlerhafte Werte leer werden und die Verarbeitung nicht brechen.
Deduplizierung
Wiederholungen entstehen aus drei Gründen: Überlappung der Seiten bei der Paginierung, wiederholte Läufe und dieselbe Bewertung, die der Autor auf mehreren Plattformen veröffentlicht hat. Behandeln Sie sie der Reihe nach:
- Löschen Sie exakte Duplikate nach dem Paar source und review_id – das sind Wiederholungen durch Paginierung und Neustarts. Methode drop_duplicates mit dem Parameter subset.
- Finden Sie unscharfe Duplikate innerhalb einer Plattform: gleiche object_id, gleiches Datum und die ersten 100 Zeichen des Textes. Das passiert, wenn die Plattform die Kennung beim Bearbeiten der Bewertung ändert.
- Plattformübergreifende Duplikate löschen Sie nicht, sondern markieren sie mit einer separaten Spalte. Die Tatsache, dass jemand dasselbe auf Otzovik und in Yandex Maps geschrieben hat, ist an sich informativ.
Textbereinigung
- Entfernen Sie doppelte Leerzeichen und Zeilenumbrüche im Text.
- Entfernen Sie Serviceargumente der Plattformen, die in den Text gelangen: „Vollständig lesen“, „Mehr anzeigen“.
- Ersetzen Sie leere Strings in pros und cons durch einen expliziten leeren Wert, nicht durch den String „nein“ oder „-“.
- Prüfen Sie die Kodierung: Wenn Sie Kauderwelsch sehen, wurde die Datei nicht in utf-8 gespeichert. Speichern Sie sie aus der Rohquelle neu.
Export des Ergebnisses
Speichern Sie die endgültige Tabelle im Ordner clean unter dem Namen reviews_all_JJJJ-MM-TT.xlsx über die Methode to_excel und parallel als CSV. Excel ist praktisch zum Ansehen, CSV – zum Laden in andere Systeme. Speichern Sie zusätzlich eine separate Datei mit der Zusammenfassung: Anzahl der Bewertungen pro Plattform, durchschnittliche Bewertung pro Objekt, Anteil der Bewertungen mit Antwort des Unternehmens.
Tipp: Fügen Sie in die saubere Tabelle die Spalte text_len mit der Textlänge ein. Bewertungen kürzer als 30 Zeichen sind für die Analyse von Ursachen fast immer nutzlos, aber lange Bewertungen mit einer Bewertung von 2-3 sind Gold: Darin erklären die Menschen ausführlich, was genau nicht stimmt.
Erwartetes Ergebnis: eine saubere Datei mit Bewertungen von allen Plattformen, ohne exakte Duplikate, mit korrekten Datentypen und Zusammenfassung.
Mögliche Probleme: Nach der Deduplizierung fehlen zu viele Zeilen. Ursache: review_id war auf einer Plattform für alle Einträge leer, und alle wurden als Duplikate gezählt. Lösung: Prüfen Sie die Ausfüllung von review_id nach Plattformen und bilden Sie für die problematische Plattform eine Kennung aus object_id, Datum und Hash des Textes.
Prüfung: Die Zeilenzahl in der sauberen Datei ist höchstens 5-10% kleiner als die Summe der Zeilen der Rohdateien. In der Spalte rating gibt es keine Werte außerhalb des Bereichs 1-5, in der Spalte published_at keine Daten aus der Zukunft.
Ergebnisprüfung: Checkliste und Test
Bevor Sie aus den gesammelten Bewertungen Schlüsse ziehen, stellen Sie sicher, dass die Sammlung korrekt verlaufen ist. Gehen Sie die Checkliste vollständig durch.
Bereitschafts-Checkliste
- Für jedes Objekt aus sources.csv gibt es in der sauberen Tabelle mindestens eine Bewertung, oder das Objekt ist in failed.txt mit Grund vermerkt.
- Die Zahl der Bewertungen pro Objekt weicht vom Zähler auf der Plattform um höchstens 10% ab.
- Die Bewertungsverteilung pro Objekt entspricht ungefähr der Verteilung, die die Plattform zeigt.
- Die neueste Bewertung in der Tabelle ist nicht später als gestern relativ zum Sammeldatum, wenn das Objekt aktiv ist.
- Alle Daten im Format JJJJ-MM-TT, alle Bewertungen Zahlen.
- Exakte Duplikate nach source und review_id gibt es nicht.
- Die Namen der Autoren fehlen entweder oder sind durch Hashes ersetzt, wenn die Aufgabe keine Namen erfordert.
- Die Rohdatendateien sind mit Datum gespeichert und nicht überschrieben.
- Tokens und Proxy-Daten liegen nicht im Skript, sondern in einer separaten Konfigurationsdatei.
Wie man stichprobenartig testet
- Wählen Sie 10 zufällige Bewertungen aus der Tabelle mit der Funktion sample in pandas.
- Öffnen Sie für jede die Objektseite auf der Plattform und finden Sie die Bewertung anhand eines Textfragments.
- Vergleichen Sie Bewertung, Datum und das Vorhandensein der Unternehmensantwort.
- Wenn 10 von 10 übereinstimmen – hervorragend. Wenn 8-9 – prüfen Sie, ob die Abweichungen mit einer Bearbeitung der Bewertung nach der Sammlung zusammenhängen. Wenn weniger als 8 – gibt es einen systematischen Fehler im Parsing, gehen Sie zum entsprechenden Schritt zurück.
Indikatoren für erfolgreiche Ausführung
Erfolg sieht so aus: Sie können eine Tabelle öffnen, sie nach jeder Plattform und jedem Objekt filtern, nach Datum und Bewertung sortieren und in fünf Minuten die Ausgangsfrage aus Schritt 1 beantworten. Zum Beispiel sehen, dass 40% der Bewertungen mit Bewertung 1-2 über ein Café auf Yandex Maps in den letzten drei Monaten die Wartezeit erwähnen, während dieselben Menschen auf 2GIS den Kaffee loben, aber das Personal kritisieren. Wenn die Frage eine Antwort bekommt – hat die Sammlung ihre Aufgabe erfüllt.
Typische Fehler und Lösungen
Unten sind Probleme gesammelt, mit denen fast jeder konfrontiert wird, der einen Bewertungs-Parser zum ersten Mal einrichtet. Format: Problem, Ursache, Lösung.
1. Das Skript hat nur die ersten 20 Bewertungen gesammelt
Ursache: Paginierung nicht implementiert oder der Offset-Parameter falsch bestimmt.
Lösung: Gehen Sie zurück ins Entwicklerpanel, scrollen Sie die Bewertungsliste zweimal und vergleichen Sie die Adressen zweier aufeinanderfolgender Anfragen. Der Parameter, der sich geändert hat, ist der Offset oder die Seitennummer. Stellen Sie sicher, dass das Skript ihn um den richtigen Schritt erhöht.
2. Alle Bewertungen kommen mit demselben Datum – dem Sammeldatum
Ursache: Im Feld published_at wird collected_at geschrieben, oder die Plattform liefert das Datum in einem Feld mit anderem Namen.
Lösung: Öffnen Sie raw_json einer Bewertung und finden Sie das Feld mit dem Veröffentlichungsdatum. Es kann date, created, published, time, updatedAt heißen. Korrigieren Sie den Feldnamen im Skript.
3. Russischer Text wird in Excel falsch angezeigt
Ursache: CSV ist in utf-8 ohne Byte Order Mark gespeichert, Excel öffnet es in einer anderen Kodierung.
Lösung: Speichern Sie mit der Kodierung utf-8-sig oder exportieren Sie direkt nach xlsx über to_excel.
4. Die Plattform antwortet mit Code 403 auf jede Anfrage
Ursache: Pflicht-Header fehlen, Session-Cookies sind nicht gesetzt, oder die Anfrage geht zu häufig raus.
Lösung: Vergleichen Sie mit dem Referenz-cURL-Befehl. Nutzen Sie requests.Session und laden Sie zuerst eine normale Objektseite. Erhöhen Sie die Pausen auf 5 Sekunden. Wechseln Sie die IP über den Proxy und warten Sie 10 Minuten vor der Wiederholung.
5. Die gesammelten Bewertungen stimmen nicht mit den realen überein
Ursache: Die Plattform speichert die Bewertung in einer anderen Skala (zum Beispiel von 0 bis 100 oder von 1 bis 10), oder in einem separaten Feld steht die Bewertung nach Unterkriterium statt der Gesamtbewertung.
Lösung: Vergleichen Sie drei Bewertungen manuell. Bestimmen Sie die Skala und führen Sie sie durch Division mit Rundung auf die Fünf-Punkte-Skala zurück. Dokumentieren Sie das in schema.txt.
6. Die Zahl der Bewertungen ist bei jedem Lauf unterschiedlich
Ursache: Die Sortierung ist nicht festgelegt, und die Plattform liefert im Modus „nach Relevanz“ unterschiedliche Datensätze.
Lösung: Finden Sie den Sortierparameter in der Anfrageadresse und legen Sie die Sortierung nach Datum fest. Sammeln Sie so lange, bis Sie eine Bewertung finden, die älter als der benötigte Zeitraum ist.
7. Das Skript stürzt an einem Objekt ab und läuft nicht weiter
Ursache: Es fehlt die Ausnahmebehandlung, jeder Fehler stoppt das Programm.
Lösung: Wickeln Sie die Verarbeitung jedes Objekts in try-except, schreiben Sie den Fehler und die Objektkennung in failed.txt und gehen Sie zum nächsten über. Die Lücken sammeln Sie in einem separaten Lauf nach.
8. Nach einer Woche Arbeit findet das Skript plötzlich nichts mehr
Ursache: Die Plattform hat die Anfrageadresse, die JSON-Struktur oder die Klassennamen im HTML geändert.
Lösung: Das ist ein normaler Teil des Lebens jedes Parsers. Wiederholen Sie die Prozedur zum Finden der Anfrage aus Schritt 4 und aktualisieren Sie Adresse und Feldnamen. Halten Sie die Liste der Selektoren und Felder in einer separaten Konfigurationsdatei, um nur eine Stelle statt des ganzen Codes zu ändern.
9. Der Proxy funktioniert, aber die Geschwindigkeit ist sehr niedrig
Ursache: Zu große Antworten (Marktplätze liefern manchmal Tausende Bewertungen in einer Datei) oder Last auf der Basisstation des Anbieters zur Hauptverkehrszeit.
Lösung: Erhöhen Sie den Timeout, aktivieren Sie die Kompression über den Header Accept-Encoding, planen Sie umfangreiche Sammlungen in die Nachtstunden.
Zusätzliche Möglichkeiten für Fortgeschrittene
Wenn das Basisszenario gemeistert ist, hier geht es weiter. Dieser Block setzt voraus, dass Sie sicher in Python schreiben.
Inkrementelles Sammeln
Statt einer vollständigen Neusammlung speichern Sie für jedes Objekt das Datum der neuesten gesammelten Bewertung. Beim nächsten Lauf sammeln Sie mit Sortierung nach Datum und stoppen, sobald Sie eine Bewertung finden, die nicht neuer als das gespeicherte Datum ist. So dauert die tägliche Aktualisierung über 500 Objekte Minuten statt Stunden, und die Last auf den Plattformen sinkt um ein Vielfaches. Beachten Sie, dass Bewertungen nach der Moderation mit rückwirkendem Datum auftauchen können – machen Sie eine Überlappung von 2-3 Tagen.
Browser-Automatisierung für komplexe Plattformen
Google Maps und ein Teil der Bereiche von Ozon lassen sich einfacher über einen gesteuerten Browser sammeln: Playwright mit angeschlossenem mobilen Proxy öffnet die Seite, scrollt die Bewertungsliste und fängt die Hintergrundantworten über einen Event-Handler für response ab. Sie erhalten dasselbe JSON wie im Entwicklerpanel, aber ohne Header und Cookies manuell reproduzieren zu müssen. Playwright unterstützt die Emulation mobiler Geräte, was hervorragend mit einer mobilen IP harmoniert. Der Preis – Geschwindigkeit und Speicherverbrauch: Ein Browser frisst 300-500 MB, also starten Sie nicht mehr als 2-3 Instanzen.
Speicherung in einer Datenbank
Wenn es mehr als 100.000 Bewertungen sind, wird CSV unpraktisch. Wechseln Sie zu SQLite (in Python integriert, Datei auf der Festplatte, null Konfiguration) oder PostgreSQL. Die Tabelle reviews mit einem eindeutigen Index über das Paar source und review_id schützt automatisch vor Duplikaten: Ein INSERT mit ON CONFLICT DO NOTHING verwirft Wiederholungen auf Datenbankebene.
Anreicherung und Analyse
- Tonalität und Themen. Lassen Sie die Texte durch ein Sprachmodell mit einem Prompt wie „extrahiere 3 Hauptthemen und die allgemeine Tonalität“ laufen. Legen Sie das Ergebnis in separate Spalten. Für Zehntausende Bewertungen nutzen Sie Batch-Verarbeitung und Cache, um nicht zweimal für denselben Text zu zahlen.
- Dynamik der Bewertungen. Erstellen Sie den durchschnittlichen Rating-Verlauf nach Wochen für jedes Objekt. Ein starker Rückgang ist ein Signal für ein Problem, das die Bewertungen in Worten erklären.
- Reaktionsgeschwindigkeit des Unternehmens. Die Differenz zwischen published_at und dem Datum der Antwort des Unternehmens ist ein direkter Indikator für die Support-Qualität, sowohl bei Ihnen als auch bei Wettbewerbern.
- Schmerz-Wörterbuch für Werbung. Eine Häufigkeitsanalyse von Substantiven und Adjektiven in Bewertungen mit Bewertung 1-2 liefert eine fertige Liste von Formulierungen für Creatives und Landingpages.
Monitoring der Parser-Gesundheit
Richten Sie einen täglichen Lauf über den Windows Task-Planer oder cron ein und fügen Sie eine einfache Prüfung hinzu: Wenn in 24 Stunden weniger als 30% des Wochendurchschnitts gesammelt wurden oder der Fehleranteil 10% übersteigt – senden Sie eine Benachrichtigung per Telegram-Bot. So erfahren Sie noch am selben Tag von einer Markup-Änderung auf der Plattform, nicht erst in einem Monat, wenn die Daten gebraucht werden.
Verwaltung des Proxy-Pools
Wenn Sie gleichzeitig mit mehreren Plattformen arbeiten, weisen Sie jeder einen separaten mobilen Proxy zu. So beeinflusst das Verhalten auf einer Plattform nicht die Reputation der Adresse auf einer anderen. Die Rotation für Karten machen Sie seltener (Objekte sind normalerweise klein, 50-200 Bewertungen), für Marktplätze häufiger (Tausende Bewertungen pro Karte). Führen Sie ein Journal: Zeit, Plattform, IP, Antwortcode. Nach einer Woche sieht man an diesem Journal, welche Rotationsintervalle für Ihr Lastprofil optimal sind.
FAQ: Häufige Fragen zum Sammeln von Bewertungen
Ist es legal, Bewertungen von öffentlichen Seiten zu sammeln?
Das Sammeln öffentlich zugänglicher Informationen für die eigene Analyse ist an sich nicht verboten, aber es gibt Einschränkungen: Nutzungsbedingungen der Plattformen, Anforderungen des 152-FZ zur Verarbeitung personenbezogener Daten, Verbot der Behinderung des Dienstbetriebs. Halten Sie Pausen ein, anonymisieren Sie Autoren, veröffentlichen Sie gesammelte Datenbanken nicht und nutzen Sie offizielle APIs, wo sie vorhanden sind. Bei kommerzieller Nutzung der Daten konsultieren Sie einen Anwalt.
Geht es auch ohne Programmierung?
Teilweise. Für eigene Objekte reichen die Nutzerkonten. Für kleine einmalige Aufgaben eignen sich Browser-Erweiterungen als Parser, die sichtbare Seitenelemente in eine Tabelle exportieren: Sie scrollen die Bewertungen manuell, die Erweiterung sammelt. Für regelmäßiges Sammeln über Dutzende Objekte ist ein Skript jedoch bequemer und zuverlässiger, und die fertigen Fragmente aus diesem Leitfaden können fast unverändert verwendet werden.
Wozu mobile Proxys, wenn ich nur 10 Objekte habe?
Für 10 Objekte und eine einmalige Sammlung kann man es auch ohne versuchen. Aber sobald Sie Daten regelmäßig aktualisieren oder die Liste erweitern, beginnen Anfragen von einer Heim-IP zusätzliche Prüfungen zu erhalten. Ein mobiler Proxy löst das im Voraus, und die Kosten sind nicht vergleichbar mit der Zeit, die für die Bewältigung von Blockierungen draufgeht.
Wie viele Bewertungen pro Stunde kann man realistisch sammeln?
In einem Thread mit Pausen von 2-5 Sekunden – zwischen 500 und 1500 Bewertungen pro Stunde, je nach Größe der Portion auf der Plattform. Marktplätze, die Hunderte Bewertungen in einer Antwort liefern, geben mehr, Aggregatoren mit seitenweisem HTML – weniger. Für die meisten analytischen Aufgaben ist das mehr als genug.
Wie sammle ich nur neue Bewertungen statt alles neu?
Speichern Sie das Datum der letzten gesammelten Bewertung für jedes Objekt, sortieren Sie bei der Anfrage nach Datum und stoppen Sie bei der ersten bereits bekannten Bewertung. Mehr dazu im Block über inkrementelles Sammeln.
Bewertungen ohne Text, nur mit Bewertung – sammeln oder nicht?
Hängt von der Aufgabe ab. Für die Berechnung des Durchschnittsratings und der Dynamik – ja, sie beeinflussen die Zahlen. Für die Analyse von Ursachen – nein, sie können bei der Verarbeitung herausgefiltert werden. Sammeln Sie alles und filtern Sie in der Analysephase: Neu sammeln ist teurer.
Was tun, wenn die Plattform ein Captcha zeigt?
Die Sammlung für 10-15 Minuten stoppen, die IP über den Proxy wechseln, die Anfragefrequenz senken und die Header prüfen. Das Captcha ist ein Signal, dass Ihr Verhalten untypisch aussieht. Die Aufgabe ist, es typisch zu machen, nicht sich durch die Prüfung zu drücken.
Wie speichere ich Autorennamen, ohne das Gesetz zu verletzen?
Am besten gar nicht speichern. Wenn Sie Bewertungen eines Autors unterscheiden müssen, nutzen Sie einen Einweg-Hash vom Namen. Wenn Namen notwendig sind (zum Beispiel für die Antwort an den Kunden über das Nutzerkonto), speichern Sie sie nur im Rahmen der Arbeit mit Ihrer eigenen Organisation und geben Sie sie nicht an Dritte weiter.
Wie oft brechen Bewertungs-Parser?
Große Plattformen ändern interne Anfragen und Markup mehrmals im Jahr. Bei gutem Monitoring dauert die Reparatur 20-40 Minuten: die Anfrage neu suchen und die Felder aktualisieren. Halten Sie Selektoren und Adressen in einer Konfigurationsdatei, dann sind die Änderungen punktuell.
Kann man mit einem Skript von allen Plattformen sammeln?
Ja, wenn man ein gemeinsames Grundgerüst macht (Proxy, Wiederholungen, Schreiben ins Schema) und für jede Plattform eine separate Adapter-Funktion, die die Anfrageadresse und die Feldnamen kennt. Genau so sind ausgereifte Projekte aufgebaut: ein gemeinsames Modul und ein Dutzend kleiner Adapter.
Fazit
Fassen wir zusammen. Sie haben den Weg von der Fragestellung bis zur sauberen Bewertungstabelle von drei verschiedenen Plattformtypen durchlaufen. Sie haben gelernt, Hintergrundanfragen über das Entwicklerpanel zu finden, sie per Skript zu reproduzieren, HTML dort zu parsen, wo JSON nicht verfügbar ist, mobile Proxys mit Rotation anzubinden, Fehler zu behandeln und Anfragen zu wiederholen, Daten zusammenzuführen und zu bereinigen. Separat haben Sie sich mit den offiziellen Exportwegen und den rechtlichen Rahmenbedingungen befasst, was sowohl die Daten als auch Sie schützt.
Die Hauptsache, die man mitnehmen sollte: Bewertungen sind ein besonderer Datentyp mit eigener Dynamik. Sie erscheinen ständig, werden bearbeitet, durchlaufen die Moderation und tragen personenbezogene Informationen. Deshalb ist ein Bewertungs-Parser kein einmaliges Skript, sondern ein kleines System: Sammlung, Speicherung der Rohdaten, Überführung ins Schema, Deduplizierung, Monitoring. Jedes Element dieses Systems haben Sie bereits in Grundform aufgebaut.
Was als Nächstes zu tun ist:
- Erweitern Sie sources.csv auf die reale Objektliste und führen Sie eine vollständige Sammlung durch.
- Richten Sie einen täglichen inkrementellen Lauf über den Planer ein.
- Fügen Sie mindestens eine analytische Erweiterung hinzu: Rating-Dynamik oder Thematisierung negativer Bewertungen.
- Führen Sie ein Journal der Plattformänderungen und aktualisieren Sie die Adapter bei Ausfällen.
Wohin man sich entwickeln kann. Die nächste Stufe ist die Automatisierung der Reaktion: Benachrichtigungen an das Team über eine negative Bewertung innerhalb einer Stunde nach Veröffentlichung, Vergleichsberichte über Wettbewerber einmal pro Woche, Integration von Themen aus Bewertungen in den Produktplan und Werbehypothesen. Die Daten haben Sie bereits. Es bleibt, sie in Entscheidungen zu verwandeln, und hier beginnt der interessanteste Teil der Arbeit.
