So baust du einen Korpus für ein RAG-System über mobile Proxys auf, ohne Müll zu sammeln: Schritt-für-Schritt-Anleitung
Inhalt des Artikels
- Einleitung: was du bekommst und für wen das gedacht ist
- Vorbereitung: werkzeuge, zugänge, umgebung
- Grundbegriffe einfach erklärt
- Schritt 1: korpusgrenzen definieren und quellenkarte erstellen
- Schritt 2: mobilen proxy einbinden und prüfen, dass requests darüber laufen
- Schritt 3: einen sorgfältigen crawler mit limits, rotation und journal schreiben
- Schritt 4: sauberen text aus html und dokumenten extrahieren
- Schritt 5: müll filtern: deduplizierung, templates, qualität, sprache
- Schritt 6: metadaten auszeichnen und den finalen korpus zusammenstellen
- Ergebnis prüfen: checkliste und test des korpus
- Typische fehler und lösungen beim aufbau eines rag-korpus
- Zusätzliche möglichkeiten für fortgeschrittene
- Faq: häufige fragen zum korpusaufbau
- Fazit: was geschafft ist und wie es weitergeht
Einleitung: Was du bekommst und für wen das gedacht ist
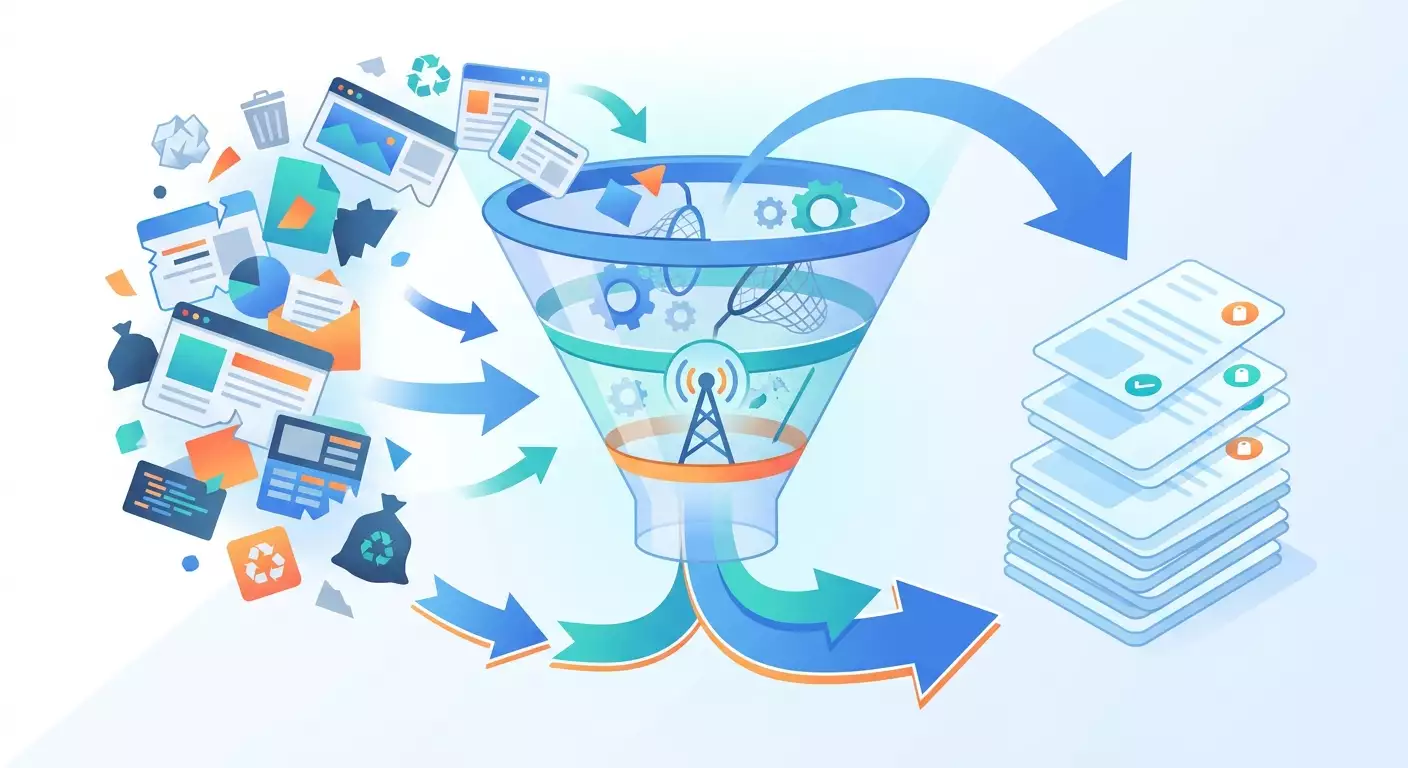
Ein RAG-System ist genau so gut wie der Korpus, auf dem es antwortet. Du kannst das stärkste Sprachmodell nehmen, eine teure Vektordatenbank anbinden und am Ende trotzdem überzeugenden Unsinn bekommen, wenn im Korpus Menüs, Footer mit Copyright, dieselbe Artikel in fünf Varianten und Seiten wie „Artikel vorübergehend nicht verfügbar“ gelandet sind. Das Modell unterscheidet nicht zwischen Müll und Wissen. Es sucht einfach ähnliche Fragmente und setzt daraus eine Antwort zusammen.
Diese Schritt-für-Schritt-Anleitung widmet sich einem einzigen Schritt: dem Aufbau des Korpus. Wir schauen uns nicht den Aufbau der Vektordatenbank, die Auswahl der Embeddings oder die Chunk-Konfiguration an – dazu gibt es separate Beiträge im Blog. Hier konzentrieren wir uns genau auf die Grenze: Auf deiner Festplatte liegt eine saubere, ausgezeichnete, deduplizierte Sammlung von Dokumenten im JSONL-Format, die du an jede Indexierungspipeline übergeben kannst.
Was du am Ende erhältst:
- eine Liste von Quellen mit klaren Grenzen: was wir sammeln, was nicht;
- einen funktionierenden Crawler in Python, der über mobile Proxys läuft, Limits einhält und fremde Websites nicht zum Absturz bringt;
- einen Ordner mit Rohseiten und Dokumenten, jeweils mit Metadaten;
- ein Skript zur Extraktion des Haupttextes ohne Navigation, Werbung und Template-Blöcke;
- Qualitätsfilter und Deduplizierung, die Müll aussortieren, bevor er in den Index gelangt;
- eine finale Korpusdatei und einen Bericht mit Zahlen, an denen du erkennen kannst, dass alles richtig gemacht wurde.
Für wen dieser Leitfaden ist. Für Marketer und Geschäftsinhaber, die eine Wissensdatenbank zu ihrer Nische aufbauen und darauf einen Assistenten aufsetzen wollen. Für Affiliates, die einen Korpus zu Angeboten, Landingpages und Werbeplatzierungsregeln benötigen. Für Entwickler, die bereits Proxys in Skripte eingebunden haben und es nun sauber und systematisch machen wollen. Der Haupttext ist für Einsteiger geschrieben, am Ende gibt es einen separaten Block für Fortgeschrittene.
Was du vorher wissen solltest. Du solltest Befehle im Terminal ausführen und Dateien in einem Texteditor öffnen können. Grundlegende Python-Kenntnisse auf dem Niveau „ich verstehe, was eine for-Schleife macht“. Zugang zu einem mobilen Proxy: Adresse, Port, Login, Passwort und ein Link zum IP-Wechsel.
Wie viel Zeit du brauchst. Die Einrichtung der Umgebung dauert etwa 30 Minuten. Alle Schritte zusammen 3 bis 5 Stunden, je nach Umfang des Korpus. Das Sammeln mehrerer tausend Seiten kann im Hintergrund einige Stunden laufen, aber deine Anwesenheit ist dabei nicht nötig.
Vorbereitung: Werkzeuge, Zugänge, Umgebung
Bevor wir die erste Codezeile schreiben, bringen wir den Arbeitsplatz in Ordnung. Das spart später Stunden beim Debuggen.
Systemanforderungen
- Ein Computer oder Server mit Windows 10/11, macOS oder Linux. Für das Sammeln von Zehntausenden Seiten ist ein gemieteter VPS bequemer, aber für den ersten Korpus reicht ein Laptop.
- Mindestens 8 GB Arbeitsspeicher. Die Deduplizierung großer Korpora braucht viel Speicher.
- Freier Festplattenplatz: mindestens 5 GB. Rohes HTML belegt 5- bis 10-mal mehr als reiner Text, und wir werden beides speichern.
- Eine stabile Internetverbindung. Der Proxy fügt Verzögerungen hinzu, daher dehnt eine langsame Heimleitung den Sammelvorgang deutlich aus.
Was du installieren solltest
- Python 3.11 oder neuer. Lade den Installer von der offiziellen Website herunter und setze bei der Installation unter Windows das Häkchen „Add Python to PATH“. Überprüfe im Terminal:
python --version. Es sollte eine Zeile wiePython 3.12.xerscheinen. - Virtuelle Umgebung. Erstelle einen Projektordner, zum Beispiel
rag-corpus, gehe hinein und führepython -m venv venvaus. Aktiviere sie: unter Windowsvenv\Scripts\activate, unter macOS und Linuxsource venv/bin/activate. Am Anfang der Terminalzeile erscheint(venv). - Bibliotheken. Installiere sie mit einem Befehl:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdm. Die Installation dauert 1-3 Minuten. - Ein Texteditor mit Code-Highlighting: VS Code, PyCharm Community oder ein anderer.
Proxy-Zugänge
Öffne dein Proxy-Kundenkonto. In der Karte des gekauften mobilen Proxys findest du vier Werte: Host (IP-Adresse oder Domainname), Port für HTTP und Port für SOCKS5, Login und Passwort. Kopiere zusätzlich den Link zum IP-Wechsel: das ist eine URL, bei der ein einfacher GET-Request genügt, damit der Proxy eine neue Adresse vom Anbieter erhält. Schreibe alles in eine Datei .env im Projektordner, nicht direkt in den Code.
Ordnerstruktur
Erstelle im Projekt folgende Ordner: raw für Rohseiten, clean für extrahierten Text, corpus für die finale Datei, logs für Journale. Leere Ordner am Anfang sind normal.
Backups
Der Korpus braucht lange zum Aufbau, und ihn zu verlieren ist ärgerlich. Mach dir eine Regel: Der Ordner raw wird niemals überschrieben, nur ergänzt. Nach jedem größeren Schritt archivierst du das Ergebnis: tar -czf raw_backup_2026-03-01.tar.gz raw/ unter Linux und macOS oder über den integrierten Windows-Archivierer. Wenn du dich bei den Filtern vertust und zu viel löschst, kannst du jederzeit zu den Rohdaten zurückkehren, ohne sie neu sammeln zu müssen.
Tipp: Lege sofort eine Datei sources.md an und notiere jede Entscheidung: welche Websites du nimmst, welche Bereiche du ausschließt, warum. Wenn der Assistent einen Monat später seltsame Antworten gibt, rettet dir diese Datei den Abend.
Grundbegriffe einfach erklärt
Wenn du zum ersten Mal Daten für ein RAG-System sammelst, tauchen in jedem Schritt einige Begriffe auf. Wir klären sie kurz.
Was ist RAG und warum der Korpus wichtiger ist als das Modell
RAG (Retrieval-Augmented Generation) ist ein Ansatz, bei dem das Sprachmodell vor der Antwort eine Auswahl von Fragmenten aus deiner Wissensdatenbank erhält. Das Modell „kennt“ deine Dokumente nicht, es liest die gefundenen Stücke und antwortet darauf basierend. Daraus folgt eine einfache Regel: Wenn in der Datenbank Müll liegt, zieht die Suche früher oder später genau diesen hervor, und die Antwort stützt sich auf die Zeile „Abonniere den Newsletter“ statt auf eine Anleitung. Deshalb darf der Schritt des Korpusaufbaus nicht übersprungen werden.
Korpus, Dokument, Metadaten
Korpus ist die Gesamtheit der Texte, die in das RAG-System gehen. Dokument ist eine sinnvolle Einheit: ein Artikel, eine Hilfeseite, eine PDF-Anleitung, eine Produktkarte. Metadaten sind der Pass des Dokuments: woher es stammt, wann es gesammelt wurde, in welcher Sprache, von wem, zu welchem Bereich es gehört. Ohne Metadaten kannst du den Korpus weder aktualisieren noch dem Nutzer erklären, woher die Antwort kommt, noch Veraltetes herausfiltern.
Mobiler Proxy und warum er beim Sammeln wichtig ist
Ein mobiler Proxy ist ein Vermittlungsserver, der deine Anfragen über eine IP-Adresse eines Mobilfunkanbieters ins Internet leitet. Für den Korpusaufbau löst er drei praktische Aufgaben. Erstens: Lastverteilung. Statt eine Website von einer Adresse aus anzusteuern, kommst du von verschiedenen, und jede Quelle sieht ruhigen, seltenen Traffic. Zweitens: Geografie. Viele Websites zeigen unterschiedliche Inhalte, Preise und Verfügbarkeiten je nach Region, und ein mobiler Proxy der gewünschten Stadt liefert genau die Seitenversion, die deine Kunden sehen. Drittens: Stabilität langer Sessions. Die IP-Rotation per Link ermöglicht stundenlanges Sammeln, ohne von einer Adresse abhängig zu sein.
Rotation ist der Wechsel der IP-Adresse. Sie kann nach Zeitplan erfolgen (alle N Minuten) oder auf Anfrage (du rufst den Link auf, wenn du es brauchst). Beim Korpusaufbau ist die zweite Variante praktischer: Quelle gewechselt, Adresse gewechselt.
Was als Müll gilt
Im Kontext des Korpus ist Müll alles, was kein Wissen zu deinem Thema trägt, aber Platz im Index belegt und die Suche verschlechtert:
- Navigation, Menüs, Footer, „Brotkrumen“, Aboformulare;
- exakte und fast exakte Duplikate desselben Textes unter verschiedenen Adressen;
- Platzhalterseiten: „Seite nicht gefunden“, „Artikel ausverkauft“, „Wartung läuft“;
- Texte in einer anderen Sprache, wenn der Korpus einsprachig ist;
- abgeschnittene Seiten, bei denen der Proxy oder die Website nur die Hälfte des HTML zurückgegeben hat;
- fremde Inhalte, die du nicht verwenden darfst.
Rechtlicher Rahmen
Sammle nur offene Daten, die ohne Anmeldung zugänglich sind, und deine eigenen Dokumente. Respektiere die Datei robots.txt: Das ist eine Liste von Regeln der Website, welche Bereiche automatisch durchsucht werden dürfen. Sammle keine personenbezogenen Daten Dritter: Namen mit Telefonnummern, Adressen, Konten. Wenn du einen Korpus aus eigenen internen Dokumenten aufbaust, stelle sicher, dass du das Recht hast, sie zu verwenden. Der Proxy wird in diesem Leitfaden als Werkzeug für ehrliches, verteiltes Sammeln eingesetzt, nicht als Mittel, um etwas zu tun, was die Quelle verboten hat.
Schritt 1: Korpusgrenzen definieren und Quellenkarte erstellen
Ziel dieses Schritts: eine Datei mit einer Liste von Quellen, in der für jede festgehalten ist, welche URLs wir nehmen, welche ausschließen, mit welcher Tiefe wir crawlen und wie viele Requests pro Minute erlaubt sind.
Die häufigste Ursache eines mülligen Korpus sind nicht technische Fehler, sondern fehlende Grenzen. Man startet den Crawler „für die ganze Website“, bekommt 40.000 Seiten, von denen 800 zum Thema gehören, und putzt dann eine Woche lang. Machen wir es umgekehrt: erst die Karte, dann das Sammeln.
Anleitung
- Formuliere die Fragen, die dein RAG-System beantworten soll. Schreibe 20-30 echte Nutzerfragen auf. Zum Beispiel für die Wissensdatenbank eines Proxy-Dienstes: „Wie wechsle ich die IP per Link“, „Warum antwortet der Proxy langsam“, „Welche Ports werden unterstützt“. Diese Fragen werden dein Testset bei der Überprüfung.
- Notiere für jede Frage, wo die Antwort liegt. Hilfebereich, Dokumentation, Blogartikel, PDF-Richtlinien, Produktseiten. Alles, was nicht auf dieser Liste steht, kommt nicht in den Korpus.
- Öffne jede Quelle im Browser und untersuche die Adressstruktur. Nützlicher Inhalt liegt normalerweise unter klaren Präfixen:
/help/,/docs/,/blog/,/faq/. Müll liegt unter anderen:/tag/,/search?,/cart/,/author/, Paginierungsseiten wie?page=. - Prüfe die robots.txt der Quelle. Öffne
https://domain/robots.txt. Suche die ZeilenDisallow: diese Pfade schließen wir ohne Diskussion aus. Wenn dort auchCrawl-delaysteht, notiere es als minimale Pause zwischen Requests. - Finde die Sitemap. Oft steht sie in der robots.txt unter
Sitemap:oder liegt unter/sitemap.xml. Die Sitemap ist eine fertige Liste von Adressen, die dich vom rekursiven Link-Crawling und dem damit verbundenen Müll befreit. - Bestimme die Last. Für kleine Websites setze nicht mehr als 10-15 Requests pro Minute. Für große Portale mit CDN sind bis zu 30 erlaubt. Wenn du unsicher bist, nimm weniger: Der Korpus eilt nicht.
- Bestimme die Geografie. Wenn der Inhalt regionsabhängig ist (Preise, Lieferung, Verfügbarkeit), entscheide, aus welcher Stadt dein Crawler „schauen“ soll, und wähle den passenden mobilen Proxy.
- Fasse alles in einer Datei
sources.jsonzusammen.
Beispiel für einen Eintrag einer Quelle:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]Das Feld rotate_every legt fest, nach wie vielen Requests der Crawler den Link zum IP-Wechsel aufruft. Ersetze die einfachen Anführungszeichen durch doppelte, wenn du die Datei als echtes JSON speicherst; hier stehen sie nur zur Veranschaulichung.
Achtung: Füge keine Websites als Quellen hinzu, bei denen der nützliche Inhalt nur nach dem Login sichtbar ist. Erstens verstößt das gegen die Nutzungsbedingungen der meisten Plattformen. Zweitens lässt sich ein solcher Korpus nicht legal aktualisieren und innerhalb des Unternehmens weitergeben.
Tipp: Lege eine separate Quelle für deine eigenen Dokumente an: einen Ordner mit PDFs, DOCX und Exporten aus deinem CRM oder deiner Wissensdatenbank. Sie müssen nicht über den Proxy heruntergeladen werden, aber sie werden mit derselben Pipeline verarbeitet und bereinigt wie Webseiten.
Überprüfung: Du hast eine Datei sources.json, in der jede Quelle Include-Präfixe, Exclude-Muster, Request-Limit und Sprache hat. Öffne 5 zufällige Adressen aus der Sitemap, die unter deine Filter fallen, und stelle sicher, dass jede inhaltlichen Text enthält und nicht nur einen Linkkatalog.
Mögliche Probleme
- Die Website hat keine Sitemap. Sammle die Adressliste manuell aus mehreren Übersichtsseiten oder über ein einfaches Link-Crawling nur innerhalb der erlaubten Präfixe bis Tiefe 2.
- Die Sitemap enthält 100.000 Adressen. Filtere nach Präfixen, nimm dann eine Stichprobe von 200 Adressen, sammle und bewerte die Qualität, bevor du alles startest.
- Der nützliche Inhalt ist über verschiedene Domains verteilt. Lege für jede Domain einen eigenen Eintrag in
sources.jsonan, mit eigenem Limit und eigener Geografie.
Schritt 2: Mobilen Proxy einbinden und prüfen, dass Requests darüber laufen
Ziel dieses Schritts: sicherstellen, dass das Skript tatsächlich über den mobilen Proxy läuft, die Rotation funktioniert und die Verzögerungen für das Sammeln akzeptabel sind.
Anleitung
- Erstelle die Datei
.envim Projektstamm und trage die Werte aus dem Kundenkonto ein:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxJeder Wert in einer eigenen Zeile. Füge .env zu .gitignore hinzu, wenn du ein Versionskontrollsystem verwendest.
- Erstelle die Datei
proxy_check.pymit folgendem Inhalt:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP ohne Proxy:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP über Proxy:', ip1, 'in', round(time.time() - t0, 2), 'Sek.') print('IP wird geändert...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP nach Rotation:', ip2) print('Rotation hat funktioniert:', ip1 != ip2)Installiere vorher pip install python-dotenv. Die Codezeilen stehen in der echten Datei jeweils in einer eigenen Zeile.
- Führe aus:
python proxy_check.py. - Lies die Ausgabe. Die erste IP sollte deine Heim- oder Server-IP sein. Die zweite sollte abweichen und zu einem Mobilfunkanbieter gehören. Die dritte sollte von der zweiten abweichen, und die letzte Zeile sollte
Trueanzeigen. - Messe die Verzögerung. Wenn ein Request über den Proxy länger als 5-6 Sekunden dauert, wird das Sammeln langsam. Prüfe, ob der gewählte Proxy geografisch nahe an den Zielseiten liegt, oder kontaktiere den Support des Dienstes.
- Prüfe SOCKS5 als Alternative. Wenn der HTTP-Port instabile Ergebnisse liefert, ersetze
http://inproxy_urldurchsocks5h://und den Port durch den SOCKS5-Port aus dem Kundenkonto. Dazu brauchst dupip install requests[socks]. Das Suffixhist wichtig: Es bewirkt, dass der Proxy Domänennamen selbst auflöst.
Achtung: Löse die IP-Rotation nicht häufiger aus, als dein Tarif erlaubt. Bei den meisten mobilen Proxys gibt es ein Mindestintervall zwischen Wechseln, meist 30 Sekunden bis 2 Minuten. Zu häufige Aufrufe des Rotationslinks werden entweder ignoriert oder sperren die Funktion vorübergehend.
Tipp: Messe fünf Verzögerungen hintereinander und notiere den Median. Diese Zahl brauchst du im nächsten Schritt, um die Timeouts richtig zu setzen: Der Timeout sollte etwa 4-5 Mal so groß sein wie die typische Verzögerung.
Überprüfung: Das Skript gibt drei verschiedene IP-Adressen aus, die Zeile Rotation hat funktioniert: True, und die typische Verzögerung über den Proxy überschreitet 3-4 Sekunden nicht. Wenn alles so ist, ist der Proxy einsatzbereit.
Mögliche Probleme
- Fehler 407 Proxy Authentication Required. Prüfe Login und Passwort, stelle sicher, dass keine Leerzeichen enthalten sind. Wenn das Passwort
@oder:enthält, kodiere sie miturllib.parse.quote. - Fehler Connection refused oder Timeout. Der Proxy ist möglicherweise an deine Whitelist-IP gebunden. Gehe ins Kundenkonto und füge die aktuelle Serveradresse zur Liste der erlaubten hinzu, oder wechsle zur Authentifizierung per Login und Passwort.
- Die IP hat sich nach der Rotation nicht geändert. Erhöhe die Pause nach dem Aufruf des Rotationslinks auf 15-20 Sekunden. Manche Anbieter vergeben die neue Adresse nicht sofort.
- SSL-Fehler. Aktualisiere die Bibliothek
certifimitpip install -U certifi. Deaktiviere nicht die Zertifikatsprüfung mitverify=False: Das ist unsicher.
Schritt 3: Einen sorgfältigen Crawler mit Limits, Rotation und Journal schreiben
Ziel dieses Schritts: ein Skript, das die Adressen aus der Sitemap durchgeht, robots.txt und Limits einhält, über den Proxy läuft, die IP nach Zeitplan wechselt, rohes HTML speichert und ein Journal führt, in dem jeder Request sichtbar ist.
Hier ist die Philosophie wichtig. Ein guter Crawler für ein RAG-System ist langsam, höflich und paranoid detailliert in den Logs. Ein schneller aggressiver Crawler sammelt dir einen Haufen abgeschnittener Seiten und 429-Fehler ein, und danach weißt du nicht, was davon Müll ist.
Anleitung
- Erstelle die Datei
fetch.py. Struktur des Skripts: Einstellungen laden, Sitemap parsen, Adressen filtern, Request-Schleife mit Pausen, Ergebnis speichern. - Lade die Sitemap und filtere die Adressen. Die Sitemap ist XML, in der jede Adresse im Tag
locliegt. Parse sie mit dem Standardmodulxml.etree.ElementTree. Behalte nur Adressen, die mitinclude_prefixesbeginnen und keines derexclude_patternsenthalten. Speichere das Ergebnis inurls_help_center.txtund schau es dir mit eigenen Augen an. - Binde die robots.txt-Prüfung ein. Nutze
urllib.robotparser.RobotFileParser: Lade die Datei einmal pro Domain und frage vor jedem Requestcan_fetch(user_agent, url). Überspringe verbotene Adressen und schreibe sie mit der Notizrobots_disallowins Journal. - Setze einen ehrlichen User-Agent. Zum Beispiel:
CorpusCollector/1.0 (+contact: data@yourcompany.ru). Der Websitebetreiber sollte verstehen, wer zu ihm kommt und wie er Kontakt aufnehmen kann. Das ist nicht nur Ethik, sondern Praxis: Ein verständlicher Agent gerät seltener unter automatische Beschränkungen. - Implementiere Pausen. Berechne aus
rate_per_minutedie Basis-Pause:60 / rate_per_minuteSekunden. Füge eine Zufallskomponente von 20-40 Prozent hinzu, damit die Requests nicht wie ein Metronom laufen. Wenn in der robots.txt einCrawl-delaysteht, nimm das Maximum der beiden Werte. - Implementiere die Rotation. Zähle die Requests, und wenn der Zähler
rotate_everyerreicht, rufe den Link zum IP-Wechsel auf, warte 10 Sekunden und setze den Zähler zurück. Die Rotation sollte auch beim Wechsel zur nächsten Quelle erfolgen. - Verarbeite die Antworten. Code 200 speichern. Codes 301 und 302 behandelt
requestsselbst, aber notiere die endgültige Adresse: Sie wird für die Deduplizierung gebraucht. Code 404 ins Journal schreiben und überspringen. Code 429 oder 503 bedeutet „zu häufig“: 5 Minuten Pause, Basis-Pause um das Eineinhalbfache erhöhen und einmal wiederholen. Wenn die Wiederholung nicht hilft, überspringen und weitermachen. - Speichere rohes HTML zusammen mit dem Pass. Schreibe für jede Seite eine Zeile in die Datei
raw/help_center.jsonl.
Zentraler Codeausschnitt für Speichern und Schleife:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))Achte auf die Bedingung len(html) > 2000. Eine Seite mit inhaltlichem Text ist fast nie kürzer als zwei Kilobyte HTML. Das ist der erste, gröbste Müllfilter, und er schneidet leere Antworten und Platzhalter schon am Eingang ab.
- Starte an einer Stichprobe. Der erste Durchlauf sollte an 50 Adressen erfolgen. Schau ins Journal, öffne ein paar gespeicherte HTML-Dateien im Browser. Stelle sicher, dass es die richtigen Seiten sind.
- Starte den vollständigen Sammellauf. Verwende auf dem Server
nohup python fetch.py &oderscreen, damit der Prozess das Schließen des Terminals überlebt. Das Sammeln von 3000 Seiten bei 12 Requests pro Minute dauert etwa 4-5 Stunden.
Achtung: Starte nicht mehrere Kopien des Crawlers parallel auf dieselbe Website über denselben Proxy. Die IP-Rotation hebt die Lastlimits auf den Quellserver nicht auf. Wenn du schneller sein willst, parallelisiere über verschiedene Websites, nicht über eine einzelne.
Tipp: Schreibe ins Journal die Proxy-IP, mit der jeder Request gemacht wurde. Wenn beim Bereinigen eine Charge abgeschnittener Seiten auffällt, siehst du an IP und Zeit sofort, ob es ein Ausfall einer bestimmten Session war, und sammelst nur diese neu.
Tipp: Füge dem Crawler eine Wiederaufnahme hinzu: Lies vor dem Start die bereits gesammelten Adressen aus raw/*.jsonl und überspringe sie. Dann zwingen eine Verbindungsunterbrechung oder ein Serverneustart dich nicht, von Null anzufangen.
Überprüfung: Im Ordner raw liegt eine JSONL-Datei, die Zeilenzahl ist nahe an der Anzahl der Adressen mit Status 200 im Journal, und eine zufällig gewählte Zeile enthält die Felder url, fetched_at, proxy_ip und vollständiges HTML. Der Anteil an Fehlern und Übersprüngen im Journal überschreitet 5 Prozent nicht.
Mögliche Probleme
- Viele 429-Antworten. Du bist zu schnell für diese Website. Halbiere
rate_per_minute, erhöherotate_every, damit die Rotation nicht wie ein Ausbruch von neuen Adressen aussieht. - Seiten kommen leer an, obwohl der Status 200 ist. Der Inhalt wird per JavaScript gerendert. Solche Quellen brauchen Browser-Rendering, dazu im Fortgeschrittenen-Block. Markiere sie vorerst in
sources.jsonmit dem Flagneeds_js: true. - Das Sammeln läuft, aber sehr langsam. Prüfe die Proxy-Verzögerung aus Schritt 2, stelle sicher, dass der Timeout nicht auf 120 Sekunden gesetzt ist, wenn die typische Verzögerung 2 beträgt, sonst frisst jede hängende Seite zwei Minuten.
- Das Skript stürzt bei der Kodierung ab. Verwende
r.textmit Prüfung vonr.encoding; wenn die Website die Kodierung falsch liefert, setzer.encoding = r.apparent_encodingvor dem Lesen.
Schritt 4: Sauberen Text aus HTML und Dokumenten extrahieren
Ziel dieses Schritts: rohes HTML und Dateien in reinen Text verwandeln, in dem nur der Hauptinhalt der Seite bleibt: Überschrift, Absätze, Listen, Tabellen, ohne Menüs, Footer, Werbeeinblendungen und Widgets.
Das ist der Moment, in dem die Qualität des Korpus geboren wird oder stirbt. Der naive Ansatz „alle Tags entfernen“ lässt Menüpunkte, „Kaufen“-Buttons, Cookie-Banner-Text und Listen ähnlicher Artikel im Text. All das taucht später in den Antworten des RAG-Systems auf.
Anleitung für Webseiten
- Erstelle die Datei
extract.py. Sie liestraw/*.jsonlzeilenweise und schreibt das Ergebnis inclean/*.jsonl. - Verwende die Bibliothek
trafilaturazur Extraktion des Haupttextes. Sie ist darauf trainiert, den Inhaltsbereich einer Seite zu finden und Template-Blöcke zu verwerfen.
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- Der Parameter
favor_precision=Truezwingt die Bibliothek, strenger zu sein: Sie verliert lieber ein Stück Text, als ein Menü mitzunehmen. Für einen RAG-Korpus ist das die richtige Wahl. Wenn du merkst, dass benötigte Blöcke verloren gehen, zum Beispiel Tabellen mit Eigenschaften, schalte für die betreffende Quelle auffavor_recall=Trueum. - Füge eine Fallback-Methode hinzu. Wenn
trafilaturaNoneoder Text kürzer als 200 Zeichen zurückgibt, versuche, den Inhalt über einen CSS-Selektor zu extrahieren, den du manuell findest: Öffne die Seite im Browser, drücke F12, finde den Block mit dem Haupttext, kopiere seine Klasse, zum Beispielarticle-body. VerwendeBeautifulSoup, um nur diesen Block auszuschneiden. Trage den Selektor insources.jsonalscontent_selectorein. - Normalisiere den Text. Ersetze geschützte Leerzeichen durch normale, fasse drei oder mehr Zeilenumbrüche zu zwei zusammen, entferne Leerzeichen am Zeilenanfang und -ende. Ändere nicht die Groß-/Kleinschreibung und entferne keine Satzzeichen: Das verschlechtert die Suche.
- Speichere zusammen mit den ursprünglichen Metadaten. Kopiere aus dem Rohdatensatz
url,final_url,fetched_at, fügesourceaussources.jsonhinzu, Felder aus der Extraktion und die Textlänge in Zeichen.
Anleitung für PDF und DOCX
- PDF. Verwende
pypdf: Öffne die Datei, gehe durch die Seiten, rufepage.extract_text()auf und füge zusammen. Speichere die Seitenzahl für jedes Fragment: Das sind wertvolle Metadaten, mit denen der Nutzer die Stelle im Original finden kann. Wenn der Text leer zurückkommt, enthält das PDF Scans statt Text: Lege solche Dateien in einen separaten Ordner, die Erkennung liegt außerhalb dieses Leitfadens. - DOCX. Verwende
python-docx: Gehe durchdocument.paragraphsunddocument.tables. Überschriften in Word haben den StilHeading 1,Heading 2: Speichere sie als separate Zeilen mit Markierung, damit lässt sich das Dokument später gut aufteilen. - Entferne Kopf- und Fußzeilen. In PDF-Anleitungen wiederholt sich auf jeder Seite der Firmenname, die Versionsnummer und „Seite 3 von 40“. Sammle alle Zeilen des Dokuments, finde die, die auf mehr als der Hälfte der Seiten vorkommen, und lösche sie.
Achtung: Lösche Tabellen nicht der Schönheit wegen. In Anleitungen, Tarifen und Eigenschaften enthalten genau die Tabellen die Antworten auf konkrete Fragen: „Welches Limit“, „Wie viel kostet“, „Welcher Port“. Speichere sie zeilenweise, trenne die Zellen durch Tab oder senkrechten Strich.
Tipp: Nimm nach der Extraktion 20 zufällige Dokumente und lies sie vollständig. Nicht überfliegen, sondern lesen. Eine solche Revision findet mehr systematische Probleme als jeder automatische Filter: Zum Beispiel siehst du, dass bei allen Blogseiten am Textende ein Block „Lies auch“ mit drei Überschriften klebt.
Überprüfung: Im Ordner clean liegen JSONL-Dateien. Die Anzahl der Datensätze ist nicht kleiner als 80 Prozent der Anzahl roher Seiten. In 10 zufälligen Datensätzen beginnt der Text mit der Überschrift oder dem ersten Absatz des Artikels, nicht mit Menüpunkten, und endet mit dem letzten inhaltlichen Absatz, nicht mit der Signatur „Alle Rechte vorbehalten“.
Mögliche Probleme
- Zu wenig Text wird extrahiert. Die Website hat ein ungewöhnliches Layout. Füge
content_selectorhinzu und einen Fallback überBeautifulSoup. - Im Text bleiben Buttons und Menüpunkte. Aktiviere
favor_precision, und für hartnäckige Fälle füge eine Liste von Stopp-Zeilen hinzu: kurze Zeilen wie „Teilen“, „Weiterlesen“, „Nach oben“ löschen, wenn sie in einer eigenen Zeile stehen. - PDF gibt Text rückwärts oder mit zerrissenen Wörtern aus. Probiere
pdfplumberstattpypdf, es arbeitet besser mit Spalten.
Schritt 5: Müll filtern: Deduplizierung, Templates, Qualität, Sprache
Ziel dieses Schritts: Duplikate, Platzhalter, Template-Blöcke, Texte in fremder Sprache und zu kurze oder kaputte Dokumente aussortieren, sodass nur das bleibt, was Wissen trägt.
Selbst nach sorgfältiger Extraktion bleiben 15 bis 40 Prozent Müll im Korpus. Das ist normal. Unnormal ist, ihn in den Index zu lassen.
Anleitung
- Erstelle die Datei
filter.py, dieclean/*.jsonlliest, die Filter nacheinander anwendet, die durchgelassenen Dokumente incorpus/filtered.jsonlschreibt und die aussortierten incorpus/rejected.jsonlmit Angabe des Grundes. - Filter 1: Mindestlänge. Dokumente kürzer als 300 Zeichen sind fast immer Platzhalter, Ankündigungen oder Extraktionsfehler. Sortiere mit Grund
too_shortaus. Für Produktkarten kann der Schwellenwert auf 150 gesenkt werden. - Filter 2: Stopp-Phrasen für Platzhalter. Erstelle eine Liste von Phrasen, an denen man sieht, dass die Seite leer ist: „Seite nicht gefunden“, „Artikel nicht verfügbar“, „Zugang beschränkt“, „JavaScript aktivieren“, „Wartungsarbeiten“. Wenn eine solche Phrase in den ersten 300 Zeichen vorkommt und der ganze Text kürzer als 1500 ist, sortiere mit Grund
placeholderaus. - Filter 3: Sprache. Verwende
langdetect.detectauf den ersten 1000 Zeichen. Wenn die Sprache nicht mit der in der Quelle angegebenen übereinstimmt, sortiere mit Grundwrong_langaus. Beachte, dass der Detektor bei kurzen Texten Fehler macht, wende ihn daher nach dem Längenfilter an. - Filter 4: exakte Duplikate. Normalisiere den Text: Kleinschreibung, Leerzeichen zusammenfassen, Satzzeichen entfernen. Berechne
sha1. Wenn der Hash schon vorkam, sortiere mit Grundexact_dupaus und speichere einen Verweis auf das Original. Typische Quellen exakter Duplikate: dieselbe Seite unterhttpundhttps, mit und ohnewww, mit Parameter?utm_sourceund ohne, sowie Druckseiten. - Filter 5: Fast-Duplikate. Hier brauchst du MinHash aus der Bibliothek
datasketch. Zerlege den normalisierten Text in Shingles von 5 Wörtern, baueMinHashmit 128 Permutationen, lege ihn inMinHashLSHmit Schwellenwert 0.85. Ein Dokument, das bereits einen ähnlichen Nachbarn im Index hat, sortiere mit Grundnear_dupaus. So verschwinden Versionen eines Artikels mit unterschiedlichen Daten, Produktseiten, die sich nur in der Farbe unterscheiden, und neu veröffentlichte News.
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- Filter 6: Template-Zeilen. Sammle alle Zeilen aller Dokumente einer Quelle und zähle, in welchem Prozentsatz der Dokumente jede vorkommt. Zeilen, die in mehr als 30 Prozent der Dokumente vorkommen und kürzer als 200 Zeichen sind, sind Template: Disclaimer, Signaturen, Aufrufe zum Abonnieren. Lösche sie aus allen Dokumenten. Das ist kein Aussortieren des Dokuments, sondern eine Bereinigung innerhalb.
- Filter 7: Textqualität. Berechne einfache Metriken: Der Anteil an Buchstaben unter allen Zeichen sollte über 0.6 liegen; die durchschnittliche Wortlänge zwischen 3 und 12; der Anteil an Zeilen, die mit einem Punkt enden, über 0.3 für Artikel. Dokumente außerhalb dieser Grenzen sind in der Regel Code-Tabellen, Dumps oder kaputte Extraktionen. Sortiere mit Grund
low_qualityaus, aber schau dir das Aussortierte unbedingt mit eigenen Augen an: Für technische Dokumentation müssen die Schwellenwerte gelockert werden. - Filter 8: abgeschnittene Seiten. Vergleiche
html_lenaus dem Rohdatensatz mit dem Median der Quelle. Wenn das HTML kürzer als 30 Prozent des Medians ist und der Text mitten im Satz ohne Punkt abbricht, ist das eine abgeschnittene Antwort. Grundtruncated. Notiere solche Adressen inrecollect.txtund sammle sie in Schritt 3 über den Proxy neu. - Starte den Filter und untersuche den Bericht. Das Skript sollte eine Tabelle ausgeben: wie viele Dokumente am Eingang, wie viele pro Grund aussortiert, wie viele übrig.
Achtung: Lösche niemals Dateien aus clean und raw während der Filterung. Der Filter schreibt nur neue Dateien. Wenn der MinHash-Schwellenwert zu aggressiv war und du 40 Prozent nützlicher Dokumente verloren hast, änderst du einfach die Zahl und startest das Skript in zwei Minuten neu.
Tipp: Der Schwellenwert 0.85 für Fast-Duplikate ist gut für Artikel und Hilfe. Für Produktkarten einer Marke, die sich nur in Größe oder Volumen unterscheiden, fasst er sie zu einer zusammen. Entscheide vorher, ob dein RAG-System alle Varianten braucht, und hebe entweder den Schwellenwert auf 0.95 oder fasse die Varianten in einem Dokument mit Unterschiedstabelle schon bei der Extraktion zusammen.
Tipp: Aussortierte Dokumente sind kein Abfall, sondern Material zum Debuggen. Öffne einmal pro Woche rejected.jsonl, filtere nach Grund und schau 10 zufällige Datensätze an. Wenn unter low_quality regelmäßig nützliche Tariftabellen auftauchen, müssen die Schwellenwerte angepasst werden.
Überprüfung: Der Filterbericht zeigt ein vernünftiges Bild: Gesamtaussortierung zwischen 10 und 40 Prozent, davon machen Duplikate einen merklichen Anteil aus, und der Grund truncated ergibt nicht mehr als 2-3 Prozent. In der Datei filtered.jsonl gibt es keine zwei Dokumente mit demselben normalisierten Text, und 10 zufällige Datensätze sehen wie abgeschlossene Artikel oder Dokumentationsabschnitte aus.
Mögliche Probleme
- Aussortierung größer als 60 Prozent. Wahrscheinlich sind die Qualitätsschwellen zu streng oder die Normalisierung hat einen Fehler, durch den alle Texte ähnlich wurden. Gib 20 zufällige aussortierte aus und finde die systematische Ursache.
- MinHash arbeitet sehr lange. Bei einem Korpus von mehr als 100.000 Dokumenten reduziere
num_permauf 64 oder zähle pro Quelle separat. - Der Sprachdetektor markiert russische Texte als Bulgarisch oder Mazedonisch. Das passiert bei kurzen Fragmenten mit vielen Eigennamen. Prüfe die Sprache auf den ersten 2000 Zeichen und akzeptiere jede Sprache aus der Gruppe der nahen Sprachen als Übereinstimmung.
Schritt 6: Metadaten auszeichnen und den finalen Korpus zusammenstellen
Ziel dieses Schritts: eine einzige Datei corpus/corpus_v1.jsonl erhalten, in der jedes Dokument eine stabile ID, einen vollständigen Satz Metadaten und die Bereitschaft für die Übergabe an die Indexierungspipeline hat.
Metadaten sind das, was einen Korpus von einem Haufen Text unterscheidet. Sie ermöglichen es, einzelne Quellen zu aktualisieren, dem Nutzer die Herkunft der Antwort zu erklären, nach Datum und Bereich zu filtern und, was am wichtigsten ist, die ganze Arbeit nicht in einem Monat erneut zu machen.
Anleitung
- Definiere das Dokumentenschema. Halte es in der Datei
schema.mdfest und ändere es nicht ohne Version des Korpus. Empfohlenes Minimum:
doc_id: stabile ID, zum Beispielsha1vonfinal_url, damit das Dokument bei Neusammlung dieselbe ID bekommt;source: Name der Quelle aussources.json;urlundfinal_url;title;section: Bereich der Website, berechnet aus dem ersten Pfadsegment nach dem Präfix, zum Beispielhelp/proxies;lang;published_at: Veröffentlichungsdatum, falls extrahiert;fetched_at: Sammeldatum;geo: Region des Proxys, mit dem gesammelt wurde;text;text_len,text_sha1;corpus_version: zum Beispielv1.
- Berechne den Bereich. Parse
final_urlmiturllib.parse.urlparse, nimm den Pfad, entferne das Quellpräfix, behalte ein bis zwei Segmente. Der Bereich wird später zum Filter im RAG-System: Der Nutzer fragt nach Zahlung, die Suche geht vorrangig im Bereichbilling. - Normalisiere die Daten. Bringe alle Daten in ISO 8601 in UTC. Wenn kein Veröffentlichungsdatum gefunden wird, lasse das Feld leer und setze nicht das Sammeldatum ein: Das sind verschiedene Dinge, und sie zu verwechseln ist gefährlich beim Filtern veralteter Materialien.
- Füge die Überschrift in den Text ein. Wenn
textnicht mittitlebeginnt, füge die Überschrift als erste Zeile ein. Die Überschrift trägt Schlüsselwörter, die für die Suche wichtig sind. - Sortiere und schreibe. Sortiere die Dokumente nach
sourceundfinal_url, schreibe incorpus/corpus_v1.jsonl. Lege danebencorpus/manifest_v1.jsonmit der Anzahl der Dokumente pro Quelle, dem Sammeldatum, der Schemaversion und den Filterparametern ab. - Erstelle ein Archiv. Archiviere
corpus,sources.json,schema.mdund den Ordnerlogs. Dieses Archiv ist eine reproduzierbare Version deines Korpus.
Tipp: Halte personenbezogene Daten grundsätzlich außerhalb des Korpus. Wenn in Hilfetexten Beispiele wie „Ivan Petrov, +7 900...“ vorkommen, ersetze sie schon beim Aufbau des Korpus durch Platzhalter. Das RAG-System sollte keine Telefonnummer ausgeben können, selbst wenn sie öffentlich zugänglich war.
Überprüfung: Die Datei corpus_v1.jsonl öffnet sich, jede Zeile ist gültiges JSON mit Feldern aus dem Schema, alle Dokumente haben eine eindeutige doc_id, bei allen sind source, lang, fetched_at, text gefüllt. Die Datei manifest_v1.json enthält eine Zusammenfassung, die mit der Zeilenzahl übereinstimmt.
Mögliche Probleme
- Verschiedene Adressen führen zu einem Dokument und ergeben unterschiedliche doc_id. Berechne die ID von
final_urlnach Weiterleitungen, mit Entfernung der Query-Parameter und des abschließenden Schrägstrichs. - Daten werden in verschiedenen Formaten extrahiert. Verwende
dateutil.parser.parsemit dem Parameterdayfirst=Truefür russischsprachige Quellen.
Ergebnis prüfen: Checkliste und Test des Korpus
Der Korpus ist fertig. Bevor du ihn in die Indexierung gibst, prüfen wir ihn wie ein Produkt, nicht wie eine Datei.
Checkliste
- Es gibt
sources.jsonmit den Grenzen jeder Quelle und den Limits. - Alle Requests liefen über den mobilen Proxy, im Journal hat jeder Request eine
proxy_ip. - Der Anteil an Sammelfehlern laut Journal überschreitet 5 Prozent nicht, 429-Antworten unter 1 Prozent.
- Aus den Rohseiten wurden mindestens 80 Prozent der Dokumente extrahiert.
- Die Aussortierung beim Filtern liegt zwischen 10 und 40 Prozent, alle Aussortierungsgründe sind benannt.
- Im Korpus gibt es keine exakten Duplikate nach normalisiertem Text.
- Bei jedem Dokument sind die Pflichtmetadaten gefüllt.
- Es gibt ein Archiv mit Rohdaten, Korpus, Journalen und Einstellungen.
Wie du testest
- Test mit den Fragen aus Schritt 1. Nimm deine 20-30 Fragen. Suche für jede per einfacher Teilstring-Suche oder über
grepdas Dokument im Korpus, das die Antwort enthält. Ziel: Mindestens 90 Prozent der Fragen sind abgedeckt. Wenn eine Frage nicht abgedeckt ist, finde die Seite mit der Antwort im Browser und kläre, warum sie nicht hineingekommen ist: nicht in der Sitemap, von Filtern aussortiert, Text abgeschnitten. - Test auf Müll. Finde im Korpus die Zeichenfolgen „abonnieren“, „Warenkorb“, „cookie“, „alle Rechte vorbehalten“, „lies auch“. Jedes Vorkommen ist ein Verdacht. Ein paar sind akzeptabel, wenn sie Teil des inhaltlichen Textes sind; Dutzende Vorkommen bedeuten, dass der Template-Filter nachgebessert werden muss.
- Test auf Abbrüche. Zähle die Dokumente, deren Text nicht mit einem Punkt, Ausrufe- oder Fragezeichen und nicht mit einer schließenden Klammer endet. Es sollten weniger als 5 Prozent sein. Den Rest schau dir mit eigenen Augen an.
- Test auf Verteilung. Erstelle ein Histogramm der Dokumentlängen. Ein gesunder Hilfe- oder Blog-Korpus hat einen Peak bei 2-8 Tausend Zeichen und einen langen Schwanz. Ein scharfer Peak nahe der Mindestschwelle deutet auf Platzhalter hin, die durchgerutscht sind.
- Test auf Geografie. Wenn der Inhalt regionsabhängig ist, öffne 5 Seiten mit Preisen oder Verfügbarkeit und vergleiche mit dem, was ein Mensch aus der gewünschten Stadt sieht. Abweichungen bedeuten, dass der Proxy aus einer anderen Region gewählt wurde oder die Website die Region nicht per IP, sondern per Cookie bestimmt.
Erfolgsindikatoren
Der Korpus ist fertig, wenn die Abdeckung der Testfragen über 90 Prozent liegt, der Anteil an Dokumenten mit Müllmerkmalen unter 3 Prozent liegt und das manifest die vollständige Reproduktion der Zusammenstellung erlaubt. Erst danach wird der Korpus an die Indexierungspipeline des RAG-Systems übergeben.
Typische Fehler und Lösungen beim Aufbau eines RAG-Korpus
Problem: In den Antworten des Assistenten erscheinen Menüpunkte und Aufrufe zum Abonnieren. Ursache: Die Textextraktion arbeitete im Recall- statt im Precision-Modus, der Template-Filter lief nicht. Lösung: Aktiviere favor_precision, implementiere das Löschen von Zeilen, die in mehr als 30 Prozent der Dokumente der Quelle vorkommen, und baue clean aus raw neu auf, ohne erneut herunterzuladen.
Problem: Der Assistent antwortet nach einer veralteten Version der Anleitung. Ursache: Im Korpus leben sowohl die alte als auch die neue Version des Artikels, Fast-Duplikate wurden nicht aussortiert oder der Schwellenwert ist zu hoch. Lösung: Senke den MinHash-Schwellenwert auf 0.8 für Quellen mit Versionierung, behalte bei Konflikt das Dokument mit dem späteren published_at.
Problem: Ein Teil der Seiten wurde leer gesammelt, Status 200. Ursache: Der Inhalt wird per JavaScript im Browser aufgebaut. Lösung: Markiere die Quelle mit needs_js und verwende Rendering über Playwright aus dem Fortgeschrittenen-Block, oder finde beim Anbieter eine API oder ein RSS, wo der Inhalt fertig geliefert wird.
Problem: Das Sammeln stoppt bei Fehlern 429 und 503. Ursache: Die Request-Frequenz ist zu hoch, die IP-Rotation wurde anstelle der Lastreduzierung verwendet. Lösung: Reduziere die Frequenz auf 6-8 Requests pro Minute, erhöhe die Zufallsstreuung der Pausen, lege beim ersten 429 eine Pause von 5-10 Minuten ein. Denk daran, dass ein Lastlimit Respekt gegenüber der Quelle bedeutet und nicht eine Frage der Anzahl von Adressen ist.
Problem: Nach der Rotation zeigt die Website Inhalte einer anderen Region. Ursache: Der mobile Proxy hat eine IP aus einer anderen Stadt geliefert, oder die Website hat die Region anhand der Cookies der vorherigen Sitzung bestimmt. Lösung: Fixiere im Proxy-Konto die gewünschte Region, setze die requests-Session nach jeder Rotation zurück, damit keine Cookies übertragen werden.
Problem: Der Korpus ist fertig, aber die Abdeckung der Fragen liegt bei 60 Prozent. Ursache: Die Grenzen der Quellen sind zu eng gesetzt, nützliche Seiten wurden durch Präfixe ausgeschlossen. Lösung: Nimm die nicht abgedeckten Fragen, finde die Antworten im Browser, schau dir ihre Adressen an und erweitere include_prefixes.
Problem: Die Deduplizierung hat Produktkarten mit unterschiedlichen Eigenschaften gefressen. Ursache: Der Fast-Duplikat-Schwellenwert ist zu niedrig für gleichförmige Texte. Lösung: Für Katalogquellen hebe den Schwellenwert auf 0.95 oder fasse die Varianten eines Produkts schon bei der Extraktion in einem Dokument zusammen.
Problem: PDF-Texte kommen als eine einzige Zeile ohne Absätze. Ursache: pypdf verliert die Formatierung. Lösung: Wechsle zu pdfplumber oder pymupdf, stelle Absätze anhand doppelter Zeilenumbrüche und Einrückungen wieder her.
Problem: In den Korpus sind personenbezogene Daten geraten. Ursache: Es gab keinen Schritt zur Anonymisierung. Lösung: Füge vor dem Schreiben in den Korpus eine Suche nach Telefonnummern, E-Mails und Namen über einfache Muster und eine Ersetzung durch Platzhalter hinzu; strittige Dokumente gehen in die manuelle Prüfung.
Zusätzliche Möglichkeiten für Fortgeschrittene
Wenn die Basis-Pipeline funktioniert, hier die nächsten Entwicklungen.
Seiten mit JavaScript über den Proxy rendern
Installiere pip install playwright und playwright install chromium. Starte den Browser mit dem Parameter proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS}. Warte auf den Selektor des Hauptinhalts mit page.wait_for_selector statt fester Sekunden. Hole page.content() und lege es im selben raw-Format ab, damit die weiteren Schritte sich nicht ändern. Das Rendern ist 5-10 Mal langsamer als normale Requests, wende es daher nur auf Quellen mit Flag needs_js an und reduziere die Frequenz auf 3-5 Seiten pro Minute.
Inkrementelle Aktualisierung des Korpus
Speichere im Manifest text_sha1 jedes Dokuments. Beim nächsten Sammeln lädst du die Seiten herunter, extrahierst und filterst aber nur die, bei denen sich der HTML-Hash geändert hat oder mehr als 30 Tage seit dem Sammeln vergangen sind. Verwende die Header If-Modified-Since und ETag: Viele Websites geben 304 ohne Body zurück, und du sparst Proxy-Traffic. Jede Aktualisierung erhält eine neue Korpusversion: v2, v3, und alte Archive werden nicht gelöscht.
Mehrregionen-Korpus
Wenn das Unternehmen Filialen hat und der Inhalt der Quellen von der Stadt abhängt, lege mehrere mobile Proxys mit unterschiedlicher Geografie an. Sammle dieselbe Seite aus jeder Region, speichere geo in den Metadaten und dedupliziere nur innerhalb einer Region. Das RAG-System kann dann antworten „In Kasan Lieferung 2 Tage, in Nowosibirsk 4“, basierend auf echten regionalen Seitenversionen.
Qualitätsbewertung statt harter Schwellenwerte
Statt nach Schwellenwerten auszusortieren, berechne für jedes Dokument eine Qualitätsbewertung von 0 bis 1 aus denselben Metriken: Länge, Buchstabenanteil, Anteil vollständiger Sätze, Wiederholbarkeit von Zeilen. Speichere die Bewertung in den Metadaten. Dann kann die Indexierungspipeline selbst entscheiden, was sie nimmt, und die Suche zuverlässige Dokumente höher ranken.
Semantische Deduplizierung
MinHash fängt lexikalische Duplikate. Umschreibungen derselben Anleitung mit anderen Worten lässt es durch. Um sie zu fangen, berechne Embeddings der Dokumente und suche Paare mit Kosinus-Ähnlichkeit über 0.95. Das ist schon die Grenze zur Indexierung, daher hier nur eine Erwähnung: Entscheide, wo du die Grenze ziehst, und mache dieselbe Arbeit nicht zweimal.
Monitoring des Sammelns
Leite aus dem Journal Metriken ab: Requests pro Minute, Anteil der 200-Codes, durchschnittliche Verzögerung, Anzahl der Rotationen. Ein einfaches Dashboard mit matplotlib oder eine Tabelle im Terminal alle 10 Minuten zeigt eine Verschlechterung früher, als du am Morgen 500 leere Seiten entdeckst.
FAQ: häufige Fragen zum Korpusaufbau
Muss ich für den Korpusaufbau unbedingt einen mobilen Proxy verwenden? Für eigene Dokumente und kleine Quellen nicht unbedingt. Der Proxy wird nötig, wenn es viele Quellen gibt, das Sammeln Stunden dauert, die regionale Version des Inhalts wichtig ist oder du keine auffällige Last auf einer Website von einer Adresse aus erzeugen willst.
Wie oft sollte ich die IP beim Sammeln wechseln? Richtwert: alle 30-60 Requests oder beim Wechsel zu einer anderen Quelle. Häufiger ist nicht nötig: Der Sinn der Rotation liegt in der Lastverteilung und der Stabilität der Sitzung, nicht in der Häufigkeit an sich. Häufige Rotation ohne Senkung des Gesamttempos reduziert die Last nicht.
Wie viele Dokumente braucht ein funktionierendes RAG-System? Für einen Assistenten zu einem Produkt reichen oft 200-500 hochwertige Dokumente. Für eine breite Nische einige Tausend. Qualität ist wichtiger als Umfang: 500 saubere Artikel liefern bessere Antworten als 20.000 mit Müll.
Kann ich soziale Netzwerke und Marktplätze sammeln? Nur offene Seiten im Rahmen der Regeln der Plattform und der robots.txt, ohne personenbezogene Daten. Viele Plattformen haben offizielle APIs für Inhalte, beginne damit.
Was mache ich mit Bildern und Videos? Im Rahmen eines Textkorpus speichere nur Bildunterschriften, Alt-Texte und Transkripte, falls sie auf der Seite vorhanden sind. Die Dateien selbst kommen nicht in den Korpus.
Warum kann ich nicht einfach die ganze Website mit einem Download-Programm herunterladen? Kannst du, aber du bekommst Zehntausende Dateien ohne Metadaten, mit Duplikaten, Service-Seiten und ohne Journal. Dann musst du alle Schritte dieses Leitfadens in umgekehrter Reihenfolge machen, nur schwieriger.
Wie erkenne ich, dass die Filter nicht das Falsche gelöscht haben? Schau dir rejected.jsonl nach jedem Grund an, eine Stichprobe von 10-20 Datensätzen. Und prüfe die Abdeckung der Testfragen: Wenn Antworten fehlen, such sie im Aussortierten.
Muss ich Dokumente in diesem Schritt in Chunks aufteilen? Nein. Die Aufteilung in Fragmente ist Teil der Indexierung und hängt vom Embedding-Modell und der Kontextgröße ab. Die Aufgabe des Korpus ist es, ganze Dokumente mit Metadaten und Überschriftenauszeichnung zu liefern, anhand derer der Chunker sinnvoll schneiden kann.
Wie aktualisiere ich den Korpus, ohne alles neu zu sammeln? Speichere Hashes, verwende bedingte Requests If-Modified-Since, versioniere den Korpus. Mehr dazu im Fortgeschrittenen-Block.
Was mache ich, wenn die Website das automatische Sammeln in robots.txt verbietet? Das Verbot respektieren. Schreib dem Betreiber, oft gibt er einen Export, eine API oder eine Erlaubnis. Ein Korpus, der gegen die Regeln der Quelle gesammelt wurde, schafft Risiken für das ganze Projekt.
Fazit: Was geschafft ist und wie es weitergeht
Du bist den ganzen Weg von der Idee bis zum fertigen Korpus gegangen. Du hast Grenzen definiert und eine Quellenkarte mit Limits und Geografie erstellt. Du hast den mobilen Proxy eingebunden und geprüft, dass die Rotation funktioniert. Du hast einen höflichen Crawler geschrieben, der robots.txt einhält, die Last verteilt und ein detailliertes Journal führt. Du hast reinen Text aus HTML, PDF und DOCX extrahiert. Du hast Duplikate, Platzhalter, Templates und kaputte Seiten mit benannten Gründen aussortiert. Du hast Metadaten ausgezeichnet und einen versionierten Korpus mit Manifest zusammengestellt. Du hast ihn an echten Fragen getestet.
Das Hauptergebnis ist nicht die Datei auf der Festplatte, sondern ein reproduzierbarer Prozess. In einem Monat startest du ihn erneut und bekommst einen aktualisierten Korpus in ein paar Stunden statt in einer Woche. Und wenn das RAG-System anfängt, seltsam zu antworten, weißt du genau, wo du die Ursache suchen musst: im Sammeljournal, im Filterbericht oder im Manifest.
Was als Nächstes zu tun ist. Übergib corpus_v1.jsonl an die Indexierungspipeline: Aufteilung in Fragmente, Embeddings, Vektordatenbank. Dazu in verwandten Blogartikeln mehr. Richte einen regelmäßigen Start des Crawlers nach Zeitplan mit inkrementeller Aktualisierung ein. Erweitere die Quellenkarte, sobald die Zahl der nicht abgedeckten Fragen wächst. Wenn das Unternehmen regional ist, füge Proxys der benötigten Städte hinzu und sammle regionale Versionen des Inhalts.
Wohin du dich entwickeln kannst. Meistere Browser-Rendering für komplexe Websites, Qualitätsbewertung von Dokumenten statt harter Schwellenwerte, semantische Deduplizierung und Monitoring des Sammelns. Jeder dieser Schritte verbessert die Qualität der Antworten stärker als ein Modellwechsel. Saubere Daten sind die günstigste Verbesserung des RAG-Systems, die du hast. Viel Erfolg beim Sammeln.