วิธีรวบรวมคลังข้อมูลสำหรับระบบ RAG ผ่านมือถือพร้อมพร็อกซีโดยไม่เก็บขยะ: คู่มือทีละขั้นตอน
บทความ
- บทนำ: คุณจะได้อะไรและใครควรอ่าน
- การเตรียมการเบื้องต้น: เครื่องมือ สิทธิ์การเข้าถึง สภาพแวดล้อม
- แนวคิดพื้นฐานที่อธิบายอย่างง่าย
- ขั้นตอนที่ 1: กำหนดขอบเขตของคลังข้อมูลและสร้างแผนที่แหล่งข้อมูล
- ขั้นตอนที่ 2: เชื่อมต่อพร็อกซีมือถือและตรวจสอบว่าคำขอวิ่งผ่านมัน
- ขั้นตอนที่ 3: เขียนตัวเก็บข้อมูลที่แม่นยำพร้อมขีดจำกัด การหมุน และบันทึก
- ขั้นตอนที่ 4: แยกข้อความสะอาดจาก html และเอกสาร
- ขั้นตอนที่ 5: กรองขยะ: การลบข้อมูลซ้ำ เทมเพลต คุณภาพ ภาษา
- ขั้นตอนที่ 6: ติดป้าย metadata และรวบรวมคลังข้อมูลสุดท้าย
- ตรวจสอบผลลัพธ์: รายการตรวจสอบและทดสอบคลังข้อมูล
- ข้อผิดพลาดทั่วไปและวิธีแก้ไขเมื่อรวบรวมคลังข้อมูลสำหรับ rag
- ความสามารถเพิ่มเติมสำหรับผู้เชี่ยวชาญ
- Faq: คำถามที่พบบ่อยเกี่ยวกับการรวบรวมคลังข้อมูล
- บทสรุป: สิ่งที่ทำและจะไปต่อที่ไหน
บทนำ: คุณจะได้อะไรและใครควรอ่าน
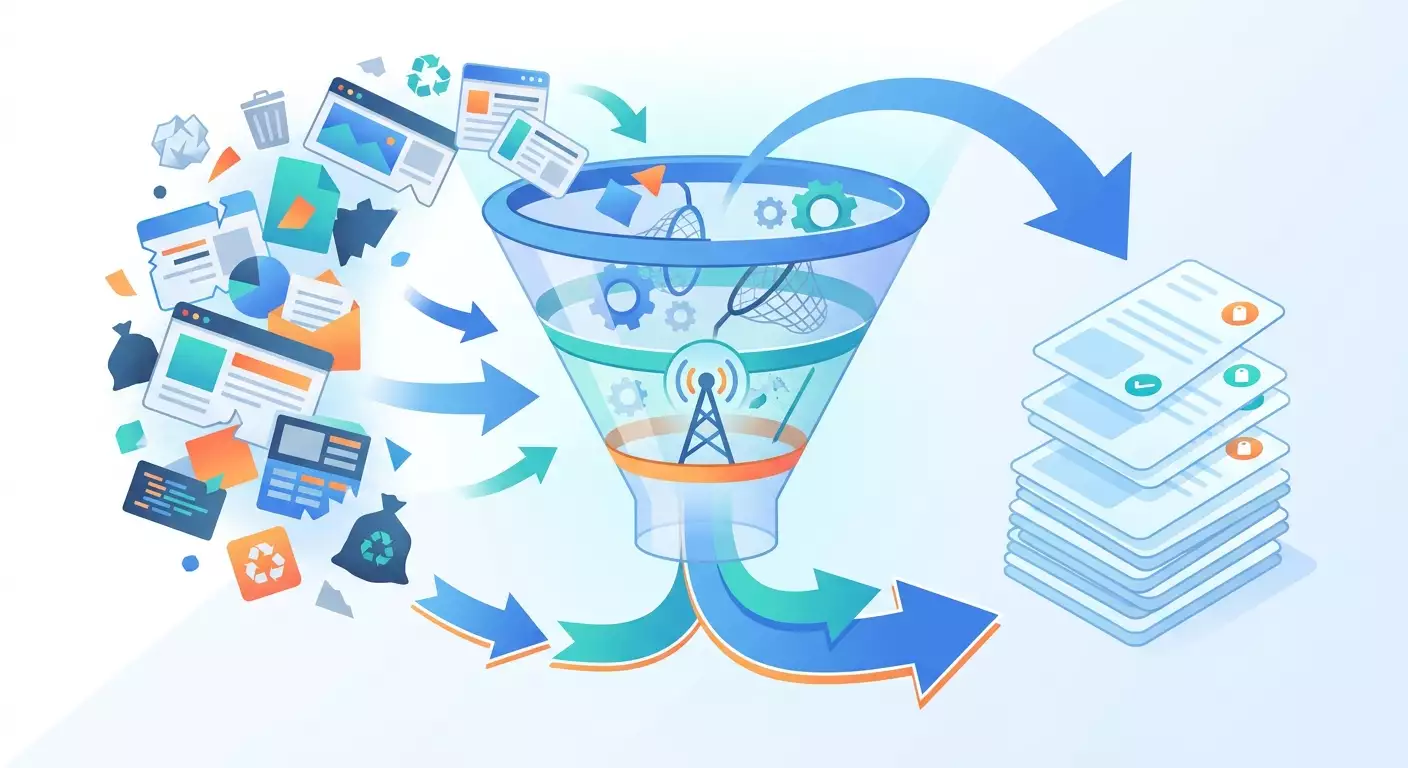
ระบบ RAG จะดีได้ก็ต่อเมื่อคลังข้อมูลที่มันใช้อ้างอิงดีพอ คุณอาจใช้โมเดลภาษาที่แข็งแกร่งที่สุด เชื่อมต่อฐานข้อมูลเวกเตอร์ราคาแพง แต่ผลลัพธ์ที่ได้กลับเป็นเรื่องเหลวไหลอย่างมั่นใจ ถ้าในคลังข้อมูลมีเมนูเว็บไซต์ ฟุตเตอร์ที่มีลิขสิทธิ์ บทความเดียวกันซ้ำห้าฉบับ และหน้าเว็บ "สินค้าหมดชั่วคราว" โมเดลไม่สามารถแยกแยะขยะออกจากความรู้ได้ มันแค่ค้นหาส่วนที่คล้ายกันและประกอบคำตอบขึ้นมา
คู่มือทีละขั้นตอนนี้มุ่งเน้นเพียงขั้นตอนเดียว: การรวบรวมคลังข้อมูล เราจะไม่พูดถึงโครงสร้างของฐานข้อมูลเวกเตอร์ การเลือก embedding หรือการกำหนดค่า chunk เพราะมีเนื้อหาแยกต่างหากในบล็อกแล้ว ที่นี่เราจะหยุดตรงขอบเขตพอดี: คุณมีชุดเอกสารที่สะอาด มีการติดป้ายกำกับ ลบข้อมูลซ้ำแล้ว ในรูปแบบ JSONL บนดิสก์ของคุณ ซึ่งพร้อมส่งให้ไปป์ไลน์การทำดัชนีใดก็ได้
สิ่งที่คุณจะได้รับในที่สุด:
- รายการแหล่งข้อมูลที่มีขอบเขตชัดเจน: เก็บอะไร ไม่เก็บอะไร
- ตัวเก็บข้อมูลที่ใช้งานได้บน Python ซึ่งวิ่งผ่านพร็อกซีมือถือ เคารพขีดจำกัด และไม่ทำให้เว็บไซต์ของคนอื่นล่ม
- โฟลเดอร์ที่มีหน้าเว็บและเอกสารดิบ แต่ละชิ้นมี metadata
- สคริปต์สำหรับแยกข้อความหลักโดยไม่มีเมนู โฆษณา และบล็อกเทมเพลต
- ตัวกรองคุณภาพและการลบข้อมูลซ้ำ ที่จะกำจัดขยะก่อนที่มันจะเข้าสู่ดัชนี
- ไฟล์คลังข้อมูลสุดท้ายและรายงานที่มีตัวเลข ซึ่งแสดงให้เห็นว่าทุกอย่างทำอย่างถูกต้อง
คู่มือนี้สำหรับใคร สำหรับนักการตลาดและเจ้าของธุรกิจที่ต้องการรวบรวมฐานความรู้ในสายงานของตนและสร้างผู้ช่วยบนพื้นฐานนั้น สำหรับนักทำ arbitrage ที่ต้องการคลังข้อมูลเกี่ยวกับข้อเสนอหน้า landing page และกฎของแพลตฟอร์มโฆษณา สำหรับนักพัฒนาที่เคยเชื่อมต่อพร็อกซีกับสคริปต์และตอนนี้ต้องการทำอย่างระมัดระวังและเป็นระบบ เนื้อหาหลักเขียนสำหรับผู้เริ่มต้น และตอนท้ายมีบล็อกแยกสำหรับผู้เชี่ยวชาญ
สิ่งที่ต้องรู้ล่วงหน้า สามารถรันคำสั่งใน terminal และเปิดไฟล์ในโปรแกรมแก้ไขข้อความได้ มีความเข้าใจพื้นฐานเกี่ยวกับ Python ในระดับ "เข้าใจว่า loop for ทำอะไร" และสามารถเข้าถึงพร็อกซีมือถือได้: ที่อยู่ พอร์ต ชื่อผู้ใช้ รหัสผ่าน และลิงก์เปลี่ยน IP
ต้องใช้เวลานานแค่ไหน การเตรียมสภาพแวดล้อมประมาณ 30 นาที การทำตามทุกขั้นตอนใช้เวลา 3 ถึง 5 ชั่วโมง ขึ้นอยู่กับขนาดของคลังข้อมูล การเก็บข้อมูลหลายพันหน้าเองอาจใช้เวลาหลายชั่วโมงในเบื้องหลัง แต่คุณไม่จำเป็นต้องอยู่ดูแลในระหว่างนั้น
การเตรียมการเบื้องต้น: เครื่องมือ สิทธิ์การเข้าถึง สภาพแวดล้อม
ก่อนจะเขียนโค้ดบรรทัดแรก มาจัดระเบียบพื้นที่ทำงานกันก่อน ซึ่งจะประหยัดเวลาการดีบักในภายหลังได้หลายชั่วโมง
ข้อกำหนดของระบบ
- คอมพิวเตอร์หรือเซิร์ฟเวอร์ที่ใช้ Windows 10/11, macOS หรือ Linux สำหรับการเก็บข้อมูลหลายหมื่นหน้า การใช้ VPS เช่าเหมาะสมกว่า แต่สำหรับคลังข้อมูลแรกแล็ปท็อปก็เพียงพอ
- หน่วยความจำอย่างน้อย 8 GB การลบข้อมูลซ้ำในคลังขนาดใหญ่กินหน่วยความจำมาก
- พื้นที่ดิสก์ว่าง: อย่างน้อย 5 GB HTML ดิบใช้พื้นที่มากกว่าข้อความสะอาด 5-10 เท่า และเราจะเก็บทั้งสองอย่าง
- อินเทอร์เน็ตที่เสถียร พร็อกซีเพิ่มความหน่วง ดังนั้นช่องทางบ้านที่ช้าจะทำให้การเก็บข้อมูลยืดเยื้ออย่างชัดเจน
สิ่งที่ต้องติดตั้ง
- Python 3.11 หรือใหม่กว่า ดาวน์โหลดตัวติดตั้งจากเว็บไซต์ทางการ เมื่อติดตั้งบน Windows ให้ติ๊กถูกที่ "Add Python to PATH" ตรวจสอบใน terminal:
python --versionควรแสดงบรรทัดเช่นPython 3.12.x - สภาพแวดล้อมเสมือน สร้างโฟลเดอร์โปรเจกต์ เช่น
rag-corpusเข้าไปในโฟลเดอร์และรันpython -m venv venvเปิดใช้งาน: บน Windowsvenv\Scripts\activateบน macOS และ Linuxsource venv/bin/activateที่ต้นบรรทัด terminal จะปรากฏ(venv) - ไลบรารี ติดตั้งด้วยคำสั่งเดียว:
pip install requests trafilatura pypdf python-docx langdetect datasketch tqdmการติดตั้งใช้เวลา 1-3 นาที - โปรแกรมแก้ไขข้อความ ที่มี syntax highlighting: VS Code, PyCharm Community หรืออื่น ๆ
สิทธิ์การเข้าถึงพร็อกซี
เปิดแดชบอร์ดของบริการพร็อกซีของคุณ ในบัตรของพร็อกซีมือถือที่ซื้อมา หาค่าสี่อย่าง: โฮสต์ (ที่อยู่ IP หรือชื่อโดเมน) พอร์ต สำหรับ HTTP และพอร์ตสำหรับ SOCKS5 ชื่อผู้ใช้ และ รหัสผ่าน แยกคัดลอก ลิงก์เปลี่ยน IP: เป็น URL ที่เพียงส่งคำขอ GET เพื่อให้พร็อกซีขอที่อยู่ใหม่จากผู้ให้บริการ บันทึกทั้งหมดนี้ในไฟล์ .env ในโฟลเดอร์โปรเจกต์ ไม่ใช่ในโค้ดโดยตรง
โครงสร้างโฟลเดอร์
สร้างโฟลเดอร์ต่อไปนี้ในโปรเจกต์: raw สำหรับหน้าเว็บดิบ clean สำหรับข้อความที่แยกออกมา corpus สำหรับไฟล์สุดท้าย logs สำหรับบันทึก โฟลเดอร์ว่างตอนเริ่มต้นเป็นเรื่องปกติ
การสำรองข้อมูล
การรวบรวมคลังข้อมูลใช้เวลานาน และการสูญเสียมันเป็นเรื่องน่าเสียดาย ตกลงกับตัวเองเป็นกฎ: โฟลเดอร์ raw ไม่เคยถูกเขียนทับ เพียงเพิ่มเติมเท่านั้น หลังแต่ละขั้นตอนสำคัญ ให้เก็บสำรองผลลัพธ์: tar -czf raw_backup_2026-03-01.tar.gz raw/ บน Linux และ macOS หรือใช้โปรแกรมบีบอัดในตัวของ Windows ถ้าคุณตั้งค่าตัวกรองผิดและลบสิ่งที่ไม่ควรลบ คุณสามารถกลับไปยังข้อมูลดิบได้เสมอโดยไม่ต้องเก็บใหม่
คำแนะนำ: สร้างไฟล์ sources.md ตั้งแต่แรกและบันทึกทุกการตัดสินใจ: เลือกเว็บไซต์ใด ยกเว้นส่วนใด เพราะเหตุใด อีกหนึ่งเดือนเมื่อผู้ช่วยเริ่มตอบแปลก ๆ ไฟล์นี้จะช่วยคุณได้ทั้งเย็น
แนวคิดพื้นฐานที่อธิบายอย่างง่าย
ถ้าคุณรวบรวมข้อมูลสำหรับระบบ RAG เป็นครั้งแรก มีคำศัพท์หลายคำที่จะพบในทุกขั้นตอน มาอธิบายสั้น ๆ
RAG คืออะไรและทำไมคลังข้อมูลจึงสำคัญกว่าโมเดล
RAG (Retrieval-Augmented Generation) เป็นวิธีการที่โมเดลภาษาก่อนตอบจะได้รับชุดข้อความที่เกี่ยวข้องจากฐานความรู้ของคุณ โมเดลไม่ได้ "รู้" เอกสารของคุณ มันอ่านส่วนที่ค้นพบและตอบตามนั้น ดังนั้นกฎง่าย ๆ คือ: ถ้าในฐานข้อมูลมีขยะ ไม่ช้าก็เร็วการค้นหาจะดึงขยะนั้นออกมา และคำตอบจะอ้างอิงบรรทัด "สมัครรับจดหมายข่าว" แทนที่จะเป็นคำแนะนำ ดังนั้นขั้นตอนการรวบรวมคลังข้อมูลจึงข้ามไม่ได้
คลังข้อมูล เอกสาร metadata
คลังข้อมูล คือชุดข้อความทั้งหมดที่จะเข้าสู่ระบบ RAG เอกสาร คือหน่วยความหมายหนึ่งหน่วย: บทความ หน้าช่วยเหลือ คู่มือ PDF การ์ดสินค้า Metadata คือหนังสือเดินทางของเอกสาร: มาจากไหน เก็บเมื่อไหร่ ภาษาใด ใครเป็นผู้เขียน อยู่ในส่วนใด หากไม่มี metadata คุณจะไม่สามารถอัปเดตคลัง อธิบายที่มาของคำตอบแก่ผู้ใช้ หรือกรองสิ่งล้าสมัยได้
พร็อกซีมือถือและเหตุใดจึงใช้ในการรวบรวมข้อมูล
พร็อกซีมือถือ คือเซิร์ฟเวอร์ตัวกลางที่ส่งคำขอของคุณออกสู่อินเทอร์เน็ตผ่านที่อยู่ IP ของผู้ให้บริการมือถือ สำหรับการรวบรวมคลังข้อมูล มันแก้ปัญหาปฏิบัติได้สามประการ ประการแรก: การกระจายโหลด แทนที่จะยิงไปที่เว็บไซต์จากที่อยู่เดียว คุณวิ่งจากที่อยู่ต่าง ๆ และแต่ละแหล่งเห็นทราฟฟิกที่เงียบและหายาก ประการที่สอง: ภูมิศาสตร์ หลายเว็บไซต์แสดงเนื้อหา ราคา และสต็อกที่แตกต่างกันตามภูมิภาค และพร็อกซีมือถือของเมืองที่ต้องการให้เวอร์ชันของหน้าที่ลูกค้าของคุณเห็น ประการที่สาม: ความเสถียรของเซสชันยาว การหมุน IP ผ่านลิงก์ช่วยให้เก็บข้อมูลต่อได้หลายชั่วโมงโดยไม่ขึ้นกับที่อยู่เดียว
การหมุน คือการเปลี่ยนที่อยู่ IP มีทั้งแบบตามกำหนดการ (ทุก N นาที) และแบบตามคำขอ (คุณดึงลิงก์เมื่อต้องการ) ในการรวบรวมคลังข้อมูลแบบที่สองสะดวกกว่า: เปลี่ยนแหล่ง เปลี่ยนที่อยู่
อะไรถือว่าเป็นขยะ
ในบริบทของคลังข้อมูล ขยะคือทุกสิ่งที่ไม่มีความรู้เกี่ยวกับหัวข้อของคุณ แต่กินที่ในดัชนีและทำให้การค้นหาแย่ลง:
- เมนูนำทาง ฟุตเตอร์ "breadcrumbs" แบบฟอร์มสมัครสมาชิก
- ข้อมูลซ้ำที่เหมือนกันหรือเกือบเหมือนกันของข้อความเดียวกันในที่อยู่ต่าง ๆ
- หน้าตัวแทน: "ไม่พบหน้าเว็บ" "สินค้าหมด" "อยู่ระหว่างการบำรุงรักษา"
- ข้อความในภาษาอื่น หากคลังเป็นภาษาเดียว
- หน้าที่ถูกตัดขาด ซึ่งพร็อกซีหรือเว็บไซต์ส่ง HTML มาแค่ครึ่งเดียว
- เนื้อหาของผู้อื่นที่คุณไม่มีสิทธิ์ใช้
กรอบทางกฎหมาย
เก็บเฉพาะข้อมูลเปิดที่เข้าถึงได้โดยไม่ต้องล็อกอินและเอกสารของคุณเอง เคารพไฟล์ robots.txt: เป็นรายการกฎของเว็บไซต์ว่าส่วนใดสามารถเข้าชมโดยอัตโนมัติได้ อย่าเก็บข้อมูลส่วนบุคคลของบุคคลที่สาม: ชื่อพร้อมเบอร์โทร ที่อยู่ บัญชี หากคุณสร้างคลังจากเอกสารภายในของตัวเอง ให้แน่ใจว่าคุณมีสิทธิ์ใช้ พร็อกซีในคู่มือนี้ใช้เป็นเครื่องมือสำหรับการเก็บข้อมูลแบบกระจายอย่างซื่อสัตย์ ไม่ใช่เป็นวิธีทำสิ่งที่แหล่งข้อมูลห้าม
ขั้นตอนที่ 1: กำหนดขอบเขตของคลังข้อมูลและสร้างแผนที่แหล่งข้อมูล
เป้าหมายของขั้นตอนนี้: ได้ไฟล์ที่มีรายการแหล่งข้อมูล ซึ่งแต่ละแหล่งระบุว่า URL ใดเก็บ ใดยกเว้น ความลึกในการเข้าชม และจำนวนคำขอต่อนาทีที่อนุญาต
สาเหตุที่พบบ่อยที่สุดของคลังข้อมูลขยะไม่ใช่ข้อผิดพลาดทางเทคนิค แต่เป็นการขาดขอบเขต คนรันตัวเก็บข้อมูล "ทั้งเว็บไซต์" ได้ 40,000 หน้า ซึ่งในหัวข้อมีเพียง 800 หน้า และต้องทำความสะอาดเป็นอาทิตย์ มาทำตรงกันข้าม: แผนที่ก่อน แล้วจึงเก็บ
คำแนะนำ
- กำหนดคำถามที่ระบบ RAG ของคุณต้องตอบ เขียนคำถามจริงของผู้ใช้ 20-30 ข้อ ตัวอย่างเช่น สำหรับฐานความรู้ของบริการพร็อกซี: "วิธีเปลี่ยน IP ผ่านลิงก์" "ทำไมพร็อกซีตอบช้า" "พอร์ตใดรองรับ" คำถามเหล่านี้จะเป็นชุดทดสอบของคุณในขั้นตอนการตรวจสอบ
- สำหรับแต่ละคำถาม บันทึกว่าคำตอบอยู่ที่ไหน ส่วนช่วยเหลือ เอกสาร บทความบล็อก ระเบียบ PDF หน้าสินค้า ทุกสิ่งที่ไม่ในรายการนี้ไม่เข้าคลังข้อมูล
- เปิดแต่ละแหล่งในเบราว์เซอร์และศึกษาโครงสร้างที่อยู่ ปกติเนื้อหาที่มีประโยชน์อยู่ที่ prefix ที่ชัดเจน:
/help/,/docs/,/blog/,/faq/และขยะอยู่ที่อื่น:/tag/,/search?,/cart/,/author/หน้า pagination เช่น?page= - ตรวจสอบ robots.txt ของแหล่งข้อมูล เปิด
https://โดเมน/robots.txtหาบรรทัดDisallow: เส้นทางเหล่านี้ยกเว้นโดยไม่ต้องถกเถียง หากมีการระบุCrawl-delayให้บันทึกเป็นเวลาหยุดขั้นต่ำระหว่างคำขอ - หา sitemap มักระบุใน robots.txt ที่บรรทัด
Sitemap:หรืออยู่ที่/sitemap.xmlSitemap คือรายการที่อยู่พร้อมใช้ ซึ่งจะช่วยให้คุณไม่ต้องเข้าชมลิงก์แบบเรียกซ้ำและขยะที่เกี่ยวข้อง - กำหนดโหลด สำหรับเว็บไซต์เล็ก ตั้งค่าไม่เกิน 10-15 คำขอต่อนาที สำหรับพอร์ทัลขนาดใหญ่ที่มี CDN อนุญาตได้ถึง 30 หากไม่แน่ใจ ให้ใช้น้อยกว่า: คลังข้อมูลไม่เร่งด่วน
- กำหนดภูมิศาสตร์ หากเนื้อหาขึ้นกับภูมิภาค (ราคา การจัดส่ง สต็อก) ตัดสินใจว่าตัวเก็บข้อมูลควร "มอง" จากเมืองใด และเลือกพร็อกซีมือถือที่เหมาะสม
- จัดทำทั้งหมดในไฟล์
sources.json
ตัวอย่างรายการสำหรับแหล่งเดียว:
[ {'name': 'help_center','sitemap': 'https://example.ru/sitemap.xml','include_prefixes': ['https://example.ru/help/', 'https://example.ru/docs/'],'exclude_patterns': ['/tag/', '/search', '?page=', '/print/'],'rate_per_minute': 12,'geo': 'RU-MOW','lang': 'ru','rotate_every': 40 }]ฟิลด์ rotate_every กำหนดว่าหลังจากกี่คำขอ ตัวเก็บข้อมูลจะดึงลิงก์เปลี่ยน IP แทนที่เครื่องหมายคำพูดเดี่ยวด้วยคู่เมื่อบันทึกเป็นไฟล์ JSON จริง ที่นี่แสดงเพื่อความชัดเจน
ข้อควรระวัง: อย่าเพิ่มเว็บไซต์ที่เนื้อหาที่มีประโยชน์มองเห็นได้เฉพาะหลังล็อกอินเข้าบัญชี ประการแรก มันละเมิดข้อตกลงผู้ใช้ของแพลตฟอร์มส่วนใหญ่ ประการที่สอง คลังข้อมูลเช่นนั้นไม่สามารถอัปเดตและเผยแพร่ภายในบริษัทได้อย่างถูกกฎหมาย
คำแนะนำ: สร้างแหล่งแยกสำหรับเอกสารของคุณเอง: โฟลเดอร์ที่มี PDF, DOCX และการส่งออกจาก CRM หรือฐานความรู้ของคุณ ไม่ต้องดาวน์โหลดผ่านพร็อกซี แต่ประมวลผลและทำความสะอาดด้วยไปป์ไลน์เดียวกับหน้าเว็บ
การตรวจสอบ: คุณมีไฟล์ sources.json ซึ่งแต่ละแหล่งมี prefix ที่รวม pattern ที่ยกเว้น ขีดจำกัดคำขอ และภาษา เปิด 5 ที่อยู่สุ่มจาก sitemap ที่ตรงกับตัวกรองและตรวจสอบว่าแต่ละที่มีข้อความที่มีเนื้อหา ไม่ใช่แค่แค็ตตาล็อกลิงก์
ปัญหาที่อาจเกิดขึ้น
- เว็บไซต์ไม่มี sitemap รวบรวมรายการที่อยู่จากหน้าสารบัญหลายหน้าด้วยมือ หรือผ่านการเข้าชมลิงก์อย่างง่ายเฉพาะภายใน prefix ที่อนุญาตที่ความลึก 2
- Sitemap มี 100,000 ที่อยู่ กรองตาม prefix จากนั้นเลือกตัวอย่าง 200 ที่อยู่ เก็บและประเมินคุณภาพก่อนรันทั้งหมด
- เนื้อหาที่มีประโยชน์กระจายอยู่ตามโดเมนต่าง ๆ สร้างบันทึกแยกใน
sources.jsonสำหรับแต่ละโดเมน พร้อมขีดจำกัดและภูมิศาสตร์ของตัวเอง
ขั้นตอนที่ 2: เชื่อมต่อพร็อกซีมือถือและตรวจสอบว่าคำขอวิ่งผ่านมัน
เป้าหมายของขั้นตอนนี้: ตรวจสอบให้แน่ใจว่าสคริปต์วิ่งผ่านพร็อกซีมือถือจริง การหมุนทำงาน และความหน่วงยอมรับได้สำหรับการเก็บข้อมูล
คำแนะนำ
- สร้างไฟล์
.envในรากของโปรเจกต์และป้อนค่าจากแดชบอร์ด:
PROXY_HOST=proxy.example.net PROXY_PORT=10000 PROXY_USER=your_login PROXY_PASS=your_password ROTATE_URL=https://changeip.example.net/?proxy_key=xxxxxxxxแต่ละค่าอยู่บรรทัดแยกกัน เพิ่ม .env ใน .gitignore หากใช้ระบบควบคุมเวอร์ชัน
- สร้างไฟล์
proxy_check.pyด้วยเนื้อหาต่อไปนี้:
import os, time, requests from dotenv import load_dotenv load_dotenv() host = os.getenv('PROXY_HOST') port = os.getenv('PROXY_PORT') user = os.getenv('PROXY_USER') pwd = os.getenv('PROXY_PASS') rotate_url = os.getenv('ROTATE_URL') proxy_url = 'http://' + user + ':' + pwd + '@' + host + ':' + port PROXIES = {'http': proxy_url, 'https': proxy_url} def my_ip(): r = requests.get('https://api.ipify.org?format=json', proxies=PROXIES, timeout=30) return r.json()['ip'] print('IP без прокси:', requests.get('https://api.ipify.org?format=json', timeout=30).json()['ip']) t0 = time.time() ip1 = my_ip() print('IP через прокси:', ip1, 'за', round(time.time() - t0, 2), 'сек') print('Меняем IP...') requests.get(rotate_url, timeout=60) time.sleep(8) ip2 = my_ip() print('IP после ротации:', ip2) print('Ротация сработала:', ip1 != ip2)ติดตั้ง pip install python-dotenv ก่อน บรรทัดโค้ดในไฟล์จริงอยู่บรรทัดละบรรทัด
- รัน:
python proxy_check.py - อ่านผลลัพธ์ IP แรกควรเป็นที่อยู่บ้านหรือเซิร์ฟเวอร์ของคุณ IP ที่สองควรแตกต่างและเป็นของผู้ให้บริการมือถือ IP ที่สามควรแตกต่างจากที่สอง และบรรทัดสุดท้ายแสดง
True - วัดความหน่วง หากคำขอผ่านพร็อกซีใช้เวลามากกว่า 5-6 วินาที การเก็บข้อมูลจะช้า ตรวจสอบว่าพร็อกซีที่เลือกอยู่ใกล้กับเว็บไซต์เป้าหมายทางภูมิศาสตร์ หรือติดต่อฝ่ายสนับสนุนบริการ
- ลอง SOCKS5 เป็นทางเลือก หากพอร์ต HTTP ให้ผลลัพธ์ไม่เสถียร เปลี่ยน
http://ในproxy_urlเป็นsocks5h://และเปลี่ยนพอร์ตเป็นพอร์ต SOCKS5 จากแดชบอร์ด ต้องใช้pip install requests[socks]ส่วนต่อท้ายhสำคัญ: มันบังคับให้พร็อกซีแก้ไขชื่อโดเมนด้วยตัวเอง
ข้อควรระวัง: อย่ารันการหมุน IP บ่อยกว่าที่แพ็กเกจของคุณอนุญาต พร็อกซีมือถือส่วนใหญ่มีช่วงเวลาขั้นต่ำระหว่างการเปลี่ยน โดยปกติตั้งแต่ 30 วินาทีถึง 2 นาที คำขอที่บ่อยเกินไปไปยังลิงก์หมุนจะถูกละเลยหรือบล็อกฟังก์ชันชั่วคราว
คำแนะนำ: วัดความหน่วงห้าครั้งติดต่อกันและบันทึกค่ามัธยฐาน ตัวเลขนี้จะใช้ในขั้นตอนถัดไปเพื่อตั้ง timeout อย่างถูกต้อง: timeout ควรประมาณ 4-5 เท่าของความหน่วงทั่วไป
การตรวจสอบ: สคริปต์แสดงที่อยู่ IP สามที่อยู่ที่แตกต่างกัน บรรทัด Ротация сработала: True และความหน่วงทั่วไปผ่านพร็อกซีไม่เกิน 3-4 วินาที หากเป็นเช่นนั้น พร็อกซีพร้อมใช้งาน
ปัญหาที่อาจเกิดขึ้น
- ข้อผิดพลาด 407 Proxy Authentication Required ตรวจสอบชื่อผู้ใช้และรหัสผ่าน ตรวจสอบว่าไม่มีช่องว่างเกิน หากในรหัสผ่านมีอักขระ
@หรือ:เข้ารหัสผ่านurllib.parse.quote - ข้อผิดพลาด Connection refused หรือ timeout พร็อกซีอาจผูกกับ IP สีขาวของคุณ เข้าแดชบอร์ดและเพิ่มที่อยู่เซิร์ฟเวอร์ปัจจุบันในรายการที่อนุญาต หรือเปลี่ยนเป็นการยืนยันตัวตนด้วยชื่อผู้ใช้และรหัสผ่าน
- IP หลังการหมุนไม่เปลี่ยน เพิ่มเวลาหยุดหลังจากคำขอไปยังลิงก์หมุนเป็น 15-20 วินาที ผู้ให้บริการบางรายออกที่อยู่ใหม่ไม่ทันที
- ข้อผิดพลาด SSL อัปเดตไลบรารี
certifiด้วยคำสั่งpip install -U certifiอย่าปิดการตรวจสอบใบรับรองด้วยพารามิเตอร์verify=False: ไม่ปลอดภัย
ขั้นตอนที่ 3: เขียนตัวเก็บข้อมูลที่แม่นยำพร้อมขีดจำกัด การหมุน และบันทึก
เป้าหมายของขั้นตอนนี้: ได้สคริปต์ที่ผ่านที่อยู่จาก sitemap เคารพ robots.txt และขีดจำกัด วิ่งผ่านพร็อกซี เปลี่ยน IP ตามกำหนดการ บันทึก HTML ดิบและเก็บบันทึกที่แสดงทุกคำขอ
ที่นี่สิ่งสำคัญคือต้องเข้าใจปรัชญา ตัวเก็บข้อมูลที่ดีสำหรับระบบ RAG นั้นเชื่องช้า สุภาพ และละเอียดถี่ถ้วนอย่างหวาดระแวงในบันทึก ครอว์เลอร์ที่รวดเร็วและก้าวร้าวจะเก็บหน้าที่ถูกตัดและข้อผิดพลาด 429 ให้คุณ และคุณจะไม่เข้าใจว่าอะไรคือขยะ
คำแนะนำ
- สร้างไฟล์
fetch.pyโครงสร้างสคริปต์: โหลดการตั้งค่า แยก sitemap กรองที่อยู่ ลูปคำขอพร้อมเวลาหยุด บันทึกผลลัพธ์ - โหลด sitemap และกรองที่อยู่ Sitemap เป็น XML ที่แต่ละที่อยู่ในแท็ก
locแยกด้วยxml.etree.ElementTreeมาตรฐาน เก็บเฉพาะที่อยู่ที่เริ่มต้นด้วยinclude_prefixesและไม่มีexclude_patternsใด บันทึกผลลัพธ์ในurls_help_center.txtและดูด้วยตา - เชื่อมต่อการตรวจสอบ robots.txt ใช้
urllib.robotparser.RobotFileParser: โหลดไฟล์ครั้งเดียวต่อโดเมนและก่อนทุกคำขอถามcan_fetch(user_agent, url)ที่อยู่ที่ห้ามให้ข้ามและเขียนในบันทึกด้วยหมายเหตุrobots_disallow - ตั้ง User-Agent ที่ซื่อสัตย์ ตัวอย่าง:
CorpusCollector/1.0 (+contact: data@yourcompany.ru)เจ้าของเว็บไซต์ควรเข้าใจว่าใครมาและติดต่อได้อย่างไร นี่ไม่ใช่แค่จริยธรรม แต่เป็นปฏิบัติ: agent ที่ชัดเจนมักถูกจำกัดโดยอัตโนมัติน้อยกว่า - ใช้เวลาหยุด จาก
rate_per_minuteคำนวณเวลาหยุดพื้นฐาน:60 / rate_per_minuteวินาที เพิ่มองค์ประกอบสุ่ม 20-40 เปอร์เซ็นต์ เพื่อให้คำขอไม่วิ่งตามเมโทรนอม หากใน robots.txt มีCrawl-delayให้ใช้ค่ามากกว่าของสองค่า - ใช้การหมุน นับคำขอ และเมื่อตัวนับถึง
rotate_everyเรียกลิงก์เปลี่ยน IP รอ 10 วินาที รีเซ็ตตัวนับ การหมุนควรทำเมื่อเปลี่ยนไปยังแหล่งถัดไปด้วย - จัดการการตอบสนอง รหัส 200 บันทึก รหัส 301 และ 302
requestsจัดการเอง แต่บันทึกที่อยู่สุดท้าย: จำเป็นสำหรับการลบข้อมูลซ้ำ รหัส 404 เขียนในบันทึกและข้าม รหัส 429 หรือ 503 หมายถึง "บ่อยเกินไป": หยุด 5 นาที เพิ่มเวลาหยุดพื้นฐานหนึ่งเท่าครึ่ง และลองซ้ำหนึ่งครั้ง หากลองซ้ำไม่ช่วย ให้ข้ามและไปต่อ - บันทึก HTML ดิบพร้อมหนังสือเดินทาง สำหรับแต่ละหน้า บันทึกหนึ่งบรรทัดในไฟล์
raw/help_center.jsonl
ส่วนสำคัญของโค้ดสำหรับบันทึกและลูป:
import json, time, random, hashlib from datetime import datetime, timezone def save_raw(path, url, final_url, status, html, proxy_ip): rec = { 'url': url, 'final_url': final_url, 'status': status, 'fetched_at': datetime.now(timezone.utc).isoformat(), 'proxy_ip': proxy_ip, 'html_len': len(html), 'html_sha1': hashlib.sha1(html.encode('utf-8', 'ignore')).hexdigest(), 'html': html } with open(path, 'a', encoding='utf-8') as f: f.write(json.dumps(rec, ensure_ascii=False) + chr(10)) def fetch_one(session, url, proxies, headers, timeout): r = session.get(url, proxies=proxies, headers=headers, timeout=timeout, allow_redirects=True) return r.status_code, r.url, r.text for i, url in enumerate(urls): if not rp.can_fetch(UA, url): log('robots_disallow', url); continue if i > 0 and i % ROTATE_EVERY == 0: requests.get(ROTATE_URL, timeout=60); time.sleep(10) try: status, final_url, html = fetch_one(session, url, PROXIES, HEADERS, TIMEOUT) except Exception as e: log('error', url, str(e)); time.sleep(BASE_DELAY * 2); continue if status == 200 and len(html) > 2000: save_raw(RAW_PATH, url, final_url, status, html, current_ip) else: log('skip', url, status, len(html)) time.sleep(BASE_DELAY * random.uniform(1.0, 1.4))สังเกตเงื่อนไข len(html) > 2000 หน้าที่มีข้อความที่มีเนื้อหาแทบไม่เคยสั้นกว่า 2 กิโลไบต์ HTML นี่เป็นตัวกรองขยะที่หยาบที่สุดตัวแรก และมันตัดการตอบสนองว่างและตัวแทนออกตั้งแต่เริ่ม
- รันบนตัวอย่าง การรันครั้งแรกทำบน 50 ที่อยู่ ดูบันทึก เปิด HTML ที่บันทึกสองสามหน้าในเบราว์เซอร์ ตรวจสอบว่าเป็นหน้าเหล่านั้นจริง
- รันการเก็บข้อมูลเต็มรูปแบบ บนเซิร์ฟเวอร์ใช้
nohup python fetch.py &หรือscreenเพื่อให้โปรเซสรอดการปิด terminal การเก็บ 3000 หน้าที่ 12 คำขอต่อนาทีใช้เวลาประมาณ 4-5 ชั่วโมง
ข้อควรระวัง: อย่ารันสำเนาหลายชุดของตัวเก็บข้อมูลบนเว็บไซต์เดียวกันพร้อมกันผ่านพร็อกซีเดียว การหมุน IP ไม่ได้ยกเลิกขีดจำกัดโหลดบนเซิร์ฟเวอร์ต้นทาง หากต้องการเร็วขึ้น ให้ขนานไปยังเว็บไซต์ต่าง ๆ ไม่ใช่ไปยังเว็บไซต์เดียว
คำแนะนำ: บันทึก IP พร็อกซีที่ใช้ในแต่ละคำขอในบันทึก เมื่อในขั้นตอนการทำความสะอาดพบหน้าที่ถูกตัดเป็นชุด คุณจะเห็นจาก IP และเวลาทันทีว่าเป็นความล้มเหลวของเซสชันเฉพาะหรือไม่ และเก็บเฉพาะเซสชันนั้นใหม่
คำแนะนำ: เพิ่มการดำเนินการต่อในตัวเก็บข้อมูล: ก่อนรัน อ่านที่อยู่ที่เก็บแล้วจาก raw/*.jsonl และข้ามไป จากนั้นการตัดการเชื่อมต่อหรือรีสตาร์ทเซิร์ฟเวอร์จะไม่ทำให้เริ่มจากศูนย์
การตรวจสอบ: ในโฟลเดอร์ raw มีไฟล์ JSONL จำนวนบรรทัดใกล้เคียงกับจำนวนที่อยู่ที่สถานะ 200 ในบันทึก และบรรทัดที่เลือกสุ่มมีฟิลด์ url, fetched_at, proxy_ip และ HTML ที่สมบูรณ์ สัดส่วนข้อผิดพลาดและการข้ามในบันทึกไม่เกิน 5 เปอร์เซ็นต์
ปัญหาที่อาจเกิดขึ้น
- การตอบสนอง 429 หลายรายการ คุณเร็วเกินไปสำหรับเว็บไซต์นี้ ลด
rate_per_minuteครึ่งหนึ่ง เพิ่มrotate_everyเพื่อให้การหมุนไม่ดูเหมือนการระเบิดจากที่อยู่ใหม่ - หน้ามาว่างเปล่า แม้ว่าสถานะ 200 เนื้อหาวาดด้วย JavaScript แหล่งเหล่านี้ต้องใช้การเรนเดอร์ผ่านเบราว์เซอร์ ซึ่งอยู่ในบล็อกขั้นสูง ตอนนี้ทำเครื่องหมายใน
sources.jsonด้วยแฟล็กneeds_js: true - การเก็บข้อมูลดำเนินไปแต่ช้ามาก ตรวจสอบความหน่วงพร็อกซีจากขั้นตอนที่ 2 ตรวจสอบว่า timeout ไม่ได้ตั้งไว้ที่ 120 วินาทีเมื่อความหน่วงทั่วไปคือ 2 มิฉะนั้นแต่ละหน้าที่ค้างจะกินเวลาสองนาที
- สคริปต์ล้มเหลวในการเข้ารหัส ใช้
r.textพร้อมตรวจสอบr.encoding; หากเว็บไซต์ส่งการเข้ารหัสผิด ให้แทนที่r.encoding = r.apparent_encodingก่อนอ่าน
ขั้นตอนที่ 4: แยกข้อความสะอาดจาก HTML และเอกสาร
เป้าหมายของขั้นตอนนี้: เปลี่ยน HTML ดิบและไฟล์ให้เป็นข้อความสะอาด โดยเหลือเพียงเนื้อหาหลักของหน้า: หัวข้อ ย่อหน้า รายการ ตาราง โดยไม่มีเมนู ฟุตเตอร์ โฆษณา และวิดเจ็ต
นี่คือช่วงเวลาที่คุณภาพของคลังข้อมูลเกิดขึ้นหรือตาย วิธีการไร้เดียงสา "ลบแท็กทั้งหมด" ทิ้งรายการเมนู ปุ่ม "ซื้อ" ข้อความแบนเนอร์คุกกี้ และรายการบทความที่เกี่ยวข้องไว้ในข้อความ ทั้งหมดนี้จะโผล่ขึ้นมาในคำตอบของระบบ RAG ในภายหลัง
คำแนะนำสำหรับหน้าเว็บ
- สร้างไฟล์
extract.pyมันอ่านraw/*.jsonlทีละบรรทัดและเขียนผลลัพธ์ในclean/*.jsonl - ใช้ไลบรารี
trafilaturaเพื่อแยกข้อความหลัก มันถูกฝึกให้หาพื้นที่เนื้อหาของหน้าและทิ้งบล็อกเทมเพลต
import json, trafilatura def extract_text(html, url): downloaded = html result = trafilatura.extract( downloaded, url=url, include_comments=False, include_tables=True, include_links=False, favor_precision=True, output_format='json' ) if not result: return None data = json.loads(result) return { 'title': data.get('title'), 'text': data.get('text'), 'author': data.get('author'), 'date': data.get('date'), 'description': data.get('description') }- พารามิเตอร์
favor_precision=Trueบังคับให้ไลบรารีเคร่งครัดขึ้น: มันจะเลือกที่จะเสียข้อความบางส่วนแทนที่จะดึงเมนูมา สำหรับคลังข้อมูล RAG นี่เป็นตัวเลือกที่ถูกต้อง หากคุณสังเกตว่าบล็อกที่จำเป็นสูญหาย เช่น ตารางคุณลักษณะ ให้เปลี่ยนเป็นfavor_recall=Trueสำหรับแหล่งเฉพาะ - เพิ่มวิธีการสำรอง หาก
trafilaturaส่งคืนNoneหรือข้อความสั้นกว่า 200 ตัวอักษร ลองแยกเนื้อหาด้วย CSS selector ที่คุณหาเอง: เปิดหน้าในเบราว์เซอร์ กด F12 หาบล็อกที่มีข้อความหลัก คัดลอกคลาส เช่นarticle-bodyใช้BeautifulSoupตัดเฉพาะบล็อกนั้น ระบุ selector ในsources.jsonเป็นcontent_selector - ทำให้ข้อความปกติ แทนช่องว่างที่แยกไม่ได้ด้วยช่องว่างปกติ ยุบการขึ้นบรรทัดใหม่สามหรือมากกว่าเป็นสอง ลบช่องว่างที่ต้นและท้ายบรรทัด อย่าเปลี่ยนตัวพิมพ์และอย่าลบเครื่องหมายวรรคตอน: มันจะทำให้การค้นหาแย่ลง
- บันทึกพร้อม metadata ต้นทาง คัดลอกจากบันทึกดิบ
url,final_url,fetched_atเพิ่มsourceจากsources.jsonฟิลด์จากการแยก และความยาวข้อความเป็นตัวอักษร
คำแนะนำสำหรับ PDF และ DOCX
- PDF ใช้
pypdf: เปิดไฟล์ วนหน้าต่าง ๆ เรียกpage.extract_text()และรวม บันทึกหมายเลขหน้าสำหรับแต่ละส่วน: เป็น metadata ที่มีค่า ผู้ใช้สามารถหาตำแหน่งในต้นฉบับได้ หากข้อความส่งคืนว่างเปล่า PDF มีการสแกน ไม่ใช่ข้อความ: เก็บไฟล์เหล่านั้นไว้ในโฟลเดอร์แยก การจดจำอยู่นอกขอบเขตของคู่มือนี้ - DOCX ใช้
python-docx: วนdocument.paragraphsและdocument.tablesหัวข้อใน Word มีสไตล์Heading 1,Heading 2: บันทึกเป็นบรรทัดแยกพร้อมหมายเหตุ ซึ่งสะดวกในการตัดเอกสารในภายหลัง - ลบหัวกระดาษและท้ายกระดาษ ในคู่มือ PDF ชื่อบริษัท หมายเลขเวอร์ชัน และ "หน้า 3 จาก 40" ซ้ำในทุกหน้า รวบรวมบรรทัดทั้งหมดของเอกสาร หาบรรทัดที่ซ้ำมากกว่าครึ่งหน้า และลบออก
ข้อควรระวัง: อย่าลบตารางเพื่อความสวยงาม ในคู่มือ แพ็กเกจ และคุณลักษณะ ตารางคือที่ที่มีคำตอบสำหรับคำถามเฉพาะ: "ขีดจำกัดเท่าไหร่" "ราคาเท่าไหร่" "พอร์ตใด" เก็บบรรทัด แยกเซลล์ด้วยแท็บหรือเครื่องหมายขีดตั้ง
คำแนะนำ: หลังแยก เลือก 20 เอกสารสุ่มและอ่านทั้งหมด ไม่ใช่แค่กวาดตา แต่อ่านจริง ๆ การตรวจสอบเช่นนี้หาปัญหาเชิงระบบได้มากกว่าตัวกรองอัตโนมัติใด ๆ: ตัวอย่างเช่น คุณจะเห็นว่าบนทุกหน้าของบล็อกมีบล็อก "อ่านเพิ่มเติม" พร้อมหัวข้อสามหัวติดอยู่ที่ท้ายข้อความ
การตรวจสอบ: ในโฟลเดอร์ clean มีไฟล์ JSONL จำนวนบันทึกไม่น้อยกว่า 80 เปอร์เซ็นต์ของจำนวนหน้าดิบ ใน 10 บันทึกสุ่ม ข้อความเริ่มต้นด้วยหัวข้อหรือย่อหน้าแรกของบทความ ไม่ใช่รายการเมนู และสิ้นสุดด้วยย่อหน้าที่มีเนื้อหาสุดท้าย ไม่ใช่ลายเซ็น "สงวนลิขสิทธิ์"
ปัญหาที่อาจเกิดขึ้น
- แยกข้อความได้น้อยเกินไป เว็บไซต์ที่มีการจัดวางผิดมาตรฐาน เพิ่ม
content_selectorและเส้นทางสำรองผ่านBeautifulSoup - ข้อความยังมีปุ่มและรายการเมนู เปิด
favor_precisionและสำหรับกรณีที่ดื้อรั้นเพิ่มรายการคำหยุด: บรรทัดสั้นเช่น "แชร์" "อ่านต่อ" "ขึ้นบน" ลบหากมันอยู่บรรทัดแยก - PDF ส่งข้อความกลับหลังหรือคำขาด ลอง
pdfplumberแทนpypdfซึ่งทำงานกับคอลัมน์ได้ดีกว่า
ขั้นตอนที่ 5: กรองขยะ: การลบข้อมูลซ้ำ เทมเพลต คุณภาพ ภาษา
เป้าหมายของขั้นตอนนี้: คัดแยกข้อมูลซ้ำ ตัวแทน บล็อกเทมเพลต ข้อความในภาษาอื่น และเอกสารสั้นเกินไปหรือเสียหาย เหลือเฉพาะสิ่งที่มีความรู้
แม้หลังการแยกที่แม่นยำ ในคลังข้อมูลยังมีขยะ 15 ถึง 40 เปอร์เซ็นต์ เป็นเรื่องปกติ การปล่อยให้มันเข้าดัชนีนั้นไม่ปกติ
คำแนะนำ
- สร้างไฟล์
filter.pyที่อ่านclean/*.jsonlใช้ตัวกรองตามลำดับ เขียนเอกสารที่ผ่านในcorpus/filtered.jsonlและที่ถูกคัดออกในcorpus/rejected.jsonlพร้อมระบุเหตุผล - ตัวกรอง 1: ความยาวขั้นต่ำ เอกสารสั้นกว่า 300 ตัวอักษรเกือบทั้งหมดเป็นตัวแทน ประกาศ หรือข้อผิดพลาดในการแยก คัดออกด้วยเหตุผล
too_shortสำหรับการ์ดสินค้า เกณฑ์สามารถลดเป็น 150 - ตัวกรอง 2: วลีตัวแทน รวบรวมรายการวลีที่แสดงว่าหน้าว่างเปล่า: "ไม่พบหน้าเว็บ" "สินค้าหมด" "การเข้าถึงถูกจำกัด" "เปิดใช้งาน javascript" "อยู่ระหว่างการซ่อมบำรุง" หากวลีเช่นนี้ปรากฏใน 300 ตัวอักษรแรกและข้อความทั้งหมดสั้นกว่า 1500 คัดออกด้วยเหตุผล
placeholder - ตัวกรอง 3: ภาษา ใช้
langdetect.detectบน 1000 ตัวอักษรแรก หากภาษาไม่ตรงกับที่ระบุในแหล่ง คัดออกด้วยเหตุผลwrong_langโปรดทราบว่าบนข้อความสั้น ตัวตรวจจับผิดพลาด ดังนั้นใช้หลังตัวกรองความยาว - ตัวกรอง 4: ข้อมูลซ้ำที่แน่นอน ทำให้ข้อความปกติ: ตัวพิมพ์เล็ก ยุบช่องว่าง ลบเครื่องหมายวรรคตอน คำนวณ
sha1หากแฮชเคยปรากฏแล้ว คัดออกด้วยเหตุผลexact_dupและบันทึกลิงก์ไปยังต้นฉบับ แหล่งข้อมูลซ้ำที่แน่นอนทั่วไป: หน้าเดียวที่httpและhttpsกับและไม่มีwwwกับและไม่มีพารามิเตอร์?utm_sourceและหน้าสำหรับพิมพ์ - ตัวกรอง 5: ข้อมูลซ้ำเกือบ ที่นี่ต้องใช้ MinHash จากไลบรารี
datasketchแบ่งข้อความปกติเป็น shingles 5 คำ สร้างMinHashด้วย 128 การเรียงสับเปลี่ยน ใส่ในMinHashLSHด้วยเกณฑ์ 0.85 เอกสารที่มีเพื่อนบ้านคล้ายกันในดัชนีอยู่แล้ว คัดออกด้วยเหตุผลnear_dupด้วยวิธีนี้เวอร์ชันของบทความเดียวกันที่มีวันที่ต่างกัน หน้าสินค้าที่ต่างกันเพียงสี และข่าวที่ออกซ้ำจะหายไป
from datasketch import MinHash, MinHashLSH def shingles(text, k=5): words = text.split() return set(' '.join(words[i:i+k]) for i in range(max(1, len(words) - k + 1))) lsh = MinHashLSH(threshold=0.85, num_perm=128) def is_near_dup(doc_id, norm_text): m = MinHash(num_perm=128) for sh in shingles(norm_text): m.update(sh.encode('utf-8')) if lsh.query(m): return True lsh.insert(doc_id, m) return False- ตัวกรอง 6: บรรทัดเทมเพลต รวบรวมบรรทัดทั้งหมดของเอกสารทั้งหมดของแหล่งเดียวและนับว่าบรรทัดใดปรากฏในเอกสารกี่เปอร์เซ็นต์ บรรทัดที่ปรากฏในมากกว่า 30 เปอร์เซ็นต์ของเอกสารและสั้นกว่า 200 ตัวอักษร เป็นเทมเพลต: ข้อจำกัดความรับผิดชอบ ลายเซ็น คำเชิญสมัครสมาชิก ลบออกจากเอกสารทั้งหมด นี่ไม่ใช่การคัดออกเอกสาร แต่เป็นการทำความสะอาดภายใน
- ตัวกรอง 7: คุณภาพข้อความ คำนวณเมตริกง่าย ๆ: สัดส่วนตัวอักษรในทุกอักขระควรมากกว่า 0.6; ความยาวคำเฉลี่ยจาก 3 ถึง 12; สัดส่วนบรรทัดที่ลงท้ายด้วยจุดมากกว่า 0.3 สำหรับบทความ เอกสารนอกช่วงเหล่านี้มักเป็นตารางรหัส ดัมป์ หรือการแยกที่เสียหาย คัดออกด้วยเหตุผล
low_qualityแต่ต้องดูสิ่งที่ถูกคัดออกด้วยตา: สำหรับเอกสารทางเทคนิคเกณฑ์ต้องผ่อนปรน - ตัวกรอง 8: หน้าที่ถูกตัด เปรียบเทียบ
html_lenจากบันทึกดิบกับค่ามัธยฐานของแหล่ง หาก HTML สั้นกว่า 30 เปอร์เซ็นต์ของค่ามัธยฐาน และข้อความตัดกลางประโยคโดยไม่มีจุด นี่คือการตอบสนองที่ถูกตัด เหตุผลtruncatedบันทึกที่อยู่เหล่านั้นในrecollect.txtและเก็บใหม่ผ่านพร็อกซีในขั้นตอนที่ 3 - รันตัวกรองและศึกษารายงาน สคริปต์ควรแสดงตาราง: จำนวนเอกสารขาเข้า จำนวนที่ถูกคัดออกด้วยเหตุผลแต่ละอย่าง จำนวนที่เหลือ
ข้อควรระวัง: อย่าลบไฟล์จาก clean และ raw ในระหว่างการกรอง ตัวกรองเขียนเฉพาะไฟล์ใหม่ หากเกณฑ์ MinHash เข้มงวดเกินไปและคุณสูญเสียเอกสารที่มีประโยชน์ 40 เปอร์เซ็นต์ คุณเพียงเปลี่ยนตัวเลขและรันสคริปต์อีกครั้งในสองนาที
คำแนะนำ: เกณฑ์ 0.85 สำหรับข้อมูลซ้ำเกือบดีสำหรับบทความและหน้าช่วยเหลือ สำหรับการ์ดสินค้าแบรนด์เดียวที่ต่างกันเพียงขนาดหรือปริมาณ มันจะยุบเป็นหนึ่ง ตัดสินใจล่วงหน้าว่าระบบ RAG ของคุณต้องการทุกตัวแปรหรือไม่ และจะขึ้นเกณฑ์เป็น 0.95 หรือรวมตัวแปรเป็นเอกสารเดียวพร้อมตารางความแตกต่างในขั้นตอนการแยก
คำแนะนำ: เอกสารที่ถูกคัดออกไม่ใช่ขยะ แต่เป็นวัสดุสำหรับดีบัก สัปดาห์ละครั้งเปิด rejected.jsonl กรองตามเหตุผลและดู 10 บันทึกสุ่ม หากใน low_quality มีตารางแพ็กเกจที่มีประโยชน์ปรากฏเป็นประจำ เกณฑ์ต้องแก้ไข
การตรวจสอบ: รายงานตัวกรองแสดงภาพที่สมเหตุสมผล: การคัดออกรวม 10 ถึง 40 เปอร์เซ็นต์ ซึ่งข้อมูลซ้ำเป็นส่วนสำคัญ และเหตุผล truncated ให้ไม่เกิน 2-3 เปอร์เซ็นต์ ในไฟล์ filtered.jsonl ไม่มีสองเอกสารที่มีข้อความปกติเหมือนกัน และ 10 บันทึกสุ่มดูเหมือนบทความหรือส่วนเอกสารที่สมบูรณ์
ปัญหาที่อาจเกิดขึ้น
- การคัดออกมากกว่า 60 เปอร์เซ็นต์ เป็นไปได้มากว่าเกณฑ์คุณภาพเข้มงวดเกินไปหรือข้อผิดพลาดในการทำให้เป็นปกติ ทำให้ข้อความทั้งหมดดูคล้ายกัน แสดง 20 รายการที่ถูกคัดออกสุ่มและหาเหตุผลเชิงระบบ
- MinHash ทำงานนานมาก บนคลังมากกว่า 100,000 เอกสาร ลด
num_permเป็น 64 หรือคำนวณแยกตามแหล่ง - ตัวตรวจจับภาษาทำเครื่องหมายข้อความรัสเซียเป็นบัลแกเรียหรือมาซิโดเนีย เกิดบนส่วนสั้นที่มีชื่อเฉพาะมาก ตรวจสอบภาษาบน 2000 ตัวอักษรแรกและยอมรับภาษาใดก็ได้จากกลุ่มใกล้เคียงเป็นความสอดคล้อง
ขั้นตอนที่ 6: ติดป้าย metadata และรวบรวมคลังข้อมูลสุดท้าย
เป้าหมายของขั้นตอนนี้: ได้ไฟล์เดียว corpus/corpus_v1.jsonl ที่แต่ละเอกสารมีตัวระบุที่เสถียร ชุด metadata ครบถ้วน และพร้อมส่งให้ไปป์ไลน์การทำดัชนี
Metadata คือสิ่งที่แยกคลังข้อมูลออกจากกองข้อความ มันช่วยให้อัปเดตแหล่งแต่ละแห่ง อธิบายที่มาของคำตอบแก่ผู้ใช้ กรองตามวันที่และส่วน และที่สำคัญที่สุด ไม่ต้องทำงานทั้งหมดซ้ำในอีกหนึ่งเดือน
คำแนะนำ
- กำหนด schema ของเอกสาร บันทึกในไฟล์
schema.mdและอย่าเปลี่ยนโดยไม่เปลี่ยนเวอร์ชันคลังข้อมูล แนะนำขั้นต่ำ:
doc_id: ตัวระบุที่เสถียร เช่นsha1ของfinal_urlเพื่อให้เมื่อเก็บใหม่ เอกสารได้ id เดิมsource: ชื่อแหล่งจากsources.jsonurlและfinal_urltitlesection: ส่วนของเว็บไซต์ที่คำนวณจากส่วนแรกของเส้นทางหลัง prefix เช่นhelp/proxieslangpublished_at: วันที่เผยแพร่ หากแยกได้fetched_at: วันที่เก็บgeo: ภูมิภาคของพร็อกซีที่ใช้เก็บtexttext_len,text_sha1corpus_version: เช่นv1
- คำนวณส่วน แยก
final_urlผ่านurllib.parse.urlparseใช้เส้นทาง ลบ prefix ของแหล่ง เหลือหนึ่งหรือสองเซกเมนต์ ส่วนจะกลายเป็นตัวกรองในระบบ RAG ในภายหลัง: ผู้ใช้ถามเกี่ยวกับการชำระเงิน การค้นหาจะเริ่มจากส่วนbillingก่อน - ทำให้วันที่เป็นปกติ วันที่ทั้งหมดให้เป็น ISO 8601 ใน UTC หากไม่พบวันที่เผยแพร่ ให้เว้นฟิลด์ว่าง ไม่ใส่วันที่เก็บ: สองอย่างนี้ต่างกัน และการสับสนเป็นอันตรายเมื่อกรองวัสดุที่ล้าสมัย
- เพิ่มหัวข้อในข้อความ หาก
textไม่เริ่มต้นด้วยtitleให้แทรกหัวข้อเป็นบรรทัดแรก หัวข้อมีคำสำคัญที่สำคัญสำหรับการค้นหา - เรียงลำดับและเขียน เรียงเอกสารตาม
sourceและfinal_urlเขียนในcorpus/corpus_v1.jsonlวางcorpus/manifest_v1.jsonไว้ข้าง ๆ พร้อมจำนวนเอกสารตามแหล่ง วันที่รวบรวม เวอร์ชัน schema และพารามิเตอร์ตัวกรอง - สร้างไฟล์เก็บถาวร บีบอัด
corpus,sources.json,schema.mdและโฟลเดอร์logsไฟล์เก็บถาวรนี้คือเวอร์ชันที่ทำซ้ำได้ของคลังข้อมูลของคุณ
คำแนะนำ: เก็บข้อมูลส่วนบุคคลไว้นอกคลังข้อมูลเลย หากในข้อความช่วยเหลือมีตัวอย่างเช่น "อีวาน เปตรอฟ, +7 900..." ให้แทนที่ด้วยตัวแทนตั้งแต่ขั้นตอนการรวบรวมคลังข้อมูล ระบบ RAG ไม่ควรสามารถให้เบอร์โทรของใคร แม้จะอยู่ในที่เปิดเผยก็ตาม
การตรวจสอบ: ไฟล์ corpus_v1.jsonl เปิดได้ แต่ละบรรทัดเป็น JSON ที่ถูกต้องพร้อมฟิลด์ตาม schema ทุกเอกสารมี doc_id ที่ไม่ซ้ำ ทุกอย่างมี source, lang, fetched_at, text ที่กรอกไว้ ไฟล์ manifest_v1.json มีสรุปที่ตรงกับจำนวนบรรทัด
ปัญหาที่อาจเกิดขึ้น
- ที่อยู่ต่างกันนำไปยังเอกสารเดียวกันและให้ doc_id ต่างกัน คำนวณ id จาก
final_urlหลังการเปลี่ยนเส้นทาง โดยลบพารามิเตอร์คำขอและเครื่องหมายทับท้าย - วันที่ถูกแยกในรูปแบบต่าง ๆ ใช้
dateutil.parser.parseพร้อมพารามิเตอร์dayfirst=Trueสำหรับแหล่งภาษารัสเซีย
ตรวจสอบผลลัพธ์: รายการตรวจสอบและทดสอบคลังข้อมูล
คลังข้อมูลรวบรวมเสร็จแล้ว ก่อนนำไปทำดัชนี มาตรวจสอบมันในฐานะผลิตภัณฑ์ ไม่ใช่แค่ไฟล์
รายการตรวจสอบ
- มี
sources.jsonพร้อมขอบเขตของแต่ละแหล่งและขีดจำกัด - ทุกคำขอวิ่งผ่านพร็อกซีมือถือ ในบันทึกแต่ละคำขอมี
proxy_ip - สัดส่วนข้อผิดพลาดการเก็บข้อมูลตามบันทึกไม่เกิน 5 เปอร์เซ็นต์ การตอบสนอง 429 น้อยกว่า 1 เปอร์เซ็นต์
- แยกเอกสารได้ไม่น้อยกว่า 80 เปอร์เซ็นต์จากหน้าดิบ
- การคัดออกจากการกรอง 10 ถึง 40 เปอร์เซ็นต์ เหตุผลการคัดออกทั้งหมดมีชื่อ
- ในคลังข้อมูลไม่มีข้อมูลซ้ำที่แน่นอนตามข้อความปกติ
- ทุกเอกสารมี metadata ที่จำเป็นกรอกไว้
- มีไฟล์เก็บถาวรที่มีข้อมูลดิบ คลังข้อมูล บันทึก และการตั้งค่า
วิธีทดสอบ
- ทดสอบด้วยคำถามจากขั้นตอนที่ 1 ใช้คำถาม 20-30 ข้อของคุณ สำหรับแต่ละข้อ ค้นหาด้วยการค้นหาแบบสตริงย่อยหรือผ่าน
grepในคลังข้อมูลเพื่อหาเอกสารที่มีคำตอบ เป้าหมาย: ไม่น้อยกว่า 90 เปอร์เซ็นต์ของคำถามมีการครอบคลุม หากคำถามไม่ถูกครอบคลุม หาหน้าที่มีคำตอบในเบราว์เซอร์และค้นหาว่าทำไมมันไม่เข้า: ไม่อยู่ใน sitemap ถูกตัวกรองคัดออก ข้อความถูกตัด - ทดสอบขยะ ค้นหาในคลังข้อมูลสำหรับสตริง "สมัครสมาชิก" "ตะกร้า" "cookie" "สงวนลิขสิทธิ์" "อ่านเพิ่มเติม" ทุกการปรากฏเป็นข้อสงสัย อนุญาตไม่กี่รายการหากเป็นส่วนของข้อความที่มีเนื้อหา การปรากฏเป็นสิบแสดงว่าตัวกรองเทมเพลตต้องแก้ไข
- ทดสอบการตัดขาด นับเอกสารที่ข้อความสิ้นสุดไม่ใช่จุด อัศเจรีย์ คำถาม หรือวงเล็บปิด ควรน้อยกว่า 5 เปอร์เซ็นต์ ที่เหลือดูด้วยตา
- ทดสอบการกระจาย สร้างฮิสโตแกรมความยาวเอกสาร คลังข้อมูลช่วยเหลือหรือบล็อกที่ดีมีพีคที่ 2-8 พันตัวอักษรและหางยาว พีคที่คมใกล้เกณฑ์ขั้นต่ำแสดงว่ามีตัวแทนที่รอดตัวกรอง
- ทดสอบภูมิศาสตร์ หากเนื้อหาขึ้นกับภูมิภาค เปิด 5 หน้าที่มีราคาหรือสต็อกและเปรียบเทียบกับสิ่งที่คนจากเมืองที่ต้องการเห็น ความแตกต่างแสดงว่าพร็อกซีถูกเลือกจากภูมิภาคอื่นหรือเว็บไซต์กำหนดภูมิภาคจากคุกกี้ ไม่ใช่ IP
ตัวชี้วัดความสำเร็จ
คลังข้อมูลพร้อม หากการครอบคลุมคำถามทดสอบสูงกว่า 90 เปอร์เซ็นต์ สัดส่วนเอกสารที่มีสัญญาณขยะต่ำกว่า 3 เปอร์เซ็นต์ และ manifest ช่วยทำซ้ำการรวบรวมได้ทั้งหมด หลังจากนั้นคลังข้อมูลจึงถูกส่งให้ไปป์ไลน์การทำดัชนีของระบบ RAG
ข้อผิดพลาดทั่วไปและวิธีแก้ไขเมื่อรวบรวมคลังข้อมูลสำหรับ RAG
ปัญหา: ในคำตอบของผู้ช่วยปรากฏรายการเมนูและคำเชิญสมัครสมาชิก สาเหตุ: การแยกข้อความทำงานในโหมดความครบถ้วน ไม่ใช่ความแม่นยำ ตัวกรองเทมเพลตไม่ได้รัน วิธีแก้: เปิด favor_precision ใช้การลบบรรทัดที่ซ้ำในมากกว่า 30 เปอร์เซ็นต์ของเอกสารแหล่ง รวบรวม clean จาก raw ใหม่โดยไม่ต้องดาวน์โหลดซ้ำ
ปัญหา: ผู้ช่วยตอบตามคู่มือเวอร์ชันเก่า สาเหตุ: ในคลังข้อมูลมีทั้งเวอร์ชันเก่าและใหม่ของบทความ ข้อมูลซ้ำเกือบไม่ถูกคัดออกหรือเกณฑ์สูงเกินไป วิธีแก้: ลดเกณฑ์ MinHash เป็น 0.8 สำหรับแหล่งที่มีเวอร์ชัน เมื่อขัดแย้งให้เก็บเอกสารที่มี published_at ใหม่กว่า
ปัญหา: บางหน้าถูกเก็บว่างเปล่า สถานะ 200 สาเหตุ: เนื้อหาสร้างด้วย JavaScript ฝั่งเบราว์เซอร์ วิธีแก้: ทำเครื่องหมายแหล่ง needs_js และใช้การเรนเดอร์ผ่าน Playwright จากบล็อกขั้นสูง หรือหา API หรือ RSS ของเว็บไซต์ที่ให้เนื้อหาพร้อม
ปัญหา: การเก็บข้อมูลหยุดที่ข้อผิดพลาด 429 และ 503 สาเหตุ: ความถี่คำขอสูงเกินไป การหมุน IP ถูกใช้แทนการลดโหลด วิธีแก้: ลดความถี่เป็น 6-8 คำขอต่อนาที เพิ่มการกระจายแบบสุ่มของเวลาหยุด ตั้งเวลาหยุด 5-10 นาทีเมื่อ 429 ครั้งแรก จำไว้ว่าขีดจำกัดโหลดคือการเคารพแหล่งข้อมูล ไม่ใช่จำนวนที่อยู่
ปัญหา: หลังการหมุน เว็บไซต์แสดงเนื้อหาของภูมิภาคอื่น สาเหตุ: พร็อกซีมือถือออก IP ของเมืองอื่น หรือเว็บไซต์กำหนดภูมิภาคจากคุกกี้ของเซสชันก่อน วิธีแก้: ตรึงภูมิภาคที่ต้องการในแดชบอร์ดพร็อกซี รีเซ็ตเซสชัน requests หลังการหมุนแต่ละครั้ง เพื่อไม่ให้คุกกี้ถูกถ่ายโอน
ปัญหา: คลังข้อมูลรวบรวมแล้ว แต่การครอบคลุมคำถาม 60 เปอร์เซ็นต์ สาเหตุ: ขอบเขตแหล่งข้อมูลแคบเกินไป หน้าที่มีประโยชน์ถูกตัดตาม prefix วิธีแก้: ใช้คำถามที่ไม่ถูกครอบคลุม หาคำตอบในเบราว์เซอร์ ดูที่อยู่ของพวกเขาและขยาย include_prefixes
ปัญหา: การลบข้อมูลซ้ำกินการ์ดสินค้าที่ต่างกันในคุณลักษณะ สาเหตุ: เกณฑ์ข้อมูลซ้ำเกือบต่ำเกินไปสำหรับข้อความประเภทเดียวกัน วิธีแก้: สำหรับแหล่งแค็ตตาล็อกเพิ่มเกณฑ์เป็น 0.95 หรือรวมตัวแปรของสินค้าเดียวกันเป็นเอกสารเดียวในขั้นตอนการแยก
ปัญหา: ข้อความ PDF มาเป็นบรรทัดเดียวโดยไม่มีย่อหน้า สาเหตุ: pypdf สูญเสียการจัดรูปแบบ วิธีแก้: เปลี่ยนเป็น pdfplumber หรือ pymupdf กู้คืนย่อหน้าจากการขึ้นบรรทัดคู่และ indent
ปัญหา: ข้อมูลส่วนบุคคลเข้ามาในคลังข้อมูล สาเหตุ: ไม่มีขั้นตอนการทำให้ไม่ระบุตัวตน วิธีแก้: เพิ่มก่อนเขียนในคลังข้อมูลการค้นหาโทรศัพท์ email และชื่อผ่าน pattern ง่าย ๆ และแทนที่ด้วยตัวแทน เอกสารที่คลุมเครือส่งให้ตรวจสอบด้วยมือ
ความสามารถเพิ่มเติมสำหรับผู้เชี่ยวชาญ
หากไปป์ไลน์พื้นฐานทำงานได้ นี่คือสิ่งที่ต้องพัฒนา
การเรนเดอร์หน้าที่มี JavaScript ผ่านพร็อกซี
ติดตั้ง pip install playwright และ playwright install chromium รันเบราว์เซอร์ด้วยพารามิเตอร์ proxy={'server': 'http://HOST:PORT', 'username': USER, 'password': PASS} รอ selector ของเนื้อหาหลักผ่าน page.wait_for_selector ไม่ใช่รอวินาทีคงที่ ดึง page.content() และเก็บบันทึกในรูปแบบ raw เดียวกัน เพื่อให้ขั้นตอนต่อไปไม่เปลี่ยน การเรนเดอร์ช้ากว่าคำขอปกติ 5-10 เท่า ดังนั้นใช้เฉพาะกับแหล่งที่มีแฟล็ก needs_js และลดความถี่เป็น 3-5 หน้าต่อนาที
การอัปเดตคลังข้อมูลแบบเพิ่ม
เก็บ text_sha1 ของแต่ละเอกสารใน manifest ในการรวบรวมครั้งถัดไป ดาวน์โหลดหน้า แต่แยกและกรองเฉพาะที่มีแฮช HTML เปลี่ยนหรือผ่านมากกว่า 30 วันจากการเก็บ ใช้ส่วนหัว If-Modified-Since และ ETag: หลายเว็บไซต์จะส่งคืน 304 โดยไม่มีเนื้อหา และคุณประหยัดทราฟฟิกพร็อกซี การอัปเดตแต่ละครั้งได้เวอร์ชันคลังข้อมูลใหม่: v2, v3 และไฟล์เก็บถาวรเก่าไม่ถูกลบ
คลังข้อมูลหลายภูมิภาค
หากธุรกิจมีสาขาและเนื้อหาของแหล่งขึ้นกับเมือง สร้างพร็อกซีมือถือหลายตัวที่มีภูมิศาสตร์ต่างกัน เก็บหน้าเดียวกันจากแต่ละภูมิภาค เก็บ geo ใน metadata และลบข้อมูลซ้ำเฉพาะภายในภูมิภาค ระบบ RAG จะสามารถตอบได้ว่า "ในคาซานจัดส่ง 2 วัน ในโนโวซีบีร์สค์ 4" โดยอ้างอิงจากเวอร์ชันหน้าเว็บตามภูมิภาคจริง
การให้คะแนนคุณภาพแทนเกณฑ์ที่เข้มงวด
แทนที่จะคัดออกตามเกณฑ์ ให้คำนวณคะแนนคุณภาพ 0 ถึง 1 สำหรับแต่ละเอกสารจากเมตริกเดียวกัน: ความยาว สัดส่วนตัวอักษร สัดส่วนประโยคที่สมบูรณ์ การซ้ำของบรรทัด เก็บคะแนนใน metadata จากนั้นไปป์ไลน์การทำดัชนีสามารถตัดสินใจเองว่าจะเอาอะไร และการค้นหาจัดอันดับเอกสารที่น่าเชื่อถือสูงกว่า
การลบข้อมูลซ้ำเชิงความหมาย
MinHash จับข้อมูลซ้ำเชิงศัพท์ การถอดความคำแนะนำเดียวกันด้วยคำต่างกันมันจะข้ามไป สำหรับการจับ这些东西 ให้คำนวณ embedding ของเอกสารและหาคู่ที่มีความคล้ายคลึงโคไซน์สูงกว่า 0.95 นี่เป็นเส้นแบ่งกับขั้นตอนการทำดัชนี ดังนั้นที่นี่เพียงกล่าวถึง: ตัดสินใจว่าจะลากเส้นแบ่งตรงไหน และอย่าทำงานเดียวสองครั้ง
การตรวจสอบการเก็บข้อมูล
แสดงเมตริกจากบันทึก: คำขอต่อนาที สัดส่วนรหัส 200 ความหน่วงเฉลี่ย จำนวนการหมุน แดชบอร์ดง่าย ๆ ด้วย matplotlib หรือตารางใน terminal ทุก 10 นาทีจะแสดงการเสื่อมสภาพก่อนที่คุณจะพบ 500 หน้าที่ว่างเปล่าในตอนเช้า
FAQ: คำถามที่พบบ่อยเกี่ยวกับการรวบรวมคลังข้อมูล
จำเป็นต้องใช้พร็อกซีมือถือสำหรับการรวบรวมคลังข้อมูลหรือไม่ สำหรับเอกสารของคุณเองและแหล่งเล็ก ไม่จำเป็น พร็อกซีจำเป็นเมื่อมีแหล่งมาก การเก็บข้อมูลดำเนินไปหลายชั่วโมง ต้องการเวอร์ชันภูมิภาคของเนื้อหา หรือคุณไม่ต้องการสร้างโหลดที่สังเกตได้บนเว็บไซต์จากที่อยู่เดียว
ควรเปลี่ยน IP บ่อยแค่ไหนเมื่อเก็บข้อมูล แนวทาง: ทุก 30-60 คำขอ หรือเมื่อเปลี่ยนไปยังแหล่งอื่น บ่อยกว่านั้นไม่จำเป็น: ความหมายของการหมุนคือการกระจายโหลดและความเสถียรของเซสชัน ไม่ใช่ความถี่ในตัวเอง การหมุนบ่อยโดยไม่ลดความเร็วโดยรวมไม่ได้ลดโหลด
ต้องมีเอกสารเท่าไหร่สำหรับระบบ RAG ที่ใช้งานได้ สำหรับผู้ช่วยเกี่ยวกับผลิตภัณฑ์เดียว 200-500 เอกสารที่มีคุณภาพมักเพียงพอ สำหรับ niche กว้าง หลายพันเอกสาร คุณภาพสำคัญกว่าปริมาณ: 500 บทความสะอาดให้คำตอบที่ดีกว่า 20,000 บทความที่มีขยะ
สามารถเก็บจากโซเชียลมีเดียและมาร์เก็ตเพลสได้หรือไม่ เฉพาะหน้าที่เปิดภายในกฎของแพลตฟอร์มและ robots.txt โดยไม่มีข้อมูลส่วนบุคคล หลายแพลตฟอร์มมี API ทางการสำหรับรับเนื้อหา เริ่มจากสิ่งเหล่านั้น
จะทำอย่างไรกับรูปภาพและวิดีโอ ในกรอบของคลังข้อมูลข้อความ เก็บเฉพาะคำบรรยาย alt-text และ transcript หากมีในหน้า ไฟล์เองไม่เข้าคลังข้อมูล
ทำไมไม่ดาวน์โหลดทั้งเว็บไซต์ด้วยโปรแกรมดาวน์โหลดเลย ได้ แต่คุณจะได้ไฟล์หลายหมื่นไฟล์โดยไม่มี metadata มีข้อมูลซ้ำ หน้าบริการ และไม่มีบันทึก จากนั้นจะต้องทำทุกขั้นตอนของคู่มือนี้ในลำดับย้อนกลับ เพียงแต่ยากกว่า
จะรู้ได้อย่างไรว่าตัวกรองไม่ได้ลบสิ่งจำเป็น ดู rejected.jsonl ตามเหตุผลแต่ละอย่าง ตัวอย่าง 10-20 บันทึก และตรวจสอบการครอบคลุมคำถามทดสอบ: หากคำตอบหายไป ค้นหาในสิ่งที่ถูกคัดออก
ต้องตัดเอกสารเป็น chunks ในขั้นตอนนี้หรือไม่ ไม่ การแบ่งเป็นส่วนเป็นส่วนหนึ่งของการทำดัชนีและขึ้นอยู่กับโมเดล embedding และขนาดบริบท หน้าที่ของคลังข้อมูลคือให้เอกสารที่สมบูรณ์พร้อม metadata และการติดป้ายหัวข้อ ซึ่ง chunker สามารถตัดได้อย่างมีความหมาย
จะอัปเดตคลังข้อมูลโดยไม่รวบรวมทั้งหมดได้อย่างไร เก็บแฮช ใช้คำขอแบบมีเงื่อนไข If-Modified-Since ทำเวอร์ชันคลังข้อมูล รายละเอียดในบล็อกขั้นสูง
จะทำอย่างไรหากเว็บไซต์ห้ามการเก็บข้อมูลอัตโนมัติใน robots.txt เคารพการห้าม เขียนถึงเจ้าของ บ่อยครั้งเขาจะให้การส่งออก API หรืออนุญาต คลังข้อมูลที่รวบรวมขัดกับกฎของแหล่งสร้างความเสี่ยงต่อทั้งโปรเจกต์
บทสรุป: สิ่งที่ทำและจะไปต่อที่ไหน
คุณผ่านเส้นทางทั้งหมดจากแนวคิดไปยังคลังข้อมูลที่พร้อมใช้ กำหนดขอบเขตและสร้างแผนที่แหล่งข้อมูลพร้อมขีดจำกัดและภูมิศาสตร์ เชื่อมต่อพร็อกซีมือถือและตรวจสอบว่าการหมุนทำงาน เขียนตัวเก็บข้อมูลที่สุภาพซึ่งเคารพ robots.txt กระจายโหลด และเก็บบันทึกอย่างละเอียด แยกข้อความสะอาดจาก HTML, PDF และ DOCX คัดข้อมูลซ้ำ ตัวแทน เทมเพลต และหน้าที่เสียหายพร้อมเหตุผลที่มีชื่อ ติดป้าย metadata และรวบรวมคลังข้อมูลที่มีเวอร์ชันพร้อม manifest ตรวจสอบกับคำถามจริง
ผลลัพธ์หลักไม่ใช่ไฟล์บนดิสก์ แต่เป็นกระบวนการที่ทำซ้ำได้ อีกหนึ่งเดือนคุณจะรันมันอีกครั้งและได้คลังข้อมูลที่อัปเดตในสองชั่วโมง ไม่ใช่หนึ่งสัปดาห์ และเมื่อระบบ RAG เริ่มตอบแปลก ๆ คุณจะรู้แน่ชัดว่าจะหาเหตุผลที่ไหน: ในบันทึกการเก็บข้อมูล ในรายงานตัวกรอง หรือใน manifest
สิ่งที่ต้องทำต่อไป ส่ง corpus_v1.jsonl ให้ไปป์ไลน์การทำดัชนี: การแบ่งเป็นส่วน, embedding, ฐานข้อมูลเวกเตอร์ เรื่องนี้อยู่ในบทความที่เกี่ยวข้องในบล็อก ตั้งการรันตัวเก็บข้อมูลตามกำหนดการพร้อมการอัปเดตแบบเพิ่ม ขยายแผนที่แหล่งข้อมูลเมื่อจำนวนคำถามที่ไม่ถูกครอบคลุมเพิ่มขึ้น หากธุรกิจเป็นระดับภูมิภาค เพิ่มพร็อกซีของเมืองที่ต้องการและรวบรวมเวอร์ชันภูมิภาคของเนื้อหา
จะพัฒนาไปที่ไหน เรียนรู้การเรนเดอร์ผ่านเบราว์เซอร์สำหรับเว็บไซต์ที่ซับซ้อน การให้คะแนนคุณภาพเอกสารแทนเกณฑ์ที่เข้มงวด การลบข้อมูลซ้ำเชิงความหมาย และการตรวจสอบการเก็บข้อมูล แต่ละขั้นตอนเหล่านี้เพิ่มคุณภาพคำตอบได้มากกว่าการเปลี่ยนโมเดล ข้อมูลสะอาดคือการปรับปรุงระบบ RAG ที่ถูกที่สุดที่คุณมี ขอให้สนุกกับการรวบรวม