ระบบป้องกันบอทสำหรับเว็บไซต์: เลือกใช้อะไรและติดตั้งอย่างไรเมื่อคุณถูกดึงข้อมูล
บทความ
- บทนำ: เมื่อเว็บไซต์ของคุณกลายเป็นฐานข้อมูลของคนอื่น
- พื้นฐาน: ระบบป้องกันบอทคืออะไร และป้องกันจากใคร
- เจาะลึก: ระบบป้องกันบอทสมัยใหม่ "มองเห็น" ผู้เข้าชมอย่างไร
- วิธีที่ 1. การวินิจฉัย: ค้นหาว่าใครและอย่างไรกำลังดึงข้อมูลคุณ
- วิธีที่ 2. แนวแรก: ระดับเซิร์ฟเวอร์และเครือข่าย
- วิธีที่ 3. แนวที่สอง: การตรวจสอบไคลเอนต์และ challenge
- วิธีที่ 4. แนวที่สาม: พฤติกรรม กับดัก และการป้องกันข้อมูลเอง
- ข้อผิดพลาดทั่วไปในการนำระบบป้องกันบอทไปใช้
- เครื่องมือและทรัพยากรสำหรับการนำไปใช้
- กรณีศึกษา: สิ่งนี้ทำงานอย่างไรในโปรเจกต์จริง
- Faq: คำตอบสำหรับคำถามยาก
- บทสรุป: การป้องกันเป็นกระบวนการ ไม่ใช่การซื้อ
บทนำ: เมื่อเว็บไซต์ของคุณกลายเป็นฐานข้อมูลของคนอื่น
ลองจินตนาการดูว่า คุณใช้เวลาครึ่งปีรวบรวมแคตตาล็อก ตรวจสอบราคา เขียนรายละเอียดสินค้า ตั้งค่าฟิลเตอร์ แล้วจู่ๆ คุณก็สังเกตเห็นว่าคู่แข่งอัปเดตราคาเพียงยี่สิบนาทีหลังจากคุณ และมีเว็บไซต์โคลนโผล่ขึ้นมาในผลการค้นหาพร้อมคำอธิบายของคุณแบบคำต่อคำ เซิร์ฟเวอร์ก็ครางภายใต้ภาระ ค่าโฮสติ้งก็เพิ่มขึ้น และ analytics ก็แสดงยอดทราฟฟิกพุ่งสูงผิดปกติตอนกลางคืนจากพื้นที่ที่คุณไม่มีลูกค้าเลยสักราย familiar ไหม? นี่คือการดึงข้อมูล (parsing) และมันไม่ใช่ภัยคุกคามสมมติ แต่เป็นความจริงในชีวิตประจำวันของเว็บไซต์ใดก็ตามที่มีอะไรมีค่าอยู่บ้าง
จากรายงานอุตสาหกรรมในช่วงไม่กี่ปีที่ผ่านมา ทราฟฟิกอัตโนมัติคิดเป็นประมาณครึ่งหนึ่งของคำขอทั้งหมดบนอินเทอร์เน็ต และประมาณหนึ่งในสามของปริมาณทั้งหมดมาจากบอทที่เป็นอันตรายอย่างชัดเจน สำหรับอีคอมเมิร์ซ มาร์เก็ตเพลส ท่องเที่ยว และแพลตฟอร์มคอนเทนต์ สัดส่วนอาจสูงกว่านี้ด้วยซ้ำ แถมเทรนด์ปี 2026 ก็ชัดเจน: นอกจากสแครปเปอร์แบบดั้งเดิมแล้ว ยังมีเอเจนต์ที่ขับเคลื่อนด้วยโมเดลภาษาขนาดใหญ่ ซึ่งท่องเว็บได้ไม่ต่างจากมนุษย์ อ่านคอนเทนต์และตัดสินใจ เส้นแบ่งระหว่างผู้เข้าชม "จริง" กับ "อัตโนมัติ" กำลังเลือนหายไปต่อหน้าต่อตา
ผู้อ่าน mobileproxy.space รู้จักหัวข้อนี้จากทั้งสองฝั่ง นักการตลาดและนัก arbitrage ก็เก็บข้อมูลเอง นักพัฒนาก็เขียน collector เจ้าของธุรกิจก็ติดตามคู่แข่ง แต่ทุกคนล้วนมีเว็บไซต์ แลนดิ้งเพจ แคตตาล็อก หรือ API ของตัวเองที่ใครบางคนกำลังดึงข้อมูลอยู่ในตอนนี้ ดังนั้นในบทความนี้เราจะเปลี่ยนมุมมอง: วันนี้คุณกำลังถูกดึงข้อมูล และเราจะมาวิเคราะห์วิธีสร้างระบบป้องกันบอทสำหรับเว็บไซต์ให้ทำงานได้จริง โดยไม่รบกวนผู้ใช้จริง
ข้อควรระวังสำคัญ เราไม่ได้เปรียบเทียบผู้ให้บริการหรือจัดอันดับบริการเชิงพาณิชย์ — เรื่องนั้นมีเนื้อหาแยกต่างหากในบล็อก ที่นี่เราพูดถึงการนำไปใช้: มีระดับการป้องกันอะไรบ้าง เรียงลำดับอย่างไร วัดผลอย่างไร และมีกับดักอะไรบ้างในแต่ละขั้น คุณจะได้อะไรเมื่ออ่านจบ:
- เข้าใจว่าระบบป้องกันบอทสมัยใหม่ "มองเห็น" ผู้เข้าชมอย่างไร และทำไมการบล็อกตาม IP จึงใช้ไม่ได้ผลมานานแล้ว
- ระเบียบวิธีวินิจฉัย: วิธีค้นหาภายในหนึ่งวันว่าใครและอย่างไรกำลังดึงข้อมูลคุณ
- แนวป้องกันสามชั้นพร้อมคำแนะนำทีละขั้น — ตั้งแต่ rate limiting ระดับเซิร์ฟเวอร์ ไปจนถึงการวิเคราะห์พฤติกรรมและกับดักในข้อมูล
- กรอบการทำงานสำหรับการนำไปใช้ทีละขั้นโดยไม่ทำลาย conversion
- เช็คลิสต์ รายการเครื่องมือ และกรณีศึกษาจริงพร้อมตัวเลข
นั่งสบายๆ เนื้อหายาวหน่อย แต่ตั้งใจเขียนให้เป็น bookmark ทำงานที่คุณจะกลับมาอ่านในทุกขั้นตอนของโปรเจกต์
พื้นฐาน: ระบบป้องกันบอทคืออะไร และป้องกันจากใคร
บอทมีหลายแบบ และไม่ใช่ทุกตัวที่ต้องบล็อก
สิ่งแรกที่ควรยอมรับ: บอทไม่ใช่คำหยาบ บอทค้นหาจัดทำดัชนีหน้าเว็บของคุณและนำทราฟฟิกมาให้ การตรวจสอบความพร้อมใช้งานตรวจสอบว่าเว็บไซต์ยังทำงานอยู่ ระบบชำระเงินเรียก webhook พันธมิตรรวบรวมฟีดตามสัญญา ทั้งหมดนี้เป็นทราฟฟิกอัตโนมัติที่คุณต้องการและเป็นประโยชน์ ภารกิจของระบบป้องกันบอทสำหรับเว็บไซต์ไม่ใช่ทำลายระบบอัตโนมัติโดยสิ้นเชิง แต่เป็นการแยกคำขอที่เป็นประโยชน์และยอมรับได้ออกจากคำขอที่เป็นอันตราย และทำให้คำขอที่เป็นอันตรายนั้นไร้ความหมายทางเศรษฐกิจ
โดยทั่วไปบอทที่ไม่พึงประสงค์แบ่งออกเป็นหลายประเภท:
- สแครปเปอร์คอนเทนต์และราคา — ดึงแคตตาล็อก คำอธิบาย สต็อก ราคา รีวิว ตัวเอกของบทความนี้
- แอกกริเกเตอร์ที่ไม่มีสัญญา — เอาข้อมูลของคุณไปขายต่อให้บุคคลที่สาม
- บอทเดารหัสผ่าน — โจมตีฟอร์มเข้าสู่ระบบ ตรวจสอบคู่ชื่อผู้ใช้-รหัสผ่านที่รั่วไหล
- สเกลปเปอร์และ "สไนเปอร์" สต็อก — ซื้อสินค้าขาดตลาดหรือจองช่องเวลาภายในเสี้ยววินาที
- บอทสแปมและปั๊มยอด — ถมฟอร์ม สร้างบัญชีปลอม ทำลายเมตริก
- ครอว์เลอร์ของโมเดล AI — รวบรวมข้อความสำหรับฝึกหรือสำหรับตอบคำถามแบบเรียลไทม์ ความยอมรับได้ขึ้นอยู่กับแต่ละธุรกิจ
สังเกตว่าการดึงข้อมูลเองไม่ค่อยทำลายเว็บไซต์ แต่สร้างภาระปรสิต (บางครั้งถึง 60-80% ของคำขอทั้งหมดไปยังแคตตาล็อก) บิดเบือน analytics ทำให้โควต้า API ภายนอกที่คุณเรียกตอนเรนเดอร์หน้าหมดลง และที่สำคัญที่สุดคือพรากความได้เปรียบในการแข่งขันที่คุณรวบรวมข้อมูลเหล่านี้มาเพื่อมัน
การป้องกันการดึงข้อมูลต่างจากการป้องกัน DDoS อย่างไร
เจ้าของเว็บไซต์หลายคนถือว่าสองงานนี้เหมือนกันและสงสัยว่าทำไมฟิลเตอร์กัน DDoS ถึงปล่อยสแครปเปอร์ผ่านไป ความแตกต่างเป็นพื้นฐาน DDoS คือการโจมตีที่ปริมาณ: เป้าหมายคือทำให้ช่องสัญญาณหรือเซิร์ฟเวอร์หมดทรัพยากร การโจมตีแบบนี้สังเกตได้ง่ายจากเมตริก และกรองได้ในระดับเครือข่าย ส่วนสแครปเปอร์กลับพยายามซ่อนตัว: ยืดคำขอออกตามเวลา กระจายไปยังที่อยู่หลายหมื่นแห่ง เลียนแบบเบราว์เซอร์ และเข้าถึง URL เดียวกับที่คนจริงเข้า ฟิลเตอร์ DDoS แบบคลาสสิกเห็นทราฟฟิกที่สม่ำเสมอ "สุขภาพดี" และปล่อยผ่าน ดังนั้นการป้องกันบอทจึงต้องใช้สัญญาณที่แตกต่างโดยพื้นฐาน — เราจะพูดถึงในหัวข้อถัดไป
แนวป้องกันสามชั้น: โมเดลที่เราจะใช้
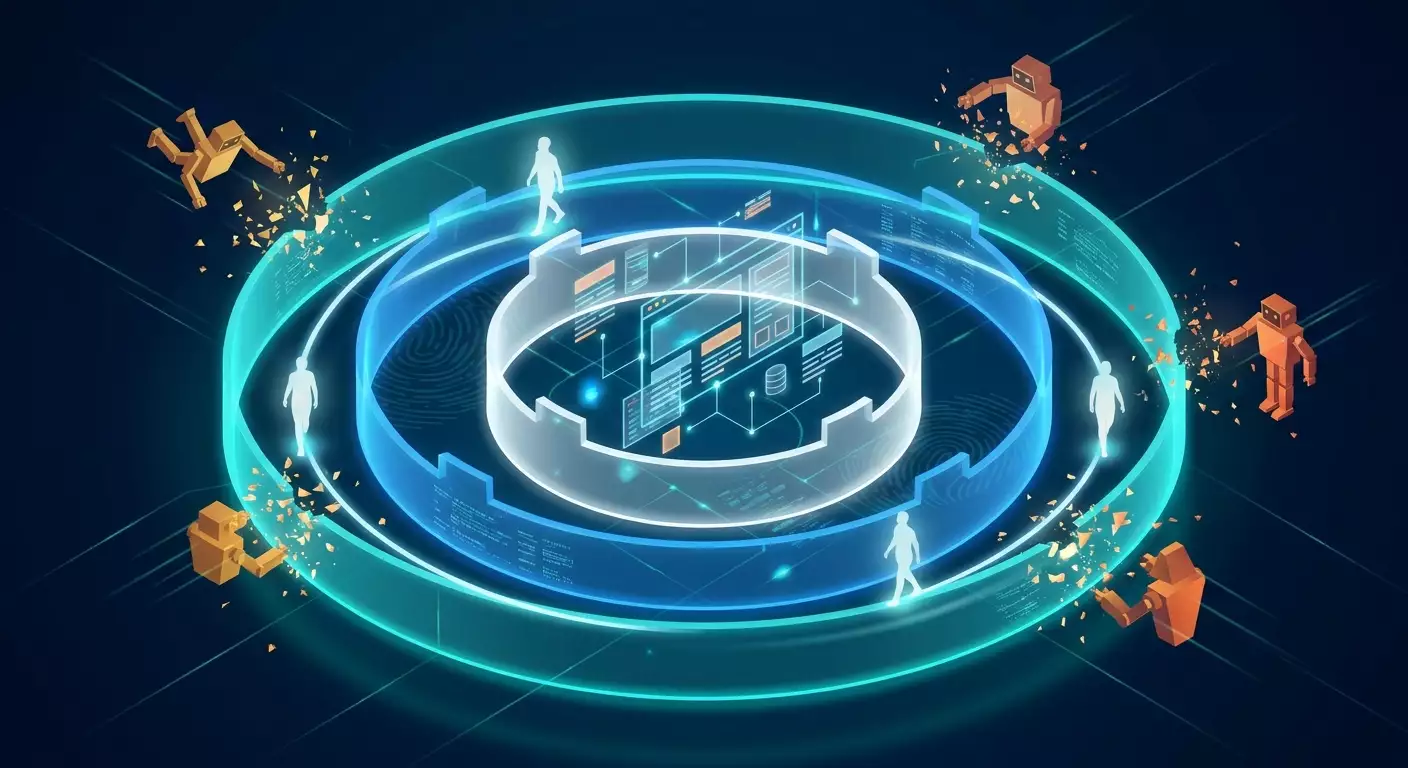
เพื่อไม่ให้จมอยู่ในเทคโนโลยี มองการป้องกันบอทเป็นสามชั้น concentric อุปมาคือปราสาทยุคกลาง: คูน้ำและกำแพงชั้นนอก ประตูที่มีทหารยาม และสุดท้ายคือห้องชั้นในที่แม้ผู้มาเยือนที่ผ่านประตูมาก็ยังถูกเฝ้าดู
- ระดับเครือข่ายและเซิร์ฟเวอร์ จำกัดความถี่คำขอ กรองตามชื่อเสียงเครือข่าย WAF กฎพื้นฐานตาม header ราคาถูก เร็ว ตัดบอทพื้นฐานที่สุดออก
- ระดับตรวจสอบไคลเอนต์ JavaScript challenge วิเคราะห์ลายนิ้วมือ TLS และเบราว์เซอร์ แคปช่าในจุดที่เหมาะสม งานพิสูจน์การทำงาน ตัดสคริปต์ที่ไม่มีเบราว์เซอร์และเครื่องมือ headless ที่ตั้งค่าไม่ดี
- ระดับพฤติกรรมและการป้องกันข้อมูล วิเคราะห์ลำดับการกระทำ สกอริ่งเซสชัน กับดัก honeypot การทำให้ข้อมูลสับสนและลายน้ำในข้อมูล ใช้ได้ผลกับบอทขั้นสูงที่ผ่านสองชั้นแรกมาแล้ว
ความคิดหลักที่เราจะกลับมาพูดซ้ำ: ไม่มีชั้นใดเพียงพอด้วยตัวเอง จุดแข็งอยู่ที่บอทต้องหลบเลี่ยงทั้งสามชั้นพร้อมกัน และอุปสรรคแต่ละชั้นเพิ่มขึ้นจะทำให้ต้นทุนการทำงานของมันสูงขึ้น เมื่อการดึงข้อมูลของคุณแพงกว่าการซื้อข้อมูลถูกกฎหมายหรือเก็บด้วยวิธีอื่น การดึงข้อมูลก็หยุด นี่คือเศรษฐศาสตร์ ไม่ใช่เวทมนตร์
คำศัพท์พื้นฐานที่จะเจอต่อไป
- Rate limiting — การจำกัดจำนวนคำขอจากแหล่งเดียวต่อหน่วยเวลา
- WAF (Web Application Firewall) — ไฟร์วอลล์ระดับแอปพลิเคชันที่กรองคำขอ HTTP ตามกฎ
- Fingerprint (ลายนิ้วมือ) — ชุดคุณลักษณะของไคลเอนต์ที่ใช้ระบุประเภทหรืออินสแตนซ์เฉพาะ
- Headless browser — เบราว์เซอร์เต็มรูปแบบที่ไม่มีส่วนติดต่อกราฟิก ควบคุมด้วยโปรแกรม
- Challenge — งานตรวจสอบที่ไคลเอนต์ต้องแก้เพื่อเข้าถึง
- False positive — สถานการณ์ที่ระบบป้องกันบล็อกผู้ใช้จริง
- Honeypot — กับดัก: องค์ประกอบที่มนุษย์มองไม่เห็น แต่ไคลเอนต์อัตโนมัติสังเกตเห็น
เจาะลึก: ระบบป้องกันบอทสมัยใหม่ "มองเห็น" ผู้เข้าชมอย่างไร
เพื่อติดตั้งระบบป้องกันอย่างมีสติ ต้องเข้าใจว่ามันอาศัยสัญญาณอะไร นี่คือส่วนที่น่าสนใจที่สุด: ในช่วงห้าปีที่ผ่านมา อุตสาหกรรมเดินทางจาก "แบน IP" ไปสู่การสกอริ่งหลายชั้นที่ตัดสินใจจากหลายร้อยคุณลักษณะ มาดูกลุ่มสัญญาณหลัก
สัญญาณเครือข่าย และทำไม IP ไม่ใช่ตัวหลักอีกต่อไป
ในอดีตสัญญาณแรกของบอทคือที่อยู่ IP คำขอจาก data center? น่าจะสคริปต์ พันคำขอจากที่อยู่เดียว? แน่ใจว่าสคริปต์ วิธีนี้ยังได้ผลกับ parser ขี้เกียจที่วิ่งตรงจากเซิร์ฟเวอร์คลาวด์ และควรนำมาใช้ แต่มีข้อจำกัดพื้นฐานสองประการ
ประการแรก: ที่อยู่ residential และ mobile ผู้อ่านบล็อกนี้รู้ดีกว่าหลายคนว่า เนื่องจาก NAT ที่อยู่ IP มือถือของโอเปอเรเตอร์หนึ่งแห่งสามารถมีสมาชิกจริงหลายพันคนพร้อมกัน การบล็อกที่อยู่ดังกล่าวเพราะไคลเอนต์น่าสงสัยรายเดียว จะตัดพื้นที่ทั้งอำเภอออกจากเว็บไซต์ของคุณ ฐานชื่อเสียงสำหรับเครือข่ายมือถือแทบไร้ประโยชน์: ที่อยู่ที่สแครปเปอร์ใช้เมื่อวาน วันนี้อาจเป็นของคุณลูกค้า ดังนั้นระบบป้องกันบอทที่ถูกต้องใช้ IP เป็นเพียงสัญญาณอ่อนตัวหนึ่ง ไม่ใช่เหตุผลสำหรับการตัดสิน
ประการที่สอง: การกระจาย parser สมัยใหม่หมุนเวียนที่อยู่จนแต่ละแห่งมี 2-3 คำขอต่อชั่วโมง เกณฑ์ rate limiting ที่เพียงพอตัดไคลเอนต์แบบนี้ จะกระทบคนจริงที่เปิดแคตตาล็อกสิบบานอย่างแน่นอน
อะไรยังมีประโยชน์ในระดับเครือข่าย? ลักษณะ ASN (เครือข่ายเป็นของผู้ให้บริการโฮสติ้ง) ความผิดปกติทางภูมิศาสตร์ (ทราฟฟิกจากประเทศที่คุณไม่ได้ดำเนินธุรกิจ) ความไม่สอดคล้องระหว่างตำแหน่ง IP และภาษาของเบราว์เซอร์ สถิติตาม subnet ไม่ใช่ตามที่อยู่เดี่ยว
ลายนิ้วมือระดับ transport และ protocol
นี่คือสัญญาณที่หลายคนมองข้าม เมื่อไคลเอนต์สร้างการเชื่อมต่อที่ปลอดภัย มันส่งข้อความทักทาย TLS พร้อมรายการ cipher ที่รองรับ extensions และลำดับของมัน ชุดนี้ขึ้นอยู่กับไลบรารีที่ไคลเอนต์ใช้ Chrome บน Windows สร้างข้อความทักทายแบบหนึ่ง Firefox อีกแบบ และไลบรารี Python สำหรับคำขอ HTTP อีกแบบที่ไม่เหมือนเบราว์เซอร์เลย แฮชของชุดนี้เรียกว่า TLS fingerprint (scheme ที่แพร่หลายคือ JA3 และ JA4 ที่ใหม่กว่า)
ความมหัศจรรย์คือ parser ปลอม User-Agent ได้ในเสี้ยววินาที แต่ปลอม TLS fingerprint ให้ตรงกับเบราว์เซอร์ที่อ้างนั้นยากกว่ามาก หากไคลเอนต์อ้างว่าเป็น Chrome เวอร์ชันล่าสุด แต่ข้อความทักทาย TLS ตรงกับไลบรารี console แสดงว่าเป็นสคริปต์ ลายนิ้วมือที่คล้ายกันมีสำหรับ HTTP/2 (ลำดับและค่าของเฟรม SETTINGS ลำดับความสำคัญของ stream) และ HTTP/3 การรวมกันของ "เบราว์เซอร์ที่อ้าง + TLS + HTTP/2" ให้ความแม่นยำในการจำแนกที่ดีโดยไม่ต้องใช้ JavaScript แม้แต่บรรทัดเดียว
ลายนิ้วมือเบราว์เซอร์และสัญญาณของระบบอัตโนมัติ
เมื่อไคลเอนต์รัน JavaScript ขอบเขตการวิเคราะห์ก็ขยายออกไปหลายเท่า สคริปต์ป้องกันรวบรวมพารามิเตอร์หลายร้อยรายการ: ความละเอียดหน้าจอและอัตราส่วนต่อขนาดหน้าต่าง รายการฟอนต์ ผลการเรนเดอร์กราฟิกผ่าน Canvas และ WebGL ลักษณะของ audiocontext เขตเวลา การตั้งค่าภาษา การมีอยู่และพฤติกรรมของออบเจ็กต์เฉพาะของสภาพแวดล้อม แยกตรวจสอบสัญญาณของระบบอัตโนมัติ: คุณสมบัติที่โหมด headless ทิ้งไว้ในสภาพแวดล้อม ความไม่สอดคล้องระหว่างแพลตฟอร์มที่อ้างกับความสามารถจริง ค่าที่ "สมบูรณ์แบบเกินไป" ในจุดที่อุปกรณ์จริงมีสัญญาณรบกวนเสมอ
สิ่งสำคัญที่ต้องเข้าใจ: เป้าหมายไม่ใช่ระบุตัวบุคคลอย่างชัดเจน (ทั้งอ่อนไหวทางกฎหมายและไม่น่าเชื่อถือทางเทคนิค) แต่คือการค้นหา ความขัดแย้งภายใน iPhone จริงไม่รายงานว่ามีคอร์โปรเซสเซอร์ 32 คอร์ Chrome จริงบน Android ไม่มีความละเอียดหน้าจอ 1920x1080 โดยไม่มีการป้อนข้อมูลแบบสัมผัส ความขัดแย้งแต่ละอย่างเพิ่มคะแนนความน่าสงสัย
สัญญาณพฤติกรรม
คลาสคุณลักษณะที่ปลอมแปลงยากที่สุดคือพฤติกรรมเมื่อเวลาผ่านไป มนุษย์ขยับเคอร์เซอร์ด้วยการสั่นไหวและความเร่งระดับไมโคร เลื่อนหน้าไม่สม่ำเสมอ หยุดอ่านเป็นช่วงๆ คลิกไม่ตรงศูนย์กลางปุ่มเป๊ะ มนุษย์เข้าหน้าหลัก ไปหมวดหมู่ ดูสินค้าสามสี่ชิ้น กลับมา บอทเปิดการ์ดสินค้าห้าร้อยรายการติดกันตาม ID จากน้อยไปมาก แต่ละรายการห่างกัน 1.2 วินาทีพอดี ไม่โหลดรูปภาพและไม่ขอ CSS แม้ parser ขั้นสูงบน managed browser ก็เผยตัวผ่านโครงสร้างของเซสชัน: เป็นไปไม่ได้ที่จะดึงแคตตาล็อกทั้งหมดโดยทำตัวเหมือนผู้ซื้อคนเดียว
สกอริ่งแทนการตัดสินแบบขาวดำ
ระบบสมัยใหม่ไม่ตอบคำถาม "บอทหรือมนุษย์" แบบไบนารี แต่ให้ คะแนนความเสี่ยง กับแต่ละคำขอหรือเซสชัน แล้วใช้นโยบาย: ความเสี่ยงต่ำ — ปล่อย ความเสี่ยงกลาง — แสดง challenge ล่องหนหรือตอบช้าลง ความเสี่ยงสูง — แคปช่า หรือบล็อก ความเสี่ยงวิกฤต — ส่งข้อมูลที่ดูน่าเชื่อถือแต่บิดเบือน วิธีนี้ลด false positive ได้มาก: ไคลเอนต์ที่น่าสงสัยไม่ถูกปิดประตูใส่ แต่ได้โอกาสพิสูจน์ว่ามีชีวิต
สิ่งที่เปลี่ยนไปในปี 2026
เทรนด์หลายอย่างที่ส่งผลต่อการออกแบบการป้องกันแล้ว:
- เอเจนต์ AI เป็นคลาสไคลเอนต์ใหม่ เอเจนต์ที่ขับเคลื่อนด้วยโมเดลภาษาควบคุมเบราว์เซอร์จริง อ่านหน้าเว็บ และมีพฤติกรรมเกือบเหมือนมนุษย์ บางส่วนมีประโยชน์ (พาผู้ซื้อมา) บางส่วนเป็นสแครปเปอร์ที่ฉลาดกว่า เว็บไซต์จะต้องกำหนดนโยบายชัดเจนสำหรับทราฟฟิกนี้
- การสร้างมาตรฐานการระบุบอท "อย่างมีจริยธรรม" กลไกที่ไคลเอนต์อัตโนมัติที่ถูกกฎหมายพิสูจน์ตนเข้ารหัสว่าเป็นของบริษัทใด ช่วยให้ปล่อยบอทที่มีประโยชน์โดยไม่ต้อง challenge
- การรับรองอุปกรณ์และโทเค็นความเชื่อถือ ระบบปฏิบัติการและเบราว์เซอร์ทดลองกลไกที่ให้เว็บไซต์ยืนยันได้ว่า "นี่คืออุปกรณ์จริงที่มีมนุษย์จริง" โดยไม่ต้องเก็บลายนิ้วมือ ในอนาคตจะช่วยให้ป้องกันง่ายขึ้น แต่ตอนนี้ความครอบคลุมยังจำกัด
- การเติบโตของ HTTP/3 และการเข้ารหัส metadata สัญญาณเครือข่ายที่คุ้นเคยบางส่วนเข้าถึงได้น้อยลง ทำให้เน้นการวิเคราะห์พฤติกรรมมากขึ้น
- แรงกดดันด้านกฎระเบียบต่อการเก็บข้อมูลผู้ใช้ ลายนิ้วมือเบราว์เซอร์และการเก็บเซสชันต้องคำนึงถึงกฎหมายคุ้มครองข้อมูลส่วนบุคคล ต้องออกแบบการป้องกันให้เก็บเท่าที่จำเป็น
ข้อสรุปจากส่วนนี้ง่ายและสำคัญ: การป้องกันการดึงข้อมูลที่เชื่อถือได้สร้างจากสัญญาณอ่อนหลายตัวรวมกัน ไม่ใช่คุณลักษณะ "เงิน" ตัวเดียว จำไว้เมื่อไปสู่ภาคปฏิบัติ
วิธีที่ 1. การวินิจฉัย: ค้นหาว่าใครและอย่างไรกำลังดึงข้อมูลคุณ
ติดตั้งการป้องกันแบบเดาสุ่มเป็นวิธีที่แน่นอนที่สุดในการใช้จ่ายงบและบล็อกผิดคน ก่อนติดตั้งอะไร ใช้เวลา 1-2 วันในการสอดแนม ข่าวดีคือไม่ต้องใช้เครื่องมือแพง แค่ log ของเว็บเซิร์ฟเวอร์และความสามารถในการถามคำถามที่ถูกต้อง
ขั้นที่ 1. รวบรวม log ครบถ้วนในช่วงที่เป็นตัวแทน
อย่างน้อยเจ็ดวันเพื่อจับรอบสัปดาห์ log ต้องมี: เวลา IP วิธีและเส้นทางคำขอ โค้ดตอบกลับ ขนาดคำตอบ User-Agent Referer เวลาประมวลผล หากเว็บเซิร์ฟเวอร์เขียนเฉพาะรูปแบบมาตรฐาน ให้ขยาย สำหรับโปรเจกต์ที่มีคำขอหลายล้านต่อวัน สะดวกที่สุดในการส่ง log ไปยังฐานข้อมูลวิเคราะห์หรืออย่างน้อยรูปแบบตาราง
ขั้นที่ 2. ค้นหาความผิดปกติในโครงสร้างทราฟฟิก
ถาม log คำถามต่อไปนี้และจดคำตอบ — นี่คือ baseline ของคุณ
- การกระจายตามชั่วโมง ทราฟฟิกจริงมีวัฏจักรประจำวัน "ชั้น" แบนๆ ตอนกลางคืนหรือการพุ่งขึ้นตอน 4 ทุ่มเป็นเครื่องหมายแรก
- อัตราส่วนประเภททรัพยากร มีคำขอ HTML กี่รายการต่อ CSS, JS และรูปภาพหนึ่งรายการ? สำหรับเบราว์เซอร์อัตราส่วนนี้ประมาณ 1:10-30 สำหรับ parser — 1:0 ค้นหาที่อยู่และ subnet ที่ขอเฉพาะ HTML หรือเฉพาะ JSON
- ความลึกของการท่อง ใครเปิดการ์ดสินค้ามากกว่า 100 รายการต่อเซสชัน? ใครไล่ ID หน้าตัวเลข ชุดค่าผสมของฟิลเตอร์ตามลำดับ?
- Header เบราว์เซอร์เวอร์ชันเก่า User-Agent ว่างเปล่าหรือของไลบรารี ไม่มี Accept-Language User-Agent เดียวกันบนที่อยู่หลายพันแห่ง
- โค้ดตอบกลับ 404 มากมายบน ID ที่ไม่มี — สัญญาณของการไล่ 429 หรือ 403 มากมาย — ใครบางคนติดขีดจำกัดของคุณแล้ว
- Autonomous Systems จัดกลุ่ม IP ตาม ASN สัดส่วนของผู้ให้บริการโฮสติ้งในทราฟฟิกแคตตาล็อกสูงกว่า 5-10% — เกือบแน่นอนว่าบอท
ขั้นที่ 3. ประเมินความเสียหายเป็นตัวเงิน
แปลสิ่งที่พบเป็นภาษาธุรกิจ ไม่เช่นนั้นการป้องกันจะไม่ได้รับงบ ประเมิน: สัดส่วนทราฟฟิกปรสิตและต้นทุนในโครงสร้างพื้นฐาน ภาระบน API ภายนอกที่เสียเงิน (อัตราแลกเปลี่ยน การเข้ารหัสภูมิศาสตร์ การค้นหา) ที่บอทสร้างขึ้น การบิดเบือน analytics (เซสชันปลอมทำลาย attribution ของโฆษณา ซึ่งเกี่ยวข้องโดยตรงกับนักการตลาด) ผลประโยชน์ที่สูญเสียจากการคัดลอกราคาและคอนเทนต์ แม้แต่การประเมินคร่าวๆ อย่าง "บอททำให้เราเสีย 180,000 รูเบิลต่อเดือนในโครงสร้างพื้นฐานและจำนวนที่ไม่รู้จักในตำแหน่งการแข่งขัน" เปลี่ยนบทสนทนากับผู้บริหาร
ขั้นที่ 4. วางกับดักเพื่อยืนยันสมมติฐาน
log แสดงว่าใครบางคนอยู่ แต่ไม่แสดงว่าเขาต้องการอะไรจริงๆ เสริมการวิเคราะห์ด้วยการสอดแนมเชิงรุก:
- รายการ canary เพิ่มสินค้าที่ไม่มีอยู่จริงพร้อมชื่อไม่ซ้ำซึ่งไม่ถูกจัดทำดัชนีโดยเครื่องมือค้นหาและไม่แสดงใน navigation แต่เข้าถึงได้ผ่านลิงก์ตรงจากหน้าตัวเลข การปรากฏของชื่อนี้บนเว็บไซต์อื่นเป็นหลักฐานของการดึงข้อมูลและระบุแหล่งที่มา
- ลิงก์ที่ซ่อนอยู่ ลิงก์ที่มองไม่เห็นสำหรับมนุษย์ (นอกจอ ไม่มีขนาด) แต่มีอยู่ใน HTML มนุษย์จะไม่คลิก มันทุกครั้งที่คลิก — บอท อย่าลืมปิดจากบอทค้นหาผ่านกฎการยกเว้น
- ช่องว่างเฉพาะและความแตกต่างเล็กน้อย ลักษณะการจัดรูปแบบเฉพาะเล็กๆ ในคำอธิบาย ที่ใช้ระบุข้อความที่คัดลอกในภายหลัง
ขั้นที่ 5. สร้างโปรไฟล์ของ parser
ผลลัพธ์ของการวินิจฉัยควรเป็นตาราง 3-5 โปรไฟล์ ตัวอย่าง: "โปรไฟล์ A: สคริปต์คลาวด์ไม่มี JS 40,000 คำขอไปยังการ์ดต่อคืน User-Agent ของ Chrome เก่า subnet เดียว" "โปรไฟล์ B: ไคลเอนต์กระจายบนที่อยู่ residential 2-3 คำขอต่อที่อยู่ รัน JS ไปตามฟิลเตอร์ราคาเท่านั้น" "โปรไฟล์ C: แอกกริเกเตอร์ แสดงตัวตนอย่างซื่อสัตย์ ดึงฟีดวันละครั้ง" สำหรับโปรไฟล์แต่ละแบบชัดเจนว่าชั้นป้องกันใดจะหยุดมัน โปรไฟล์ A จะล้มบนชั้นแรก โปรไฟล์ B ต้องการการวิเคราะห์พฤติกรรม โปรไฟล์ C อาจคุ้มค่าที่จะเสนอ API พันธมิตร — บางครั้งก็ทำกำไรได้มากกว่าการทำสงคราม
เช็คลิสต์การวินิจฉัย
- รวบรวม log 7+ วันพร้อมฟิลด์ครบถ้วน
- สร้างการกระจายทราฟฟิกตามชั่วโมงและประเภททรัพยากร
- ระบุ 20 subnet และ ASN สูงสุดตามจำนวนคำขอไปยัง URL "มีค่า"
- พบเซสชันที่มีความลึกและความสม่ำเสมอผิดปกติ
- คำนวณสัดส่วนทราฟฟิกปรสิตและต้นทุน
- วางรายการ canary และลิงก์ที่ซ่อนอยู่
- สร้างโปรไฟล์ parser พร้อมระบุชั้นป้องกันเป้าหมาย
- ระบุบอทที่ถูกกฎหมายที่ห้ามแตะ: เครื่องมือค้นหา webhook การชำระเงิน พันธมิตร การตรวจสอบ
วิธีที่ 2. แนวแรก: ระดับเซิร์ฟเวอร์และเครือข่าย
แนวแรกคือรากฐาน มันจะไม่หยุด parser ขั้นสูง แต่จะตัดบอทพื้นฐาน 50-70% ได้ภายในวันเดียวและแทบไม่มีค่าใช้จ่าย การข้ามขั้นตอนนี้เพื่อไปใช้โซลูชันแพงๆ เป็นความผิดพลาด: ทำไมต้องจ่ายสำหรับการวิเคราะห์ทุกคำขอ ถ้าครึ่งหนึ่งตัดออกได้ด้วยกฎง่ายๆ?
Rate limiting ที่ตั้งค่าอย่างถูกต้อง
Rate limiting เป็นเครื่องมือที่รู้จักดีที่สุดและตั้งค่าผิดบ่อยที่สุด ข้อผิดพลาดทั่วไป: ขีดจำกัดเดียวทั่วทั้งเว็บไซต์ต่อ IP ผลลัพธ์คือขีดจำกัดอ่อนเกินไปและไร้ประโยชน์ หรือเข้มเกินไปและกระทบสำนักงาน มหาวิทยาลัย และเครือข่ายมือถือที่มี NAT วิธีที่ถูกต้องคือ ขีดจำกัดที่แตกต่างกัน:
- ตามประเภททรัพยากร static และหน้าหลัก — ขีดจำกัดใจกว้าง การ์ดสินค้า ผลการค้นหา endpoint JSON ของแคตตาล็อก — เข้มขึ้นอย่างชัดเจน ฟอร์มเข้าสู่ระบบและสมัครสมาชิก — เข้มมาก
- ตามคีย์ ไม่ใช่แค่ IP รวม: IP + path, IP + User-Agent, cookie เซสชัน สำหรับผู้ใช้ที่ล็อกอิน — ตัวระบุบัญชี สำหรับเครือข่ายมือถือ ขีดจำกัดตาม subnet /24 หรือตาม ASN ด้วยเกณฑ์สูงดีกว่าขีดจำกัดเข้มตามที่อยู่เดี่ยว
- ตามหน้าต่างเวลา สองหน้าต่าง: สั้น (เช่น 20 คำขอใน 10 วินาที — ต่อการพุ่ง) และยาว (เช่น 600 คำขอไปยังการ์ดต่อชั่วโมง — ต่อการท่องช้าๆ) parser ช้าแต่ดื้อจะตกในหน้าต่างที่สอง มนุษย์ไม่
- ตามประเภทการตอบสนอง การเกินขีดจำกัดไม่จำเป็นต้องหมายถึงการบล็อก ขั้นแรก — หน่วงเวลาตอบ 2-5 วินาที ขั้นที่สอง — โค้ด 429 พร้อม header Retry-After ขั้นที่สาม — แบนชั่วคราว 10-15 นาที การยกระดับทีละขั้นแทบไม่กระทบคนและชะลอบอทอย่างมาก
ตัวอย่างการตั้งค่าโซนพื้นฐานสำหรับเว็บเซิร์ฟเวอร์ยอดนิยมที่คุณปรับให้เข้ากับตัวเอง (ค่าเป็นตัวอย่าง):
limit_req_zone $binary_remote_addr zone=catalog_burst:20m rate=3r/s;limit_req_zone $binary_remote_addr zone=login:10m rate=10r/m;location /catalog/ { limit_req zone=catalog_burst burst=15 delay=8; }location /login { limit_req zone=login burst=3 nodelay; limit_req_status 429; }สังเกตพารามิเตอร์ delay: ช่วยให้ส่วนหนึ่งของการพุ่งได้รับการตอบสนองทันที ส่วนที่เหลือตอบช้า ซึ่งสบายสำหรับคนที่เปิดสิบบานและไม่สบายสำหรับสคริปต์
การกรองตามลักษณะเครือข่าย
กำหนดนโยบายสำหรับ Autonomous Systems ผู้ให้บริการโฮสติ้งและคลาวด์เป็นแหล่งของ parser พื้นฐานส่วนใหญ่ การบล็อกทั้งหมดไม่เสมอไป (proxy องค์กรและบริการที่ถูกกฎหมายบางส่วนก็มาจากที่นั่น) แต่การใช้ขีดจำกัดเข้มและ JavaScript challenge บังคับเป็นเรื่องสมเหตุสมผล สำหรับประเทศที่คุณไม่ได้ทำธุรกิจ — เช่นเดียวกัน: ไม่บล็อก แต่ยกระดับการตรวจสอบ จำวิธี "สัญญาณอ่อนเพิ่มคะแนน" ไม่ใช่ "สัญญาณเดียวตัดสินทุกอย่าง"
กฎระดับ header
กฎราคาถูกแต่ได้ผลหลายข้อสำหรับ WAF หรือการตั้งค่าเซิร์ฟเวอร์:
- ปฏิเสธคำขอที่มี User-Agent ว่างหรือมีลายเซ็นของไลบรารี HTTP ที่รู้จักไปยัง URL ที่ไม่ใช่ service ที่ถูกกฎหมายต้องใช้ API เฉพาะที่มีคีย์ ไม่ใช่หน้าเว็บสาธารณะ
- ต้องให้ header สอดคล้องกัน: Chrome ที่อ้างขาด header client hints ที่เป็นลักษณะเฉพาะ — น่าสงสัย
- ส่งคืน 404 หรือ 410 สำหรับรูปแบบ URL เก่าที่ parser ยังคงเรียกตาม sitemap เก่า
- ซ่อนเวอร์ชันของซอฟต์แวร์เซิร์ฟเวอร์และเฟรมเวิร์กใน header — ไม่ใช่เพื่อป้องกันการดึงข้อมูล แต่เพื่อสุขอนามัยทั่วไป
กฎสำหรับบอทและนโยบายชัดเจน
ไฟล์กฎสำหรับบอทค้นหาไม่ใช่เครื่องมือป้องกัน — บอทที่เป็นอันตรายเพิกเฉย แต่สำคัญด้วยสองเหตุผล ประการแรก ช่วยให้อนุญาตบอทที่มีประโยชน์อย่างชัดเจนและห้ามครอว์เลอร์ที่ไม่พึงประสงค์ รวมถึงตัวรวบรวมข้อมูลสำหรับโมเดล AI — ผู้ประกอบการที่ซื่อสัตย์ปฏิบัติตามกฎเหล่านี้ ประการที่สอง มันกำหนดจุดยืนของคุณ: การรวมกฎทางเทคนิคและข้อกำหนดการใช้งานของเว็บไซต์ทำให้การเก็บข้อมูลโดยไม่ได้รับอนุญาตเสี่ยงทางกฎหมายมากขึ้นสำหรับผู้ที่ทำ ต้องระบุในข้อตกลงผู้ใช้ว่าห้ามเก็บข้อมูลอัตโนมัติโดยไม่ได้รับอนุญาตเป็นลายลักษณ์อักษร
Caching เป็นการป้องกัน
เทคนิคที่ไม่ชัดเจน: caching หน้าที่ "มีค่า" อย่างเข้มข้นในระดับ CDN หรือ reverse proxy ไม่ได้ขัดขวาง parser จากการดึงข้อมูล แต่ขจัดความเจ็บปวดหลัก — ภาระบนแอปพลิเคชันและฐานข้อมูล หากบอทดึงแคตตาล็อกจาก cache โครงสร้างพื้นฐานของคุณแทบไม่สนใจ นี่ไม่ใช่ชัยชนะ แต่เป็นเวลาที่ได้มาเพื่อสร้างชั้นถัดไปโดยไม่ต้องดับเพลิง
เช็คลิสต์แนวแรก
- ระบุกลุ่ม URL ที่มีมูลค่าต่างกันและตั้งค่าขีดจำกัดของแต่ละกลุ่ม
- ใช้หน้าต่างขีดจำกัดสองแบบ: สั้นและยาว
- การตอบสนองต่อการเกิน — ยกระดับ: หน่วง 429 แบนชั่วคราว
- ขีดจำกัดสำหรับเครือข่ายมือถือและ residential ผ่อนปรนหรือนับตาม subnet
- ASN ของโฮสติ้งและภูมิภาคที่ไม่ใช่เป้าหมายเปลี่ยนเป็นโหมดตรวจสอบเพิ่ม ไม่ใช่แบน
- ตั้งกฎตาม header เพื่อตัดไคลเอนต์ไลบรารี
- กำหนดนโยบายสำหรับบอทและข้อห้ามทางกฎหมายต่อการเก็บข้อมูล
- เปิด caching สำหรับหน้าที่มีค่าแพง
- ตรวจสอบและจัดทำเอกสารข้อยกเว้นสำหรับเครื่องมือค้นหา ระบบชำระเงิน และพันธมิตร
วิธีที่ 3. แนวที่สอง: การตรวจสอบไคลเอนต์และ challenge
แนวแรกทำงานตามลักษณะของคำขอเอง แนวที่สองไปไกลกว่านั้นและถามไคลเอนต์ว่า: "พิสูจน์ว่าคุณเป็นเบราว์เซอร์ และพิสูจน์ว่ามีมนุษย์อยู่ข้างหลัง" นี่คือจุดที่สคริปต์ที่ไม่รัน JavaScript และเครื่องมือ headless ที่ตั้งค่าเร็วๆ ถูกตัดออก มาดูเครื่องมือของชั้นนี้ตามลำดับ "ราคา" ที่เพิ่มขึ้นสำหรับผู้ใช้
ลายนิ้วมือ TLS และ HTTP/2: ฟิลเตอร์ไร้รอยต่อ
เริ่มจากสิ่งที่ผู้ใช้ไม่สังเกตเลย บน load balancer หรือ reverse proxy คำนวณ TLS fingerprint ของการเชื่อมต่อและเปรียบเทียบกับ User-Agent ที่อ้าง ตรรกะทั่วไป:
- fingerprint ตรงกับไลบรารี HTTP ที่รู้จัก แต่ User-Agent อ้างว่าเป็นเบราว์เซอร์ — ความเสี่ยงสูง
- fingerprint ตรงกับเบราว์เซอร์ แต่ไม่ใช่ตระกูลหรือเวอร์ชันที่ระบุใน header — ความเสี่ยงกลาง
- fingerprint ปรากฏบนเว็บไซต์เป็นครั้งแรกและมีอยู่บนที่อยู่หลายพันแห่งพร้อมกัน — สงสัยเครื่องมือ parser ใหม่
รายละเอียดสำคัญในการนำไปใช้: อย่าบล็อกตาม TLS fingerprint ในวันแรก เก็บสถิติหนึ่งสัปดาห์ ค้นหาว่า fingerprint ใดสอดคล้องกับผู้ชมจริงของคุณ (รวมถึงเบราว์เซอร์ในแอปมือถือและ web view ของแอปแชทที่มี fingerprint เฉพาะ) แล้วเปลี่ยนกฎเป็นโหมดทำงาน ไม่เช่นนั้นคุณเสี่ยงตัดผู้ใช้ที่เปิดเว็บไซต์ของคุณจาก Telegram หรือโปรแกรมอีเมล
JavaScript challenge: การตรวจสอบสภาพแวดล้อมการทำงาน
JS challenge พื้นฐานคือสคริปต์เล็กๆ ที่ไคลเอนต์ต้องรันเพื่อรับ cookie การเข้าถึง หากไม่มี cookie เซิร์ฟเวอร์ส่ง placeholder แทนคอนเทนต์ สคริปต์ง่ายๆ บนไลบรารี HTTP ไม่รัน JavaScript และค้างอยู่หน้าประตู เวอร์ชันขั้นสูงกว่ารวบรวมลักษณะของสภาพแวดล้อมและตรวจสอบความสอดคล้องตามที่พูดในส่วนสัญญาณ
คำแนะนำเชิงปฏิบัติสำหรับการนำไปใช้:
- อย่าแสดง challenge กับทุกคน ใช้กับคำขอที่มีคะแนนความเสี่ยงกลางและส่วนที่มีค่า หน้าหลักและ landing page ที่โฆษณาชี้นำต้องเปิดทันที — ทุกวินาทีที่เพิ่มก่อนหน้าจอแรกมีค่าใช้จ่ายต่อ conversion และนัก arbitrage รู้เรื่องนี้ดีกว่าทุกคน
- ทำให้ challenge ล่องหน สคริปต์ควรรันในพื้นหลังภายใน 100-300 มิลลิวินาที โดยไม่มีหน้าจอสีขาวและข้อความ "กำลังตรวจสอบเบราว์เซอร์ของคุณ" สำหรับไคลเอนต์ที่ซื่อสัตย์กระบวนการมองไม่เห็น
- ผูกผลลัพธ์กับเซสชัน ไม่ใช่ IP cookie การเข้าถึงต้องถูกเซ็น มีอายุ และมีแฮชของคุณลักษณะสำคัญของไคลเอนต์ จากนั้นไม่สามารถคัดลอกและแจกจ่ายให้เธรด parser ร้อยเธรดได้
- เปลี่ยน challenge เป็นประจำ การตรวจสอบแบบ static จะถูกถอดรหัสในหนึ่งสัปดาห์ ทำให้โค้ดสับสน เปลี่ยนพารามิเตอร์ที่ตรวจ สลับคีย์ลายเซ็น
- ตรวจสอบความสอดคล้องของข้อมูล JS กับฝั่งเซิร์ฟเวอร์ เขตเวลาจากสคริปต์ไม่ตรงกับตำแหน่ง IP? แพลตฟอร์มที่อ้างไม่ตรงกับ TLS fingerprint? ทุกความไม่สอดคล้องคือคะแนนความเสี่ยง
Proof of work: อุปสรรคทางเศรษฐกิจ
เทคนิคที่สง่างามและกำลังได้ความนิยมเป็นทางเลือกแทนแคปช่า เซิร์ฟเวอร์มอบงานคำนวณให้ไคลเอนต์ (เช่น หาค่าที่แฮชขึ้นต้นด้วยเลขศูนย์จำนวนหนึ่ง) เบราว์เซอร์บนมือถือแก้ได้ใน 200-500 มิลลิวินาทีโดยที่มนุษย์ไม่รู้ตัว แต่ parser ที่ทำ 100,000 คำขอต้องใช้เวลาชั่วโมงของ CPU ความยากของงานสามารถเพิ่มตามคะแนนความเสี่ยง: ไคลเอนต์น่าสงสัย — งานหนักกว่าสิบเท่า มนุษย์ไม่รู้สึกถึงความแตกต่าง บอท — รู้สึกมาก
แคปช่า: ใช้ที่ไหนเหมาะสมและที่ไหนทำลาย
แคปช่าเป็นเครื่องมือที่สังเกตได้ชัดที่สุดและน่ารำคาญที่สุด การศึกษา UX แสดงอย่างสม่ำเสมอ: แคปช่าทุกตัวบนเส้นทางสู่การซื้อลด conversion และสำหรับผู้ใช้มือถือความสูญเสียสูงกว่า ดังนั้นกฎง่ายๆ: แคปช่าเป็นข้อโต้แย้งสุดท้าย ไม่ใช่การตรวจสอบแรก จุดที่เหมาะสม:
- ฟอร์มเข้าสู่ระบบหลังจากพยายามล้มเหลวหลายครั้ง
- การสมัครสมาชิกและการกู้คืนรหัสผ่าน
- การส่งฟอร์มติดต่อและรีวิว
- สถานการณ์ที่คะแนนความเสี่ยงของเซสชันสูงแล้วแต่ไคลเอนต์ยังพยายามท่องแคตตาล็อก
- การป้องกันการดำเนินการสำคัญ: การจอง การใช้โค้ดโปรโมชัน การเพิ่มสินค้าขาดตลาดลงตะกร้า
จุดที่ไม่เหมาะสม: หน้าหลัก การ์ดสินค้า การค้นหา landing page ของแคมเปญโฆษณา หากคุณต้องใส่แคปช่าบนแคตตาล็อก แสดงว่าชั้นก่อนหน้าไม่ทำงาน และต้องรักษาสิ่งนั้น แยก: เลือกแคปช่าสมัยใหม่ที่มีโหมดล่องหนและความยากแบบปรับได้ ไม่ใช่ภาพที่มีตัวอักษรบิดเบี้ยวจากยุค 2000
การป้องกัน API และแอปมือถือ
บ่อยครั้ง parser ไม่ได้เข้าเว็บไซต์ด้วยซ้ำ — พบ endpoint JSON ที่ frontend ของคุณใช้ และดึงข้อมูลที่สะอาดโดยไม่ต้องแยกวิเคราะห์ HTML ตรวจสอบ: API แคตตาล็อกของคุณเข้าถึงได้โดยไม่มี cookie เซสชันและไม่มีคำขอที่เซ็นชื่อหรือไม่? ถ้าใช่ การป้องกันเว็บไซต์ทั้งหมดก็ไร้ความหมาย ชุดขั้นต่ำ: โทเค็นที่เซ็นชื่ออายุสั้นที่ออกหลังผ่าน challenge การผูกโทเค็นกับเซสชัน การจำกัดขนาดผลลัพธ์และความลึกของหน้าตัวเลข ขีดจำกัดที่เข้มกว่าสำหรับ API สำหรับแอปมือถือ — ตรวจสอบความถูกต้องของแอปผ่านแพลตฟอร์มและ certificate pinning
เช็คลิสต์แนวที่สอง
- คำนวณ TLS/HTTP2 fingerprint รวบรวมสถิติหนึ่งสัปดาห์ของผู้ชม
- กฎตาม fingerprint เปลี่ยนเป็นโหมดทำงานหลังการวิเคราะห์
- JS challenge ติดตั้งแบบล่องหนและใช้แบบปรับได้ตามคะแนนความเสี่ยง
- cookie การเข้าถึงถูกเซ็น ผูกกับไคลเอนต์ มีอายุ
- ใช้ proof of work พร้อมความยากแบบปรับได้
- แคปช่าอยู่เฉพาะฟอร์มและการดำเนินการสำคัญ ไม่ใช่แคตตาล็อก
- API แคตตาล็อกป้องกันด้วยโทเค็นและขีดจำกัด ไม่สามารถเข้าถึงได้โดยไม่มีเซสชัน
- การตรวจสอบทั้งหมดทดสอบใน web view ของแอปแชทและเบราว์เซอร์มือถือ
วิธีที่ 4. แนวที่สาม: พฤติกรรม กับดัก และการป้องกันข้อมูลเอง
สมมติว่า parser ผ่านสองชั้นแรก: วิ่งจากที่อยู่ residential ควบคุมเบราว์เซอร์จริงกับ fingerprint ที่น่าเชื่อถือ รัน challenge แล้ว อะไรต่อไป? ต่อไปเราเปลี่ยนจากคำถาม "คุณคือใคร" เป็น "คุณกำลังทำอะไร" และท้ายที่สุดคือการทำให้เหยื่อเองไร้ค่า นี่คือชั้นที่ชาญฉลาดที่สุดของระบบป้องกันบอทสำหรับเว็บไซต์ และเป็นสิ่งที่แยกแยะระบบที่เป็นผู้ใหญ่ออกจากชุดกฎ
การสกอริ่งพฤติกรรมของเซสชัน
รากฐานของแนวที่สามคือการสะสมคะแนนความเสี่ยงตามเซสชันเมื่อเวลาผ่านไป คุณลักษณะที่ควรนับ:
- ความลึกและโครงสร้างการนำทาง มากกว่า 50-100 การ์ดต่อชั่วโมง การไล่หน้าตัวเลขจนสุด การไล่ทุกชุดค่าผสมของฟิลเตอร์ การเคลื่อนตามตัวระบุจากน้อยไปมาก
- จังหวะ ช่วงเวลาระหว่างคำขอสม่ำเสมอเกินไป หรือในทางกลับกัน ช่วงที่มีการกระจายแบบสุ่มอย่างสมบูรณ์แบบ (มนุษย์ไม่เคยสุ่มอย่างสมบูรณ์แบบ)
- ขาดการมีส่วนร่วม ไม่มีเหตุการณ์การเคลื่อนไหวเมาส์ การเลื่อน การแตะ การเปลี่ยนขนาดหน้าต่าง โฟกัส โหลดหน้าแล้วแต่ไม่มีใครดู
- เส้นทางที่ไม่เป็นลักษณะเฉพาะ ไม่มีการเปลี่ยนไปหน้าหลัก ตะกร้า ติดต่อ เฉพาะหน้าข้อมูลเป้าหมาย
- เพิกเฉยต่อทรัพยากร ไม่ขอรูปภาพ ฟอนต์ สคริปต์ analytics
- คุณลักษณะหลายเซสชัน fingerprint เบราว์เซอร์เดียวกันบนที่อยู่หลายร้อยแห่ง หลายสิบเซสชันที่มีรูปแบบการนำทางเดียวกัน เริ่มในนาทีเดียวกัน
การตอบสนองต่อคะแนนที่เพิ่มขึ้น — การยกระดับเดียวกัน: เริ่มจากหน่วงเวลาตอบ แล้ว challenge ความยากสูงขึ้น แล้วแคปช่า แล้วบล็อกเซสชัน และควรบล็อกเซสชันและ fingerprint ไม่ใช่ IP — จำเรื่องเครือข่ายมือถือ
กับดัก honeypot ในการใช้งานจริง
กับดักที่เราใช้ในการวินิจฉัยยังทำงานได้ดีในฐานะองค์ประกอบถาวรของการป้องกัน ลิงก์ที่ซ่อนอยู่ทุกอัน ฟิลด์ฟอร์มที่มองไม่เห็นที่ไคลเอนต์กรอก ทุกคำขอไปยัง URL ที่ไม่มีใน navigation — สัญญาณที่มี false positive ใกล้ศูนย์ มนุษย์ไม่สามารถคลิกองค์ประกอบที่มีขนาดศูนย์ กฎความปลอดภัย: ปิดกับดักจากบอทค้นหา อย่าใช้กับดักที่โปรแกรมอ่านหน้าจอสำหรับผู้ใช้ที่มีความบกพร่องสามารถสัมผัสได้ เปลี่ยนตำแหน่งและรูปแบบกับดักเป็นประจำ
ทำให้เหยื่อไร้ค่า: ทำงานกับข้อมูลเอง
นี่คือกลยุทธ์ที่แทบไม่มีใครพูดถึง และบ่อยครั้งมีประสิทธิภาพกว่าการบล็อกใดๆ หากคุณไม่สามารถขัดขวางบอทจากการดึงข้อมูลได้ ทำให้สิ่งที่ถูกดึงไปไร้ประโยชน์หรือเป็นกับดัก
- การวางยาข้อมูลสำหรับเซสชันที่น่าสงสัย ไคลเอนต์ที่มีคะแนนความเสี่ยงสูงได้รับการตอบกลับไม่ใช่ข้อผิดพลาด 403 แต่เป็นหน้าที่ดูปกติที่มีราคาและสต็อกบิดเบือน: ราคาบวก/ลบ 7% สต็อกสุ่ม เรตติ้งที่เปลี่ยนไป parser ไม่เข้าใจว่าถูกเปิดเผยและเก็บขยะต่อไป ซึ่งต่อมาจะเข้าสู่ฐานข้อมูลของคู่แข่ง เหตุการณ์หนึ่งที่พบหลังการประเมินราคาใหม่จะยับยั้งความปรารถนาที่จะดึงข้อมูลเป็นเวลานาน ใช้อย่างระมัดระวัง: เฉพาะกับความมั่นใจสูงมาก เพื่อไม่ให้แสดงราคาผิดกับผู้ซื้อจริง และไม่เคย — สำหรับข้อมูลที่มีนัยสำคัญทางกฎหมาย
- ลายน้ำในข้อมูล ลักษณะเฉพาะระดับจุลภาคของคอนเทนต์สำหรับแต่ละเซสชัน: ลำดับคำในคำอธิบาย ความแปรปรวนของการจัดรูปแบบที่มองไม่เห็น สินค้า "canary" เฉพาะ ใช้ยืนยันภายหลังว่าข้อมูลรั่วจากไหนและเกี่ยวกับไคลเอนต์ใด
- โครงสร้างแบบไดนามิก การเปลี่ยนชื่อคลาส CSS และโครงสร้าง HTML บนหน้าที่มีค่าเป็นประจำทำลาย parser ที่ผูกกับ selector นี่คือการแข่งขัน แต่แต่ละรอบมีค่าใช้จ่ายเพียงหนึ่งรีลีสสำหรับคุณ และสำหรับผู้โจมตี — การเขียนตรรกะใหม่
- เรนเดอร์ค่าสำคัญแบบไม่มาตรฐาน ราคาสามารถประกอบจากหลายองค์ประกอบ ใส่ผ่าน pseudo-element ของ CSS ส่งเป็นรูปภาพ หรือโหลดแบบเลื่อนเวลาหลังการมีส่วนร่วม แต่ละวิธีมีค่าใช้จ่ายต่อ accessibility และ SEO — ชั่งน้ำหนัก
- จำกัดผลลัพธ์ อย่าให้แคตตาล็อกทั้งหมดกับใคร: ขีดจำกัดความลึกของหน้าตัวเลขแบบเข้ม บังคับให้กรองด้วยฟิลเตอร์ ไม่มี endpoint "สินค้าทั้งหมดในรายการเดียว"
ช่องทางที่ถูกกฎหมายแทนการทำสงคราม
เทคนิคที่ขัดแย้งแต่ใช้ได้ผล หากข้อมูลของคุณเป็นที่ต้องการอย่างเป็นระบบของแอกกริเกเตอร์ พันธมิตร หรือนักวิจัย ให้ API อย่างเป็นทางการพร้อมคีย์ ขีดจำกัด และข้อกำหนดการใช้งาน ภาระส่วนหนึ่งจะออกจากโซน "สีเทา" สู่โซนควบคุม และคุณจะมีพื้นฐานทางกฎหมายและทางเทคนิคในการจัดการอย่างเข้มงวดกับผู้ที่ยังคงดึงข้อมูลจากหน้าสาธารณะ
กรอบการนำไปใช้ทั้งสามชั้นทีละขั้น
แยกเรื่องกระบวนการ เพราะความล้มเหลวส่วนใหญ่ไม่ได้เกิดจากเทคโนโลยี แต่จากความเร่งรีบ ลำดับที่แนะนำ:
- โหมดสังเกตการณ์ (1-2 สัปดาห์) กฎและสกอริ่งทั้งหมดทำงาน แต่ไม่บล็อกอะไร — เพียงบันทึกการตัดสินใจ คุณเห็นว่าใครจะถูกบล็อกและเปรียบเทียบกับความเป็นจริง
- การปรับเทียบ ตรวจสอบเซสชัน "จะถูกบล็อก" ยอดนิยมด้วยตนเอง ในหมู่พวกเขาจะพบพันธมิตรของคุณ การตรวจสอบของคุณเอง web view ของแอปแชท และผู้ใช้ที่มีเบราว์เซอร์แปลกแต่ยังมีชีวิต ปรับเกณฑ์ เพิ่มข้อยกเว้น
- การดำเนินการอ่อน (1-2 สัปดาห์) เปิดเฉพาะการหน่วงและ challenge ล่องหน ติดตาม conversion อัตราตีกลับ ข้อร้องเรียนไปยังฝ่ายสนับสนุน
- การดำเนินการเต็มรูปแบบพร้อมความครอบคลุมทีละขั้น เปิดแคปช่าและการบล็อกเริ่มจาก 10% ของทราฟฟิก แล้ว 50% แล้วทั้งหมด ในแต่ละขั้น — ตรวจสอบเมตริก
- การดำเนินงาน ทบทวน false positive รายสัปดาห์ ทบทวนเกณฑ์รายเดือน สลับ challenge และกับดัก อัปเดตโปรไฟล์ parser
เมตริกหลักสำหรับการควบคุม
- สัดส่วนทราฟฟิกที่จำแนกเป็นบอท แยกตามส่วนของเว็บไซต์
- จำนวนข้อร้องเรียนไปยังฝ่ายสนับสนุนเกี่ยวกับแคปช่าหรือการไม่สามารถเข้าถึง
- Conversion และอัตราตีกลับก่อนและหลัง แยกสำหรับผู้ใช้มือถือ
- สัดส่วน false positive ตามตัวอย่างเซสชันที่ตรวจสอบด้วยตนเอง (เป้าหมาย — น้อยกว่า 0.5%)
- ภาระบนแอปพลิเคชันและฐานข้อมูล ต้นทุนโครงสร้างพื้นฐาน
- เวลาที่ผ่านไประหว่างการเปลี่ยนแปลงราคาของคุณและการปรากฏบนเว็บไซต์คู่แข่งที่รู้จัก
ข้อผิดพลาดทั่วไปในการนำระบบป้องกันบอทไปใช้
เราพูดถึงสิ่งที่ควรทำ ตอนนี้เรื่องที่ไม่ควรทำ — จากประสบการณ์หลายสิบโปรเจกต์ ข้อผิดพลาดเหล่านี้ซ้ำรอยด้วยความสม่ำเสมอที่น่าทึ่ง
ข้อผิดพลาด 1. บล็อกตาม IP เป็นมาตรการหลัก
พบบ่อยที่สุดและเป็นอันตรายที่สุด เจ้าของเว็บไซต์เห็นพันคำขอจากที่อยู่ แบนมัน — และตัดศูนย์สำนักงานหรือส่วนหนึ่งของเครือข่ายมือถือของโอเปอเรเตอร์ที่มีสมาชิกหลายพันคน พร้อมกันนั้น parser สลับไปยังที่อยู่ถัดไป IP เป็นสัญญาณอ่อน เหตุผลสำหรับการตรวจสอบเพิ่ม ไม่ใช่การแบน
ข้อผิดพลาด 2. แคปช่าทุกที่
ปฏิกิริยาแบบ "ใส่แคปช่าทุกหน้า ให้บอททรมาน" คนที่ทรมานไม่ใช่บอท แต่เป็น conversion: คนจริงจากไป โฆษณาเผางบกับผู้ใช้ที่ไม่ถึงคอนเทนต์ บอทค้นหาได้รับ placeholder แคปช่าเป็นเครื่องมือเฉพาะจุดสำหรับฟอร์มและการดำเนินการสำคัญ
ข้อผิดพลาด 3. เปิดการบล็อกโดยไม่มีโหมดสังเกตการณ์
เขียนกฎตอนเย็น เปิดตอนกลางคืน ตอนเช้าฝ่ายสนับสนุนจมในข้อร้องเรียน ทำโหมดสังเกตการณ์ก่อน แล้วปรับเทียบ แล้วจึงดำเนินการ
ข้อผิดพลาด 4. ลืมบอทที่ถูกกฎหมาย
บอทค้นหาที่ถูกบล็อก — สูญเสียอันดับในสองสัปดาห์ webhook การชำระเงินที่ถูกบล็อก — คำสั่งซื้อที่ไม่ชำระ การตรวจสอบของคุณเองที่ถูกบล็อก — การเตือนผิด ก่อนเปิดกฎใดๆ ให้สร้างและตรวจสอบรายการข้อยกเว้น
ข้อผิดพลาด 5. เพิกเฉยต่อ API และ endpoint มือถือ
เว็บไซต์ป้องกันอย่างดีเยี่ยม แต่ JSON ที่ frontend เรียกเปิดให้ทั้งโลกโดยไม่มีโทเค็น parser ขอบคุณสำหรับข้อมูลที่มีโครงสร้างสะอาด การป้องกันต้องครอบคลุมทุกช่องทางของการส่งคอนเทนต์
ข้อผิดพลาด 6. challenge และกับดักแบบ static
การป้องกันที่ตั้งค่าครั้งเดียวถูกถอดรหัสและหลบเลี่ยงในหนึ่งเดือน ระบบป้องกันบอทสำหรับเว็บไซต์คือกระบวนการ ไม่ใช่โปรเจกต์: การสลับ อัปเดต ทบทวนเกณฑ์
ข้อผิดพลาด 7. การวางยาข้อมูลโดยไม่มีความมั่นใจสูง
ความอยากแสดงราคา "ที่เสียหาย" นั้นยิ่งใหญ่ แต่ราคาผิดหนึ่งอันที่แสดงกับลูกค้าจริง ยิ่งไปกว่านั้นคำสั่งซื้อที่ทำตามนั้น — เป็นความเสี่ยงด้านชื่อเสียงและกฎหมาย ใช้เฉพาะกับเซสชันที่มีคะแนนสูงสุดและไม่เคย — สำหรับข้อมูลที่มีนัยสำคัญทางกฎหมาย
ข้อผิดพลาด 8. ลืมเรื่องการเข้าถึง
กับดักและการเรนเดอร์ที่ไม่มาตรฐานสามารถทำลายเว็บไซต์สำหรับโปรแกรมอ่านหน้าจอและผู้ใช้ที่มีความบกพร่อง ทดสอบการป้องกันด้วยเครื่องมือ accessibility ไม่ใช่แค่ใน Chrome ล่าสุด
ข้อผิดพลาด 9. การเก็บข้อมูลผู้ใช้เกินจำเป็น
ลายนิ้วมือเบราว์เซอร์และ log พฤติกรรมโดยละเอียดเป็นข้อมูลที่กฎหมายคุ้มครองข้อมูลส่วนบุคคลใช้บังคับ เก็บเท่าที่จำเป็นสำหรับการตัดสินใจ จำกัดระยะเวลาการเก็บ สะท้อนข้อเท็จจริงของการประมวลผลในนโยบายความเป็นส่วนตัว
ข้อผิดพลาด 10. ไม่มีเมตริกความสำเร็จ
เปิดการป้องกันแล้ว แต่ไม่มีใครตอบคำถาม "ดีขึ้นไหม" ได้ หากไม่มี baseline จากการวินิจฉัยและไม่มีการติดตาม conversion คุณจะแยกความแตกต่างระหว่างชัยชนะกับความพ่ายแพ้ไม่ได้
เครื่องมือและทรัพยากรสำหรับการนำไปใช้
เราสัญญาว่าจะไม่เปรียบเทียบผู้ให้บริการและรักษาคำพูด ด้านล่างคือหมวดหมู่เครื่องมือและสิ่งที่แต่ละอย่างรับผิดชอบ เพื่อให้คุณประกอบสแต็กตามขนาดและงบประมาณของคุณ ชื่อโซลูชันเฉพาะคุณหาเองได้ง่าย ที่นี่สถาปัตยกรรมสำคัญ
ระดับเว็บเซิร์ฟเวอร์และ reverse proxy
Nginx, Apache, Caddy, HAProxy, Envoy ให้: rate limiting ตามคีย์ที่ยืดหยุ่น กฎตาม header ส่งคำตอบต่างกันตามเงื่อนไข คำนวณ TLS fingerprint ผ่านโมดูลและส่วนขยาย นี่คือแนวแรกของคุณ และสำหรับโปรเจกต์ที่มีคำขอไม่กี่ล้านต่อวันอาจเพียงพอในตอนเริ่มต้น
WAF และ CDN ที่มีการป้องกัน
CDN บนคลาวด์ที่มี WAF ในตัวและโหมดกรองบอท หรือ WAF ที่ติดตั้งเองบนชุดกฎโอเพนซอร์ส ให้: การกรองตามชื่อเสียง ASN และภูมิศาสตร์ challenge ที่จัดการได้ สกอริ่งพื้นฐาน caching ข้อดี — เปิดใช้เร็ว ข้อเสีย — การปรับแต่งตามตรรกะธุรกิจของคุณจำกัด
แพลตฟอร์มจัดการบอทเฉพาะทาง
ระบบเชิงพาณิชย์และโอเพนซอร์สที่รวบรวม fingerprint ของไคลเอนต์ ทำสกอริ่งพฤติกรรม ใช้ challenge แบบปรับได้ และให้แดชบอร์ด analytics เหมาะเมื่อสัดส่วนทราฟฟิกบอทสูง ข้อมูลมีค่า และทีมไม่มีสำหรับพัฒนาของตัวเอง ในการเลือกดูโหมดสังเกตการณ์ ความละเอียดของนโยบาย การรองรับแอปมือถือและ web view ตลอดจนความโปร่งใสของการตัดสินใจ — คุณต้องเข้าใจว่าทำไมไคลเอนต์เฉพาะถูกบล็อก
ไลบรารีสำหรับพัฒนาของตัวเอง
ไลบรารีโอเพนซอร์สสำหรับรวบรวม fingerprint เบราว์เซอร์ ใช้ proof of work คำนวณ TLS fingerprint ฝั่งเซิร์ฟเวอร์ ตรวจจับสัญญาณของระบบอัตโนมัติ เหมาะกับทีมที่มีนักพัฒนาที่ต้องการการควบคุมเต็มรูปแบบ อย่าลืมความจำเป็นในการอัปเดตเป็นประจำ: สัญญาณของโหมด headless เปลี่ยนทุกเวอร์ชันของเบราว์เซอร์
แคปช่าและทางเลือก
บริการตรวจสอบสมัยใหม่ที่มีโหมดล่องหนและความยากแบบปรับได้ ตลอดจนโซลูชันบนพื้นฐานของ proof of work โดยไม่มีการมีส่วนร่วมของผู้ใช้ เกณฑ์การเลือก: การเข้าถึงสำหรับผู้ที่มีความบกพร่อง การทำงานในภูมิภาคของคุณโดยไม่มีความล่าช้า การเก็บข้อมูลผู้ใช้น้อยที่สุด
Analytics และ observability
สแต็กการเก็บและวิเคราะห์ log (ELK และอื่นๆ ClickHouse ระบบ analytics บนคลาวด์) แดชบอร์ดสำหรับเมตริกการป้องกัน ระบบแจ้งเตือนความผิดปกติของทราฟฟิก หากไม่มีคุณจะตาบอด: ไม่สามารถปรับเทียบเกณฑ์ได้หากไม่เห็นการตัดสินใจของระบบแยกตามเซกเมนต์ผู้ชม
เครื่องมือทดสอบ
คำแนะนำแยก: ทดสอบการป้องกันของคุณด้วยเครื่องมือเดียวกับที่ parser ใช้ เบราว์เซอร์อัตโนมัติในโหมด headless ไคลเอนต์ HTTP ในภาษายอดนิยม เครื่องมือ profiler เครือข่าย หากสคริปต์ง่ายๆ ของคุณเองดึงแคตตาล็อกได้อย่างอิสระ แสดงว่างานยังไม่เสร็จ สำหรับทีมที่ทำงานกับ mobile proxy การตรวจสอบสถานการณ์อื่นเป็นประโยชน์: การป้องกันบล็อกผู้ใช้ที่ซื่อสัตย์จากเครือข่ายมือถือที่ที่อยู่ถูกแบ่งปันระหว่างสมาชิกหลายพันคนหรือไม่
ทรัพยากรภายในที่จำเป็น
- บุคคลที่รับผิดชอบการป้องกันพร้อมอำนาจในการเปลี่ยนเกณฑ์
- ระเบียบการตรวจสอบ false positive ที่มีส่วนร่วมของฝ่ายสนับสนุน
- ข้อกำหนดการใช้งานและนโยบายความเป็นส่วนตัวที่ผ่านการตรวจสอบทางกฎหมาย
- ช่องทางอย่างเป็นทางการสำหรับพันธมิตรที่ต้องการข้อมูลของคุณ
กรณีศึกษา: สิ่งนี้ทำงานอย่างไรในโปรเจกต์จริง
สามเรื่องราวไม่ระบุชื่อจากประสบการณ์การนำไปใช้ พร้อมตัวเลขและบทเรียน รายละเอียดถูกเปลี่ยน สาระสำคัญยังคงอยู่
กรณีศึกษา 1. ร้านอิเล็กทรอนิกส์ออนไลน์: 71% ของคำขอไปยังแคตตาล็อกเป็นบอท
สถานการณ์ ร้านขนาดกลาง ประมาณ 40,000 สินค้า สังเกตว่าคู่แข่งเปลี่ยนราคาภายในครึ่งชั่วโมงหลังจากเขา การวินิจฉัย log แสดง: 71% ของคำขอไปยังการ์ดสินค้าตอนกลางคืนและ 44% ตอนกลางวันเป็นอัตโนมัติ โปรไฟล์หลัก: สคริปต์คลาวด์สองตัวไม่มี JS และไคลเอนต์กระจายหนึ่งตัวบนที่อยู่ residential ไปเฉพาะหน้าเว็บที่มีราคา ต้นทุนโครงสร้างพื้นฐานของทราฟฟิกปรสิต — ประมาณ 140,000 รูเบิลต่อเดือน บวกโควต้า API geocoding ที่เสียเงินหมดกลางวัน
วิธีแก้ แนวแรก: ขีดจำกัดที่ differentiated ตามส่วน โหมดเข้มสำหรับ ASN ของโฮสติ้ง caching การ์ด แนวที่สอง: TLS fingerprint พร้อมการสังเกตหนึ่งสัปดาห์ JS challenge ล่องหนสำหรับแคตตาล็อก ป้องกัน endpoint JSON ของ frontend ด้วยโทเค็น แนวที่สาม: สกอริ่งตามความลึกของเซสชัน ลิงก์ที่ซ่อนอยู่ สินค้า canary สำหรับเซสชันที่มีคะแนนสูงสุด — การบิดเบือนราคาภายใน 5-8%
ผลลัพธ์ในสองเดือน สัดส่วนทราฟฟิกบอทไปยังแคตตาล็อกลดลงเหลือ 9% สคริปต์คลาวด์หายไปในสัปดาห์แรก ไคลเอนต์กระจายยืนได้สามสัปดาห์ จากนั้นตัดสินจากสินค้า canary เริ่มรวบรวมราคาที่บิดเบือน และหลังจากหนึ่งเดือนกิจกรรมก็หยุด ภาระบนแอปพลิเคชันลดลง 58% ค่าใช้จ่ายโครงสร้างพื้นฐาน — 96,000 รูเบิลต่อเดือน Conversion ไม่เปลี่ยนแปลงอย่างมีนัยสำคัญทางสถิติ จำนวนข้อร้องเรียนไปยังฝ่ายสนับสนุนเกี่ยวกับแคปช่า — 11 ในสองเดือนโดยมีผู้ชมหลายแสนคน อัตรา false positive ตามตัวอย่างที่ตรวจสอบด้วยมือ — 0.3%
บทเรียน การวางยาข้อมูลกลับเป็นปัจจัยชี้ขาดต่อ parser ที่ดื้อรั้นที่สุด แต่ใช้ได้ผลเพียงเพราะชั้นก่อนหน้าให้ความมั่นใจสูงในการจำแนก
กรณีศึกษา 2. ตลาดบริการ: ป้องกันผู้ติดต่อและประกาศ
สถานการณ์ แพลตฟอร์มประกาศของผู้เชี่ยวชาญรายบุคคลประสบกับการรวบรวมข้อมูลติดต่อจำนวนมาก: หมายเลขโทรศัพท์ของผู้ให้บริการไปยังฐานสแปม ผู้ใช้ร้องเรียนและจากไป การรวบรวมดำเนินการผ่าน managed browser ที่มี fingerprint น่าเชื่อถือจากที่อยู่ residential และมือถือ แนวแรกแทบไม่ช่วย
วิธีแก้ เน้นแนวที่สามและการป้องกันข้อมูล ผู้ติดต่อถูกย้ายออกจาก HTML และส่งเฉพาะเมื่อคลิก ผ่านคำขอที่เซ็นชื่อพร้อมโทเค็นเซสชัน พร้อมขีดจำกัดการเปิดเผยต่อชั่วโมงต่อเซสชัน และความยาก proof of work ที่เพิ่มขึ้นเมื่อคะแนนความเสี่ยงเพิ่ม สำหรับผู้ใช้ที่ล็อกอินขีดจำกัดสูงกว่า สำหรับ guest ต่ำกว่า สกอริ่งเซสชันโดยคำนึงถึงการมีส่วนร่วม: การเปิดเผยผู้ติดต่อโดยไม่เลื่อนไปที่มันก่อนและไม่มีการเคลื่อนไหวของ pointer เพิ่มคะแนน แคปช่า — เฉพาะการเปิดเผยครั้งที่ห้าและหลังจากนั้นต่อชั่วโมงสำหรับ guest
ผลลัพธ์ จำนวนผู้ติดต่อที่ถูกเปิดเผยต่อเซสชันในไคลเอนต์ที่น่าสงสัยลดลงจากหลายร้อยเหลือ 3-4 หลังจากนั้นเซสชันถูกบล็อก ข้อร้องเรียนของผู้ให้บริการเกี่ยวกับสแปมลดลง 80% ในไตรมาส Conversion "ดูประกาศ — ติดต่อ" ในผู้ใช้จริงเพิ่มขึ้น 4% — น่าจะเป็นเพราะหน้าเร็วขึ้นจากการลดภาระ
บทเรียน เมื่อ parser แยกแยะจากมนุษย์ไม่ได้ด้วย fingerprint การเปลี่ยนโมเดลการส่งข้อมูลเองช่วยได้: ของมีค่าส่งตามการกระทำ ทีละส่วน และมีราคาที่เพิ่มขึ้น
กรณีศึกษา 3. แคตตาล็อก B2B: false positive เป็นปัญหาหลัก
สถานการณ์ ซัพพลายเออร์ชิ้นส่วนอุตสาหกรรมเปิดระบบป้องกันบอทบนคลาวด์ในโหมดเข้มโดยไม่สังเกต ผ่านไปสองวัน — คำขอเพิ่มลดลง 35% การตรวจสอบแสดง: ลูกค้าของบริษัทอยู่ในเครือข่ายองค์กรที่มีที่อยู่ร่วมกันและเบราว์เซอร์เก่า และส่วนสำคัญของทราฟฟิกผ่าน web view ของแอปแชทขององค์กรที่มี TLS fingerprint ไม่มาตรฐาน ระบบตัดสินว่าพวกเขาเป็นบอท
วิธีแก้ ย้อนกลับไปโหมดสังเกตการณ์ ปรับเทียบสองสัปดาห์ สร้าง white list ของ fingerprint และ subnet ของลูกค้าหลัก เปลี่ยนเซกเมนต์องค์กรเป็นโหมด "เฉพาะหน่วงและ challenge ล่องหน ไม่เคยแคปช่า" เพิ่มเติม — API พันธมิตรสำหรับผู้จัดจำหน่ายสามรายที่ก่อนหน้านี้ดึงแคตตาล็อกสำหรับระบบของตัวเอง
ผลลัพธ์ คำขอเพิ่มกลับมาในหนึ่งสัปดาห์หลังการปรับเทียบ ทราฟฟิกบอทลดลง 62% จากการที่ผู้จัดจำหน่ายย้ายไป API อย่างเป็นทางการและการตัดสคริปต์พื้นฐาน False positive — น้อยกว่า 0.2%
บทเรียน โหมดสังเกตการณ์ไม่ใช่พิธีกรรม และส่วนหนึ่งของ "parser" จริงๆ แล้วเป็นพันธมิตรของคุณ ที่ให้ API ง่ายกว่าการทำสงคราม
FAQ: คำตอบสำหรับคำถามยาก
หยุดการดึงข้อมูลได้ทั้งหมดหรือไม่
คำตอบที่ซื่อสัตย์ — ไม่ หากข้อมูลเข้าถึงได้สาธารณะโดยมนุษย์ ก็เข้าถึงได้ทางเทคนิคโดยบอทที่มีแรงจูงใจเพียงพอ เป้าหมายของการป้องกันคือทำให้การรวบรวมแพง ช้า และไม่น่าเชื่อถือพอที่จะสูญเสียความหมายทางเศรษฐกิจ ในสถานการณ์เชิงพาณิชย์ส่วนใหญ่เท่านี้ก็เพียงพอ: คู่แข่งที่ได้ข้อมูลล่าช้าหนึ่งวันและมีเปอร์เซ็นต์การบิดเบือนไม่ได้รับความได้เปรียบ
การป้องกันบอทจะทำร้าย SEO หรือไม่
จะทำร้ายหากทำไม่ถูกต้อง: บล็อกบอทค้นหา ส่ง challenge แทนคอนเทนต์ หรือเรนเดอร์ราคาเป็นรูปภาพ การป้องกันที่สร้างอย่างถูกต้องจดจำบอทที่ถูกกฎหมาย (ตามช่วงที่อยู่ที่ประกาศและการตรวจสอบย้อนกลับ DNS) ปล่อยโดยไม่มีการตรวจสอบ และไม่เปลี่ยนเนื้อหาสำหรับพวกเขา ตรวจสอบการมองเห็นหน้าด้วยเครื่องมือ webmaster หลังการเปลี่ยนนโยบายทุกครั้ง
ป้องกันเว็บไซต์โดยไม่บล็อกผู้ใช้เครือข่ายมือถือได้อย่างไร
ห้ามแบน IP เดี่ยวจากเครือข่ายมือถือ นับขีดจำกัดตาม subnet หรือ ASN ด้วยเกณฑ์สูง พึ่งสัญญาณเซสชันและพฤติกรรม ไม่ใช่เครือข่าย ใช้ challenge ล่องหนและการหน่วงกับไคลเอนต์ที่น่าสงสัย ไม่ใช่แคปช่า ต้องทดสอบการป้องกันจากอุปกรณ์มือถือจริงในเครือข่ายโอเปอเรเตอร์หลัก
ควรทำการป้องกันเองหรือใช้แพลตฟอร์มสำเร็จรูป
ขึ้นอยู่กับขนาดและทีม แนวแรกและ challenge พื้นฐานทำได้โดยนักพัฒนาหนึ่งคนในสองสัปดาห์และครอบคลุมบอทพื้นฐานส่วนใหญ่ การสกอริ่งพฤติกรรมพร้อมการอัปเดตเป็นประจำแทบจะเป็นผลิตภัณฑ์แยก และสำหรับโปรเจกต์ที่ไม่มีทีมรักษาความปลอดภัยเฉพาะ แพลตฟอร์มสำเร็จรูปมักถูกกว่าเมื่อคิดต่อปี เส้นทางที่สมเหตุสมผล — เริ่มจากมาตรการพื้นฐานของตัวเอง วัดปัญหาที่เหลือ แล้วตัดสินว่าต้องการเครื่องมือเฉพาะทางหรือไม่
จะจัดการกับครอว์เลอร์ของโมเดล AI อย่างไร
เป็น decisions ทางธุรกิจ ไม่ใช่แค่ทางเทคนิค หากการมีอยู่ในการตอบของ AI assistant นำผู้ชมมาให้ — อนุญาตการเข้าถึงผ่านกฎสำหรับบอทและไม่ขัดขวาง หากคอนเทนต์ของคุณเป็นผลิตภัณฑ์ของคุณและการสรุปโดยโมเดลพรากทราฟฟิก — ห้ามอย่างชัดเจนและเสริมด้วยมาตรการทางเทคนิค ผู้ประกอบการที่ซื่อสัตย์ประกาศครอว์เลอร์ของตนและปฏิบัติตามกฎ ที่ไม่ซื่อสัตย์ตกอยู่ภายใต้ระบบป้องกันบอทสำหรับเว็บไซต์ทั่วไปเช่นเดียวกับสแครปเปอร์อื่นๆ
การให้ข้อมูลบิดเบือนกับ parser ถูกกฎหมายหรือไม่
ในทางเทคนิคคุณมีสิทธิ์แสดงคอนเทนต์ต่างกันให้ไคลเอนต์ต่างกันบนทรัพยากรของคุณ แต่ต้องตัดสถานการณ์ที่ข้อมูลบิดเบือนกลายเป็นพื้นฐานสำหรับธุรกรรมกับผู้บริโภคจริง และไม่บิดเบือนข้อมูลที่กฎหมายกำหนดให้เปิดเผยอย่างถูกต้อง ใช้การวางยาเฉพาะกับเซสชันที่มีความมั่นใจสูงสุดในการจำแนก ปิดสำหรับผู้ใช้ที่ล็อกอิน และปรึกษาทนายความเกี่ยวกับอุตสาหกรรมของคุณ
ต้องอัปเดตการป้องกันบ่อยแค่ไหน
เกณฑ์และข้อยกเว้น — รายสัปดาห์ในเดือนแรก จากนั้นรายเดือน Challenge และกับดัก — สลับทุก 4-8 สัปดาห์หรือเมื่อพบการหลบเลี่ยง โปรไฟล์ parser — ทบทวนทุกครั้งที่มีการเปลี่ยนแปลงที่สังเกตได้ในภาพทราฟฟิก สัญญาณของระบบอัตโนมัติในเบราว์เซอร์ — ทุก major release ของเบราว์เซอร์ การป้องกันที่ไม่มีการดูแลจะเสื่อมสภาพในหนึ่งถึงสองไตรมาส
จะทำอย่างไรหากคู่แข่งรายใหญ่ที่มีงบประมาณมากดึงข้อมูล
เปลี่ยนจุดเน้นจากการบล็อกเป็นการทำให้ไร้ค่าและหลักฐาน: รายการ canary และลายน้ำให้ข้อโต้แย้งทางกฎหมาย การวางยาข้อมูลทำให้เหยื่อไม่น่าเชื่อถือ การจำกัดความลึกของผลลัพธ์ไม่อนุญาตให้ดึงแคตตาล็อกทั้งหมด ในขณะเดียวกันบันทึกเหตุการณ์และประเมินโอกาสของงานเรียกร้อง — เมื่อมีหลักฐานการรวบรวมอย่างเป็นระบบที่ละเมิดข้อกำหนดการใช้งาน มักมีประสิทธิภาพมากกว่าการแข่งขันทางเทคนิค
เริ่มจากอะไรหากงบและเวลาจำกัด
หนึ่งวันสำหรับการวินิจฉัย log จากนั้น: rate limiting ที่ differentiated พร้อมสองหน้าต่าง caching หน้าที่แพง ปิด endpoint JSON ด้วยโทเค็น ลิงก์กับดักที่ซ่อนอยู่และสินค้า canary ชุดนี้ใช้ได้ในหนึ่งสัปดาห์แทบไม่มีค่าใช้จ่ายและตัดปัญหาส่วนใหญ่ออก ต่อไป — วัดและตัดสินว่าต้องการชั้นถัดไปหรือไม่
บทสรุป: การป้องกันเป็นกระบวนการ ไม่ใช่การซื้อ
หากสรุปทุกอย่างเป็นความคิดเดียว มันจะเป็นเช่นนี้: ระบบป้องกันบอทสำหรับเว็บไซต์ไม่ใช่กล่องที่ตั้งแล้วลืม แต่เป็นระบบสามชั้นที่สอดคล้องกันและกระบวนการปรับเทียบอย่างต่อเนื่อง ระดับเครือข่ายตัดบอทพื้นฐานเกือบฟรี การตรวจสอบไคลเอนต์จับสคริปต์และเบราว์เซอร์อัตโนมัติที่ตั้งค่าไม่ระมัดระวัง การวิเคราะห์พฤติกรรมและการทำงานกับข้อมูลเองทำให้ความพยายามของแม้แต่ parser ขั้นสูงไร้ความหมาย และสิ่งที่รวมทั้งหมดนี้คือหลักการสกอริ่ง: อย่าปิดประตูใส่ตามสัญญาณเดียว แต่สะสมสัญญาณอ่อนและตอบสนองตามสัดส่วน
กระบวนการก็สำคัญไม่แพ้กัน การวินิจฉัยก่อนการนำไปใช้ โหมดสังเกตการณ์ก่อนเปิดการบล็อก ความครอบคลุมทีละขั้น เมตริก conversion ควบคู่กับเมตริกการป้องกัน การสลับเป็นประจำ — นี่คือสิ่งที่แยกโปรเจกต์ที่ประสบความสำเร็จออกจากโปรเจกต์ที่ย้อนกลับในหนึ่งสัปดาห์เพราะข้อร้องเรียนของลูกค้า และจำเรื่องคนที่อยู่หลังที่อยู่: ผู้ใช้เครือข่ายมือถือ proxy องค์กร และ web view ของแอปแชท — เป็นผู้ซื้อจริงของคุณ และการป้องกันต้องผ่านการทดสอบความเป็นมิตรต่อพวกเขา
สิ่งที่ต้องทำต่อไป วันนี้เลย:
- ส่งออก log หนึ่งสัปดาห์และตอบคำถามจากส่วนการวินิจฉัย ฟรีและใช้เวลาสองสามชั่วโมง
- คำนวณว่าทราฟฟิกบอททำให้คุณเสียเท่าไรในโครงสร้างพื้นฐานและผลประโยชน์ที่สูญเสีย ตัวเลขนี้จะกำหนดงบประมาณ
- นำแนวแรกไปใช้ตามเช็คลิสต์: ขีดจำกัด cache กฎตาม header การป้องกัน API
- วางกับดักและรายการ canary — พวกเขาจะทำงานให้คุณเป็นเดือนๆ
- วางแผนแนวที่สองและสามทีละขั้น พร้อมโหมดสังเกตการณ์ในทุกขั้น
- สร้างปฏิทินการดูแลการป้องกันและกำหนดผู้รับผิดชอบ
ข้อมูลที่คุณรวบรวมและสร้าง — เป็นสินทรัพย์ เช่นเดียวกับสินทรัพย์อื่นๆ มันสมควรได้รับการปกป้องตามสัดส่วนของมูลค่าและไม่รบกวนผู้ที่มันถูกสร้างมาเพื่อ หวังว่าคู่มือนี้จะเป็น bookmark ที่คุณจะกลับมาอ่านในทุกขั้น — ตั้งแต่การดู log ครั้งแรกจนถึงระบบที่เป็นผู้ใหญ่ทำงานอย่างสงบ
