Ochrona antyscraperowa strony: co wdrożyć i jak, gdy ktoś zrzuca Twoje dane
Spis treści
- Wprowadzenie: gdy twoja strona staje się czyjąś bazą danych
- Podstawy: czym jest ochrona antyscraperowa i przed kim chroni
- Głębokie zanurzenie: jak współczesny system antybotowy „widzi" odwiedzającego
- Metoda 1. diagnostyka: ustalamy, kto i jak was scrapuje
- Metoda 2. pierwsza linia: poziom serwerowy i sieciowy
- Metoda 3. druga linia: weryfikacja klienta i challenge'y
- Metoda 4. trzecia linia: zachowanie, pułapki i ochrona samych danych
- Typowe błędy przy wdrażaniu ochrony antyscraperowej
- Narzędzia i zasoby do realizacji
- Case studies: jak to działa w realnych projektach
- Faq: odpowiedzi na trudne pytania
- Zakończenie: ochrona jako proces, a nie zakup
Wprowadzenie: gdy Twoja strona staje się czyjąś bazą danych
Wyobraź sobie: przez pół roku budowałeś katalog, weryfikowałeś ceny, pisałeś opisy produktów, konfigurowałeś filtry. A potem zauważasz, że konkurent aktualizuje swoje ceny dwadzieścia minut po Tobie, a w wyszukiwarce pojawiają się klony z Twoimi opisami słowo w słowo. Serwer jęczy pod obciążeniem, rachunek za hosting rośnie, a analityka pokazuje dziwne skoki ruchu w nocy z regionów, w których nie masz ani jednego klienta. Znajome? To scraping. I to nie hipotetyczne zagrożenie, ale codzienna rzeczywistość dla każdej strony, na której jest choćby coś wartościowego.
Według szacunków branżowych raportów z ostatnich lat ruch zautomatyzowany stanowi około połowy wszystkich żądań w internecie, a mniej więcej jedna trzecia całkowitego wolumenu przypada na jawnie szkodliwe boty. W e-commerce, serwisach ogłoszeniowych, projektach turystycznych i platformach treściowych udział bywa jeszcze wyższy. Co więcej, trend na 2026 rok jest oczywisty: do klasycznych scraperów dołączyli agenci oparci na dużych modelach językowych, którzy poruszają się po stronach nie gorzej niż człowiek, czytają treści i podejmują decyzje. Granica między „żywym" a „automatycznym" odwiedzającym zaciera się na naszych oczach.
Publiczność mobileproxy.space zna ten temat z obu stron. Marketerzy i arbitrażyści sami zbierają dane, programiści piszą kolektory, właściciele firm monitorują konkurencję. Ale każdy z Was ma z pewnością własną stronę, landing page, katalog czy API, które ktoś w tej chwili właśnie zrzuca. Dlatego w tym artykule zmieniamy optykę: dziś to Was scrapują, i omawiamy, jak zbudować ochronę antyscraperową strony tak, żeby działała, a nie przeszkadzała prawdziwym użytkownikom.
Ważne zastrzeżenie. Nie porównujemy dostawców i nie tworzymy rankingów komercyjnych usług — temu poświęcony jest osobny materiał na blogu. Tutaj chodzi o wdrożenie: jakie poziomy ochrony istnieją, w jakiej kolejności je ustawiać, jak mierzyć efekty i jakie pułapki czekają na każdym kroku. Co zyskasz do końca lektury:
- zrozumienie, jak współczesne systemy antybotowe „widzą" odwiedzającego i dlaczego blokowanie po IP już dawno przestało być rozwiązaniem;
- metodykę diagnostyki: jak w jeden dzień ustalić, kto i jak dokładnie Was scrapuje;
- trzy linie obrony z instrukcjami krok po kroku — od serwerowego rate limitingu po analizę behawioralną i pułapki w danych;
- framework stopniowego wdrażania bez zawalenia konwersji;
- listy kontrolne, listę narzędzi i omówienie realnych przypadków z liczbami.
Usiądź wygodnie. Materiał jest duży, ale pomyślany jako zakładka robocza, do której będziesz wracać na każdym etapie projektu.
Podstawy: czym jest ochrona antyscraperowa i przed kim chroni
Boty bywają różne i nie wszystkie trzeba blokować
Pierwsza rzecz, którą warto przyjąć: bot to nie wyzwisko. Roboty wyszukiwarek indeksują Twoje strony i przyprowadzają ruch. Monitoring dostępności sprawdza, czy strona żyje. Systemy płatności wywołują webhooki. Agregatory partnerskie pobierają feedy na podstawie umowy. To wszystko ruch zautomatyzowany, którego potrzebujesz i który Ci się opłaca. Zadaniem ochrony antyscraperowej strony nie jest zniszczenie automatyzacji jako zjawiska, lecz oddzielenie żądań pożytecznych i dozwolonych od szkodliwych, a te szkodliwe uczynienie ekonomicznie bezsensownymi.
Umownie niepożądane boty dzieli się na kilka kategorii:
- Scrapery treści i cen — zrzucają katalog, opisy, stany magazynowe, ceny, opinie. Główny bohater tego artykułu.
- Agregatory bez umowy — biorą Twoje dane i sprzedają do nich dostęp osobom trzecim.
- Boty do łamania danych logowania — atakują formularze logowania, sprawdzając wyciekłe pary login-hasło.
- Scaperzy i „snajperzy" stanów magazynowych — wykupują deficytowy towar lub rezerwują sloty w ułamkach sekund.
- Boty spamowe i nabijacze — zaśmiecają formularze, rejestrują fałszywe konta, psują metryki.
- Crawlery modeli AI — zbierają tekst do trenowania lub do odpowiedzi w czasie rzeczywistym. Ich dopuszczalność każdy biznes określa sam.
Zwróć uwagę: sam scraping rzadko psuje stronę. Ale tworzy pasożytnicze obciążenie (czasem do 60-80% wszystkich żądań do katalogu), zniekształca analitykę, wyczerpuje limity zewnętrznych API, które wywołujesz przy renderowaniu strony, i przede wszystkim pozbawia Cię przewagi konkurencyjnej, dla której te dane zbierałeś.
Czym ochrona przed scrapingiem różni się od ochrony przed DDoS
Wielu właścicieli stron stawia znak równości między tymi zadaniami i dziwi się, dlaczego filtr anty-DDoS przepuszcza scraper. Różnica jest fundamentalna. DDoS to cios w wolumen: celem atakującego jest wyczerpanie zasobu kanału lub serwera. Taki atak łatwo zauważyć po metrykach i filtruje się go na poziomie sieci. Scraper wręcz przeciwnie — stara się być niezauważalny: rozciąga żądania w czasie, rozkłada je na dziesiątki tysięcy adresów, imituje przeglądarkę i chodzi po tych samych URL-ach co żywi ludzie. Klasyczny filtr anty-DDoS widzi równy, „zdrowy" ruch i go przepuszcza. Dlatego ochrona przed botami wymaga zupełnie innych sygnałów — o nich w następnym rozdziale.
Trzy linie obrony: model, którym się posłużymy
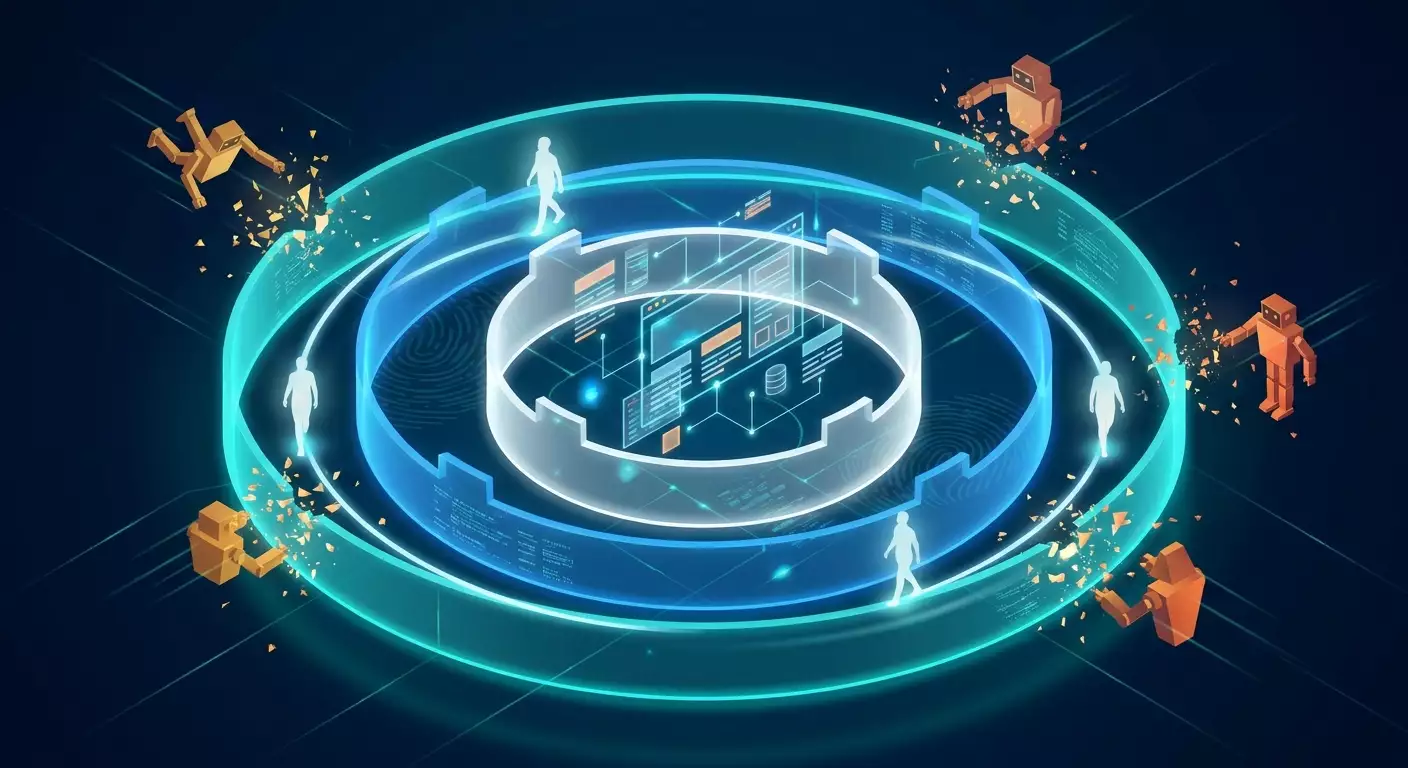
Żeby nie utonąć w technologiach, wygodnie wyobrazić sobie ochronę antyscraperową jako trzy koncentryczne warstwy. Analogia — średniowieczna twierdza: fosa i zewnętrzny mur, brama ze strażą i wreszcie wewnętrzne komnaty, gdzie nawet gość, który przeszedł bramę, znajduje się pod obserwacją.
- Poziom sieciowy i serwerowy. Ograniczanie częstotliwości żądań, filtrowanie po reputacji sieci, WAF, podstawowe reguły po nagłówkach. Tanio, szybko, odsiewa najbardziej prymitywne boty.
- Poziom weryfikacji klienta. Challenge'y JavaScript, analiza odcisków TLS i przeglądarki, captcha w odpowiednich miejscach, zadania proof-of-work. Odsiewa skrypty bez przeglądarki i źle skonfigurowane narzędzia headless.
- Poziom behawioralny i ochrona danych. Analiza sekwencji działań, scoring sesji, pułapki-honeypoty, obfuskacja i znaki wodne w samych danych. Działa przeciw zaawansowanym botom, które przeszły dwa pierwsze kręgi.
Kluczowa myśl, do której będziemy wracać: żadna warstwa nie jest wystarczająca sama w sobie. Siła polega na tym, że bot musi jednocześnie obejść wszystkie trzy, a każda dodatkowa przeszkoda podnosi koszt jego pracy. Gdy scrapowanie staje się droższe niż legalny zakup danych lub zebranie ich inaczej, scraping ustaje. To ekonomia, a nie magia.
Podstawowe terminy, które pojawią się dalej
- Rate limiting — ograniczenie liczby żądań z jednego źródła w jednostce czasu.
- WAF (Web Application Firewall) — firewall warstwy aplikacji filtrujący żądania HTTP według reguł.
- Fingerprint (odcisk) — zestaw cech klienta pozwalający rozpoznać jego typ lub konkretny egzemplarz.
- Przeglądarka headless — pełnoprawna przeglądarka bez interfejsu graficznego, sterowana programowo.
- Challenge (wyzwanie) — zadanie weryfikacyjne, które klient musi rozwiązać, by uzyskać dostęp.
- False positive (fałszywe trafienie) — sytuacja, gdy ochrona blokuje żywego użytkownika.
- Honeypot — pułapka: element niewidoczny dla człowieka, ale zauważalny dla klienta zautomatyzowanego.
Głębokie zanurzenie: jak współczesny system antybotowy „widzi" odwiedzającego
Żeby świadomie ustawiać ochronę, trzeba rozumieć, na jakich sygnałach się opiera. Tu zaczyna się najciekawsze: przez ostatnie pięć lat branża przeszła drogę od „zbanować IP" do wielowarstwowego scoringu, gdzie decyzja podejmowana jest na podstawie setek cech. Omówmy główne grupy sygnałów.
Sygnały sieciowe i dlaczego IP nie jest już najważniejsze
Historycznie pierwszą cechą bota był adres IP. Żądania z centrum danych? Prawdopodobnie skrypt. Tysiąc żądań z jednego adresu? Na pewno skrypt. To podejście wciąż działa przeciw leniwym scraperom, które chodzą bezpośrednio z serwerów chmurowych, i warto je stosować. Ale ma dwa zasadnicze ograniczenia.
Po pierwsze: adresy rezydenckie i mobilne. Publiczność tego bloga wie lepiej niż wielu, że za jednym mobilnym IP operatora dzięki NAT może jednocześnie znajdować się kilka tysięcy realnych abonentów. Blokując taki adres z powodu jednego podejrzanego klienta, odcinasz od strony całą dzielnicę miasta. Bazy reputacyjne dla sieci mobilnych są praktycznie bezużyteczne: adres, który wczoraj używał scraper, dziś należy do Twojego klienta. Dlatego sensowna ochrona antyscraperowa strony używa IP jedynie jako jednego ze słabych sygnałów, a nie jako podstawy wyroku.
Po drugie: rozproszenie. Współczesny scraper rotuje adresy tak, że na każdy przypada 2-3 żądania na godzinę. Próg rate limitingu wystarczający do odcięcia takiego klienta z pewnością uderzy w żywych ludzi, którzy otwierają dziesięć kart katalogu.
Co zostaje pożytecznego na poziomie sieciowym? Cechy ASN (przynależność sieci do dostawcy hostingu), anomalie geograficzne (ruch z kraju, w którym nie działasz), niezgodność geolokalizacji IP i języka przeglądarki, statystyki po podsieciach, a nie po pojedynczych adresach.
Odcisk warstwy transportowej i protokołu
Oto sygnał, który wielu nie docenia. Gdy klient nawiązuje połączenie szyfrowane, wysyła wiadomość powitalną TLS z listą obsługiwanych szyfrów, rozszerzeń i ich kolejnością. Ten zestaw zależy od biblioteki, której używa klient. Chrome na Windows tworzy jedno powitanie, Firefox — inne, a biblioteka Pythona do żądań HTTP — trzecie, zupełnie niepodobne do przeglądarkowego. Hash tego zestawu nazywa się odciskiem TLS (popularne schematy — JA3 i nowszy JA4).
Magia polega na tym, że scraper może podrobić nagłówek User-Agent w sekundę, ale podrobić odcisk TLS tak, by zgadzał się z deklarowaną przeglądarką, jest znacznie trudniej. Jeśli klient przedstawia się jako świeży Chrome, a jego powitanie TLS odpowiada bibliotece konsolowej, mamy do czynienia ze skryptem. Analogiczne odciski istnieją dla HTTP/2 (kolejność i wartości ramek SETTINGS, priorytety strumieni) i HTTP/3. Kombinacja „deklarowana przeglądarka + TLS + HTTP/2" daje już niezłą dokładność klasyfikacji bez ani jednej linii JavaScriptu.
Odcisk przeglądarki i oznaki automatyzacji
Gdy klient wykonuje JavaScript, pole analizy rozszerza się wielokrotnie. Skrypt ochronny zbiera setki parametrów: rozdzielczość ekranu i jej stosunek do rozmiaru okna, lista czcionek, wynik renderowania grafiki przez Canvas i WebGL, cechy kontekstu audio, strefa czasowa, ustawienia językowe, obecność i zachowanie specyficznych obiektów środowiska. Osobno sprawdzane są oznaki automatyzacji: właściwości, które tryb headless zostawia w środowisku, niezgodności między deklarowaną platformą a realnymi możliwościami, zbyt „idealne" wartości tam, gdzie żywe urządzenie zawsze ma szum.
Ważne, by zrozumieć: celem nie jest jednoznaczna identyfikacja człowieka (to i prawnie wrażliwe, i technicznie zawodne), lecz znalezienie wewnętrznych sprzeczności. Prawdziwy iPhone nie zgłasza 32 rdzeni logicznych procesora. Prawdziwy Chrome na Androidzie nie ma rozdzielczości 1920 na 1080 przy braku wejścia dotykowego. Każda sprzeczność to plus do punktu podejrzliwości.
Sygnały behawioralne
Najbardziej odporna na podrabianie klasa cech — zachowanie w czasie. Człowiek porusza kursorem z mikroskopijnymi drżeniami i przyspieszeniami, przewija stronę nierównomiernie, robi pauzy na czytanie, klika nie w idealny środek przycisku. Człowiek wchodzi na stronę główną, przechodzi do kategorii, ogląda trzy-cztery produkty, wraca. Bot otwiera pięćset kart produktów pod rząd po rosnącym ID, każdą dokładnie co 1,2 sekundy, nigdy nie ładuje obrazów i nie pobiera CSS. Nawet najbardziej zaawansowane scrapery na sterowanych przeglądarkach zdradzają się strukturą sesji: nie da się zrzucić całego katalogu, zachowując się jak jeden kupujący.
Scoring zamiast decyzji czarno-białej
Współczesne systemy nie odpowiadają na pytanie „bot czy człowiek" binarnie. Przypisują każdemu żądaniu lub sesji ocenę ryzyka, a następnie stosują politykę: niskie ryzyko — przepuścić, średnie — pokazać niewidoczny challenge lub spowolnić odpowiedź, wysokie — captcha lub blokada, krytyczne — oddać prawdopodobne, ale zniekształcone dane. Takie podejście drastycznie zmniejsza fałszywe trafienia: wątpliwemu klientowi nie trzaska się drzwiami przed nosem, tylko daje szansę dowiedzenia, że jest żywy.
Co zmienia się w 2026 roku
Kilka tendencji, które już wpływają na projektowanie ochrony:
- Agenci AI jako nowa klasa klientów. Agenci oparci na modelach językowych sterują prawdziwymi przeglądarkami, czytają strony i zachowują się niemal jak ludzie. Część z nich jest pożyteczna (przyprowadzają kupujących), część to po prostu mądrzejsze scrapery. Strony będą musiały formułować wyraźną politykę dla takiego ruchu.
- Standaryzacja „etycznej" identyfikacji botów. Rozwijają się mechanizmy, w których legalny klient zautomatyzowany kryptograficznie potwierdza przynależność do konkretnej firmy. To pozwala przepuszczać pożyteczne roboty bez challenge'y.
- Atestacja urządzeń i tokeny zaufania. Systemy operacyjne i przeglądarki eksperymentują z mechanizmami pozwalającymi stronie uzyskać potwierdzenie „to prawdziwe urządzenie z prawdziwym człowiekiem" bez zbierania odcisków. W perspektywie to uprości ochronę, ale na razie zasięg jest ograniczony.
- Wzrost HTTP/3 i szyfrowania metadanych. Część znanych sygnałów sieciowych staje się mniej dostępna, co przesuwa akcent na analizę behawioralną.
- Presja regulacyjna na zbieranie danych o użytkownikach. Odcisk przeglądarki i przechowywanie sesji wymagają uważnego podejścia do przepisów o danych osobowych. Ochronę trzeba projektować tak, by zbierała minimum niezbędne.
Wniosek z tego rozdziału jest prosty i ważny: solidna ochrona przed scrapingiem opiera się na kombinacji słabych sygnałów, a nie na jednej „srebrnej" cesze. Miej to w głowie, przechodząc do praktyki.
Metoda 1. Diagnostyka: ustalamy, kto i jak Was scrapuje
Ustawianie ochrony po omacku to pewny sposób na przepalenie budżetu i zablokowanie nie tych, co trzeba. Zanim cokolwiek wdrożysz, poświęć dzień lub dwa na rozpoznanie. Dobra wiadomość: nie potrzeba do tego drogich narzędzi, wystarczą logi serwera WWW i umiejętność zadawania im właściwych pytań.
Krok 1. Zbierz pełne logi z reprezentatywnego okresu
Minimum — siedem dni, żeby uchwycić cykl tygodniowy. W logach powinny być: czas, IP, metoda i ścieżka żądania, kod odpowiedzi, rozmiar odpowiedzi, User-Agent, Referer, czas przetwarzania. Jeśli Twój serwer WWW zapisuje tylko standardowy format, rozszerz go. W projekcie z milionami żądań dziennie wygodnie od razu eksportować logi do bazy analitycznej lub przynajmniej do formatu tabelarycznego.
Krok 2. Znajdź anomalie w strukturze ruchu
Zadaj logom następujące pytania i zapisz odpowiedzi — to będzie Twoja linia bazowa.
- Rozkład godzinowy. Żywy ruch ma cykl dobowy. Równy „płaskownik" w nocy lub skok o 4 rano to pierwszy marker.
- Stosunek typów zasobów. Ile żądań do stron HTML przypada na jedno żądanie do CSS, JS i obrazów? U przeglądarki ten stosunek to około 1 do 10-30. U scrapera — 1 do 0. Znajdź adresy i podsieci, które żądają tylko HTML lub tylko JSON.
- Głębokość obchodu. Kto w ramach sesji otwiera ponad 100 kart produktów? Kto kolejno przegląda ID, strony paginacji, kombinacje filtrów?
- Nagłówki. Przestarzałe wersje przeglądarek, pusty lub biblioteczny User-Agent, brak Accept-Language, ten sam User-Agent na tysiącach adresów.
- Kody odpowiedzi. Masowe 404 po nieistniejących ID — oznaka przeglądania. Masowe 429 lub 403 — ktoś już dobija się do Twoich limitów.
- Systemy autonomiczne. Pogrupuj IP po ASN. Udział dostawców hostingu w ruchu katalogu powyżej 5-10% — prawie na pewno boty.
Krok 3. Oszacuj szkody w pieniądzach
Przełóż ustalenia na język biznesu, inaczej ochrona nie dostanie budżetu. Policz: udział pasożytniczych żądań i ich koszt w infrastrukturze; obciążenie zewnętrznych płatnych API (kursy walut, geokodowanie, wyszukiwanie), które generują boty; zniekształcenie analityki (fałszywe sesje psują atrybucję reklam, a to bezpośrednio dotyczy marketerów); utracone korzyści ze skopiowanych cen i treści. Nawet przybliżona ocena w stylu „boty kosztują nas 180 tysięcy złotych miesięcznie na infrastrukturze i nieznaną kwotę na pozycji konkurencyjnej" zmienia rozmowę z zarządem.
Krok 4. Rozstaw pułapki, by potwierdzić hipotezy
Logi pokazują, że ktoś jest, ale nie pokazują, czego dokładnie chce. Uzupełnij analizę aktywnym rozpoznaniem:
- Rekordy kanarkowe. Dodaj do katalogu nieistniejący produkt z unikalną nazwą, który nie jest indeksowany przez wyszukiwarki i nie pokazuje się w nawigacji, ale jest dostępny pod bezpośrednim linkiem z paginacji. Pojawienie się tej nazwy na cudzej stronie — dowód scrapowania i wskazówka co do źródła.
- Ukryte linki. Link niewidoczny dla człowieka (poza ekranem, bez rozmiarów), ale obecny w HTML. Człowiek nigdy w niego nie kliknie. Każde przejście — bot. Nie zapomnij zamknąć go przed robotami wyszukiwarek regułami wykluczenia.
- Unikalne spacje i drobne wariacje. Niewielkie unikalne cechy formatowania w opisach, po których później rozpoznasz skopiowany tekst.
Krok 5. Sporządź profile scraperów
Wynikiem diagnostyki powinna być tabela z trzema do pięciu profili. Na przykład: „Profil A: skrypt chmurowy bez JS, 40 tysięcy żądań do kart w nocy, User-Agent starego Chrome, jedna podsieć". „Profil B: klient rozproszony na adresach rezydenckich, 2-3 żądania z adresu, wykonuje JS, chodzi tylko po filtrze ceny". „Profil C: agregator, przedstawia się uczciwie, pobiera feed raz na dobę". Dla każdego profilu od razu wiadomo, która warstwa ochrony go zatrzyma. Profil A padnie na pierwszej linii. Profil B będzie wymagał analizy behawioralnej. Profilowi C warto może zaproponować partnerskie API — czasem to opłacalniejsze niż wojna.
Lista kontrolna diagnostyki
- Logi z 7+ dni z pełnym zestawem pól zebrane.
- Zbudowany rozkład ruchu po godzinach i typach zasobów.
- Zidentyfikowane top-20 podsieci i ASN pod względem liczby żądań do „cennych" URL-i.
- Znalezione sesje o anomalnej głębokości i regularności.
- Policzony udział ruchu pasożytniczego i jego koszt.
- Rozstawione rekordy kanarkowe i ukryte linki.
- Sformułowane profile scraperów ze wskazaniem docelowej warstwy ochrony.
- Określone legalne boty, których nie wolno ruszać: wyszukiwarki, webhooki płatności, partnerzy, monitoring.
Metoda 2. Pierwsza linia: poziom serwerowy i sieciowy
Pierwsza linia to fundament. Nie zatrzyma zaawansowanego scrapera, ale odsiewa 50-70% prymitywnych botów dosłownie w ciągu dnia pracy i niemal za darmo. Pomijanie tego etapu na rzecz drogich rozwiązań to błąd: po co płacić za analizę każdego żądania, jeśli połowę można odrzucić prostą regułą?
Ograniczanie częstotliwości żądań zrobione poprawnie
Rate limiting to najsłynniejsze narzędzie i najczęściej źle skonfigurowane. Typowy błąd: jeden globalny limit na IP dla całej strony. Efekt — albo limit zbyt łagodny i bezużyteczny, albo zbyt ostry i bijący w biura, uniwersytety i sieci mobilne z NAT. Właściwe podejście to zróżnicowane limity:
- Po typie zasobu. Statyka i strona główna — hojne limity. Karty produktów, wyniki wyszukiwania, endpointy JSON katalogu — znacznie ostrzejsze. Formularze logowania i rejestracji — bardzo ostro.
- Po kluczu. Nie tylko IP. Łącz: IP + ścieżka, IP + User-Agent, cookie sesji, dla zalogowanych — identyfikator konta. Dla sieci mobilnych limit po podsieci /24 lub po ASN z wysokim progiem lepszy niż ostry limit po pojedynczym adresie.
- Po oknach czasu. Dwa okna: krótkie (np. 20 żądań w 10 sekund — przeciw skokom) i długie (np. 600 żądań do kart na godzinę — przeciw wolnemu obchodowi). Wolny, ale uparty scraper wpadnie w drugie okno, żywy człowiek — nie.
- Po typie reakcji. Przekroczenie limitu nie musi oznaczać blokady. Pierwszy stopień — opóźnienie odpowiedzi o 2-5 sekund. Drugi — kod 429 z nagłówkiem Retry-After. Trzeci — tymczasowy ban na 10-15 minut. Stopniowa eskalacja niemal nie dotyka ludzi, a mocno spowalnia boty.
Przykład podstawowej konfiguracji stref dla popularnego serwera WWW, którą dostosujesz do siebie (wartości umowne):
limit_req_zone $binary_remote_addr zone=catalog_burst:20m rate=3r/s;limit_req_zone $binary_remote_addr zone=login:10m rate=10r/m;location /catalog/ { limit_req zone=catalog_burst burst=15 delay=8; }location /login { limit_req zone=login burst=3 nodelay; limit_req_status 429; }Zwróć uwagę na parametr delay: pozwala on część skoku obsłużyć natychmiast, a resztę — z opóźnieniem, co jest komfortowe dla człowieka, który otworzył dziesięć kart, i nieprzyjemne dla skryptu.
Filtrowanie po cechach sieci
Opracuj politykę dla systemów autonomicznych. Dostawcy hostingu i chmury — źródła większości prymitywnych scraperów. Całkowita blokada nie zawsze jest wskazana (stamtąd chodzą też firmowe proxy i część legalnych usług), ale zastosowanie do nich ostrzejszych limitów i obowiązkowego challenge'u JavaScript jest rozsądne. Dla krajów, w których nie prowadzisz biznesu — analogicznie: nie blokada, lecz podwyższony poziom weryfikacji. Pamiętaj o podejściu „słaby sygnał dodaje punkty", a nie „jeden sygnał decyduje o wszystkim".
Reguły na poziomie nagłówków
Kilka tanich, ale skutecznych reguł dla WAF lub konfiguracji serwera:
- Odrzucać żądania z pustym User-Agent lub z sygnaturami znanych bibliotek HTTP do URL-i nieusługowych. Legalne integracje powinny korzystać z dedykowanego API z kluczem, a nie z publicznych stron.
- Wymagać spójności nagłówków: deklarowany Chrome bez charakterystycznych dla niego nagłówków client hints — podejrzany.
- Oddawać kod 404 lub 410 na przestarzałe formaty URL, które scrapery wciąż wywołują po starych mapach strony.
- Ukrywać wersje oprogramowania serwera i frameworków w nagłówkach — nie dla ochrony przed scrapingiem, ale dla ogólnej higieny.
Reguły dla robotów i wyraźna polityka
Plik z regułami dla robotów wyszukiwarek nie jest środkiem ochrony — szkodliwy bot go zignoruje. Ale jest ważny z dwóch powodów. Po pierwsze, pozwala wyraźnie zezwolić pożytecznym botom i wyraźnie zakazać niepożądanych crawlerów, w tym zbieraczy danych dla modeli AI — uczciwi operatorzy tych reguł przestrzegają. Po drugie, utrwala Twoje stanowisko: połączenie reguł technicznych i warunków korzystania z serwisu czyni nieautoryzowane zbieranie danych prawnie bardziej podatnym dla tego, kto się nim zajmuje. Koniecznie wpisz w regulaminie zakaz zautomatyzowanego zbierania bez pisemnej zgody.
Cache'owanie jako ochrona
Nieoczywisty trik: agresywne cache'owanie „cennych" stron na poziomie CDN lub reverse proxy nie przeszkadza scraperowi w pobieraniu danych, ale usuwa główny ból — obciążenie aplikacji i bazy. Jeśli bot zrzuca katalog z cache'u, Twojej infrastrukturze jest to prawie obojętne. To nie zwycięstwo, ale wygrany czas na budowanie kolejnych linii bez gaszenia pożarów.
Lista kontrolna pierwszej linii
- Zdefiniowane grupy URL o różnej wartości i dla każdej ustawione własne limity.
- Zrealizowane dwa okna limitów: krótkie i długie.
- Reakcja na przekroczenie — eskalacja: opóźnienie, 429, tymczasowy ban.
- Limity dla sieci mobilnych i rezydenckich złagodzone lub liczone po podsieci.
- ASN hostingowe i regiony niecelowe przełączone w tryb podwyższonej weryfikacji, a nie bana.
- Ustawione reguły po nagłówkach do odsiewania klientów bibliotecznych.
- Zapisana polityka dla robotów i prawny zakaz zbierania danych.
- Włączone cache'owanie drogich stron.
- Wyjątki dla wyszukiwarek, systemów płatności i partnerów sprawdzone i udokumentowane.
Metoda 3. Druga linia: weryfikacja klienta i challenge'y
Pierwsza linia działa na podstawie cech samego żądania. Druga idzie dalej i zadaje klientowi pytanie: „Udowodnij, że jesteś przeglądarką, i udowodnij, że stoi za Tobą człowiek". Właśnie tutaj odsiewane są skrypty bez wykonywania JavaScriptu i pospiesznie skonfigurowane narzędzia headless. Omówmy narzędzia tej warstwy w kolejności rosnącej „ceny" dla użytkownika.
Odcisk TLS i HTTP/2: filtr bezszwowy
Zacznij od tego, czego użytkownik w ogóle nie zauważa. Na load balancerze lub reverse proxy obliczaj odcisk TLS połączenia i porównuj go z deklarowanym User-Agent. Typowa logika:
- Odcisk odpowiada znanej bibliotece HTTP, a User-Agent deklaruje przeglądarkę — wysokie ryzyko.
- Odcisk odpowiada przeglądarce, ale nie tej rodzinie lub wersji, co w nagłówku — średnie ryzyko.
- Odcisk pojawia się na Twojej stronie po raz pierwszy i występuje jednocześnie u tysięcy adresów — podejrzenie nowego narzędzia do scrapingu.
Ważny szczegół wdrożenia: nie blokuj po odcisku TLS pierwszego dnia. Zbierz statystyki przez tydzień, ustal, które odciski odpowiadają Twojej realnej publiczności (w tym przeglądarkom wewnątrz aplikacji mobilnych i webview komunikatorów, które mają specyficzne odciski), i dopiero potem przełączaj reguły w tryb działania. Inaczej ryzykujesz odcięcie użytkowników otwierających Twoją stronę z Telegrama lub klienta poczty.
Challenge JavaScript: weryfikacja środowiska wykonania
Podstawowy challenge JS to niewielki skrypt, który klient musi wykonać, by otrzymać cookie dostępu. Bez cookie serwer oddaje zaślepkę zamiast treści. Proste skrypty na bibliotekach HTTP nie wykonują JavaScriptu i zostają za drzwiami. Bardziej zaawansowana wersja zbiera cechy środowiska i sprawdza ich spójność, o czym mówiliśmy w rozdziale o sygnałach.
Praktyczne zalecenia dotyczące wdrożenia:
- Nie pokazuj challenge wszystkim. Stosuj go do żądań ze średnim wynikiem ryzyka i do cennych sekcji. Strona główna i landing page, do których prowadzi reklama, muszą otwierać się natychmiast — każda dodatkowa sekunda do pierwszego ekranu kosztuje konwersję, a arbitrażyści wiedzą to lepiej niż ktokolwiek.
- Zrób challenge niewidocznym. Skrypt powinien wykonywać się w tle w 100-300 milisekund, bez białego ekranu i napisów „sprawdzamy Twoją przeglądarkę". Dla uczciwego klienta proces jest niezauważalny.
- Wiąż wynik z sesją, a nie z IP. Cookie dostępu powinno być podpisane, mieć czas życia i zawierać hash kluczowych cech klienta. Wtedy nie da się go po prostu skopiować i rozdać setce wątków scrapera.
- Regularnie zmieniaj challenge. Statyczna weryfikacja zostanie rozgryziona w tydzień. Obfuskuj kod, zmieniaj sprawdzane parametry, rotuj klucze podpisu.
- Sprawdzaj spójność danych JS z serwerowymi. Strefa czasowa ze skryptu nie zgadza się z geolokalizacją IP? Deklarowana platforma nie zgadza się z odciskiem TLS? Każda niezgodność — punkt ryzyka.
Proof of work: bariera ekonomiczna
Elegancki trik zyskujący na popularności jako alternatywa dla captchy. Serwer przydziela klientowi zadanie obliczeniowe (np. znaleźć wartość, której hash zaczyna się od określonej liczby zer). Przeglądarka na telefonie rozwiązuje je w 200-500 milisekund, niezauważalnie dla człowieka. Ale scraper wykonujący 100 tysięcy żądań musi na to poświęcić godziny czasu procesora. Trudność zadania można zwiększać proporcjonalnie do wyniku ryzyka: podejrzanemu klientowi — zadanie dziesięć razy cięższe. Człowiek nie zauważa różnicy, bot — jak najbardziej.
Captcha: gdzie wskazana, a gdzie szkodliwa
Captcha to najbardziej widoczne i najbardziej irytujące narzędzie. Badania doświadczenia użytkownika konsekwentnie pokazują: każda captcha na drodze do zakupu obniża konwersję, przy czym dla użytkowników mobilnych straty są wyższe. Dlatego reguła jest prosta: captcha to ostatni argument, a nie pierwsza weryfikacja. Wskazane punkty zastosowania:
- formularze logowania po kilku nieudanych próbach;
- rejestracja i odzyskiwanie hasła;
- wysyłanie formularzy kontaktowych i opinii;
- sytuacje, gdy wynik ryzyka sesji jest już wysoki, a klient wciąż próbuje chodzić po katalogu;
- ochrona krytycznych operacji: rezerwacja, zastosowanie kodu promocyjnego, dodanie deficytowego towaru do koszyka.
Nieodpowiednie punkty: strona główna, karty produktów, wyszukiwanie, landing page kampanii reklamowych. Jeśli musisz stawiać captchę na katalogu, znaczy to, że poprzednie warstwy nie działają, i leczyć trzeba je. Osobno: wybieraj nowoczesne warianty captchy z trybem niewidocznym i adaptacyjną trudnością, a nie obrazki z zniekształconymi literami z lat dwutysięcznych.
Ochrona API i aplikacji mobilnych
Często scrapery nawet nie chodzą po stronie — znajdują endpointy JSON, z których korzysta Twój frontend, i pobierają czyste dane bez parsowania HTML. Sprawdź: czy Twoje API katalogowe jest dostępne bez cookie sesji i bez podpisanego żądania? Jeśli tak, cała ochrona strony jest bez sensu. Minimalny zestaw środków: krótkotrwałe podpisane tokeny wydawane po przejściu challenge'u; wiązanie tokenu z sesją; ograniczenie rozmiaru odpowiedzi i głębokości paginacji; osobne, ostrzejsze limity na API. Dla aplikacji mobilnych — weryfikacja autentyczności aplikacji środkami platform i pinning certyfikatów.
Lista kontrolna drugiej linii
- Obliczane są odciski TLS/HTTP2, zebrane tygodniowe statystyki dotyczące Twojej publiczności.
- Reguły po odciskach przełączone w tryb działania dopiero po analizie.
- Challenge JS wdrożony niewidocznie i stosowany adaptacyjnie po wyniku ryzyka.
- Cookie dostępu podpisane, powiązane z klientem, ma czas życia.
- Zrealizowany proof of work z adaptacyjną trudnością.
- Captcha stoi tylko na formularzach i operacjach krytycznych, nie na katalogu.
- API katalogu chronione tokenami i limitami, niedostępne bez sesji.
- Wszystkie weryfikacje przetestowane w webview komunikatorów i przeglądarkach mobilnych.
Metoda 4. Trzecia linia: zachowanie, pułapki i ochrona samych danych
Przypuśćmy, że scraper przeszedł dwa pierwsze kręgi: chodzi z adresów rezydenckich, steruje prawdziwą przeglądarką o wiarygodnym odcisku, wykonuje challenge'e. Co dalej? Dalej przechodzimy od pytania „kim jesteś" do pytania „co robisz" i, w końcu, do dewaluacji samego łupu. To najbardziej intelektualna warstwa ochrony antyscraperowej strony i właśnie ona odróżnia dojrzały system od zestawu reguł.
Behawioralny scoring sesji
Podstawą trzeciej linii jest kumulowanie punktów ryzyka po sesji w czasie. Cechy, które warto liczyć:
- Głębokość i struktura nawigacji. Ponad 50-100 kart produktów na godzinę, obchód paginacji do końca, przeglądanie wszystkich kombinacji filtrów, ruch po rosnących identyfikatorach.
- Rytm. Zbyt równomierne odstępy między żądaniami lub, przeciwnie, odstępy o idealnie losowym rozkładzie (człowiek nigdy nie jest idealnie losowy).
- Brak interakcji. Brak zdarzeń ruchu myszy, przewijania, dotknięć, zmiany rozmiaru okna, fokusu. Strona załadowana, ale nikt na nią nie patrzy.
- Nietypowe ścieżki. Ani jednego przejścia na stronę główną, do koszyka, do kontaktu. Tylko docelowe strony z danymi.
- Ignorowanie zasobów. Nie są pobierane obrazy, czcionki, skrypty analityczne.
- Cechy wielosesyjne. Ten sam odcisk przeglądarki na setkach adresów, dziesiątki sesji o identycznym wzorcu nawigacji startujących w jednej minucie.
Reakcja na wzrost wyniku — ta sama eskalacja: najpierw spowolnienie odpowiedzi, potem challenge o podwyższonej trudności, potem captcha, potem blokada sesji. Co więcej, blokować należy właśnie sesję i odcisk, a nie IP — pamiętaj o sieciach mobilnych.
Pułapki-honeypoty w środowisku produkcyjnym
Pułapki, których używaliśmy przy diagnostyce, doskonale działają też jako stały element ochrony. Każdy ukryty link, każde niewidoczne pole formularza wypełnione przez klienta, każde żądanie do nieistniejącego w nawigacji URL — sygnał o niemal zerowym poziomie fałszywych trafień. Człowiek fizycznie nie może kliknąć elementu o zerowym rozmiarze. Zasady bezpieczeństwa: zamykaj pułapki przed robotami wyszukiwarek, nie używaj pułapek, które może trafić czytnik ekranu dla użytkowników z niepełnosprawnościami, regularnie zmieniaj położenie i wygląd pułapek.
Dewaluacja łupu: praca z samymi danymi
Oto strategia, o której prawie się nie mówi, a często bywa skuteczniejsza niż jakakolwiek blokada. Jeśli nie możesz przeszkodzić botowi w zabraniu danych, spraw, by zabrane było bezużyteczne lub zdradzieckie.
- Trucie danych dla podejrzanych sesji. Klientowi z wysokim wynikiem ryzyka oddaje się nie błąd 403, lecz normalną stronę ze zniekształconymi cenami i stanami magazynowymi: cena plus-minus 7%, losowy stan, zmieniony rating. Scraper nie rozumie, że został zdemaskowany, i dalej zbiera śmieci, które następnie trafiają do bazy konkurenta. Jeden taki incydent, wykryty już po przecenie towarów, na długo odbiera ochotę na scraping. Stosuj ostrożnie: tylko przy bardzo wysokiej pewności, by nie pokazać niewłaściwej ceny żywemu kupującemu, i nigdy — dla prawnie istotnych informacji.
- Znaki wodne w danych. Unikalne dla każdej sesji mikrocechy treści: kolejność słów w opisie, niewidoczne wariacje formatowania, unikalne „kanarkowe" produkty. Po nich później udowodnisz, skąd wyciekły dane i z którym klientem to związane.
- Dynamiczne znaczniki. Regularna zmiana nazw klas CSS i struktury HTML na cennych stronach łamie scrapery przywiązane do selektorów. To wyścig, ale każda iteracja kosztuje Cię jedno wydanie, a atakującego — przepisanie logiki.
- Renderowanie krytycznych wartości niestandardowo. Cenę można złożyć z kilku elementów, wstawić przez pseudoelementy CSS, oddać jako obraz lub leniwie doczytać po interakcji. Każdy sposób ma cenę dla dostępności i optymalizacji pod wyszukiwarki — rozważaj.
- Ograniczenie wyników. Nie oddawaj całego katalogu nikomu: twardy limit głębokości paginacji, obowiązkowe zawężanie filtrami, brak endpointu „wszystkie produkty jedną listą".
Legalny kanał zamiast wojny
Paradoksalny, ale skuteczny trik. Jeśli Twoje dane są systematycznie potrzebne agregatorom, partnerom lub badaczom, daj im oficjalne API z kluczem, limitami i warunkami użytkowania. Część obciążenia przeniesie się ze „szarej" strefy do kontrolowanej, a Ty zyskasz prawną i techniczną podstawę do twardego działania wobec tych, którzy nadal scrapują publiczne strony.
Framework stopniowego wdrażania wszystkich trzech linii
Osobno o procesie, bo większość porażek wynika nie z technologii, lecz z pośpiechu. Zalecana kolejność:
- Tryb obserwacji (1-2 tygodnie). Wszystkie reguły i scoring działają, ale nic nie blokują — tylko logują decyzje. Widzisz, kogo byś zablokował, i konfrontujesz to z rzeczywistością.
- Kalibracja. Ręcznie analizujesz top sesji „do zablokowania". Znajdą się wśród nich Twoi partnerzy, Twój własny monitoring, webview komunikatora i użytkownicy z dziwnymi, ale żywymi przeglądarkami. Korygujesz progi, dodajesz wyjątki.
- Miękkie działanie (1-2 tygodnie). Włączasz tylko spowolnienie i niewidoczne challenge'e. Obserwujesz konwersję, współczynnik odrzuceń, zgłoszenia do wsparcia.
- Pełne działanie ze stopniowym zasięgiem. Włączasz captche i blokady najpierw na 10% ruchu, potem 50%, potem w pełni. Na każdym kroku — kontrola metryk.
- Eksploatacja. Cotygodniowy przegląd fałszywych trafień, comiesięczna weryfikacja progów, rotacja challenge'y i pułapek, aktualizacja profili scraperów.
Kluczowe metryki do kontroli
- Udział ruchu klasyfikowanego jako bot, według sekcji strony.
- Liczba zgłoszeń do wsparcia ze skargami na captchę lub niedostępność.
- Konwersja i współczynnik odrzuceń przed i po, osobno dla publiczności mobilnej.
- Udział fałszywych trafień na próbie ręcznie sprawdzonych sesji (cel — poniżej 0,5%).
- Obciążenie aplikacji i bazy danych, koszt infrastruktury.
- Czas, jaki upływa między Twoją zmianą ceny a jej pojawieniem się u znanego konkurenta.
Typowe błędy przy wdrażaniu ochrony antyscraperowej
Omówiliśmy, co robić. Teraz o tym, czego robić nie należy — z doświadczeń dziesiątek projektów te błędy powtarzają się z zadziwiającą regularnością.
Błąd 1. Blokowanie po IP jako główny środek
Najczęstszy i najbardziej szkodliwy. Właściciel strony widzi tysiąc żądań z adresu, banuje go — i odcina biurowiec lub segment sieci mobilnej operatora, za którym są tysiące abonentów. Scraper tymczasem przełącza się na następny adres. IP to słaby sygnał, powód do podwyższonej weryfikacji, ale nie do bana.
Błąd 2. Captcha na wszystko
Reakcja w stylu „postawimy captchę na każdej stronie, i niech boty cierpią". Cierpi nie bot, a konwersja: żywi ludzie odchodzą, reklama przepala budżet na użytkowników, którzy nie dotarli do treści, roboty wyszukiwarek dostają zaślepkę. Captcha to narzędzie punktowe dla formularzy i operacji krytycznych.
Błąd 3. Włączanie blokad bez trybu obserwacji
Reguły pisane wieczorem, włączane w nocy, a rano dział wsparcia tonie w skargach. Zawsze najpierw obserwacja, potem kalibracja, potem działanie.
Błąd 4. Zapomniane legalne boty
Zablokowany robot wyszukiwarki — utrata pozycji po dwóch tygodniach. Zablokowany webhook płatności — nieopłacone zamówienia. Zablokowany własny monitoring — fałszywe alarmy. Przed włączeniem jakiejkolwiek reguły sporządź i sprawdź listę wyjątków.
Błąd 5. Ignorowanie API i endpointów mobilnych
Strona chroniona wzorowo, a JSON, który wywołuje frontend, otwarty na cały świat bez tokenu. Scraper dziękuje za czyste, ustrukturyzowane dane. Ochrona musi pokrywać wszystkie kanały dostarczania treści.
Błąd 6. Statyczne challenge'e i pułapki
Ochrona skonfigurowana raz po miesiącu jest rozgryziona i obejdzona. Ochrona antyscraperowa strony to proces, a nie projekt: rotacja, aktualizacja, weryfikacja progów.
Błąd 7. Trucie danych bez wysokiej pewności
Pokusa pokazania „zepsutych" cen jest duża, ale jedna niewłaściwa cena pokazana żywemu klientowi, a tym bardziej złożone po niej zamówienie, to ryzyko reputacyjne i prawne. Stosuj tylko do sesji z maksymalnym wynikiem i nigdy — do prawnie istotnych informacji.
Błąd 8. Zapomniana dostępność
Pułapki i niestandardowe renderowanie mogą psuć stronę dla czytników ekranu i użytkowników z niepełnosprawnościami. Testuj ochronę narzędziami do dostępności, a nie tylko w świeżym Chrome.
Błąd 9. Zbieranie nadmiarowych danych o użytkownikach
Odcisk przeglądarki i szczegółowe logi zachowania to informacje, do których stosują się przepisy o danych osobowych. Zbieraj minimum niezbędne do rozwiązania, ograniczaj okresy przechowywania, odzwierciedlaj fakt przetwarzania w polityce prywatności.
Błąd 10. Brak metryk sukcesu
Ochrona włączona, a na pytanie „czy jest lepiej?" nikt nie potrafi odpowiedzieć. Bez linii bazowej z diagnostyki i bez kontroli konwersji nie odróżnisz zwycięstwa od porażki.
Narzędzia i zasoby do realizacji
Obiecaliśmy nie porównywać dostawców i słowa dotrzymujemy. Poniżej — kategorie narzędzi i to, za co każda odpowiada, żebyś mógł złożyć stos pod swoją skalę i budżet. Nazwy konkretnych rozwiązań łatwo znajdziesz sam; tutaj ważna jest architektura.
Poziom serwera WWW i reverse proxy
Nginx, Apache, Caddy, HAProxy, Envoy. Co dają: rate limiting po elastycznych kluczach, reguły po nagłówkach, oddawanie różnych odpowiedzi warunkowo, obliczanie odcisków TLS przez moduły i rozszerzenia. To Twoja pierwsza linia, i dla projektu do kilku milionów żądań dziennie na starcie może wystarczyć.
WAF i CDN z ochroną
Chmurowe CDN z wbudowanymi WAF i trybami filtrowania botów albo samodzielnie wdrożone WAF na bazie otwartych zestawów reguł. Co dają: filtrowanie po reputacji ASN i geografii, zarządzane challenge'e, podstawowy scoring, cache'owanie. Plus — szybkie włączenie. Minus — ograniczona konfigurowalność pod Twoją logikę biznesową.
Wyspecjalizowane platformy zarządzania botami
Komercyjne i otwarte systemy, które zbierają odciski klientów, prowadzą scoring behawioralny, stosują adaptacyjne challenge'e i dają panel analityczny. Uzasadnione, gdy udział ruchu botów jest wysoki, dane cenne, a zespołu do własnego rozwoju brak. Przy wyborze patrz na tryb obserwacji, granularność polityk, wsparcie dla Twoich aplikacji mobilnych i webview, a także na przejrzystość decyzji — musisz rozumieć, dlaczego konkretny klient został zablokowany.
Biblioteki do własnego rozwoju
Otwarte biblioteki do zbierania odcisków przeglądarki, realizacji proof of work, obliczania odcisków TLS po stronie serwera, detekcji oznak automatyzacji. Odpowiednie dla zespołów z programistami, którzy chcą pełnej kontroli. Pamiętaj o konieczności ciągłej aktualizacji: oznaki trybu headless zmieniają się z każdą wersją przeglądarek.
Captche i alternatywy
Nowoczesne usługi weryfikacji z trybem niewidocznym i adaptacyjną trudnością oraz rozwiązania oparte na proof of work bez interakcji z użytkownikiem. Kryteria wyboru: dostępność dla osób z niepełnosprawnościami, działanie w Twoim regionie bez opóźnień, minimalne zbieranie danych o użytkownikach.
Analityka i obserwowalność
Stos do zbierania i analizy logów (ELK i analogi, ClickHouse, chmurowe systemy analityczne), dashboardy do metryk ochrony, systemy powiadomień o anomaliach ruchu. Bez nich jesteś ślepy: nie da się kalibrować progów, nie widząc decyzji systemu w podziale na segmenty publiczności.
Narzędzia testowe
Osobne zalecenie: testuj swoją ochronę tymi samymi środkami, których używają scrapery. Zautomatyzowana przeglądarka w trybie headless, klient HTTP w popularnym języku, narzędzia do profilowania sieci. Jeśli Twój własny prosty skrypt swobodnie zrzuca katalog, znaczy to, że praca nie została skończona. Dla zespołu pracującego z mobilnymi proxy warto sprawdzić też inny scenariusz: czy ochrona nie blokuje uczciwych użytkowników z sieci mobilnych, gdzie adresy są dzielone między tysiącami abonentów.
Zasoby wewnętrzne, które będą potrzebne
- Osoba odpowiedzialna za ochronę z uprawnieniami do zmiany progów.
- Regulamin rozpatrywania fałszywych trafień z udziałem wsparcia.
- Prawnie zweryfikowane warunki użytkowania i polityka prywatności.
- Oficjalny kanał dla partnerów, którym potrzebne są Twoje dane.
Case studies: jak to działa w realnych projektach
Trzy zanonimizowane historie z praktyki wdrożeń, z liczbami i wnioskami. Szczegóły zmienione, istota zachowana.
Case 1. Sklep internetowy z elektroniką: 71% żądań do katalogu od botów
Sytuacja. Sklep średniej wielkości, około 40 tysięcy produktów, zauważył, że konkurenci zmieniają ceny w ciągu pół godziny po nim. Diagnostyka logów pokazała: 71% żądań do kart produktów w nocy i 44% w dzień — zautomatyzowane. Główne profile: dwa skrypty chmurowe bez JS i jeden klient rozproszony na adresach rezydenckich, chodzący tylko po stronach z cenami. Koszt infrastrukturalny pasożytniczego ruchu — około 140 tysięcy złotych miesięcznie, plus limity płatnego API geokodowania wyczerpywały się do południa.
Rozwiązanie. Pierwsza linia: zróżnicowane limity po sekcjach, ostry tryb dla ASN hostingowych, cache'owanie kart. Druga linia: odciski TLS z tygodniową obserwacją, niewidoczny challenge JS dla katalogu, ochrona endpointu JSON frontendu tokenami. Trzecia linia: scoring po głębokości sesji, ukryte linki, kanarkowe produkty, dla sesji z maksymalnym wynikiem — zniekształcanie cen w granicach 5-8%.
Wynik po dwóch miesiącach. Udział ruchu botów do katalogu spadł do 9%. Skrypty chmurowe zniknęły w pierwszym tygodniu. Klient rozproszony utrzymał się trzy tygodnie, potem, sądząc po kanarkowych produktach, zaczął zbierać zniekształcone ceny, a po miesiącu aktywność ustała. Obciążenie aplikacji spadło o 58%, koszty infrastruktury — o 96 tysięcy złotych miesięcznie. Konwersja nie zmieniła się istotnie statystycznie; liczba zgłoszeń do wsparcia w sprawie captchy — 11 w ciągu dwóch miesięcy przy publiczności liczącej setki tysięcy odwiedzających. Poziom fałszywych trafień na ręcznej próbie — 0,3%.
Lekcja. Trucie danych okazało się decydującym czynnikiem przeciw najbardziej upartemu scraperowi, ale zadziałało tylko dlatego, że poprzednie warstwy zapewniły wysoką pewność klasyfikacji.
Case 2. Serwis ogłoszeniowy usług: ochrona kontaktów i ogłoszeń
Sytuacja. Platforma z ogłoszeniami prywatnych specjalistów cierpiała z powodu masowego zbierania danych kontaktowych: telefony wykonawców trafiały do baz spamowych, użytkownicy skarżyli się i odchodzili. Zbieranie odbywało się przez sterowane przeglądarki o wiarygodnych odciskach z adresów rezydenckich i mobilnych; pierwsza linia prawie nie pomagała.
Rozwiązanie. Nacisk na trzecią linię i ochronę danych. Kontakty wyniesione z HTML i oddawane tylko po kliknięciu, przez podpisane żądanie z tokenem sesji, z limitem ujawnień na godzinę na sesję i podwyższoną trudnością proof of work przy wzroście wyniku ryzyka. Dla zalogowanych użytkowników limit wyższy, dla gości — niższy. Scoring sesji z uwzględnieniem interakcji: ujawnienie kontaktu bez wcześniejszego przewinięcia do niego i bez ruchu wskaźnika dodawało punkty. Captcha — tylko przy piątym i kolejnych ujawnieniach na godzinę dla gości.
Wynik. Liczba ujawnionych kontaktów na jedną sesję u podejrzanych klientów spadła z setek do 3-4, po czym sesje były blokowane. Skargi wykonawców na spam spadły o 80% w ciągu kwartału. Konwersja „wyświetlenie ogłoszenia — kontakt" u żywych użytkowników wzrosła o 4% — prawdopodobnie dlatego, że strony stały się szybsze dzięki zdjętemu obciążeniu.
Lekcja. Gdy scraper jest nieodróżnialny od człowieka po odcisku, ratuje zmiana samego modelu dostarczania danych: cenne oddaje się po działaniu, dawkuje i z rosnącą ceną.
Case 3. Katalog B2B: fałszywe trafienia jako główny problem
Sytuacja. Dostawca komponentów przemysłowych włączył chmurową ochronę antybotową w trybie ostrym bez obserwacji. Po dwóch dniach — spadek zapytań o 35%. Analiza pokazała: klienci firmy siedzą w sieciach korporacyjnych ze wspólnymi adresami i przestarzałymi przeglądarkami, a znaczna część ruchu idzie przez webview firmowego komunikatora o niestandardowym odcisku TLS. System uznał ich za boty.
Rozwiązanie. Cofnięcie do trybu obserwacji, dwa tygodnie kalibracji, utworzenie białej listy odcisków i podsieci kluczowych klientów, przełączenie segmentów korporacyjnych w tryb „tylko spowolnienie i niewidoczny challenge, nigdy — captcha". Dodatkowo — partnerskie API dla trzech dystrybutorów, którzy wcześniej scrapowali katalog do własnych systemów.
Wynik. Zapytania wróciły do normy w ciągu tygodnia po kalibracji. Ruch botów spadł o 62% dzięki przejściu dystrybutorów do oficjalnego API i odsianiu prymitywnych skryptów. Fałszywe trafienia — poniżej 0,2%.
Lekcja. Tryb obserwacji to nie formalność. A część „scraperów" to w rzeczywistości Twoi partnerzy, którym łatwiej dać API niż walczyć.
FAQ: odpowiedzi na trudne pytania
Czy da się całkowicie zatrzymać scraping?
Uczciwa odpowiedź — nie, jeśli dane są publicznie dostępne człowiekowi, są technicznie dostępne i wystarczająco zmotywowanemu botowi. Celem ochrony jest uczynienie zbierania tak drogim, wolnym i zawodnym, by straciło sens ekonomiczny. W większości scenariuszy komercyjnych to wystarcza: konkurent otrzymujący dane z opóźnieniem dobowym i z procentem zniekształceń nie zyskuje przewagi.
Czy ochrona antyscraperowa zaszkodzi pozycjonowaniu w wyszukiwarkach?
Zaszkodzi, jeśli zrobisz ją źle: zablokujesz roboty wyszukiwarek, oddasz im challenge zamiast treści lub wyrenderujesz ceny jako obrazki. Poprawnie zbudowana ochrona rozpoznaje legalne roboty (po deklarowanych zakresach adresów i odwrotnym sprawdzeniu DNS), przepuszcza je bez weryfikacji i nie zmienia dla nich treści. Sprawdzaj widoczność stron narzędziami webmastera po każdej zmianie polityki.
Jak chronić stronę, nie blokując użytkowników sieci mobilnych?
Nigdy nie banuj pojedynczego IP z sieci mobilnej; licz limity po podsieci lub ASN z wysokimi progami; polegaj na sygnałach sesyjnych i behawioralnych, a nie sieciowych; stosuj do wątpliwych klientów niewidoczne challenge'e i spowolnienie, a nie captchę. Koniecznie testuj ochronę z realnych urządzeń mobilnych w sieciach głównych operatorów.
Czy robić ochronę samodzielnie, czy brać gotową platformę?
Zależy od skali i zespołu. Pierwsza linia i podstawowe challenge'e realizowane są siłami jednego programisty w dwa tygodnie i pokrywają większość prymitywnych botów. Scoring behawioralny z ciągłą aktualizacją to praktycznie osobny produkt, i dla projektów bez dedykowanego zespołu bezpieczeństwa gotowa platforma zwykle wychodzi taniej w przeliczeniu na rok. Rozsądna droga — zacząć od własnych podstawowych środków, zmierzyć pozostały problem i dopiero potem zdecydować, czy potrzebne jest wyspecjalizowane narzędzie.
Jak podchodzić do crawlerów modeli AI?
Jak do decyzji biznesowej, a nie tylko technicznej. Jeśli obecność w odpowiedziach asystentów AI przyprowadza Ci publiczność — zezwól na obchód przez reguły dla robotów i nie przeszkadzaj. Jeśli Twoja treść to Twój produkt i jej przytoczenie przez model pozbawia Cię ruchu — zabroń wyraźnie i podeprzyj środkami technicznymi. Uczciwi operatorzy ogłaszają swoje crawlery i przestrzegają reguł, nieuczciwi trafiają pod ogólną ochronę antyscraperową strony na równi z innymi scraperami.
Czy oddawanie scraperom zniekształconych danych jest legalne?
Technicznie masz prawo pokazywać różnym klientom różne treści na swoim zasobie, ale trzeba wykluczyć sytuacje, gdy zniekształcona informacja staje się podstawą transakcji z realnym konsumentem, oraz nie zniekształcać informacji, które prawo nakazuje ujawniać rzetelnie. Stosuj trucie tylko do sesji o maksymalnej pewności klasyfikacji, wyłączaj je dla zalogowanych użytkowników i skonsultuj się z prawnikiem w zakresie swojej branży.
Jak często trzeba aktualizować ochronę?
Progi i wyjątki — co tydzień w pierwszych miesiącach, potem co miesiąc. Challenge'e i pułapki — rotacja raz na 4-8 tygodni lub przy wykryciu obejścia. Profile scraperów — weryfikować przy każdej zauważalnej zmianie obrazu ruchu. Oznaki automatyzacji w przeglądarkach — z każdym większym wydaniem przeglądarek. Ochrona bez obsługi degraduje się w ciągu kwartału lub dwóch.
Co zrobić, jeśli scrapuje duży konkurent z dużym budżetem?
Przesuń akcent z blokowania na dewaluację i dowody: rekordy kanarkowe i znaki wodne dadzą argumenty prawne, trucie danych uczyni łup zawodnym, ograniczenie głębokości wyników nie pozwoli zabrać całego katalogu. Równolegle dokumentuj incydenty i oceniaj perspektywy działań reklamacyjnych — przy dowodach systematycznego zbierania w naruszeniu warunków użytkowania często okazują się skuteczniejsze niż wyścig techniczny.
Od czego zacząć, jeśli budżet i czas są ograniczone?
Jeden dzień na diagnostykę po logach. Potem: zróżnicowany rate limiting z dwoma oknami, cache'owanie drogich stron, zamknięcie endpointów JSON tokenami, ukryte linki-pułapki i kanarkowe produkty. Ten zestaw realizuje się w tydzień niemal bezkosztowo i odsiewa większość problemów. Dalej — mierzyć i decydować, czy potrzebna jest następna warstwa.
Zakończenie: ochrona jako proces, a nie zakup
Jeśli sprowadzić wszystko powiedziane do jednej myśli, będzie ona taka: ochrona antyscraperowa strony to nie pudełko, które się stawia i zapomina, lecz system z trzech spójnych warstw i proces jego ciągłej kalibracji. Poziom sieciowy odsiewa prymitywne boty niemal za darmo. Weryfikacja klienta łapie skrypty i niedbale skonfigurowane zautomatyzowane przeglądarki. Analiza behawioralna i praca z samymi danymi czynią wysiłki nawet zaawansowanych scraperów bezsensownymi. A łączy to wszystko zasada scoringu: nie trzaskać drzwiami po jednej cesze, lecz kumulować słabe sygnały i reagować proporcjonalnie.
Nie mniej ważny jest proces. Diagnostyka przed wdrożeniem, tryb obserwacji przed włączeniem blokad, stopniowy zasięg, metryki konwersji obok metryk ochrony, regularna rotacja — właśnie to odróżnia udane projekty od tych, które po tygodniu się wycofują z powodu skarg klientów. I pamiętaj o ludziach za adresami: użytkownicy sieci mobilnych, firmowych proxy i webview komunikatorów to Twoi żywi kupujący, a ochrona musi przejść test przyjazności wobec nich.
Co zrobić dalej, jeszcze dziś:
- Wyeksportuj logi z tygodnia i odpowiedz na pytania z rozdziału o diagnostyce. To darmowe i zajmie kilka godzin.
- Policz, ile kosztuje Cię ruch botów w infrastrukturze i utraconych korzyściach. Ta liczba określi budżet.
- Wdróż pierwszą linię według listy kontrolnej: limity, cache, reguły po nagłówkach, ochrona API.
- Rozstaw pułapki i rekordy kanarkowe — będą pracować na Ciebie miesiącami.
- Zaplanuj drugą i trzecią linię etapowo, z trybem obserwacji na każdym kroku.
- Załóż kalendarz obsługi ochrony i wyznacz osobę odpowiedzialną.
Dane, które zbierasz i tworzysz, to aktyw. Jak każdy aktyw zasługują na ochronę współmierną do ich wartości i nieprzeszkadzającą tym, dla których zostały stworzone. Mamy nadzieję, że ten przewodnik stanie się dla Ciebie tą zakładką, do której będziesz wracać na każdym etapie — od pierwszego spojrzenia na logi do dojrzałego, spokojnie działającego systemu.
