Сбор отзывов с карт, маркетплейсов и агрегаторов: пошаговая инструкция для начинающих
Содержание статьи
- Введение: что вы получите в итоге
- Предварительная подготовка: инструменты и доступы
- Базовые понятия: как устроены отзывы и почему их собирают иначе, чем каталоги
- Шаг 1: определяем цель и составляем список источников
- Шаг 2: проектируем таблицу отзывов
- Шаг 3: используем официальные пути — кабинеты и api
- Шаг 4: собираем отзывы с карт — яндекс карты, 2гис, google maps
- Шаг 5: собираем отзывы с маркетплейсов — wildberries, ozon, яндекс маркет
- Шаг 6: собираем отзывы с агрегаторов — отзовик, irecommend, flamp, zoon
- Шаг 7: подключаем мобильные прокси и настраиваем ротацию
- Шаг 8: сохраняем, чистим и дедуплицируем
- Проверка результата: чек-лист и тестирование
- Типичные ошибки и решения
- Дополнительные возможности для продвинутых
- Faq: частые вопросы по сбору отзывов
- Заключение
Введение: что вы получите в итоге
Отзывы — это самый честный источник информации о продукте, магазине или заведении. В них люди сами рассказывают, что им понравилось, что сломалось, почему они больше не вернутся и что посоветовали бы друзьям. Проблема в том, что отзывы разбросаны по десяткам площадок: карты, маркетплейсы, агрегаторы, отраслевые каталоги. Читать их вручную неделями — нереально. Поэтому нужен системный сбор.
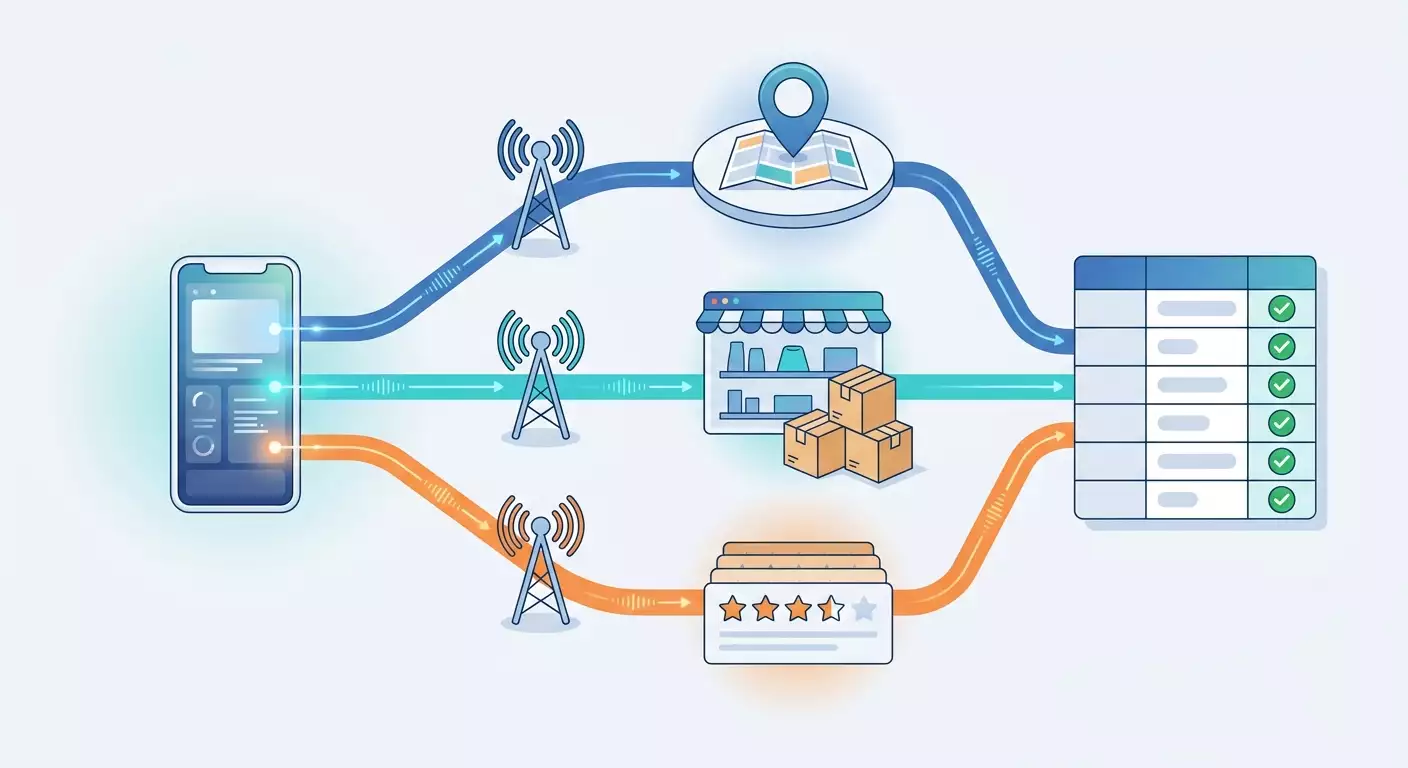
В этом руководстве мы разберём, как собрать отзывы с трёх типов площадок: картографических сервисов (Яндекс Карты, 2ГИС, Google Maps), маркетплейсов (Wildberries, Ozon, Яндекс Маркет) и агрегаторов (Отзовик, iRecommend, Flamp, Zoon). Вы пройдёте весь путь: от постановки задачи и проектирования таблицы до рабочего скрипта, подключения мобильных прокси и чистки данных.
Что вы получите в результате:
- Понимание, где и в каком виде лежат отзывы на каждом типе площадок.
- Готовую структуру таблицы отзывов, которую можно загрузить в Excel, Google Таблицы или базу данных.
- Работающий парсер отзывов на Python, который умеет ходить через мобильные прокси и не перегружает площадки.
- Знание официальных путей выгрузки: личные кабинеты, партнёрские API, экспорты.
- Чек-лист проверки качества собранных данных и список типичных ошибок.
Для кого этот гайд. Он рассчитан на маркетологов, владельцев бизнеса, арбитражников и начинающих разработчиков. Если вы никогда не писали код — не пугайтесь. Часть сценариев выполняется вообще без программирования, а для скриптов мы даём готовые фрагменты, которые нужно только скопировать и подставить свои значения. Для тех, кто уже умеет программировать, в конце есть отдельный блок с продвинутыми техниками.
Что нужно знать заранее. Достаточно уметь пользоваться браузером, устанавливать программы и работать с таблицами. Базовое представление о том, что такое прокси, поможет, но мы объясним ключевые термины по ходу.
Важная граница этого материала. Здесь мы говорим только об отзывах как об отдельном типе данных: тексте, оценке, дате, авторе, ответе компании. Мы не разбираем парсинг каталогов товаров, цен и остатков — это отдельная тема, у которой свои особенности. Если вам нужны цены, этот гайд не подойдёт, а если нужна обратная связь клиентов — вы по адресу.
Сколько времени потребуется. На подготовку окружения уйдёт около 30-40 минут. На проектирование структуры и первый сбор с одной площадки — примерно час. Полный проход по всем трём типам площадок с настройкой прокси и чисткой данных займёт 3-4 часа. Дальше сбор будет занимать минуты, потому что скрипт можно запускать повторно.
Предварительная подготовка: инструменты и доступы
Прежде чем собирать отзывы, нужно подготовить рабочее место. Ниже список того, что понадобится. Не пропускайте этот раздел, даже если что-то кажется очевидным: половина проблем на следующих шагах возникает именно из-за неподготовленного окружения.
Системные требования
- Компьютер на Windows 10/11, macOS или Linux. Подойдёт любой ноутбук последних 6-7 лет.
- Минимум 4 ГБ оперативной памяти. Для сбора десятков тысяч отзывов лучше 8 ГБ.
- Стабильный интернет. Сам сбор не требует высокой скорости, но обрывы соединения приводят к пропускам данных.
- Около 2 ГБ свободного места на диске под Python, библиотеки и результаты.
Что нужно установить
- Python 3.11 или новее. Скачайте установщик с официального сайта Python. При установке на Windows обязательно поставьте галочку «Add Python to PATH» на первом экране установщика. Без неё команда python не будет работать в терминале.
- Редактор кода. Подойдёт VS Code — бесплатный и понятный. После установки откройте его один раз, чтобы убедиться, что он запускается.
- Библиотеки Python. Откройте терминал (на Windows — PowerShell, на macOS — Terminal) и выполните команду:
pip install requests pandas openpyxl. Дождитесь сообщения Successfully installed. Это займёт 1-2 минуты. - Браузер Chrome или Яндекс Браузер. Нужен для изучения площадок через инструменты разработчика. Они встроены, отдельно ничего ставить не нужно.
- Табличный редактор. Excel, LibreOffice Calc или Google Таблицы — для просмотра результатов.
Какие доступы понадобятся
- Доступ к мобильным прокси. Зарегистрируйтесь на mobileproxy.space, выберите тариф с нужным гео (для российских площадок — российские операторы) и получите данные подключения: хост, порт, логин, пароль. Также в личном кабинете найдите ссылку для смены IP — она понадобится на шаге с ротацией.
- Доступ к личным кабинетам площадок, если вы собираете отзывы о собственном бизнесе. Это Яндекс Бизнес, кабинет продавца Wildberries, Ozon Seller, Яндекс Маркет для продавцов, Google Business Profile. Официальные выгрузки оттуда — самый чистый источник.
- Папка проекта. Создайте на диске папку, например reviews_project, и внутри неё две подпапки: raw для сырых данных и clean для обработанных. Это ваша страховка: сырые данные никогда не перезаписываются.
Совет: Сразу заведите в папке проекта текстовый файл sources.txt и записывайте туда каждый адрес, с которого собираете отзывы, вместе с датой. Через месяц вы не вспомните, откуда взялась та или иная таблица, а такой журнал снимет все вопросы.
Резервные копии
Резервное копирование здесь касается не системы, а данных. Возьмите за правило: каждый запуск парсера пишет результат в новый файл с датой в имени, например reviews_ozon_2026-03-14.csv. Старые файлы не удаляйте хотя бы месяц. Если новый сбор окажется битым из-за изменений на площадке, у вас останется рабочая версия.
Проверка: Введите в терминале python --version — должна отобразиться версия 3.11 или выше. Затем введите python -c 'import requests, pandas; print(1)' — должна появиться цифра 1 без ошибок. Если обе команды отработали, окружение готово.
Базовые понятия: как устроены отзывы и почему их собирают иначе, чем каталоги
Прежде чем что-то запускать, важно понять, с каким типом данных вы работаете. Отзыв — это не просто текст. Это структурированная запись с несколькими полями, и у неё есть особенности, которых нет у карточки товара.
Ключевые термины простым языком
- Отзыв (review) — запись, оставленная пользователем об объекте: товаре, магазине, заведении. Обычно содержит оценку, текст, дату, имя автора и иногда фотографии.
- Объект отзыва — то, о чём отзыв: карточка товара на маркетплейсе, организация на карте, компания на агрегаторе. У каждого объекта есть уникальный идентификатор на площадке.
- Ответ компании — реплика представителя бизнеса под отзывом. Для анализа качества поддержки это отдельное поле.
- Пагинация — разбивка отзывов на страницы или порции. Площадка отдаёт, например, по 20 отзывов за раз, и нужно запрашивать следующие порции.
- Парсер отзывов — программа, которая автоматически обходит нужные объекты, вытаскивает отзывы и складывает их в таблицу. Может быть простым скриптом или готовым сервисом.
- Дедупликация — удаление повторов. Один и тот же отзыв может попасть в выборку дважды из-за пагинации или повторных запусков.
- Мобильные прокси — промежуточные серверы с IP-адресами мобильных операторов. Запросы через них выглядят как трафик обычного пользователя со смартфона. Площадки лояльнее к такому трафику, потому что за одним мобильным IP стоят сотни реальных людей.
- Ротация IP — смена адреса прокси через заданный интервал или по запросу. Помогает распределить нагрузку и не создавать аномальный поток запросов с одного адреса.
Чем сбор отзывов отличается от сбора каталога
Каталог товаров относительно статичен: карточка есть, у неё есть цена и характеристики. Отзывы же живут по-другому, и это влияет на весь процесс.
- Отзывы постоянно добавляются. Нужно уметь докачивать только новые, а не переснимать всё каждый раз.
- Отзывы подгружаются отдельно. На большинстве площадок текст отзывов приходит не в самой странице, а отдельным запросом в фоне. Это хорошая новость: такие запросы отдают готовый JSON, разбирать HTML не нужно.
- Отзывы содержат персональные данные. Имя автора, аватар, иногда город. К этому есть требования закона — об этом ниже.
- Отзывы сортируются и фильтруются. По умолчанию площадка может показывать «полезные» или «новые». Если не зафиксировать сортировку, вы соберёте разные наборы при разных запусках.
- Отзывы редактируются и удаляются. Модерация снимает часть записей, авторы меняют оценки. Дата сбора становится важным полем.
Правовые рамки, которые нужно понимать
Внимание: Отзывы содержат имена и другие сведения о людях. При сборе и хранении соблюдайте требования Федерального закона 152-ФЗ о персональных данных: не собирайте больше, чем нужно для задачи, обезличивайте авторов там, где имя не требуется для анализа, не передавайте базу третьим лицам. Также прочитайте пользовательское соглашение площадки и файл robots.txt: некоторые сервисы прямо описывают допустимые режимы автоматического доступа. Если для вашей задачи есть официальный API или экспорт из личного кабинета — всегда начинайте с него.
Ещё один принцип — уважительная нагрузка. Ваш парсер отзывов должен вести себя как внимательный пользователь, а не как поток запросов. Паузы между запросами, разумное число потоков и ротация через мобильные прокси — не хитрость, а норма ответственного сбора. Площадки блокируют не сам факт автоматизации, а аномальное поведение, которое мешает их работе.
Шаг 1: Определяем цель и составляем список источников
Цель этапа: получить конкретный, ограниченный список объектов, с которых будем собирать отзывы, и понять, какие поля нам нужны. Без этого шага парсер превращается в бесконечный проект.
Сформулируйте вопрос, на который ответят отзывы
Хороший сбор начинается с вопроса. Примеры рабочих формулировок:
- «Почему у конкурента X на Wildberries рейтинг 4,8, а у нас 4,4 в той же категории?»
- «Что чаще всего ругают в отзывах о наших пяти кофейнях на Яндекс Картах за последние полгода?»
- «Какие боли клиентов упоминают в отзывах об онлайн-курсах на Отзовике, чтобы использовать их в креативах?»
Обратите внимание: в каждом вопросе есть площадка, объект, период и тип информации. Именно это и определяет настройки сбора.
Соберите список объектов
- Откройте площадку в браузере и найдите каждый нужный объект вручную: карточку товара, организацию на карте, страницу компании на агрегаторе.
- Скопируйте полный адрес страницы из адресной строки.
- Выделите из адреса идентификатор объекта. На Wildberries это число в адресе карточки после catalog/, на Ozon — число после product/ и дефиса в конце, на Яндекс Картах — длинное число после org/ и названия, в 2ГИС — число после firm/. Запишите его отдельно.
- Занесите всё в таблицу sources.csv с колонками: площадка, название объекта, адрес, идентификатор, комментарий.
- Для первого запуска ограничьтесь 3-5 объектами на площадку. Масштабировать будете потом.
Решите, какие поля нужны
Минимальный набор полей для любого отзыва: идентификатор отзыва на площадке, идентификатор объекта, площадка, оценка, текст, дата публикации, дата сбора. Расширенный набор: имя автора (или его хеш), наличие фото, достоинства и недостатки отдельно (есть на маркетплейсах и Отзовике), ответ компании и его дата, число лайков или отметок «полезно», вариант товара (размер, цвет), статус покупки подтверждённой.
Совет: Не гонитесь за всеми полями сразу. Собирайте минимальный набор плюс 2-3 поля, которые реально нужны для вашего вопроса. Каждое лишнее поле — это лишнее место, где разметка площадки может измениться и сломать скрипт.
Ожидаемый результат: файл sources.csv с 5-15 строками и записанный список полей. Каждая строка имеет заполненный идентификатор.
Возможные проблемы: не удаётся понять, где в адресе идентификатор. Решение: откройте два похожих объекта на одной площадке и сравните адреса — совпадающие части это шаблон, различающиеся — идентификатор.
Проверка: Вы можете прочитать любую строку sources.csv и по одному идентификатору вручную открыть нужный объект на площадке. Если для этого приходится гадать — вернитесь и уточните идентификаторы.
Шаг 2: Проектируем таблицу отзывов
Цель этапа: зафиксировать единый формат записи, в который будут приводиться отзывы со всех площадок. Это позволит анализировать их вместе, а не в пяти разных таблицах.
Единая схема
Создайте в редакторе кода файл schema.txt и перечислите колонки в таком порядке:
- review_id — идентификатор отзыва на площадке. Если площадка не отдаёт его явно, формируем сами из объекта, автора и даты.
- source — короткий код площадки: yandex_maps, 2gis, google_maps, wildberries, ozon, yandex_market, otzovik, irecommend, flamp, zoon.
- object_id — идентификатор объекта из sources.csv.
- object_name — читаемое название для удобства.
- rating — число от 1 до 5. Если площадка использует другую шкалу, приводим к пятибалльной и записываем это в комментарий.
- text — полный текст отзыва одной строкой. Переносы строк заменяем на пробел.
- pros и cons — достоинства и недостатки, если площадка разделяет. Иначе пусто.
- author — имя автора или его обезличенный хеш.
- published_at — дата публикации в формате ГГГГ-ММ-ДД.
- company_reply — текст ответа компании, если есть.
- likes — число отметок полезности.
- has_photo — 1 или 0.
- collected_at — дата и время сбора.
- url — адрес страницы объекта.
Почему нужен именно единый формат
Каждая площадка отдаёт данные в своём виде: где-то дата — это строка «3 дня назад», где-то — число миллисекунд, где-то — текст «14 марта». Если не привести всё к общему виду на входе, при анализе вы утонете в исключениях. Приводить к схеме нужно сразу при записи, а не потом.
Правила обезличивания
Если для задачи не нужны имена авторов (а в 90% аналитических задач они не нужны), храните вместо имени хеш. В Python это делается одной строкой через модуль hashlib: берётся имя автора, к нему добавляется код площадки, и результат превращается в короткую строку. Так вы сможете отличать отзывы одного автора друг от друга, но не будете хранить само имя.
Совет: Добавьте в схему колонку raw_json, куда будет записываться исходный ответ площадки по конкретному отзыву. Она занимает место, зато позволяет позже извлечь поле, о котором вы сегодня не подумали, без повторного сбора.
Ожидаемый результат: файл schema.txt с колонками и пустой шаблон таблицы reviews_template.csv с этими заголовками.
Проверка: Откройте reviews_template.csv в Excel. Вы должны увидеть одну строку заголовков, в которой ровно те колонки, что в schema.txt, и ни одной лишней.
Шаг 3: Используем официальные пути — кабинеты и API
Цель этапа: выгрузить отзывы о собственном бизнесе самым чистым способом, без парсинга вообще. Если вы анализируете только себя, этого шага может оказаться достаточно.
Яндекс Бизнес (отзывы на Яндекс Картах)
- Войдите в Яндекс Бизнес под аккаунтом владельца организации.
- В левом меню выберите раздел «Отзывы».
- Вверху выберите нужный филиал, если организаций несколько.
- Настройте фильтр по периоду и оценке.
- Список отзывов отображается с текстом, датой, оценкой и вашими ответами. Прямой кнопки экспорта в таблицу нет, поэтому для больших объёмов используйте копирование по страницам либо переходите к шагу 4.
Wildberries: API отзывов для продавцов
У Wildberries есть официальный раздел API для работы с отзывами и вопросами. Он доступен продавцам и отдаёт отзывы по вашим товарам с оценкой, текстом, достоинствами и недостатками, датой, а также позволяет отвечать на них.
- Войдите в кабинет продавца WB Партнёры.
- Откройте настройки профиля, раздел «Доступ к API».
- Создайте новый токен, отметив категорию доступа к отзывам и вопросам. Назовите его понятно, например reviews_export.
- Скопируйте токен сразу — повторно он не показывается. Сохраните в файле config.txt в папке проекта.
- Обращайтесь к методам списка отзывов с этим токеном в заголовке Authorization. Документация описывает параметры пагинации и фильтрации по датам.
Ozon Seller API и Яндекс Маркет
Ozon предоставляет доступ к отзывам через Seller API для продавцов с подпиской, которая включает работу с отзывами. Ключ создаётся в разделе «Настройки», подраздел «API-ключи». Яндекс Маркет отдаёт отзывы о товарах продавца через партнёрский API по идентификатору бизнеса, ключ выпускается в кабинете продавца в разделе настроек доступа.
Google Business Profile и 2ГИС для бизнеса
Отзывы о собственной организации на Google Maps доступны в кабинете Google Business Profile и через его API после подтверждения прав. 2ГИС предлагает владельцам кабинет с уведомлениями об отзывах и возможностью ответа.
Внимание: Токены и ключи API — это доступ к вашему бизнес-аккаунту. Никогда не вставляйте их в код напрямую, храните в отдельном файле, который не попадает в общие папки и репозитории. Если токен случайно утёк — немедленно отзовите его в кабинете и создайте новый.
Когда официальных путей не хватает
Все перечисленные способы дают отзывы только о ваших объектах. Для анализа конкурентов, рынка или чужих товаров они не подходят. В этом случае переходим к сбору с публичных страниц — этому посвящены следующие шаги.
Ожидаемый результат: если вы работаете со своим бизнесом — первая таблица отзывов из официального источника, приведённая к схеме из шага 2.
Проверка: Количество отзывов в выгрузке совпадает с числом, которое показывает кабинет за тот же период, с погрешностью в 1-2 записи на отзывы, которые в момент выгрузки проходили модерацию.
Шаг 4: Собираем отзывы с карт — Яндекс Карты, 2ГИС, Google Maps
Цель этапа: научиться находить фоновый запрос, которым карта подгружает отзывы, и воспроизводить его скриптом. Этот навык универсален и пригодится на всех остальных площадках.
Как найти запрос с отзывами через инструменты разработчика
- Откройте в Chrome страницу организации на Яндекс Картах или 2ГИС.
- Нажмите клавишу F12. Справа или снизу откроется панель разработчика.
- Перейдите на вкладку Network (Сеть). Если она пустая — обновите страницу клавишей F5.
- В строке фильтра над списком запросов нажмите кнопку Fetch/XHR. Останутся только фоновые запросы за данными.
- На странице организации перейдите в раздел отзывов и прокрутите список вниз, чтобы подгрузилась следующая порция.
- В списке запросов появится новый. В его имени обычно встречается слово review или feedback. Кликните на него.
- Откройте вкладку Preview или Response. Вы увидите структуру JSON, где вложенным списком идут отзывы: текст, оценка, дата, автор.
- Откройте вкладку Headers. Скопируйте полный адрес запроса (Request URL) и обратите внимание на параметры: обычно там есть идентификатор объекта, номер страницы или смещение, размер порции и сортировка.
- Найдите в этом же разделе заголовки запроса: User-Agent, Accept, Referer. Их нужно будет передать из скрипта.
Совет: Кликните правой кнопкой по найденному запросу и выберите Copy, затем Copy as cURL. Получится команда со всеми заголовками. Её удобно вставить в текстовый файл как эталон: если скрипт вдруг перестанет работать, вы сравните его запрос с эталонным.
Особенности каждой карты
- Яндекс Карты. Отзывы подгружаются порциями с указанием сортировки (по новизне, по оценке, по релевантности). Обязательно фиксируйте одну сортировку, иначе при разных запусках наборы разойдутся. Дата приходит в машиночитаемом виде, оценка — числом. Ответы организации лежат отдельным вложенным полем.
- 2ГИС. У сервиса есть публичный сервис отзывов, к которому обращается сам сайт. Запрос содержит идентификатор филиала и параметры лимита и смещения. В ответе есть текст, оценка, дата, имя пользователя, официальный ответ и счётчик полезности. Также приходит общее количество отзывов — используйте его для проверки полноты.
- Google Maps. Самая сложная из трёх площадок: отзывы приходят в упакованном формате внутри длинных ответов. Для нескольких десятков объектов проще использовать Places API с официальным ключом — он отдаёт ограниченный набор последних отзывов по каждому месту, чего часто достаточно для оценки тональности. Для полного сбора по чужим объектам потребуется браузерная автоматизация — это тема продвинутого блока.
Пишем первый скрипт
Создайте файл collect_maps.py и вставьте каркас. Адрес запроса и имена полей подставьте из того, что увидели в панели разработчика — они отличаются между площадками и могут меняться со временем.
import requests, time, csv, datetime
PROXY = 'http://LOGIN:PASSWORD@HOST:PORT'
proxies = {'http': PROXY, 'https': PROXY}
headers = {'User-Agent': 'Mozilla/5.0 (Linux; Android 13) AppleWebKit/537.36 Chrome/122 Mobile Safari/537.36', 'Accept': 'application/json'}
def fetch_page(url):
    r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
    r.raise_for_status()
    return r.json()
def collect(object_id, base_url, limit=20):
    offset = 0
    rows = []
    while True:
        url = base_url.format(oid=object_id, limit=limit, offset=offset)
        data = fetch_page(url)
        items = data.get('reviews', [])
        if not items:
            break
        for it in items:
            rows.append({'review_id': it.get('id'), 'object_id': object_id, 'rating': it.get('rating'), 'text': (it.get('text') or '').replace(chr(10), ' '), 'published_at': it.get('date_created'), 'collected_at': datetime.datetime.now().isoformat()})
        offset += limit
        time.sleep(2.5)
    return rows
Разберём, что здесь происходит. Переменная PROXY хранит данные вашего мобильного прокси. Заголовок User-Agent представляет запрос как мобильный браузер — это логично сочетается с мобильным IP. Функция collect ходит по страницам, пока площадка не вернёт пустой список, и после каждой страницы делает паузу 2,5 секунды. Пауза — не формальность: она делает нагрузку похожей на чтение живым человеком.
Запуск и запись результата
- В конце файла добавьте вызов функции для одного объекта из sources.csv и запись строк в CSV через модуль csv с кодировкой utf-8-sig, чтобы Excel корректно открыл русский текст.
- Откройте терминал в папке проекта и выполните
python collect_maps.py. - Наблюдайте за выводом. Полезно печатать номер страницы и число собранных строк после каждого запроса.
- Откройте полученный файл в Excel и просмотрите первые 20 строк.
Ожидаемый результат: CSV-файл с отзывами одной организации, где число строк примерно равно счётчику отзывов на странице организации.
Возможные проблемы: ответ приходит с кодом 403 или пустой. Решение: сверьте заголовки со скопированной cURL-командой, особенно Referer и Accept. Проверьте, что прокси подключён и ответил на тестовый запрос к любому сайту. Увеличьте паузу до 4-5 секунд.
Проверка: Возьмите три случайных отзыва из файла и найдите их на странице организации по тексту. Все три должны найтись, с теми же оценками и датами.
Шаг 5: Собираем отзывы с маркетплейсов — Wildberries, Ozon, Яндекс Маркет
Цель этапа: адаптировать подход из шага 4 под маркетплейсы, у которых отзывы привязаны к товарам и имеют дополнительные поля: достоинства, недостатки, вариант товара, фото.
Wildberries
На Wildberries отзывы привязаны не к артикулу, а к объединяющему идентификатору карточки, под которым сгруппированы цвета и размеры. Это важно: если вы соберёте отзывы по артикулу, получите их для всех вариантов сразу, и нужно будет фильтровать по полю варианта.
- Откройте карточку товара, нажмите F12, перейдите на вкладку Network с фильтром Fetch/XHR.
- Прокрутите до блока отзывов и нажмите «Смотреть все отзывы».
- Найдите запрос, в имени которого есть feedbacks. В ответе будет список с текстом, оценкой, датой, полями достоинств и недостатков, именем автора, цветом и размером, признаком наличия фото и ответом продавца.
- Обратите внимание на общее число отзывов в ответе — оно поможет проверить полноту.
- Скопируйте адрес и заголовки, подставьте в скрипт по образцу из шага 4. Пагинация здесь может отсутствовать — часть ответов приходит целиком, иногда очень крупным файлом. Увеличьте таймаут до 60 секунд.
Ozon
Ozon активно защищает данные и проверяет поведение клиента. Для отзывов сайт использует внутренний запрос за составом страницы, в котором отзывы — один из блоков. Практический порядок действий:
- Откройте страницу товара, затем перейдите в раздел отзывов по ссылке из карточки.
- В панели разработчика найдите запрос, в ответе которого содержится массив с полями content, score или rating и author. Он может называться по-разному, ищите по содержимому через строку поиска панели (сочетание Ctrl+F внутри вкладки Network).
- Скопируйте запрос как cURL. Обратите внимание на заголовки и куки: Ozon чувствителен к их отсутствию.
- При воспроизведении из скрипта используйте сессию requests.Session, чтобы куки сохранялись между запросами, и делайте первый запрос на обычную страницу товара, а уже потом — за отзывами. Это имитирует естественный путь пользователя.
- Держите паузы 4-6 секунд и меняйте IP через мобильный прокси каждые 30-50 запросов.
Внимание: Если площадка начала отдавать страницу проверки браузера или капчу — это сигнал остановиться, а не давить дальше. Уменьшите частоту, смените IP через ссылку ротации и подождите 10-15 минут. Систематическое давление на защитные механизмы приводит к блокировке всего пула адресов и противоречит правилам площадок.
Яндекс Маркет
Отзывы на Яндекс Маркете бывают двух типов: о товаре (общие для всех продавцов) и о магазине. Для анализа продукта нужны первые, для анализа сервиса — вторые. У обоих типов есть разделение на достоинства, недостатки и комментарий, а также оценка и дата. Запрос за отзывами находится тем же способом через панель разработчика на вкладке «Отзывы» карточки товара.
Приведение к схеме
На маркетплейсах поле текста часто состоит из трёх частей. Записывайте их так: pros — в колонку pros, cons — в колонку cons, а общий комментарий — в text. Если для анализа нужен один сплошной текст, на этапе чистки объедините три колонки через разделитель, но в сырых данных храните раздельно.
Совет: На маркетплейсах отзывы с фото и подтверждённой покупкой заметно информативнее. Добавьте фильтр в скрипт: сначала собирайте всё, а при анализе смотрите отдельно срез с has_photo равным 1. Часто именно там самые подробные описания дефектов и реальных сценариев использования.
Ожидаемый результат: по одному CSV на каждый маркетплейс с отзывами по 3-5 товарам, приведёнными к единой схеме.
Возможные проблемы: число собранных отзывов меньше счётчика на странице. Причина: площадка ограничивает глубину выдачи или отдаёт отзывы только с текстом, скрывая оценки без комментария. Решение: сравните счётчи��и «всего оценок» и «с текстом» на странице — обычно расхождение объясняется именно этим.
Проверка: Откройте файл в Excel, постройте сводную таблицу по колонке rating. Распределение оценок должно примерно соответствовать тому, что показывает карточка товара: если на площадке 70% пятёрок, в вашей выборке должно быть близкое значение.
Шаг 6: Собираем отзывы с агрегаторов — Отзовик, iRecommend, Flamp, Zoon
Цель этапа: научиться работать с площадками, где отзывы — это самостоятельные статьи с HTML-разметкой, а не JSON в фоне.
Чем агрегаторы отличаются
Отзовик и iRecommend строят страницы классическим способом: каждый отзыв — отдельная страница с заголовком, длинным текстом, оценкой, датой, достоинствами и недостатками, а на странице объекта лежит список ссылок на эти отзывы с краткими превью. Flamp и Zoon ближе к картам: организация, список отзывов, подгрузка порциями. Соответственно, для первых двух нужен разбор HTML, для вторых подходит метод из шага 4.
Установка библиотеки для разбора HTML
Выполните в терминале pip install beautifulsoup4 lxml. Библиотека BeautifulSoup позволяет находить элементы страницы по тегам и классам, как вы находите их глазами в панели разработчика.
Пошаговый сбор с Отзовика
- Откройте страницу объекта (товара, компании, курса) на Отзовике.
- Нажмите F12 и перейдите на вкладку Elements (Элементы).
- Нажмите значок стрелки в левом верхнем углу панели и кликните на заголовок первого отзыва в списке. В панели подсветится HTML-элемент. Запишите его тег и класс — это селектор ссылки на отзыв.
- Тем же способом найдите элементы оценки (обычно блок со звёздами и числовым атрибутом), даты и краткого текста.
- Прокрутите страницу вниз и найдите блок пагинации. Кликните на цифру 2 и посмотрите, как изменился адрес — обычно добавляется номер страницы. Это шаблон для обхода.
- В скрипте: загружайте страницу списка через requests с прокси, разбирайте через BeautifulSoup, вытаскивайте ссылки на отзывы и превью, затем переходите на следующую страницу списка. Пауза между страницами — 5-8 секунд, агрегаторы чувствительнее карт.
- Если нужен полный текст отзыва, а не превью, делайте второй проход: по каждой ссылке загружайте страницу отзыва и извлекайте основной текст, блоки достоинств и недостатков, оценку по подкритериям.
iRecommend
Логика аналогична Отзовику: страница объекта со списком отзывов и отдельные страницы отзывов. Отличие в разметке и в том, что оценка выражена количеством закрашенных звёзд — считайте элементы звёзд с активным классом, а не ищите число.
Flamp и Zoon
Для этих площадок используйте метод из шага 4: откройте организацию, переключитесь на Fetch/XHR, прокрутите отзывы и найдите фоновый запрос. Flamp отдаёт отзывы с оценкой, текстом, датой, официальным ответом и полезностью. Zoon — с оценкой, текстом, датой и ответом организации. Обе площадки показывают общее число отзывов для контроля полноты.
Мини-пример разбора HTML
from bs4 import BeautifulSoup
html = requests.get(page_url, headers=headers, proxies=proxies, timeout=30).text
soup = BeautifulSoup(html, 'lxml')
for card in soup.select('div.review-card'):
    title_el = card.select_one('a.review-title')
    rating_el = card.select_one('div.rating')
    date_el = card.select_one('span.review-date')
    row = {'text': title_el.get_text(strip=True) if title_el else '', 'rating': rating_el.get('data-value') if rating_el else '', 'published_at': date_el.get_text(strip=True) if date_el else '', 'url': title_el.get('href') if title_el else ''}
Имена классов здесь условные — подставьте реальные, которые увидели в панели Elements. Проверки на пустоту элемента обязательны: если разметка одного отзыва отличается, скрипт не должен падать целиком.
Совет: На агрегаторах даты часто написаны словами: «вчера», «3 дня назад», «14 марта». Заведите отдельную функцию нормализации дат, которая переводит такие строки в формат ГГГГ-ММ-ДД относительно даты сбора. Без неё сортировка по времени не будет работать.
Ожидаемый результат: CSV с отзывами с одного-двух агрегаторов, где для каждого отзыва есть оценка, дата и текст, а для Отзовика и iRecommend — ещё и ссылка на полную страницу.
Возможные проблемы: селекторы перестали находить элементы после нескольких страниц. Причина: площадка отдала страницу проверки вместо списка. Решение: проверяйте заголовок страницы после каждой загрузки, при появлении признаков проверки — пауза, смена IP, повтор через несколько минут.
Проверка: Число собранных отзывов с одной страницы списка равно числу отзывов, которые вы видите на этой странице в браузере. Если собралось меньше — один из селекторов слишком узкий.
Шаг 7: Подключаем мобильные прокси и настраиваем ротацию
Цель этапа: сделать так, чтобы парсер отзывов работал стабильно на десятках и сотнях объектов, распределяя нагрузку и не создавая аномального потока с одного адреса.
Почему именно мобильные прокси
Все площадки из этого гайда ориентированы на моб��льную аудиторию: большинство отзывов пишут и читают со смартфонов. Мобильные IP-адреса операторов связи — это адреса, за которыми одновременно находятся сотни и тысячи реальных абонентов. Площадки не могут блокировать такие адреса без ущерба для настоящих пользователей, поэтому относятся к ним лояльно. Для сбора отзывов это означает меньше проверок, меньше ложных срабатываний защиты и предсказуемую скорость.
Настройка подключения
- Войдите в личный кабинет mobileproxy.space и откройте список ваших прокси.
- Скопируйте хост, порт, логин и пароль. Обратите внимание на протокол: для requests удобнее HTTP-прокси, но SOCKS5 тоже поддерживается при установке дополнения
pip install requests[socks]. - Вставьте данные в переменную PROXY в скрипте. Формат: протокол, двоеточие, два слэша, логин, двоеточие, пароль, собака, хост, двоеточие, порт.
- Скопируйте из кабинета ссылку для смены IP и сохраните в переменную ROTATE_URL.
- Выполните тестовый запрос через прокси к любому сервису, показывающему ваш IP. В ответе должен быть адрес мобильного оператора, а не вашего домашнего провайдера.
Стратегия ротации
Есть два подхода, и оба рабочие.
- Ротация по времени. В кабинете задаётся интервал автоматической смены IP, например каждые 5 минут. Скрипт ничего не делает — адрес меняется сам. Подходит для длинных спокойных сборов.
- Ротация по событию. Скрипт сам дёргает ROTATE_URL в нужный момент: после каждых N запросов, при переходе к новому объекту или при получении кода 429/403. Подходит, когда нужен контроль.
Практическое правило для отзывов: меняйте IP при переходе к каждому новому объекту и дополнительно после 40-60 запросов внутри одного объекта. После смены IP делайте паузу 5-10 секунд — оператору нужно время, чтобы новый адрес стал активен.
Обработка ошибок и повторы
Добавьте в функцию fetch_page обёртку: при кодах 429, 403, 5xx или таймауте — вызвать ротацию, подождать, повторить запрос до трёх раз с увеличивающейся паузой (10, 30, 90 секунд). Если три попытки не помогли — записать объект в файл failed.txt и перейти к следующему. Так один проблемный объект не остановит весь сбор, а вы потом переснимете пропуски отдельно.
def fetch_with_retry(url, attempts=3):
    delay = 10
    for i in range(attempts):
        try:
            r = requests.get(url, headers=headers, proxies=proxies, timeout=30)
            if r.status_code == 200:
                return r.json()
        except requests.RequestException:
            pass
        requests.get(ROTATE_URL, timeout=15)
        time.sleep(delay)
        delay *= 3
    return None
Сколько потоков использовать
Для начинающих — один поток. Один прокси, одно соединение, последовательный обход. Это медленно, но надёжно: 500-1000 отзывов в час без единой проблемы. Когда убедитесь, что всё стабильно, можно добавить второй прокси и запустить второй экземпляр скрипта на другой половине списка объектов. Больше 3-4 потоков на площадку для отзывов почти никогда не нужно.
Совет: Согласуйте User-Agent с типом IP. Если идёте через мобильный прокси, представляйтесь мобильным браузером, как в примере из шага 4. Несоответствие «мобильный IP, но десктопный Chrome на Windows» само по себе не критично, но согласованность снижает число дополнительных проверок.
Ожидаемый результат: скрипт, который проходит весь sources.csv по одной площадке без ручного вмешательства, меняет IP при переходе между объектами и записывает проблемные объекты в failed.txt.
Возможные проблемы: после смены IP первые запросы падают с таймаутом. Решение: увеличьте паузу после ротации до 15 секунд. Прокси не подключается вовсе — проверьте, не включён ли в кабинете белый список IP, и добавьте туда адрес вашего компьютера.
Проверка: Запустите сбор по 10 объектам подряд. В логе должны быть записи о смене IP между объектами, файл failed.txt пуст или содержит не более одного объекта, а общее число строк в результате сопоставимо с суммой счётчиков отзывов на площадке.
Шаг 8: Сохраняем, чистим и дедуплицируем
Цель этапа: превратить набор сырых CSV с разных площадок в единую чистую таблицу, пригодную для анализа.
Объединение файлов
- Убедитесь, что все сырые файлы лежат в папке raw и имеют одинаковые заголовки согласно schema.txt.
- Создайте файл merge.py. Через pandas прочитайте все CSV из папки raw в один DataFrame: функция pandas.concat объединяет список таблиц.
- Проверьте типы: rating должен быть числом, published_at — датой. Приведите через pandas.to_numeric и pandas.to_datetime с параметром errors='coerce', чтобы некорректные значения стали пустыми, а не сломали обработку.
Дедупликация
Повторы возникают по трём причинам: перекрытие страниц при пагинации, повторные запуски и один и тот же отзыв, размещённый автором на нескольких площадках. Обрабатывайте по порядку:
- Удалите точные дубли по паре source и review_id — это повторы от пагинации и перезапусков. Метод drop_duplicates с параметром subset.
- Найдите нечёткие дубли внутри одной площадки: одинаковый object_id, одинаковая дата и первые 100 символов текста. Такое бывает, когда площадка меняет идентификатор при редактировании отзыва.
- Кросс-площадочные дубли не удаляйте, а помечайте отдельной колонкой. Тот факт, что человек написал одно и то же на Отзовике и в Яндекс Картах, сам по себе информативен.
Чистка текста
- Уберите двойные пробелы и переносы строк внутри текста.
- Удалите служебные фразы площадок, которые попадают в текст: «Читать полностью», «Показать ещё».
- Замените пустые строки в pros и cons на явное пустое значение, а не на строку «нет» или «-».
- Проверьте кодировку: если видите кракозябры, файл был сохранён не в utf-8. Пересохраните из сырого источника.
Выгрузка результата
Сохраните итоговую таблицу в папку clean под именем reviews_all_ГГГГ-ММ-ДД.xlsx через метод to_excel и параллельно в CSV. Excel удобен для просмотра, CSV — для загрузки в другие системы. Дополнительно сохраните отдельный файл со сводкой: число отзывов по площадкам, средняя оценка по объектам, доля отзывов с ответом компании.
Совет: Добавьте в чистую таблицу колонку text_len с длиной текста. Отзывы короче 30 символов почти всегда бесполезны для анализа причин, зато длинные отзывы с оценкой 2-3 — золото: в них люди подробно объясняют, что именно не так.
Ожидаемый результат: один чистый файл с отзывами со всех площадок, без точных дублей, с корректными типами данных и сводкой.
Возможные проблемы: после дедупликации пропало слишком много строк. Причина: review_id на какой-то площадке оказался пустым для всех записей, и все они посчитались дублями. Решение: проверьте заполненность review_id по площадкам и для проблемной площадки сформируйте идентификатор из object_id, даты и хеша текста.
Проверка: Число строк в чистом файле не более чем на 5-10% меньше суммы строк сырых файлов. В колонке rating нет значений вне диапазона 1-5, в колонке published_at нет дат из будущего.
Проверка результата: чек-лист и тестирование
Прежде чем строить на собранных отзывах выводы, убедитесь, что сбор прошёл корректно. Пройдите чек-лист полностью.
Чек-лист готовности
- Для каждого объекта из sources.csv в чистой таблице есть хотя бы один отзыв, либо объект записан в failed.txt с причиной.
- Число отзывов по каждому объекту отличается от счётчика на площадке не более чем на 10%.
- Распределение оценок по объекту примерно совпадает с распределением, которое показывает площадка.
- Самый свежий отзыв в таблице датирован не позже вчерашнего дня относительно даты сбора, если объект активен.
- Все даты в формате ГГГГ-ММ-ДД, все оценки — числа.
- Точных дублей по source и review_id нет.
- Имена авторов либо отсутствуют, либо заменены хешами, если задача не требует имён.
- Файлы сырых данных сохранены с датой и не перезаписаны.
- Токены и данные прокси не лежат внутри скрипта, а вынесены в отдельный файл конфигурации.
Как протестировать выборочно
- Выберите случайные 10 отзывов из таблицы функцией sample в pandas.
- Для каждого откройте страницу объекта на площадке и найдите отзыв по фрагменту текста.
- Сверьте оценку, дату и наличие ответа компании.
- Если совпало 10 из 10 — отлично. Если 8-9 — проверьте, не связаны ли расхождения с редактированием отзыва после сбора. Если меньше 8 — есть системная ошибка в разборе, вернитесь к соответствующему шагу.
Показатели успешного выполнения
Успех выглядит так: вы можете открыть одну таблицу, отфильтровать её по любой площадке и объекту, отсортировать по дате и оценке и за пять минут ответить на исходный вопрос из шага 1. Например, увидеть, что 40% отзывов с оценкой 1-2 о кофейне на Яндекс Картах за последние три месяца упоминают время ожидания, а на 2ГИС те же люди хвалят кофе, но ругают персонал. Если вопрос п��лучает ответ — сбор выполнил свою задачу.
Типичные ошибки и решения
Ниже собраны проблемы, с которыми сталкивается почти каждый, кто настраивает парсер отзывов впервые. Формат: проблема, причина, решение.
1. Скрипт собрал только первые 20 отзывов
Причина: не реализована пагинация или неверно определён параметр смещения.
Решение: вернитесь в панель разработчика, прокрутите список отзывов дважды и сравните адреса двух последовательных запросов. Параметр, который изменился, и есть смещение или номер страницы. Убедитесь, что скрипт увеличивает его на правильный шаг.
2. Все отзывы приходят с одной датой — датой сбора
Причина: в поле published_at записывается collected_at, либо площадка отдаёт дату в поле с другим именем.
Решение: откройте raw_json одного отзыва и найдите поле с датой публикации. Оно может называться date, created, published, time, updatedAt. Исправьте имя поля в скрипте.
3. Русский текст в Excel отображается неправильно
Причина: CSV сохранён в utf-8 без метки порядка байтов, Excel открывает его в другой кодировке.
Решение: сохраняйте с кодировкой utf-8-sig либо выгружайте сразу в xlsx через to_excel.
4. Площадка отвечает кодом 403 на каждый запрос
Причина: не переданы обязательные заголовки, не установлены куки сессии или запрос идёт слишком часто.
Решение: сравните с эталонной cURL-командой. Используйте requests.Session и сначала загрузите обычную страницу объекта. Увеличьте паузы до 5 секунд. Смените IP через прокси и подождите 10 минут перед повтором.
5. Собранные оценки не совпадают с реальными
Причина: площадка хранит оценку в другой шкале (например, от 0 до 100 или от 1 до 10) или в отдельном поле хранится оценка по подкритерию, а не общая.
Решение: сверьте три отзыва вручную. Определите шкалу и приведите к пятибалльной делением с округлением. Задокументируйте это в schema.txt.
6. Число отзывов при каждом запуске разное
Причина: не зафиксирована сортировка, и площадка отдаёт разные наборы в режиме «по релевантности».
Решение: найдите параметр сортировки в адресе запроса и жёстко задайте сортировку по дате. Собирайте до тех пор, пока не встретите отзыв старше нужного периода.
7. Скрипт падает на одном объекте и не идёт дальше
Причина: отсутствует обработка исключений, любая ошибка останавливает программу.
Решение: оберните обработку каждого объекта в try-except, записывайте ошибку и идентификатор объекта в failed.txt и переходите к следующему. Пропуски дособерёте отдельным запуском.
8. После недели работы скрипт внезапно перестал что-либо находить
Причина: площадка изменила адрес запроса, структуру JSON или имена классов в HTML.
Решение: это нормальная часть жизни любого парсера. Повторите процедуру поиска запроса из шага 4 и обновите адрес и имена полей. Держите список селекторов и полей в отдельном файле конфигурации, чтобы править одно место, а не весь код.
9. Прокси работает, но скорость очень низкая
Причина: слишком крупные ответы (маркетплейсы иногда отдают тысячи отзывов одним файлом) или нагрузка на базовую станцию оператора в час пик.
Решение: увеличьте таймаут, включите сжатие через заголовок Accept-Encoding, запланируйте объёмные сборы на ночное время.
Дополнительные возможности для продвинутых
Если базовый сценарий освоен, вот куда можно расти. Этот блок предполагает, что вы уверенно пишете на Python.
Инкрементальный сбор
Вместо полного пересбора храните для каждого объекта дату самого свежего собранного отзыва. При следующем запуске собирайте с сортировкой по дате и останавливайтесь, как только встретили отзыв не новее сохранённой даты. Так ежедневное обновление по 500 объектам занимает минуты вместо часов, а нагрузка на площадки падает в десятки раз. Учтите, что отзывы могут появляться задним числом после модерации — делайте перекрытие в 2-3 дня.
Браузерная автоматизация для сложных площадок
Google Maps и часть разделов Ozon проще собирать через управляемый браузер: Playwright с подключённым мобильным прокси открывает страницу, прокручивает список отзывов и перехватывает фоновые ответы через обработчик событий response. Вы получаете тот же JSON, что и в панели разработчика, но без необходимости воспроизводить заголовки и куки вручную. Playwright поддерживает эмуляцию мобильных устройств, что отлично сочетается с мобильным IP. Цена — скорость и потребление памяти: один браузер съедает 300-500 МБ, поэтому запускайте не больше 2-3 экземпляров.
Хранение в базе данных
Когда отзывов больше 100 тысяч, CSV становится неудобным. Переходите на SQLite (встроен в Python, файл на диске, ноль настройки) или PostgreSQL. Таблица reviews с уникальным индексом по паре source и review_id автоматически защищает от дублей: вставка через INSERT с обработкой конфликта ON CONFLICT DO NOTHING отбрасывает повторы на уровне базы.
Обогащение и анализ
- Тональность и темы. Прогоните тексты через языковую модель с промптом вида «выдели 3 основные темы и общую тональность». Результат кладите в отдельные колонки. Для десятков тысяч отзывов используйте пакетную обработку и кеш, чтобы не платить дважды за один текст.
- Динамика оценок. Постройте средний рейтинг по неделям для каждого объекта. Резкое падение — сигнал о проблеме, которую отзывы объяснят словами.
- Скорость реакции компании. Разница между published_at и датой ответа компании — прямой показатель качества поддержки, свой и конкурентов.
- Словарь болей для рекламы. Частотный анализ существительных и прилагательных в отзывах с оценкой 1-2 даёт готовый список формулировок для креативов и посадочных страниц.
Мониторинг здоровья парсера
Настройте ежедневный запуск через планировщик задач Windows или cron и добавьте простую проверку: если за сутки собрано меньше 30% от среднего за неделю или доля ошибок превысила 10% — отправьте уведомление в Telegram через бота. Так вы узнаете о смене разметки на площадке в тот же день, а не через месяц, когда данные понадобятся.
Управление пулом прокси
При работе с несколькими площадками одновременно закрепите за каждой отдельный мобильный прокси. Так поведение на одной площадке не влияет на репутацию адреса на другой. Ротацию для карт делайте реже (объекты обычно небольшие, 50-200 отзывов), для маркетплейсов — чаще (тысячи отзывов на карточку). Ведите журнал: время, площадка, IP, код ответа. Через неделю по этому журналу будет видно, какие интервалы ротации оптимальны для вашего профиля нагрузки.
FAQ: частые вопросы по сбору отзывов
Законно ли собирать отзывы с публичных страниц?
Сбор общедоступной информации для собственного анализа сам по себе не запрещён, но есть ограничения: пользовательские соглашения площадок, требования 152-ФЗ к обработке персональных данных, запрет на создание помех работе сервиса. Соблюдайте паузы, обезличивайте авторов, не публикуйте собранные базы и используйте официальные API везде, где они есть. При коммерческом использовании данных проконсультируйтесь с юристом.
Можно ли обойтись без программирования?
Частично. Для собственных объектов достаточно личных кабинетов. Для небольших разовых задач подойдут браузерные расширения-парсеры, которые выгружают видимые на странице элементы в таблицу: вы вручную прокручиваете отзывы, расширение собирает. Для регулярного сбора по десяткам объектов скрипт всё же удобнее и надёжнее, а готовые фрагменты из этого гайда можно использовать почти без изменений.
Зачем мобильные прокси, если у меня всего 10 объектов?
Для 10 объектов и разового сбора можно попробовать и без них. Но как только вы начнёте обновлять данные регулярно или расширите список, запросы с одного домашнего IP начнут получать дополнительные проверки. Мобильный прокси решает это заранее, а стоимость несопоставима с временем, которое уходит на разбор блокировок.
Сколько отзывов в час реально собирать?
В один поток с паузами 2-5 секунд — от 500 до 1500 отзывов в час в зависимости от размера порции на площадке. Маркетплейсы, отдающие сотни отзывов одним ответом, дают больше, агрегаторы с постраничным HTML — меньше. Для большинства аналитических задач этого более чем достаточно.
Как собирать только новые отзывы, а не всё заново?
Сохраняйте дату последнего собранного отзыва по каждому объекту, сортируйте по дате при запросе и останавливайтесь на первом уже известном отзыве. Подробнее — в блоке про инкрементальный сбор.
Отзывы без текста, только с оценкой — собирать или нет?
Зависит от задачи. Для расчёта среднего рейтинга и динамики — да, они влияют на цифры. Для анализа причин — нет, их можно отфильтровать при обработке. Собирайте всё, а фильтруйте на этапе анализа: пересобирать дороже.
Что делать, если площадка показывает капчу?
Остановить сбор на 10-15 минут, сменить IP через прокси, снизить частоту запросов и проверить заголовки. Капча — это сигнал, что ваше поведение выглядит нетипично. Задача — сделать его типичным, а не пробиваться через проверку.
Как хранить имена авторов, чтобы не нарушить закон?
Лучше всего не хранить вовсе. Если нужно отличать отзывы одного автора, используйте односторонний хеш от имени. Если имена необходимы (например, для ответа клиенту через личный кабинет), храните их только в рамках работы с собственной организацией и не передавайте третьим лицам.
Как часто ломаются парсеры отзывов?
Крупные площадки меняют внутренние запросы и разметку несколько раз в год. При хорошем мониторинге починка занимает 20-40 минут: повторить поиск запроса и обновить поля. Держите селекторы и адреса в конфигурационном файле, и правки будут точечными.
Можно ли одним скриптом собирать со всех площадок?
Да, если сделать общий каркас (прокси, повторы, запись в схему) и для каждой площадки отдельную функцию-адаптер, которая знает адрес запроса и имена полей. Именно так устроены зрелые проекты: один общий модуль и десяток маленьких адаптеров.
Заключение
Давайте подведём итог. Вы прошли путь от постановки вопроса до чистой таблицы отзывов с трёх разных типов площадок. Вы научились находить фоновые запросы через панель разработчика, воспроизводить их скриптом, разбирать HTML там, где JSON недоступен, подключать мобильные прокси с ротацией, обрабатывать ошибки и повторять запросы, объединять и очищать данные. Отдельно вы разобрались с официальными путями выгрузки и правовыми рамками, что защищает и данные, и вас.
Главное, что стоит вынести: отзывы — это особый тип данных со своей динамикой. Они появляются постоянно, редактируются, проходят модерацию и несут персональную информацию. Поэтому парсер отзывов — это не разовый скрипт, а небольшая система: сбор, хранение сырых данных, приведение к схеме, дедупликация, мониторинг. Каждый элемент этой системы вы уже построили в базовом виде.
Что делать дальше:
- Расширьте sources.csv до реального списка объектов и проведите полный сбор.
- Настройте ежедневный инкрементальный запуск по планировщику.
- Добавьте хотя бы одну аналитическую надстройку: динамику рейтинга или тематизацию негативных отзывов.
- Заведите журнал изменений площадок и обновляйте адаптеры по мере поломок.
Куда развиваться. Следующий уровень — автоматизация реакции: уведомления команде о негативном отзыве в течение часа после публикации, сравнительные отчёты по конкурентам раз в неделю, интеграция тем из отзывов в план продукта и рекламные гипотезы. Данные у вас уже есть. Осталось превратить их в решения, и здесь начинается самая интересная часть работы.
