Bot-Schutz für Websites: Was installieren und wie implementieren, wenn Sie gescraped werden
Inhalt des Artikels
- Einleitung: wenn ihre website zur datenbank eines anderen wird
- Grundlagen: was ist bot-schutz und vor wem schützt er
- Tiefeneinblick: wie ein modernes bot-schutzsystem einen besucher "sieht"
- Methode 1. diagnose: wir finden heraus, wer sie wie scrapt
- Methode 2. erste linie: server- und netzwerkebene
- Methode 3. zweite linie: client-prüfung und challenges
- Methode 4. dritte linie: verhalten, fallen und schutz der daten selbst
- Typische fehler bei der implementierung von bot-schutz
- Werkzeuge und ressourcen für die umsetzung
- Fallstudien: wie das in realen projekten funktioniert
- Faq: antworten auf schwierige fragen
- Fazit: schutz als prozess, nicht als einkauf
Einleitung: Wenn Ihre Website zur Datenbank eines anderen wird
Stellen Sie sich vor: Sie haben ein halbes Jahr an einem Katalog gearbeitet, Preise abgeglichen, Produkttexte geschrieben, Filter eingerichtet. Und dann bemerken Sie, dass ein Wettbewerber seine Preise zwanzig Minuten nach Ihnen aktualisiert, und in den Suchergebnissen tauchen Klon-Websites mit Ihren Beschreibungen Wort für Wort auf. Der Server ächzt unter der Last, die Hosting-Rechnung steigt, und die Analytics zeigen seltsame Traffic-Spitzen nachts aus Regionen, in denen Sie keinen einzigen Kunden haben. Kommt Ihnen das bekannt vor? Das ist Scraping. Und es ist keine hypothetische Bedrohung, sondern tägliche Realität für jede Website, die irgendetwas Wertvolles zu bieten hat.
Schätzungen aus Branchenberichten der letzten Jahre zufolge macht automatisierter Traffic etwa die Hälfte aller Anfragen im Internet aus, und rund ein Drittel des Gesamtvolumens entfällt auf eindeutig bösartige Bots. Bei E-Commerce, Kleinanzeigenportalen, Travel-Projekten und Content-Plattformen ist der Anteil oft noch höher. Der Trend 2026 ist dabei eindeutig: Zu den klassischen Scrapern sind Agenten auf Basis großer Sprachmodelle hinzugekommen, die Websites nicht schlechter als Menschen durchsuchen, Inhalte lesen und Entscheidungen treffen. Die Grenze zwischen "lebendigem" und "automatischem" Besucher verschwimmt zusehends.
Die Zielgruppe von mobileproxy.space kennt dieses Thema von beiden Seiten. Marketingleute und Affiliate-Manager sammeln selbst Daten, Entwickler schreiben Collector, Geschäftsinhaber beobachten Wettbewerber. Aber jeder von Ihnen hat sicherlich eine eigene Website, Landingpage, einen Katalog oder eine API, die gerade in diesem Moment jemand exportiert. Deshalb wechseln wir in diesem Artikel die Perspektive: Heute werden Sie gescraped, und wir erläutern, wie Sie einen Bot-Schutz für Ihre Website aufbauen, der funktioniert und echte Nutzer nicht behindert.
Ein wichtiger Hinweis vorab. Wir vergleichen keine Anbieter und erstellen kein Ranking kommerzieller Dienste — dem ist ein separater Beitrag im Blog gewidmet. Hier geht es um die Implementierung: Welche Schutzebenen gibt es, in welcher Reihenfolge sollten sie eingerichtet werden, wie misst man den Effekt und welche Stolperfallen lauern auf jedem Schritt. Was Sie bis zum Ende der Lektüre erhalten:
- ein Verständnis dafür, wie moderne Bot-Schutzsysteme einen Besucher "sehen" und warum IP-Blocking längst keine Lösung mehr ist;
- eine Diagnosemethodik: Wie Sie an einem Tag herausfinden, wer Sie wie genau scrapt;
- drei Verteidigungslinien mit Schritt-für-Schritt-Anleitungen — vom serverseitigen Rate Limiting bis zur Verhaltensanalyse und zu Datenfallen;
- ein Framework für die schrittweise Implementierung ohne Einbruch der Conversion;
- Checklisten, eine Werkzeugliste und die Analyse realer Fallstudien mit Zahlen.
Machen Sie es sich bequem. Der Artikel ist umfangreich, aber er ist als Arbeits-Lesezeichen gedacht, zu dem Sie bei jeder Projektphase zurückkehren werden.
Grundlagen: Was ist Bot-Schutz und vor wem schützt er
Bots sind unterschiedlich, und nicht alle müssen blockiert werden
Das Erste, was Sie akzeptieren sollten: Bot ist kein Schimpfwort. Suchmaschinen-Roboter indexieren Ihre Seiten und bringen Traffic. Verfügbarkeitsmonitoring prüft, ob die Website läuft. Zahlungssysteme lösen Webhooks aus. Partner-Aggregatoren beziehen Feeds per Vertrag. All das ist automatisierter Traffic, den Sie brauchen und der Ihnen nützt. Die Aufgabe des Bot-Schutzes für Websites ist es nicht, Automatisierung als Phänomen zu vernichten, sondern nützliche und zulässige Anfragen von schädlichen zu trennen und schädliche wirtschaftlich sinnlos zu machen.
Unerwünschte Bots werden grob in mehrere Kategorien eingeteilt:
- Content- und Preis-Scraper — exportieren Katalog, Beschreibungen, Bestände, Preise, Bewertungen. Der Hauptdarsteller dieses Artikels.
- Aggregatoren ohne Vertrag — nehmen Ihre Daten und verkaufen den Zugang Dritten.
- Bots zum Durchprobieren von Zugangsdaten — greifen Anmeldeformulare an und prüfen geleakte Login-Passwort-Paare.
- Scalper und "Bestands-Sniper" — kaufen knappe Ware oder buchen Slots in Sekundenbruchteilen.
- Spam-Bots und Manipulatoren — verstopfen Formulare, registrieren Fake-Konten, verfälschen Metriken.
- Crawler von KI-Modellen — sammeln Text für das Training oder für Echtzeit-Antworten. Ihre Zulässigkeit bestimmt jedes Unternehmen für sich.
Beachten Sie: Scraping allein bringt eine Website selten zum Absturz. Aber es erzeugt parasitäre Last (manchmal bis zu 60-80% aller Anfragen an den Katalog), verfälscht die Analytics, erschöpft die Limits externer APIs, die Sie beim Rendern der Seite aufrufen, und raubt Ihnen vor allem den Wettbewerbsvorteil, für den Sie diese Daten gesammelt haben.
Worin sich Schutz vor Scraping von DDoS-Schutz unterscheidet
Viele Website-Betreiber setzen diese beiden Aufgaben gleich und wundern sich, warum ein Anti-DDoS-Filter einen Scraper durchlässt. Der Unterschied ist grundlegend. DDoS ist ein Angriff auf das Volumen: Das Ziel des Angreifers ist es, die Ressource des Kanals oder Servers zu erschöpfen. Ein solcher Angriff ist an den Metriken leicht zu erkennen und wird auf Netzwerkebene gefiltert. Ein Scraper hingegen versucht, unauffällig zu bleiben: Er streckt die Anfragen über die Zeit, verteilt sie auf Zehntausende Adressen, imitiert einen Browser und besucht dieselben URLs wie echte Menschen. Ein klassischer DDoS-Filter sieht gleichmäßigen, "gesunden" Traffic und lässt ihn durch. Deshalb erfordert der Bot-Schutz grundlegend andere Signale — dazu im nächsten Abschnitt.
Drei Verteidigungslinien: Das Modell, das wir verwenden werden
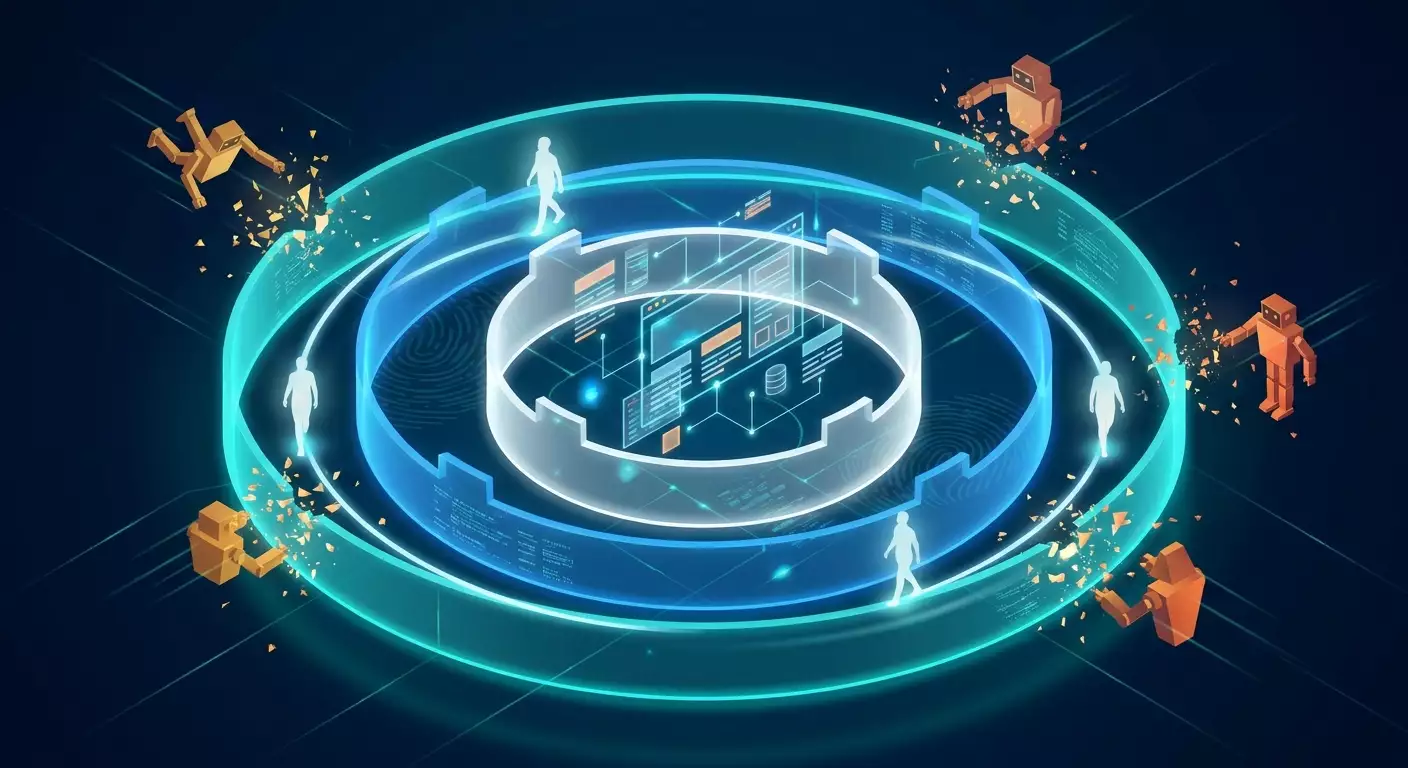
Um in der Technologie nicht zu ertrinken, ist es praktisch, Bot-Schutz als drei konzentrische Schichten darzustellen. Die Analogie ist eine mittelalterliche Festung: Graben und Außenmauer, Tore mit Wachen und schließlich die inneren Gemächer, wo selbst der durch das Tor gelangte Gast unter Beobachtung steht.
- Netzwerk- und Serverebene. Begrenzung der Anfragefrequenz, Filterung nach Netzreputation, WAF, Grundregeln für Header. Günstig, schnell, hält primitivste Bots ab.
- Ebene der Client-Prüfung. JavaScript-Challenges, Analyse von TLS- und Browser-Fingerprints, Captcha an den richtigen Stellen, Proof-of-Work-Aufgaben. Hält Skripte ohne Browser und schlecht konfigurierte Headless-Tools ab.
- Verhaltensebene und Datenschutz. Analyse von Handlungsabläufen, Session-Scoring, Honeypot-Fallen, Obfuskation und Wasserzeichen in den Daten selbst. Wirkt gegen fortgeschrittene Bots, die die ersten beiden Runden passiert haben.
Der Kernpunkt, zu dem wir immer wieder zurückkehren werden: Keine Ebene allein ist ausreichend. Die Stärke liegt darin, dass ein Bot alle drei gleichzeitig umgehen muss, und jede zusätzliche Hürde erhöht den Preis seiner Arbeit. Wenn Scraping teurer wird als der legale Datenkauf oder eine andere Erfassungsmethode, hört das Scraping auf. Das ist Ökonomie, nicht Magie.
Grundbegriffe, die Ihnen begegnen werden
- Rate Limiting — Begrenzung der Anzahl von Anfragen von einer Quelle pro Zeiteinheit.
- WAF (Web Application Firewall) — Firewall auf Anwendungsebene, die HTTP-Anfragen nach Regeln filtert.
- Fingerprint — eine Reihe von Client-Merkmalen, die seinen Typ oder eine konkrete Instanz erkennen lässt.
- Headless-Browser — ein vollwertiger Browser ohne grafische Oberfläche, programmatisch gesteuert.
- Challenge — eine Prüfaufgabe, die der Client lösen muss, um Zugang zu erhalten.
- False Positive — ein falsch-positives Ergebnis, wenn der Schutz einen echten Nutzer blockiert.
- Honeypot — eine Falle: ein Element, das für Menschen unsichtbar, für automatisierte Clients aber sichtbar ist.
Tiefeneinblick: Wie ein modernes Bot-Schutzsystem einen Besucher "sieht"
Um den Schutz bewusst einzurichten, müssen Sie verstehen, auf welche Signale er sich stützt. Hier beginnt das Interessanteste: In den letzten fünf Jahren hat die Branche den Weg von "IP sperren" bis zum mehrschichtigen Scoring durchlaufen, bei dem die Entscheidung auf Hunderten von Merkmalen basiert. Sehen wir uns die wichtigsten Signalgruppen an.
Netzwerksignale und warum die IP nicht mehr die Hauptrolle spielt
Historisch war die IP-Adresse das erste Bot-Merkmal. Anfragen aus dem Rechenzentrum? Wahrscheinlich ein Skript. Tausend Anfragen von einer Adresse? Sicher ein Skript. Dieser Ansatz funktioniert noch gegen faule Scraper, die direkt von Cloud-Servern kommen, und sollte angewendet werden. Aber er hat zwei grundlegende Einschränkungen.
Erstens: Residential- und mobile Adressen. Die Zielgruppe dieses Blogs weiß besser als viele, dass sich hinter einer mobilen IP eines Netzbetreibers dank NAT gleichzeitig mehrere Tausend echte Teilnehmer befinden können. Blockiert man eine solche Adresse wegen eines verdächtigen Clients, schneidet man einen ganzen Stadtteil von der Website ab. Reputationsdatenbanken für mobile Netze sind fast nutzlos: Eine Adresse, die gestern ein Scraper nutzte, gehört heute Ihrem Kunden. Deshalb verwendet ein gut gemachter Bot-Schutz für Websites IPs nur als eines von mehreren schwachen Signalen, nicht als Urteilsgrundlage.
Zweitens: Verteilung. Ein moderner Scraper rotiert Adressen so, dass auf jede 2-3 Anfragen pro Stunde entfallen. Ein Rate-Limiting-Schwellenwert, der ausreicht, um einen solchen Client abzuwehren, trifft garantiert echte Menschen, die zehn Katalog-Tabs öffnen.
Was bleibt auf Netzwerkebene nützlich? ASN-Merkmale (Zugehörigkeit des Netzes zu einem Hosting-Anbieter), geografische Anomalien (Traffic aus einem Land, in dem Sie nicht tätig sind), Diskrepanz zwischen IP-Geolokation und Browsersprache, Statistiken über Subnetze statt über einzelne Adressen.
Fingerprints auf Transport- und Protokollebene
Hier ein Signal, das viele unterschätzen. Wenn ein Client eine verschlüsselte Verbindung aufbaut, sendet er eine Begrüßungsnachricht im TLS-Protokoll mit einer Liste unterstützter Cipher, Erweiterungen und deren Reihenfolge. Diese Zusammenstellung hängt von der Bibliothek ab, die der Client verwendet. Chrome auf Windows erzeugt eine andere Begrüßung, Firefox eine andere, und eine Python-Bibliothek für HTTP-Anfragen eine dritte, völlig anders als die eines Browsers. Der Hash dieser Zusammenstellung wird TLS-Fingerprint genannt (verbreitete Schemata sind JA3 und das neuere JA4).
Die Magie liegt darin, dass ein Scraper den User-Agent-Header in einer Sekunde fälschen kann, aber den TLS-Fingerprint so zu fälschen, dass er mit dem angegebenen Browser übereinstimmt, ist deutlich schwieriger. Wenn sich ein Client als frischer Chrome ausgibt, seine TLS-Begrüßung aber einer Konsolenbibliothek entspricht, steht ein Skript vor uns. Ähnliche Fingerprints existieren für HTTP/2 (Reihenfolge und Werte der SETTINGS-Frames, Stream-Prioritäten) und HTTP/3. Die Kombination "angegebener Browser + TLS + HTTP/2" liefert bereits eine ordentliche Klassifizierungsgenauigkeit ohne eine Zeile JavaScript.
Browser-Fingerprint und Anzeichen von Automatisierung
Wenn der Client JavaScript ausführt, erweitert sich das Analysefeld um ein Vielfaches. Das Schutzskript sammelt Hunderte von Parametern: Bildschirmauflösung und ihr Verhältnis zur Fenstergröße, Schriftartenliste, Ergebnis des Grafik-Renderings über Canvas und WebGL, Eigenschaften des Audio-Kontexts, Zeitzone, Spracheinstellungen, Vorhandensein und Verhalten spezifischer Umgebungsobjekte. Separat werden Anzeichen von Automatisierung geprüft: Eigenschaften, die der Headless-Modus in der Umgebung hinterlässt, Diskrepanzen zwischen angegebener Plattform und tatsächlichen Möglichkeiten, allzu "perfekte" Werte dort, wo ein echtes Gerät immer Rauschen aufweist.
Wichtig zu verstehen: Das Ziel ist nicht, einen Menschen eindeutig zu identifizieren (das ist sowohl rechtlich sensibel als auch technisch unzuverlässig), sondern innere Widersprüche zu finden. Ein echtes iPhone meldet nicht 32 logische Prozessorkerne. Ein echtes Chrome auf Android hat keine Bildschirmauflösung von 1920 mal 1080 ohne Touch-Eingabe. Jeder Widerspruch ist ein Pluspunkt für die Verdächtigungsbewertung.
Verhaltenssignale
Die am schwersten fälschbare Klasse von Merkmalen ist das Verhalten über die Zeit. Ein Mensch bewegt den Cursor mit mikroskopischen Zittern und Beschleunigungen, scrollt ungleichmäßig, macht Lesepausen, klickt nicht exakt in die Mitte einer Schaltfläche. Ein Mensch kommt auf die Startseite, geht in eine Kategorie, schaut sich drei bis vier Produkte an, kehrt zurück. Ein Bot öffnet fünfhundert Produktkarten hintereinander nach aufsteigender ID, jede genau nach 1,2 Sekunden, lädt nie Bilder und fordert kein CSS an. Selbst die fortschrittlichsten Scraper mit gesteuerten Browsern verraten sich durch die Struktur der Sitzung: Es ist unmöglich, den gesamten Katalog zu exportieren und sich dabei wie ein einzelner Käufer zu verhalten.
Scoring statt Schwarz-Weiß-Entscheidung
Moderne Systeme beantworten die Frage "Bot oder Mensch" nicht binär. Sie weisen jeder Anfrage oder Sitzung eine Risikobewertung zu, und dann wird eine Richtlinie angewendet: geringes Risiko — durchlassen, mittleres — unsichtbare Challenge zeigen oder Antwort verlangsamen, hohes — Captcha oder Blockierung, kritisches — plausibel wirkende, aber verfälschte Daten liefern. Dieser Ansatz senkt falsch-positive Ergebnisse drastisch: Einem zweifelhaften Client wird nicht die Tür vor der Nase zugeschlagen, sondern er erhält die Chance zu beweisen, dass er echt ist.
Was sich 2026 ändert
Mehrere Trends, die die Gestaltung des Schutzes bereits beeinflussen:
- KI-Agenten als neue Client-Klasse. Agenten auf Basis von Sprachmodellen steuern echte Browser, lesen Seiten und verhalten sich fast wie Menschen. Ein Teil von ihnen ist nützlich (sie bringen Käufer), ein Teil sind einfach klügere Scraper. Websites werden eine ausdrückliche Richtlinie für solchen Traffic formulieren müssen.
- Standardisierung der "ethischen" Bot-Identifikation. Mechanismen werden entwickelt, bei denen ein legitimer automatisierter Client kryptografisch seine Zugehörigkeit zu einem konkreten Unternehmen bestätigt. So können nützliche Roboter ohne Challenges durchgelassen werden.
- Geräte-Attestierung und Vertrauens-Token. Betriebssysteme und Browser experimentieren mit Mechanismen, die es einer Website erlauben, die Bestätigung "das ist ein echtes Gerät mit einem echten Menschen" zu erhalten, ohne Fingerprints zu sammeln. Perspektivisch vereinfacht das den Schutz, aber derzeit ist die Abdeckung begrenzt.
- Wachstum von HTTP/3 und Metadaten-Verschlüsselung. Ein Teil der gewohnten Netzwerksignale wird weniger zugänglich, was den Schwerpunkt auf Verhaltensanalyse verschiebt.
- Regulatorischer Druck auf die Erfassung von Nutzerdaten. Browser-Fingerprints und die Speicherung von Sitzungen erfordern einen sorgfältigen Umgang mit Datenschutzgesetzen. Der Schutz muss so gestaltet sein, dass er ein Minimum des Notwendigen erfasst.
Die Schlussfolgerung aus diesem Abschnitt ist einfach und wichtig: Ein zuverlässiger Schutz vor Scraping baut auf der Kombination schwacher Signale auf, nicht auf einem "silbernen" Merkmal. Behalten Sie das im Kopf, wenn wir zur Praxis übergehen.
Methode 1. Diagnose: Wir finden heraus, wer Sie wie scrapt
Schutz blind einzurichten ist der sicherste Weg, Budget zu verschwenden und die Falschen zu blockieren. Bevor Sie etwas implementieren, investieren Sie ein bis zwei Tage in die Aufklärung. Die gute Nachricht: Dafür brauchen Sie keine teuren Tools, es genügen Webserver-Logs und die Fähigkeit, ihnen die richtigen Fragen zu stellen.
Schritt 1. Sammeln Sie vollständige Logs über einen repräsentativen Zeitraum
Mindestens sieben Tage, um den Wochenzyklus zu erfassen. Die Logs sollten enthalten: Zeit, IP, Methode und Anfragepfad, Antwortcode, Antwortgröße, User-Agent, Referer, Bearbeitungszeit. Wenn Ihr Webserver nur das Standardformat schreibt, erweitern Sie es. Bei einem Projekt mit Millionen Anfragen pro Tag ist es praktisch, die Logs direkt in eine analytische Datenbank oder zumindest in ein tabellarisches Format zu exportieren.
Schritt 2. Finden Sie Anomalien in der Traffic-Struktur
Stellen Sie den Logs die folgenden Fragen und notieren Sie die Antworten — das wird Ihre Basislinie.
- Verteilung nach Stunden. Echter Traffic hat einen Tageszyklus. Ein gleichmäßiges "Plateau" nachts oder eine Spitze um 4 Uhr morgens ist der erste Marker.
- Verhältnis der Ressourcentypen. Wie viele Anfragen an HTML-Seiten entfallen auf eine Anfrage an CSS, JS und Bilder? Bei einem Browser ist dieses Verhältnis etwa 1 zu 10-30. Bei einem Scraper 1 zu 0. Finden Sie Adressen und Subnetze, die nur HTML oder nur JSON anfordern.
- Tiefe des Crawls. Wer öffnet pro Sitzung mehr als 100 Produktkarten? Wer durchläuft nacheinander IDs, Paginierungsseiten, Kombinationen von Filtern?
- Header. Veraltete Browserversionen, leerer oder bibliotheksspezifischer User-Agent, fehlendes Accept-Language, derselbe User-Agent auf Tausenden von Adressen.
- Antwortcodes. Massenhafte 404 bei nicht existierenden IDs — ein Zeichen für Durchprobieren. Massenhafte 429 oder 403 — jemand stößt bereits an Ihre Limits.
- Autonome Systeme. Gruppieren Sie IPs nach ASN. Ein Anteil von Hosting-Anbietern am Katalog-Traffic über 5-10% bedeutet fast sicher Bots.
Schritt 3. Bewerten Sie den Schaden in Geld
Übersetzen Sie die Befunde in die Sprache des Geschäfts, sonst bekommt der Schutz kein Budget. Berechnen Sie: den Anteil parasitären Traffics und seine Infrastrukturkosten; die Last auf externe kostenpflichtige APIs (Wechselkurse, Geocoding, Suche), die Bots erzeugen; die Verfälschung der Analytics (falsche Sitzungen verzerren die Werbung-Attribution, und das betrifft Marketingleute direkt); den entgangenen Nutzen aus kopierten Preisen und Inhalten. Selbst eine grobe Schätzung wie "Bots kosten uns 180.000 Rubel pro Monat an Infrastruktur und eine unbekannte Summe an Wettbewerbsposition" verändert das Gespräch mit der Geschäftsleitung.
Schritt 4. Stellen Sie Fallen auf, um Hypothesen zu bestätigen
Logs zeigen, dass jemand da ist, aber nicht, was er genau will. Ergänzen Sie die Analyse durch aktive Aufklärung:
- Köder-Einträge. Fügen Sie dem Katalog ein nicht existierendes Produkt mit einzigartigem Namen hinzu, das nicht von Suchmaschinen indexiert und nicht in der Navigation angezeigt wird, aber über einen direkten Link aus der Paginierung erreichbar ist. Erscheint dieser Name auf einer fremden Website, ist das der Beweis für Scraping und ein Hinweis auf die Quelle.
- Versteckte Links. Ein Link, der für Menschen unsichtbar ist (außerhalb des Bildschirms, ohne Größe), aber im HTML vorhanden. Ein Mensch klickt nie darauf. Jeder Klick ist ein Bot. Vergessen Sie nicht, ihn über Ausschlussregeln vor Suchmaschinen-Robotern zu schützen.
- Einzigartige Leerzeichen und kleine Variationen. Kleine einzigartige Besonderheiten der Formatierung in Beschreibungen, an denen Sie später kopierten Text erkennen können.
Schritt 5. Erstellen Sie Scraper-Profile
Das Ergebnis der Diagnose sollte eine Tabelle mit drei bis fünf Profilen sein. Zum Beispiel: "Profil A: Cloud-Skript ohne JS, 40.000 Anfragen an Produktkarten pro Nacht, User-Agent eines alten Chrome, ein Subnetz". "Profil B: verteilter Client auf Residential-Adressen, 2-3 Anfragen pro Adresse, führt JS aus, durchläuft nur den Preisfilter". "Profil C: Aggregator, gibt sich ehrlich zu erkennen, bezieht den Feed einmal täglich". Für jedes Profil ist sofort klar, welche Schutzebene es stoppen wird. Profil A fällt auf der ersten Linie. Profil B erfordert Verhaltensanalyse. Profil C sollte man vielleicht eine Partner-API anbieten — manchmal ist das rentabler als Krieg.
Checkliste der Diagnose
- Logs für 7+ Tage mit vollständigem Feldsatz sind gesammelt.
- Die Verteilung des Traffics nach Stunden und Ressourcentypen ist erstellt.
- Die Top-20 Subnetze und ASN nach Anzahl der Anfragen an "wertvolle" URLs sind identifiziert.
- Sitzungen mit anomaler Tiefe und Regelmäßigkeit sind gefunden.
- Der Anteil parasitären Traffics und seine Kosten sind berechnet.
- Köder-Einträge und versteckte Links sind platziert.
- Scraper-Profile mit Angabe der Zielschutzebene sind erstellt.
- Legitime Bots, die nicht angetastet werden dürfen, sind bestimmt: Suchmaschinen, Zahlungs-Webhooks, Partner, Monitoring.
Methode 2. Erste Linie: Server- und Netzwerkebene
Die erste Linie ist das Fundament. Sie wird einen fortgeschrittenen Scraper nicht stoppen, aber sie hält 50-70% der primitiven Bots buchstäblich an einem Arbeitstag und fast kostenlos ab. Diese Etappe zugunsten teurer Lösungen zu überspringen ist ein Fehler: Warum für die Analyse jeder Anfrage zahlen, wenn die Hälfte mit einer einfachen Regel abgewiesen werden kann?
Rate Limiting richtig gemacht
Rate Limiting ist das bekannteste Instrument und das am häufigsten falsch konfigurierte. Typischer Fehler: ein globales Limit pro IP für die gesamte Website. Das Ergebnis — entweder ist das Limit zu weich und nutzlos, oder zu hart und trifft Büros, Universitäten und mobile Netze mit NAT. Der richtige Ansatz sind differenzierte Limits:
- Nach Ressourcentyp. Statik und Startseite — großzügige Limits. Produktkarten, Suchergebnisse, JSON-Endpunkte des Katalogs — deutlich strenger. Anmelde- und Registrierungsformulare — sehr streng.
- Nach Schlüssel. Nicht nur IP. Kombinieren Sie: IP + Pfad, IP + User-Agent, Sitzungs-Cookie, für authentifizierte Nutzer — Konto-ID. Für mobile Netze ist ein Limit nach Subnetz /24 oder nach ASN mit hohem Schwellenwert besser als ein hartes Limit pro einzelner Adresse.
- Nach Zeitfenstern. Zwei Fenster: ein kurzes (zum Beispiel 20 Anfragen in 10 Sekunden — gegen Spitzen) und ein langes (zum Beispiel 600 Anfragen an Produktkarten pro Stunde — gegen langsames Crawling). Ein langsamer, aber hartnäckiger Scraper fällt ins zweite Fenster, ein echter Mensch nicht.
- Nach Reaktionstyp. Das Überschreiten des Limits muss nicht Blockierung bedeuten. Die erste Stufe ist eine Antwortverzögerung von 2-5 Sekunden. Die zweite — Code 429 mit Header Retry-After. Die dritte — ein temporärer Bann für 10-15 Minuten. Die schrittweise Eskalation trifft Menschen kaum und bremst Bots stark.
Ein Beispiel einer einfachen Zonenkonfiguration für einen gängigen Webserver, die Sie an Ihre Bedürfnisse anpassen (Werte sind beispielhaft):
limit_req_zone $binary_remote_addr zone=catalog_burst:20m rate=3r/s;limit_req_zone $binary_remote_addr zone=login:10m rate=10r/m;location /catalog/ { limit_req zone=catalog_burst burst=15 delay=8; }location /login { limit_req zone=login burst=3 nodelay; limit_req_status 429; }Achten Sie auf den Parameter delay: Er erlaubt es, einen Teil der Spitze sofort zu bedienen und den Rest mit Verzögerung, was für einen Menschen, der zehn Tabs geöffnet hat, angenehm und für ein Skript unangenehm ist.
Filterung nach Netzmerkmalen
Erstellen Sie eine Richtlinie für autonome Systeme. Hosting-Anbieter und Clouds sind Quellen der meisten primitiven Scraper. Eine vollständige Blockierung ist nicht immer angebracht (von dort kommen auch Unternehmens-Proxys und ein Teil legitimer Dienste), aber strenge Limits und eine obligatorische JavaScript-Challenge anzuwenden ist vernünftig. Für Länder, in denen Sie kein Geschäft betreiben, gilt analog: keine Blockierung, sondern erhöhte Prüfstufe. Denken Sie an den Ansatz "ein schwaches Signal fügt Punkte hinzu", nicht "ein Signal entscheidet alles".
Regeln auf Header-Ebene
Einige günstige, aber wirksame Regeln für WAF oder Serverkonfiguration:
- Anfragen mit leerem User-Agent oder mit Signaturen bekannter HTTP-Bibliotheken an nicht dienstliche URLs ablehnen. Legitime Integrationen sollten eine dedizierte API mit Schlüssel nutzen, nicht öffentliche Seiten.
- Konsistenz der Header verlangen: Ein angegebener Chrome ohne die für ihn charakteristischen Client-Hint-Header ist verdächtig.
- Code 404 oder 410 für veraltete URL-Formate zurückgeben, die Scraper weiterhin über alte Sitemaps aufrufen.
- Versionen der Server-Software und Frameworks in Headern verbergen — nicht für den Scraping-Schutz, aber für die allgemeine Hygiene.
Roboter-Regeln und ausdrückliche Richtlinie
Die Datei mit Regeln für Suchmaschinen-Roboter ist kein Schutzmittel — ein bösartiger Bot ignoriert sie. Aber sie ist aus zwei Gründen wichtig. Erstens erlaubt sie, nützliche Bots ausdrücklich zuzulassen und unerwünschte Crawler ausdrücklich zu verbieten, einschließlich Datensammler für KI-Modelle — gewissenhafte Betreiber halten diese Regeln ein. Zweitens fixiert sie Ihre Position: Die Kombination aus technischen Regeln und Nutzungsbedingungen macht unbefugtes Datensammeln für den, der es betreibt, rechtlich angreifbarer. Schreiben Sie unbedingt in die Nutzungsbedingungen ein Verbot automatisierter Erfassung ohne schriftliche Erlaubnis.
Caching als Schutz
Ein nicht offensichtlicher Trick: Aggressives Caching "wertvoller" Seiten auf CDN- oder Reverse-Proxy-Ebene hindert den Scraper nicht daran, Daten abzurufen, aber es beseitigt den Hauptschmerz — die Last auf Anwendung und Datenbank. Wenn ein Bot den Katalog aus dem Cache exportiert, ist das Ihrer Infrastruktur fast egal. Das ist kein Sieg, aber es ist gewonnene Zeit, um die nächsten Linien ohne Feuerlöschen aufzubauen.
Checkliste der ersten Linie
- URL-Gruppen mit unterschiedlichem Wert sind definiert und für jede sind eigene Limits konfiguriert.
- Zwei Limit-Fenster sind implementiert: kurz und lang.
- Die Reaktion auf Überschreitung ist Eskalation: Verzögerung, 429, temporärer Bann.
- Limits für mobile und Residential-Netze sind gelockert oder werden pro Subnetz gezählt.
- Hosting-ASNs und nicht zielgerichtete Regionen sind in den Modus erhöhter Prüfung versetzt, nicht in den Bann.
- Header-Regeln zum Ausschluss von Bibliotheks-Clients sind konfiguriert.
- Die Roboter-Richtlinie und das juristische Verbot des Datensammelns sind formuliert.
- Caching teurer Seiten ist aktiviert.
- Ausnahmen für Suchmaschinen, Zahlungssysteme und Partner sind geprüft und dokumentiert.
Methode 3. Zweite Linie: Client-Prüfung und Challenges
Die erste Linie reagiert auf Merkmale der Anfrage selbst. Die zweite geht weiter und stellt dem Client die Frage: "Beweise, dass du ein Browser bist, und beweise, dass hinter dir ein Mensch steht". Genau hier werden Skripte ohne JavaScript-Ausführung und hastig konfigurierte Headless-Tools abgehalten. Sehen wir uns die Instrumente dieser Schicht nach steigendem "Preis" für den Nutzer an.
TLS- und HTTP/2-Fingerprints: der nahtlose Filter
Beginnen Sie mit dem, was der Nutzer gar nicht bemerkt. Berechnen Sie am Load Balancer oder Reverse Proxy den TLS-Fingerprint der Verbindung und vergleichen Sie ihn mit dem angegebenen User-Agent. Typische Logik:
- Der Fingerprint entspricht einer bekannten HTTP-Bibliothek, während der User-Agent einen Browser angibt — hohes Risiko.
- Der Fingerprint entspricht einem Browser, aber nicht der im Header angegebenen Familie oder Version — mittleres Risiko.
- Der Fingerprint erscheint erstmals auf Ihrer Website und ist gleichzeitig bei Tausenden von Adressen vorhanden — Verdacht auf ein neues Scraping-Tool.
Ein wichtiges Implementierungsdetail: Blockieren Sie nicht am ersten Tag anhand des TLS-Fingerprints. Sammeln Sie eine Woche lang Statistiken, finden Sie heraus, welche Fingerprints Ihrer echten Zielgruppe entsprechen (einschließlich Browser in mobilen Apps und Webviews von Messengern, deren Fingerprints spezifisch sind), und schalten Sie die Regeln erst dann in den aktiven Modus. Sonst riskieren Sie, Nutzer abzuschneiden, die Ihre Website über Telegram oder einen Mail-Client öffnen.
JavaScript-Challenge: Prüfung der Ausführungsumgebung
Eine einfache JS-Challenge ist ein kleines Skript, das der Client ausführen muss, um ein Zugriffs-Cookie zu erhalten. Ohne Cookie liefert der Server eine Platzhalterseite statt Inhalt. Einfache Skripte mit HTTP-Bibliotheken führen kein JavaScript aus und bleiben vor der Tür. Eine fortgeschrittenere Version sammelt Umgebungsmerkmale und prüft deren Konsistenz, worüber wir im Abschnitt über Signale gesprochen haben.
Praktische Empfehlungen für die Implementierung:
- Zeigen Sie die Challenge nicht allen. Wenden Sie sie auf Anfragen mit mittlerem Risikowert und auf wertvolle Bereiche an. Startseite und Landingpages, auf die Werbung führt, müssen sofort öffnen — jede zusätzliche Sekunde bis zum ersten Bildschirm kostet Conversion, und Affiliate-Manager wissen das besser als alle anderen.
- Machen Sie die Challenge unsichtbar. Das Skript sollte im Hintergrund in 100-300 Millisekunden ausgeführt werden, ohne weißen Bildschirm und ohne Meldungen wie "wir prüfen Ihren Browser". Für einen ehrlichen Client ist der Prozess unsichtbar.
- Binden Sie das Ergebnis an die Sitzung, nicht an die IP. Das Zugriffs-Cookie muss signiert sein, eine Lebensdauer haben und einen Hash der wichtigsten Client-Merkmale enthalten. Dann kann man es nicht einfach kopieren und an hundert Scraper-Threads verteilen.
- Ändern Sie die Challenge regelmäßig. Eine statische Prüfung wird innerhalb einer Woche geknackt. Obfuskieren Sie den Code, ändern Sie die geprüften Parameter, rotieren Sie Signaturschlüssel.
- Prüfen Sie die Konsistenz der JS-Daten mit den Serverdaten. Die Zeitzone aus dem Skript stimmt nicht mit der IP-Geolokation überein? Die angegebene Plattform stimmt nicht mit dem TLS-Fingerprint überein? Jede Abweichung ist ein Risikopunkt.
Proof of Work: die ökonomische Barriere
Ein elegantes Verfahren, das als Alternative zum Captcha an Popularität gewinnt. Der Server gibt dem Client eine Rechenaufgabe (zum Beispiel einen Wert finden, dessen Hash mit einer bestimmten Anzahl von Nullen beginnt). Der Browser auf dem Handy löst sie in 200-500 Millisekunden, unbemerkt für den Menschen. Aber ein Scraper, der 100.000 Anfragen stellt, muss dafür Stunden an Prozessorzeit aufwenden. Die Komplexität der Aufgabe lässt sich proportional zum Risikowert erhöhen: Einem verdächtigen Client eine zehnmal schwerere Aufgabe geben. Der Mensch bemerkt den Unterschied nicht, der Bot sehr wohl.
Captcha: wo sie angebracht und wo sie schädlich ist
Das Captcha ist das sichtbarste und irritierendste Instrument. Studien zur Nutzererfahrung zeigen beständig: Jedes Captcha auf dem Weg zum Kauf senkt die Conversion, wobei die Verluste bei mobilen Nutzern höher sind. Deshalb ist die Regel einfach: Das Captcha ist das letzte Argument, nicht die erste Prüfung. Geeignete Einsatzpunkte:
- Anmeldeformulare nach mehreren fehlgeschlagenen Versuchen;
- Registrierung und Passwort-Wiederherstellung;
- Absenden von Kontakt- und Bewertungsformularen;
- Situationen, in denen der Risikowert der Sitzung bereits hoch ist und der Client trotzdem weiter im Katalog navigiert;
- Schutz kritischer Vorgänge: Buchung, Anwendung eines Promo-Codes, Hinzufügen eines knappen Produkts zum Warenkorb.
Ungeeignete Punkte: Startseite, Produktkarten, Suche, Landingpages von Werbekampagnen. Wenn Sie gezwungen sind, ein Captcha im Katalog einzusetzen, bedeutet das, dass die vorherigen Schichten nicht funktionieren, und diese müssen behandelt werden. Separat: Wählen Sie moderne Captcha-Varianten mit unsichtbarem Modus und adaptiver Komplexität, nicht die Bilder mit verzerrten Buchstaben aus den 2000ern.
Schutz von API und mobilen Anwendungen
Oft besuchen Scraper nicht einmal die Website — sie finden die JSON-Endpunkte, die Ihr Frontend nutzt, und beziehen saubere Daten ohne HTML-Parsing. Prüfen Sie: Ist Ihr Katalog-API ohne Sitzungs-Cookie und ohne signierte Anfrage zugänglich? Wenn ja, ist die gesamte Website-Sicherheit sinnlos. Ein Mindestmaß an Maßnahmen: kurzlebige signierte Token, die nach bestandener Challenge ausgegeben werden; Bindung des Tokens an die Sitzung; Begrenzung der Ausgabegröße und der Paginierungstiefe; separate, strengere Limits für die API. Für mobile Apps — Prüfung der Authentizität der App mit Plattformmitteln und Zertifikats-Pinning.
Checkliste der zweiten Linie
- TLS/HTTP2-Fingerprints werden berechnet, eine Wochenstatistik Ihrer Zielgruppe ist gesammelt.
- Fingerprint-Regeln sind erst nach der Analyse in den aktiven Modus versetzt worden.
- Die JS-Challenge ist unsichtbar implementiert und wird adaptiv nach Risikowert angewendet.
- Das Zugriffs-Cookie ist signiert, an den Client gebunden, hat eine Lebensdauer.
- Proof of Work mit adaptiver Komplexität ist implementiert.
- Das Captcha steht nur auf Formularen und bei kritischen Vorgängen, nicht im Katalog.
- Das Katalog-API ist durch Token und Limits geschützt, ohne Sitzung nicht zugänglich.
- Alle Prüfungen sind in Webviews von Messengern und mobilen Browsern getestet.
Methode 4. Dritte Linie: Verhalten, Fallen und Schutz der Daten selbst
Nehmen wir an, der Scraper hat die ersten beiden Runden passiert: Er arbeitet von Residential-Adressen aus, steuert einen echten Browser mit plausiblen Fingerprints, löst Challenges. Was kommt als Nächstes? Als Nächstes wechseln wir von der Frage "Wer bist du" zur Frage "Was tust du" und letztlich zur Entwertung der Beute. Das ist die intelligenteste Schicht des Bot-Schutzes für Websites, und genau sie unterscheidet ein reifes System von einem Regelwerk.
Verhaltens-Scoring von Sitzungen
Die Grundlage der dritten Linie ist die Anhäufung von Risikopunkten pro Sitzung über die Zeit. Merkmale, die gezählt werden sollten:
- Tiefe und Struktur der Navigation. Mehr als 50-100 Produktkarten pro Stunde, Durchlaufen der Paginierung bis zum Ende, Durchprobieren aller Filterkombinationen, Bewegung in aufsteigender Reihenfolge der IDs.
- Rhythmus. Allzu gleichmäßige Intervalle zwischen den Anfragen oder umgekehrt Intervalle mit perfekt zufälliger Verteilung (Menschen sind nie perfekt zufällig).
- Fehlende Interaktion. Keine Mausbewegungen, kein Scrollen, keine Berührungen, keine Fenstergrößenänderung, kein Fokus. Die Seite ist geladen, aber niemand schaut sie an.
- Uncharakteristische Pfade. Kein einziger Übergang zur Startseite, zum Warenkorb, zu den Kontakten. Nur Zielseiten mit Daten.
- Ignorieren von Ressourcen. Bilder, Schriftarten, Analytics-Skripte werden nicht angefragt.
- Multi-Sitzungs-Merkmale. Derselbe Browser-Fingerprint auf Hunderten von Adressen, Dutzende Sitzungen mit demselben Navigationsmuster, die in derselben Minute starten.
Die Reaktion auf steigende Punktzahl ist dieselbe Eskalation: zuerst Verlangsamung der Antworten, dann eine Challenge erhöhter Komplexität, dann Captcha, dann Blockierung der Sitzung. Und blockiert werden sollte genau die Sitzung und der Fingerprint, nicht die IP — denken Sie an mobile Netze.
Honeypot-Fallen im Produktivbetrieb
Die Fallen, die wir bei der Diagnose verwendet haben, funktionieren auch als ständiges Schutzelement hervorragend. Jeder versteckte Link, jedes unsichtbare Formularfeld, das ein Client ausfüllt, jede Anfrage an eine in der Navigation nicht existierende URL — ein Signal mit nahezu null falsch-positiven Ergebnissen. Ein Mensch kann physisch nicht auf ein Element mit null Größe klicken. Sicherheitsregeln: Schützen Sie die Fallen vor Suchmaschinen-Robotern, verwenden Sie keine Fallen, die ein Screenreader für Nutzer mit Behinderungen berühren könnte, ändern Sie Position und Aussehen der Fallen regelmäßig.
Entwertung der Beute: Arbeit mit den Daten selbst
Hier ist eine Strategie, über die kaum gesprochen wird, die aber oft wirksamer ist als jede Blockierung. Wenn Sie den Bot nicht daran hindern können, die Daten abzurufen, machen Sie das Abgerufene nutzlos oder verräterisch.
- Datenvergiftung für verdächtige Sitzungen. Einem Client mit hohem Risikowert wird kein Fehler 403 geliefert, sondern eine normale Seite mit verfälschten Preisen und Beständen: Preis plus-minus 7%, zufälliger Bestand, geänderte Bewertung. Der Scraper merkt nicht, dass er enttarnt wurde, und sammelt weiter Müll, der dann in die Datenbank des Wettbewerbers gelangt. Ein solcher Vorfall, der erst nach der Neubewertung der Waren entdeckt wird, vertreibt die Lust am Scraping für lange Zeit. Verwenden Sie dies mit Vorsicht: Nur bei sehr hoher Sicherheit, um einem echten Käufer keinen falschen Preis zu zeigen, und niemals für rechtlich bedeutsame Informationen.
- Wasserzeichen in den Daten. Einzigartige mikroskopische Besonderheiten des Inhalts pro Sitzung: Wortreihenfolge in der Beschreibung, unsichtbare Formatierungsvariationen, einzigartige "Köder"-Produkte. Damit beweisen Sie später, woher die Daten geleakt sind und mit welchem Client das zusammenhängt.
- Dynamisches Markup. Regelmäßiger Wechsel von CSS-Klassennamen und HTML-Struktur auf wertvollen Seiten bricht Scraper, die an Selektoren gebunden sind. Das ist ein Wettlauf, aber jede Iteration kostet Sie ein Release und den Angreifer das Umschreiben der Logik.
- Ungewöhnliches Rendering kritischer Werte. Der Preis kann aus mehreren Elementen zusammengesetzt, über CSS-Pseudoelemente eingesetzt, als Bild ausgegeben oder nach Interaktion verzögert geladen werden. Jede Methode hat einen Preis für Barrierefreiheit und Suchmaschinenoptimierung — wägen Sie ab.
- Begrenzung der Ausgabe. Geben Sie niemandem den gesamten Katalog: harte Grenze der Paginierungstiefe, obligatorische Eingrenzung durch Filter, kein Endpunkt "alle Produkte in einer Liste".
Legitimer Kanal statt Krieg
Ein paradoxes, aber funktionierendes Verfahren. Wenn Ihre Daten systematisch von Aggregatoren, Partnern oder Forschern benötigt werden, geben Sie ihnen eine offizielle API mit Schlüssel, Limits und Nutzungsbedingungen. Ein Teil der Last wandert aus der "grauen" Zone in eine kontrollierte, und Sie erhalten eine rechtliche und technische Grundlage, um hart gegen diejenigen vorzugehen, die weiterhin öffentliche Seiten scrapen.
Framework für die schrittweise Implementierung aller drei Linien
Separat zum Prozess, denn die meisten Fehlschläge geschehen nicht wegen der Technologie, sondern wegen der Eile. Empfohlene Reihenfolge:
- Beobachtungsmodus (1-2 Wochen). Alle Regeln und das Scoring arbeiten, blockieren aber nichts — sie protokollieren nur Entscheidungen. Sie sehen, wen Sie blockieren würden, und gleichen mit der Realität ab.
- Kalibrierung. Sie prüfen die Top-"würde-blockiert"-Sitzungen manuell. Darunter finden sich Ihre Partner, Ihr eigenes Monitoring, das Webview eines Messengers und Nutzer mit seltsamen, aber echten Browsern. Sie korrigieren die Schwellenwerte, fügen Ausnahmen hinzu.
- Sanfte Aktion (1-2 Wochen). Sie aktivieren nur Verlangsamung und unsichtbare Challenges. Sie beobachten Conversion, Absprungrate, Support-Anfragen.
- Vollständige Aktion mit schrittweiser Abdeckung. Sie aktivieren Captchas und Blockierungen zuerst für 10% des Traffics, dann für 50%, dann vollständig. Bei jedem Schritt — Kontrolle der Metriken.
- Betrieb. Wöchentliche Überprüfung falsch-positiver Ergebnisse, monatliche Überprüfung der Schwellenwerte, Rotation von Challenges und Fallen, Aktualisierung der Scraper-Profile.
Wichtige Metriken zur Kontrolle
- Anteil des als Bot klassifizierten Traffics, aufgeschlüsselt nach Website-Bereichen.
- Anzahl der Support-Anfragen mit Beschwerden über Captcha oder Nichtverfügbarkeit.
- Conversion und Absprungrate vor und nachher, separat für die mobile Zielgruppe.
- Anteil falsch-positiver Ergebnisse in einer manuell geprüften Stichprobe (Zielwert — unter 0,5%).
- Last auf Anwendung und Datenbank, Kosten der Infrastruktur.
- Zeit zwischen Ihrer Preisänderung und ihrem Erscheinen bei einem bekannten Wettbewerber.
Typische Fehler bei der Implementierung von Bot-Schutz
Wir haben besprochen, was zu tun ist. Jetzt dazu, was man nicht tun sollte — aus der Erfahrung dutzender Projekte wiederholen sich diese Fehler mit erstaunlicher Beständigkeit.
Fehler 1. IP-Blocking als Hauptmaßnahme
Der häufigste und schädlichste. Der Website-Betreiber sieht tausend Anfragen von einer Adresse, bannt sie — und schneidet ein Bürozentrum oder ein Segment des Mobilfunknetzes ab, hinter dem Tausende Teilnehmer stehen. Der Scraper wechselt unterdessen zur nächsten Adresse. IP ist ein schwaches Signal, ein Anlass für erhöhte Prüfung, aber nicht für einen Bann.
Fehler 2. Captcha auf alles
Die Reaktion im Stil "wir setzen ein Captcha auf jede Seite, und die Bots sollen leiden". Es leiden nicht die Bots, sondern die Conversion: echte Menschen gehen weg, die Werbung verbrennt Budget für Nutzer, die nicht bis zum Inhalt gekommen sind, Suchmaschinen-Roboter erhalten eine Platzhalterseite. Das Captcha ist ein punktuelles Instrument für Formulare und kritische Vorgänge.
Fehler 3. Aktivierung von Blockierungen ohne Beobachtungsmodus
Die Regeln werden abends geschrieben, nachts aktiviert, und morgens versinkt der Support in Beschwerden. Immer erst Beobachtung, dann Kalibrierung, dann Aktion.
Fehler 4. Vergessene legitime Bots
Ein blockierter Suchmaschinen-Roboter — Verlust von Rankings nach zwei Wochen. Ein blockierter Zahlungs-Webhook — unbezahlte Bestellungen. Ein blockiertes eigenes Monitoring — falsche Alarme. Bevor Sie eine Regel aktivieren, erstellen und prüfen Sie die Ausnahmeliste.
Fehler 5. Ignorieren von API und mobilen Endpunkten
Die Website ist vorbildlich geschützt, aber das JSON, das das Frontend aufruft, ist für die ganze Welt ohne Token offen. Der Scraper dankt für die sauberen strukturierten Daten. Der Schutz muss alle Kanäle der Content-Auslieferung abdecken.
Fehler 6. Statische Challenges und Fallen
Ein einmal eingerichteter Schutz ist nach einem Monat geknackt und umgangen. Bot-Schutz für Websites ist ein Prozess, kein Projekt: Rotation, Aktualisierung, Überprüfung der Schwellenwerte.
Fehler 7. Datenvergiftung ohne hohe Sicherheit
Die Versuchung, "verfälschte" Preise zu zeigen, ist groß, aber ein falscher Preis, einem echten Kunden gezeigt, und erst recht eine darauf aufgegebene Bestellung, ist ein Reputations- und Rechtsrisiko. Wenden Sie es nur auf Sitzungen mit maximalem Risikowert an und niemals auf rechtlich bedeutsame Informationen.
Fehler 8. Vergessene Barrierefreiheit
Fallen und ungewöhnliches Rendering können die Website für Screenreader und Nutzer mit Behinderungen unbrauchbar machen. Testen Sie den Schutz mit Barrierefreiheits-Tools, nicht nur im frischen Chrome.
Fehler 9. Erfassung übermäßiger Nutzerdaten
Browser-Fingerprints und detaillierte Verhaltenslogs sind Informationen, auf die Datenschutzgesetze anwendbar sind. Erfassen Sie das Minimum, das für die Entscheidung nötig ist, begrenzen Sie die Speicherfristen, spiegeln Sie die Tatsache der Verarbeitung in der Datenschutzerklärung wider.
Fehler 10. Fehlende Erfolgsmetriken
Der Schutz ist aktiviert, aber niemand kann die Frage "ist es besser geworden?" beantworten. Ohne Basislinie aus der Diagnose und ohne Conversion-Kontrolle können Sie Sieg nicht von Niederlage unterscheiden.
Werkzeuge und Ressourcen für die Umsetzung
Wir haben versprochen, keine Anbieter zu vergleichen, und halten Wort. Unten finden Sie Kategorien von Werkzeugen und wofür jede verantwortlich ist, damit Sie Ihren Stack nach Maßstab und Budget zusammenstellen können. Die Namen konkreter Lösungen finden Sie leicht selbst; hier ist die Architektur wichtig.
Ebene des Webservers und Reverse Proxy
Nginx, Apache, Caddy, HAProxy, Envoy. Was sie bieten: Rate Limiting nach flexiblen Schlüsseln, Header-Regeln, Ausgabe unterschiedlicher Antworten nach Bedingungen, Berechnung von TLS-Fingerprints über Module und Erweiterungen. Das ist Ihre erste Linie, und für ein Projekt mit bis zu einigen Millionen Anfragen pro Tag kann sie zu Beginn ausreichen.
WAF und CDN mit Schutz
Cloud-CDN mit integrierter WAF und Bot-Filtermodi oder selbst betriebene WAF auf Basis offener Regelsätze. Was sie bieten: Filterung nach ASN-Reputation und Geografie, verwaltete Challenges, Basis-Scoring, Caching. Plus — schnelle Aktivierung. Minus — begrenzte Anpassbarkeit an Ihre Geschäftslogik.
Spezialisierte Bot-Management-Plattformen
Kommerzielle und offene Systeme, die Client-Fingerprints sammeln, Verhaltens-Scoring betreiben, adaptive Challenges anwenden und ein Analyse-Dashboard bieten. Gerechtfertigt, wenn der Bot-Traffic-Anteil hoch ist, die Daten wertvoll sind und kein Team für eigene Entwicklung vorhanden ist. Bei der Auswahl achten Sie auf den Beobachtungsmodus, die Granularität der Richtlinien, die Unterstützung Ihrer mobilen Apps und Webviews sowie auf die Transparenz der Entscheidungen — Sie müssen verstehen, warum ein konkreter Client blockiert wurde.
Bibliotheken für die Eigenentwicklung
Offene Bibliotheken für die Erfassung von Browser-Fingerprints, die Implementierung von Proof of Work, die serverseitige Berechnung von TLS-Fingerprints, die Erkennung von Automatisierungsmerkmalen. Geeignet für Teams mit Entwicklern, die volle Kontrolle wünschen. Denken Sie an die Notwendigkeit ständiger Aktualisierung: Die Merkmale des Headless-Modus ändern sich mit jeder Browserversion.
Captchas und Alternativen
Moderne Prüfdienste mit unsichtbarem Modus und adaptiver Komplexität sowie Lösungen auf Basis von Proof of Work ohne Nutzerinteraktion. Auswahlkriterien: Barrierefreiheit für Menschen mit Behinderungen, Funktion in Ihrer Region ohne Verzögerungen, minimale Erfassung von Nutzerdaten.
Analytik und Observability
Stack für die Sammlung und Analyse von Logs (ELK und Ähnliches, ClickHouse, Cloud-Analytics-Systeme), Dashboards für Schutzmetriken, Systeme zur Benachrichtigung über Traffic-Anomalien. Ohne sie sind Sie blind: Sie können Schwellenwerte nicht kalibrieren, ohne die Entscheidungen des Systems nach Zielgruppensegmenten zu sehen.
Testwerkzeuge
Eine separate Empfehlung: Testen Sie Ihren Schutz mit denselben Mitteln, die Scraper verwenden. Ein automatisierter Browser im Headless-Modus, ein HTTP-Client in einer gängigen Sprache, Netzwerk-Profiling-Tools. Wenn Ihr eigenes einfaches Skript den Katalog problemlos abruft, ist die Arbeit nicht beendet. Für ein Team, das mit mobilen Proxys arbeitet, ist es nützlich, auch das andere Szenario zu prüfen: Blockiert der Schutz ehrliche Nutzer aus mobilen Netzen, in denen Adressen zwischen Tausenden Teilnehmern geteilt werden?
Interne Ressourcen, die benötigt werden
- Eine für den Schutz verantwortliche Person mit der Befugnis, Schwellenwerte zu ändern.
- Ein Verfahren zur Bearbeitung falsch-positiver Ergebnisse unter Beteiligung des Supports.
- Rechtlich geprüfte Nutzungsbedingungen und Datenschutzerklärung.
- Ein offizieller Kanal für Partner, die Ihre Daten benötigen.
Fallstudien: Wie das in realen Projekten funktioniert
Drei anonymisierte Geschichten aus der Implementierungspraxis, mit Zahlen und Erkenntnissen. Details wurden geändert, der Kern blieb erhalten.
Fall 1. Elektronik-Online-shop: 71% der Kataloganfragen von Bots
Situation. Ein mittelgroßer Shop, etwa 40.000 Produkte, bemerkte, dass Wettbewerber ihre Preise innerhalb einer halben Stunde nach ihm änderten. Die Log-Diagnose zeigte: 71% der Anfragen an Produktkarten nachts und 44% tagsüber waren automatisiert. Hauptprofile: zwei Cloud-Skripte ohne JS und ein verteilter Client auf Residential-Adressen, der nur Preisseiten durchläuft. Die Infrastrukturkosten des parasitären Traffics betrugen etwa 140.000 Rubel pro Monat, dazu wurden die Limits der kostenpflichtigen Geocoding-API bis zur Tagesmitte erschöpft.
Lösung. Erste Linie: differenzierte Limits nach Bereichen, strenger Modus für Hosting-ASNs, Caching von Produktkarten. Zweite Linie: TLS-Fingerprints mit einwöchiger Beobachtung, unsichtbare JS-Challenge für den Katalog, Schutz des JSON-Endpunkts des Frontends mit Token. Dritte Linie: Scoring nach Sitzungstiefe, versteckte Links, Köder-Produkte, für Sitzungen mit maximalem Risikowert — Preisverfälschung um 5-8%.
Ergebnis nach zwei Monaten. Der Bot-Traffic-Anteil am Katalog sank auf 9%. Die Cloud-Skripte verschwanden in der ersten Woche. Der verteilte Client hielt drei Wochen durch, begann dann laut den Köder-Produkten, verfälschte Preise zu sammeln, und nach einem Monat hörte die Aktivität auf. Die Last auf die Anwendung sank um 58%, die Infrastrukturkosten um 96.000 Rubel pro Monat. Die Conversion änderte sich statistisch nicht signifikant; die Zahl der Support-Anfragen wegen Captcha — 11 in zwei Monaten bei einer Zielgruppe von Hunderttausenden Besuchern. Der Anteil falsch-positiver Ergebnisse in einer manuellen Stichprobe — 0,3%.
Lehre. Die Datenvergiftung erwies sich als entscheidender Faktor gegen den hartnäckigsten Scraper, funktionierte aber nur, weil die vorherigen Schichten eine hohe Klassifizierungssicherheit gewährleisteten.
Fall 2. Dienstleistungs-Kleinanzeigenportal: Schutz von Kontakten und Anzeigen
Situation. Eine Plattform mit Anzeigen privater Fachleute litt unter massenhafter Erfassung von Kontaktdaten: Telefonnummern von Anbietern landeten in Spam-Datenbanken, Nutzer beschwerten sich und gingen weg. Die Erfassung erfolgte über gesteuerte Browser mit plausiblen Fingerprints von Residential- und mobilen Adressen; die erste Linie half kaum.
Lösung. Schwerpunkt auf die dritte Linie und den Datenschutz. Kontakte wurden aus dem HTML ausgelagert und nur per Klick über eine signierte Anfrage mit Sitzungstoken ausgegeben, mit einem Limit für Enthüllungen pro Stunde und Sitzung und erhöhter Proof-of-Work-Komplexität bei steigendem Risikowert. Für authentifizierte Nutzer ein höheres Limit, für Gäste ein niedrigeres. Session-Scoring unter Berücksichtigung der Interaktion: Die Enthüllung eines Kontakts ohne vorheriges Scrollen dorthin und ohne Zeigerbewegung fügte Punkte hinzu. Captcha — nur bei der fünften und jeder weiteren Enthüllung pro Stunde für Gäste.
Ergebnis. Die Zahl der enthüllten Kontakte pro Sitzung bei verdächtigen Clients sank von Hunderten auf 3-4, danach wurden Sitzungen blockiert. Die Beschwerden der Anbieter über Spam gingen im Quartal um 80% zurück. Die Conversion "Anzeige ansehen — Kontakt" bei echten Nutzern stieg um 4% — wahrscheinlich, weil die Seiten durch die entfernte Last schneller wurden.
Lehre. Wenn ein Scraper durch den Fingerprint nicht vom Menschen zu unterscheiden ist, rettet die Änderung des Auslieferungsmodells der Daten: Wertvolles wird per Aktion, dosiert und mit steigendem Preis ausgegeben.
Fall 3. B2B-Katalog: falsch-positive Ergebnisse als Hauptproblem
Situation. Ein Lieferant industrieller Komponenten aktivierte Cloud-Bot-Schutz im harten Modus ohne Beobachtung. Nach zwei Tagen — ein Rückgang der Anfragen um 35%. Die Analyse zeigte: Die Kunden des Unternehmens sitzen in Unternehmensnetzen mit gemeinsam genutzten Adressen und veralteten Browsern, und ein erheblicher Teil des Traffics läuft über das Webview eines Unternehmens-Messengers mit ungewöhnlichem TLS-Fingerprint. Das System hielt sie für Bots.
Lösung. Rollback in den Beobachtungsmodus, zwei Wochen Kalibrierung, Erstellung einer Whitelist von Fingerprints und Subnetzen wichtiger Kunden, Versetzung der Unternehmenssegmente in den Modus "nur Verlangsamung und unsichtbare Challenge, niemals Captcha". Zusätzlich — eine Partner-API für drei Distributoren, die den Katalog zuvor für ihre Systeme gescrapt hatten.
Ergebnis. Die Anfragen erholten sich innerhalb einer Woche nach der Kalibrierung. Der Bot-Traffic sank um 62% durch den Wechsel der Distributoren zur offiziellen API und das Abschneiden primitiver Skripte. Falsch-positive Ergebnisse — unter 0,2%.
Lehre. Der Beobachtungsmodus ist keine Formalität. Und ein Teil der "Scraper" sind in Wirklichkeit Ihre Partner, denen man einfacher eine API gibt, als Krieg zu führen.
FAQ: Antworten auf schwierige Fragen
Kann man Scraping vollständig stoppen?
Die ehrliche Antwort — nein, wenn Daten einem Menschen öffentlich zugänglich sind, sind sie technisch auch einem ausreichend motivierten Bot zugänglich. Das Ziel des Schutzes ist es, die Erfassung so teuer, langsam und unzuverlässig zu machen, dass sie ihren wirtschaftlichen Sinn verliert. In den meisten kommerziellen Szenarien reicht das: Ein Wettbewerber, der Daten mit einem Tag Verzögerung und mit einem Prozentsatz an Verfälschungen erhält, gewinnt keinen Vorteil.
Schadet Bot-Schutz der Suchmaschinenoptimierung?
Er schadet, wenn man ihn falsch macht: Suchmaschinen-Roboter blockieren, ihnen eine Challenge statt Inhalt geben oder Preise als Bilder rendern. Ein richtig aufgebauter Schutz erkennt legitime Roboter (anhand angegebener Adressbereiche und Reverse-DNS-Prüfung), lässt sie ohne Prüfungen durch und ändert den Inhalt für sie nicht. Prüfen Sie die Sichtbarkeit der Seiten mit Webmaster-Tools nach jeder Richtlinienänderung.
Wie schützt man die Website, ohne Nutzer mobiler Netze zu blockieren?
Niemals eine einzelne IP aus einem mobilen Netz bannen; Limits pro Subnetz oder ASN mit hohen Schwellenwerten zählen; sich auf Sitzungs- und Verhaltenssignale verlassen, nicht auf Netzwerksignale; auf zweifelhafte Clients unsichtbare Challenges und Verlangsamung anwenden, nicht Captcha. Testen Sie den Schutz unbedingt mit echten mobilen Geräten in den Netzen der wichtigsten Betreiber.
Sollte man den Schutz selbst bauen oder eine fertige Plattform nehmen?
Das hängt vom Maßstab und vom Team ab. Die erste Linie und Basis-Challenges sind mit einem Entwickler in ein paar Wochen umsetzbar und decken den Großteil der primitiven Bots ab. Verhaltens-Scoring mit ständiger Aktualisierung ist praktisch ein eigenes Produkt, und für Projekte ohne dediziertes Sicherheitsteam ist eine fertige Plattform auf Jahresbasis meist günstiger. Der vernünftige Weg — mit eigenen Basismaßnahmen beginnen, das Restproblem messen und dann entscheiden, ob ein spezialisiertes Werkzeug nötig ist.
Wie soll man mit Crawlern von KI-Modellen umgehen?
Als Geschäftsentscheidung, nicht nur als technische. Wenn die Präsenz in Antworten von KI-Assistenten Ihnen Publikum bringt — erlauben Sie den Crawl über Roboter-Regeln und stören Sie nicht. Wenn Ihr Inhalt Ihr Produkt ist und seine Nacherzählung durch ein Modell Ihnen Traffic entzieht — verbieten Sie es ausdrücklich und untermauern Sie es mit technischen Maßnahmen. Gewissenhafte Betreiber melden ihre Crawler an und halten die Regeln ein, ungewissenhafte fallen unter den allgemeinen Bot-Schutz für Websites wie andere Scraper auch.
Ist es legal, Scrapern verfälschte Daten zu geben?
Technisch sind Sie berechtigt, verschiedenen Clients verschiedene Inhalte auf Ihrer Ressource zu zeigen, aber Sie müssen Situationen ausschließen, in denen verfälschte Informationen zur Grundlage eines Geschäfts mit einem echten Verbraucher werden, und dürfen keine Informationen verfälschen, deren wahrheitsgemäße Offenlegung gesetzlich vorgeschrieben ist. Wenden Sie die Vergiftung nur auf Sitzungen mit maximaler Klassifizierungssicherheit an, deaktivieren Sie sie für authentifizierte Nutzer und konsultieren Sie einen Juristen bezüglich Ihrer Branche.
Wie oft muss man den Schutz aktualisieren?
Schwellenwerte und Ausnahmen — wöchentlich in den ersten Monaten, danach monatlich. Challenges und Fallen — Rotation alle 4-8 Wochen oder bei Entdeckung einer Umgehung. Scraper-Profile — bei jeder merklichen Änderung des Traffic-Bildes überprüfen. Automatisierungsmerkmale in Browsern — mit jedem Major-Release der Browser. Schutz ohne Wartung degradiert innerhalb von ein bis zwei Quartalen.
Was tun, wenn ein großer Wettbewerber mit großem Budget scrapt?
Den Schwerpunkt von Blockierung auf Entwertung und Beweise verlagern: Köder-Einträge und Wasserzeichen liefern juristische Argumente, Datenvergiftung macht die Beute unzuverlässig, die Begrenzung der Ausgabetiefe verhindert den Export des gesamten Katalogs. Parallel Vorfälle dokumentieren und die Aussichten auf eine Abmahnung einschätzen — bei Vorliegen von Beweisen für systematisches Sammeln entgegen den Nutzungsbedingungen erweist sie sich nicht selten als wirksamer als ein technisches Wettrennen.
Womit anfangen, wenn Budget und Zeit begrenzt sind?
Ein Tag für die Diagnose anhand der Logs. Dann: differenziertes Rate Limiting mit zwei Fenstern, Caching teurer Seiten, Schließen der JSON-Endpunkte mit Token, versteckte Link-Fallen und Köder-Produkte. Dieses Set ist in einer Woche fast ohne Kosten umsetzbar und schneidet den Großteil der Probleme ab. Danach — messen und entscheiden, ob die nächste Schicht nötig ist.
Fazit: Schutz als Prozess, nicht als Einkauf
Wenn man alles Gesagte auf einen Gedanken reduziert, lautet er: Bot-Schutz für Websites ist keine Box, die man aufstellt und vergisst, sondern ein System aus drei aufeinander abgestimmten Schichten und ein Prozess seiner ständigen Kalibrierung. Die Netzwerkebene schneidet primitive Bots fast kostenlos ab. Die Client-Prüfung fängt Skripte und nachlässig konfigurierte automatisierte Browser. Verhaltensanalyse und Arbeit mit den Daten selbst machen die Anstrengungen selbst fortgeschrittener Scraper sinnlos. Und all das verbindet das Prinzip des Scorings: nicht die Tür wegen eines Merkmals zuschlagen, sondern schwache Signale sammeln und proportional reagieren.
Nicht weniger wichtig ist der Prozess. Diagnose vor der Implementierung, Beobachtungsmodus vor der Aktivierung von Blockierungen, schrittweise Abdeckung, Conversion-Metriken neben Schutzmetriken, regelmäßige Rotation — genau das unterscheidet erfolgreiche Projekte von denen, die nach einer Woche wegen Kundenbeschwerden zurückgerollt werden. Und denken Sie an die Menschen hinter den Adressen: Nutzer mobiler Netze, Unternehmens-Proxys und Messenger-Webviews sind Ihre echten Käufer, und der Schutz muss den Test auf Freundlichkeit ihnen gegenüber bestehen.
Was Sie als Nächstes tun sollten, noch heute:
- Exportieren Sie die Logs der Woche und beantworten Sie die Fragen aus dem Diagnoseabschnitt. Das ist kostenlos und dauert ein paar Stunden.
- Berechnen Sie, was Ihnen der Bot-Traffic an Infrastruktur und entgangenem Nutzen kostet. Diese Zahl bestimmt das Budget.
- Implementieren Sie die erste Linie nach der Checkliste: Limits, Cache, Header-Regeln, API-Schutz.
- Stellen Sie Fallen und Köder-Einträge auf — sie werden monatelang für Sie arbeiten.
- Planen Sie die zweite und dritte Linie schrittweise, mit Beobachtungsmodus bei jedem Schritt.
- Legen Sie einen Wartungskalender für den Schutz an und benennen Sie einen Verantwortlichen.
Die Daten, die Sie sammeln und erstellen, sind ein Aktivposten. Wie jeder Aktivposten verdienen sie einen Schutz, der ihrem Wert angemessen ist und diejenigen nicht behindert, für die sie geschaffen wurden. Wir hoffen, dieser Leitfaden wird für Sie das Lesezeichen, zu dem Sie bei jeder Etappe zurückkehren — vom ersten Blick in die Logs bis zu einem reifen, ruhig arbeitenden System.
